

In juni van dit jaar vond in het kleine Zwitserse stadje Rapperswil voor de tiende keer een evenement plaats dat de naam draagt. Dit keer verzamelden zich meer dan vijfhonderd Haskell-liefhebbers, van beginners tot oprichters van de taal. Hoewel de organisatoren dit evenement een hackathon noemen, is het toch geen conferentie of hackathon in de klassieke zin. Het format verschilt van traditionele programmeringevenementen. We hoorden toev toevallig over ZuriHac, namen deel aan het evenement en achten het nu onze plicht om deze bijzondere ontdekking te delen!
Alconost is professioneel bezig met
Dit artikel is opgesteld door twee derdejaars studenten van het programma "Toegepaste Wiskunde en Informatica" van de Higher School of Economics – Sint-Petersburg: Vasili Alferov en Elizaveta Vasilenko. Onze interesse in functioneel programmeren begon voor ons beiden met de lezingencollege van D. N. Moskvins tijdens ons tweede jaar aan de universiteit. Op dit moment neemt Vasili deel aan het Google Summer of Code-programma, waarin hij zich bezighoudt met de implementatie van algebraïsche grafen in de Haskell-taal onder leiding van het projectteam . Elizaveta heeft de verworven vaardigheden in functioneel programmeren toegepast in een scriptie over de implementatie van het anti-unificatie-algoritme met een daaropvolgende toepassing in de type theorie.
Het format van het evenement
De doelgroepen zijn eigenaren van open source-projecten, programmeurs die willen bijdragen aan hun ontwikkeling, onderzoekers van functioneel programmeren en gewoon mensen die gepassioneerd zijn door Haskell. Dit jaar verzamelden ontwikkelaars van meer dan vijftig open source-projecten in de Haskell-taal van over de hele wereld zich op de locatie – de HSR Hochschule für Technik Rapperswil – om hun producten voor te stellen en nieuwe mensen te interesseren voor hun ontwikkeling.
Foto's van Twitter
Het schema is heel eenvoudig: je moet van tevoren een paar zinnen over je project schrijven en deze naar de organisatoren sturen, die de informatie over je project op de pagina van het evenement zullen plaatsen. Daarnaast hebben de auteurs van projecten de eerste dag dertig seconden om kort vanaf het podium te vertellen waar ze mee bezig zijn en wat er moet gebeuren. Geïnteresseerde mensen zoeken daarna de auteurs op en vragen uitgebreid naar de taken.
Wij hebben momenteel geen eigen open projecten, maar we willen graag bijdragen aan bestaande projecten, dus we hebben ons geregistreerd als gewone deelnemers. Gedurende drie dagen hebben we gewerkt met twee groepen ontwikkelaars. Het blijkt dat gezamenlijk code bestuderen en in real-time communiceren de interactie tussen de projectauteurs en contributors zeer productief maakt – bij ZuriHac konden we ons verdiepen in nieuwe gebieden en hebben we twee totaal verschillende teams geholpen door elk een taak in hun projecten op te lossen.
Naast waardevolle praktijk werden er tijdens ZuriHac ook verschillende lezingen en masterclasses gegeven. Twee lezingen zijn ons vooral bijgebleven. In de eerste vertelde Andrej Mokhov van de Universiteit van Newcastle over selectieve applicatieve functors - een klasse types die tussen applicatieve functors en monaden in moet komen. Tijdens een andere lezing vertelde Simon Peyton Jones, een van de oprichters van Haskell, over hoe de type-afleiding in de GHC-compiler werkt.
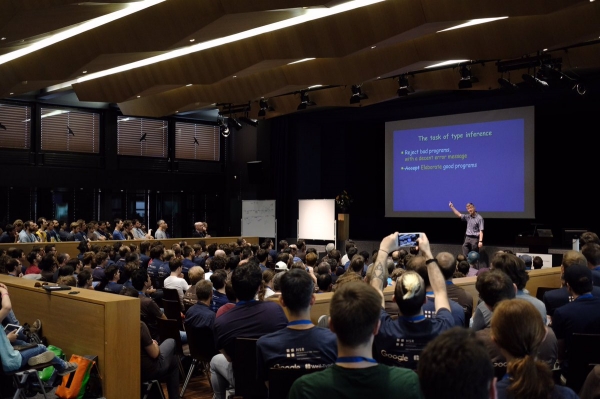
Lezing van Simon Peyton Jones. Foto van Twitter
De masterclasses die tijdens de hackathon werden gegeven, waren onderverdeeld in drie categorieën op basis van het niveau van de deelnemers. De taken die aan de deelnemers die betrokken waren bij het ontwikkelen van projecten werden aangeboden, hadden ook moeilijkheidsniveaus. De kleine maar hechte gemeenschap van functionele programmeurs verwelkomt graag nieuwkomers. Voor het begrijpen van de lezingen van Andrej Mokhov en Simon Peyton Jones was de functionele programmeercursus die we aan de universiteit volgden echter erg nuttig.
Voor zowel gewone deelnemers als projectauteurs is registratie voor het evenement gratis. We hebben ons begin juni aangemeld, waarna we vrij snel van de wachtlijst naar de lijst van bevestigde deelnemers zijn overgezet.
En nu vertellen we over de projecten waaraan we hebben deelgenomen.
Pandoc
is een universele converter voor tekstdocumenten, feitelijk van elk formaat naar elk formaat. Bijvoorbeeld van docx naar pdf, of van Markdown naar MediaWiki. De auteur is John MacFarlane, een professor filosofie aan de Universiteit van Californië in Berkeley. Over het algemeen is Pandoc vrij bekend en sommige van onze vrienden waren verrast toen ze hoorden dat Pandoc in Haskell is geschreven.
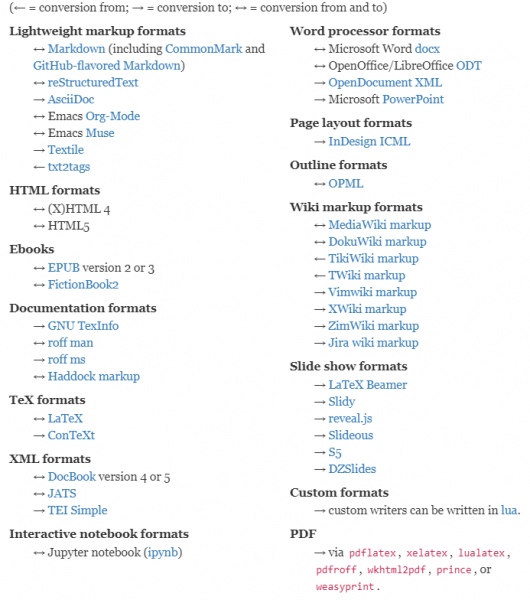
Een lijst van documentformaten die door Pandoc worden ondersteund. Op de website is ook een volledige grafiek te vinden, maar die afbeelding past niet in het artikel.
Natuurlijk is er in Pandoc geen directe conversie voor elk paar formaten geïmplementeerd. Om een zo uitgebreide reeks conversies te ondersteunen, wordt een standaard architectonische oplossing gebruikt: eerst wordt het volledige document omgezet in een speciale interne tussenvertegenwoordiging, en vervolgens wordt uit deze interne vertegenwoordiging een document in een ander formaat gegenereerd. Deze interne vertegenwoordiging noemen de ontwikkelaars "AST", wat staat voor Abstract Syntax Tree, of . De tussenvertegenwoordiging kan heel eenvoudig worden bekeken: daarvoor hoeft u alleen maar als uitvoerformaat "native" op te geven.
$ cat example.html
<h1>Hello, World!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Hallo,",Space,Str "Wereld!"]]
Lezers die ook maar een beetje met Haskell hebben gewerkt, kunnen uit dit kleine voorbeeld al raden dat Pandoc precies in Haskell is geschreven: de uitvoer van dit commando is een weergave van de interne structuren van Pandoc in de vorm van een string, gemaakt op een manier zoals dat gebruikelijk is in Haskell, bijvoorbeeld in de standaardbibliotheek.
Dus hier is te zien dat de interne vertegenwoordiging een recursieve structuur is, waarbij elke interne knoop een lijst bevat. Op het hoogste niveau bevindt zich bijvoorbeeld een lijst van één element - een kop van het eerste niveau met de attributen "hello-world",[],[]. Binnen deze kop is een lijst verborgen van de string "Hello," een spatie en de string "World!".
Zoals te zien is, verschilt de interne vertegenwoordiging niet veel van HTML. Het vormt een boomstructuur, waarbij elke interne knoop informatie geeft over de opmaak van zijn afstammelingen, en de bladeren de eigenlijke inhoud van het document bevatten.
Als we naar het niveau van de specifieke implementatie kijken, is het datatype voor het volledige document als volgt gedefinieerd:
data Pandoc = Pandoc Meta [Block]Hier is Block inderdaad de interne toppen waarboven gesproken wordt, en Meta zijn de metadata over het document, zoals de titel, de datum van creatie, de auteurs - voor verschillende formaten verschilt dit, en Pandoc probeert dergelijke informatie zoveel mogelijk te behouden bij het vertalen van het ene formaat naar het andere.
Bijna alle bouwers van het type Block — zoals Header of Para (paragraaf) — accepteren als argumenten attributen en een lijst van lager-niveau knooppunten, meestal Inline. Bijvoorbeeld, Space of Str zijn bouwers van het type Inline, en de HTML-tag wordt ook een speciale Inline. We zien geen reden om een volledige definitie van deze typen te geven, maar we merken op dat deze te bekijken is via .
Het is interessant dat het Pandoc-type een monoid is. Dit betekent dat er een lege document is, en dat documenten met elkaar kunnen worden samengevoegd. Dit is handig bij het schrijven van Readers — je kunt een document splitsen in delen met willekeurige logica, elk afzonderlijk parseren, en dan alles samenvoegen in één document. De meta-informatie wordt hierbij direct van alle delen van het document verzameld.
Bij conversie, bijvoorbeeld van LaTeX naar HTML, transformeert een speciale module, genaamd LaTeXReader, het inputdocument naar een AST, waarna een andere module, genaamd HTMLWriter, de AST omzet in HTML. Dankzij deze architectuur is het niet nodig om een kwadratisch aantal conversies te schrijven — het is genoeg om voor elk nieuw formaat een Reader en Writer te schrijven, en alle mogelijke conversiepaaren worden automatisch ondersteund.
Het is duidelijk dat deze architectuur ook zijn tekortkomingen heeft, die al lange tijd door specialisten in software-architectuur zijn voorspeld. De meest significante is de kostprijs van wijzigingen in de syntactische boom. Als de wijziging groot genoeg is, moeten de code in alle Readers en Writers worden aangepast. Een van de uitdagingen waarmee de ontwikkelaars van Pandoc worden geconfronteerd — ondersteuning voor complexe tabelformaten. Momenteel ondersteunt Pandoc alleen de meest eenvoudige tabellen, met een kop, kolommen en waarden in elke cel. Bijvoorbeeld, het attribuut colspan in HTML wordt simpelweg genegeerd. Een van de redenen voor dit gedrag is het ontbreken van een uniforme weergave-schema voor tabellen in alle of ten minste veel formaten — het is dus onduidelijk in welke vorm tabellen in de interne weergave moeten worden opgeslagen. Maar zelfs na het kiezen van een specifieke weergave moet het absoluut noodzakelijk zijn om alle Readers en Writers die met tabellen werken aan te passen.
De programmeertaal Haskell is gekozen niet alleen uit de grote liefde van de auteurs voor functioneel programmeren. Haskell staat bekend om zijn brede mogelijkheden voor tekstverwerking. Een van de voorbeelden is de bibliotheek — een bibliotheek die actief gebruikmaakt van concepten van functioneel programmeren — monaden, applicatieve en alternatieve functors — voor het schrijven van willekeurige parsers. De volledige kracht van Parsec is te zien in HaskellWiki, waar een volledige parser van een eenvoudige imperatieve programmeertaal wordt besproken. Natuurlijk wordt Parsec ook actief gebruikt in Pandoc.
Kort samengevat worden monaden gebruikt voor sequentieel parseren, waarbij eerst het een komt en dan het ander. Bijvoorbeeld in het volgende voorbeeld:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Eerst moet er een spatie gelezen worden, en dan de statement — die ook het type Parser Stmt heeft.
Alternatieve functors worden gebruikt om terug te vallen in het geval dat parseren niet is gelukt. Bijvoorbeeld,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Dit betekent dat je ofwel probeert de statement in haakjes te lezen, ofwel probeert een aantal statements achtereenvolgens te lezen.
Applicatieve functors worden voornamelijk gebruikt als korte wegen voor monaden. Bijvoorbeeld, laten we zeggen dat de functie tok een bepaalde token leest (dit is een echte functie uit LaTeXReader). Laten we eens naar deze combinatie kijken
const tok tokHet zal twee tokens achtereenvolgens lezen en de eerste retourneren.
Voor al deze klassen zijn er mooie symbolische operatoren in Haskell, waardoor het programmeren van Readers lijkt op ASCII-kunst. Kijk eens naar deze geweldige code.
Onze taken waren gerelateerd aan LaTeXReader. De taak van Vasili was het ondersteunen van de commando's mbox en hbox, nuttig bij het schrijven van pakketten in LaTeX. Elizabeth was verantwoordelijk voor het ondersteunen van het commando epigraph, dat het mogelijk maakt om epigrafen in LaTeX-documenten weer te geven.
Hatrace
In UNIX-achtige besturingssystemen is de systeemsystemcall ptrace vaak geïmplementeerd. Het is nuttig bij het debuggen en simuleren van programmeeromgevingen, en maakt het mogelijk om de systeemaanroepen die een programma doet te volgen. Bijvoorbeeld, de zeer nuttige tool strace gebruikt binnenin precies ptrace.
Hatrace is a library that provides an interface for ptrace in Haskell. The fact is that ptrace itself is quite complex, and using it directly is rather difficult, especially from functional languages.
When launched, Hatrace operates like strace and accepts similar arguments. Its distinction from strace is that it is also a library that offers a simpler interface than just ptrace.
With hatrace, we have already caught one annoying bug in the Haskell compiler GHC — when killed at the wrong moment, it generates incorrect object files and does not recompile them upon restart. Scripting around system calls allowed us to reliably reproduce the error in one run, while random terminations reproduced the error roughly in two hours.
We added system call interfaces to the library — Elizaveta added brk, and Vasiliy added mmap. As a result of our work, it is now easier and more accurate to use the arguments of these system calls when using the library.
Bron: habr.com
