

Vandaag bespreken we de metrieken van het opslag subsysteem in vSphere. Een probleem met de opslag is de meest voorkomende reden voor traagheid van een virtuele machine. In het geval van CPU en RAM eindigt het troubleshooten vaak op het niveau van de hypervisor, maar bij problemen met de schijf kan het nodig zijn om te kijken naar het datatransportnetwerk en de SAN.
Ik zal het onderwerp behandelen aan de hand van block-gebaseerde toegang tot de SAN, hoewel de tellers bij file-gebaseerde toegang ongeveer hetzelfde zijn.
Een beetje theorie
Wanneer we het hebben over de prestaties van het opslag subsysteem van virtuele machines, richten we ons doorgaans op drie met elkaar verbonden parameters:
- aantal input/output operaties per seconde (Input/Output Operations Per Second, IOPS);
- doorvoersnelheid (Throughput);
- en de latency van input/output operaties (Latency).
Aantal IOPS is meestal belangrijk voor workloads van willekeurige aard (random): toegang tot blokken op de schijf, verspreid over verschillende locaties. Voorbeelden van dergelijke workloads zijn databases, bedrijfsapplicaties (ERP, CRM), enz.
Doorvoersnelheid is belangrijk voor workloads van sequentiële aard: toegang tot blokken die naast elkaar liggen. Bijvoorbeeld, dergelijke workloads kunnen worden gegenereerd door bestandsservers (maar niet altijd) en videobewakingssystemen.
De doorvoersnelheid hangt samen met het aantal input/output operaties als volgt:
Throughput = IOPS * Blokgrootte, waarbij Blokgrootte de grootte van het blok is.
De blokgrootte is een vrij belangrijke eigenschap. Moderne versies van ESXi laten blokken tot 32.767 KB door. Als het blok nog groter is, wordt het verdeeld over meerdere. Niet alle SAN's kunnen efficiënt omgaan met zulke grote blokken, daarom is er in de Geavanceerde instellingen van ESXi een parameter DiskMaxIOSize. Hiermee kan de maximale blokgrootte, die door de hypervisor wordt verwerkt, worden verkleind (meer hierover ). Ik raad aan om voor het wijzigen van deze parameter advies in te winnen bij de fabrikant van de SAN of in ieder geval de wijzigingen op een laboratoriumopstelling te testen.
Een grote blokgrootte kan een negatieve invloed hebben op de prestaties van de SAN. Zelfs als het aantal IOPS en throughput relatief laag is, kunnen bij een grote blokgrootte hoge latencies optreden. Let daarom op deze parameter.
Latency is het meest interessante prestatieparameter. De latency van input/output operaties voor een virtuele machine bestaat uit:
- vertragingen binnen de hypervisor (KAVG, Gemiddelde Kernel MilliSec/Lezen);
- vertragingen veroorzaakt door het gegevensoverdrachtsnetwerk en de opslagarray (DAVG, Gemiddelde Driver MilliSec/Commando).
De totale vertraging die zichtbaar is in het gastbesturingssysteem (GAVG, Gemiddelde Gast MilliSec/Commando) is de som van KAVG en DAVG.
GAVG en DAVG worden gemeten, terwijl KAVG wordt berekend: GAVG–DAVG.
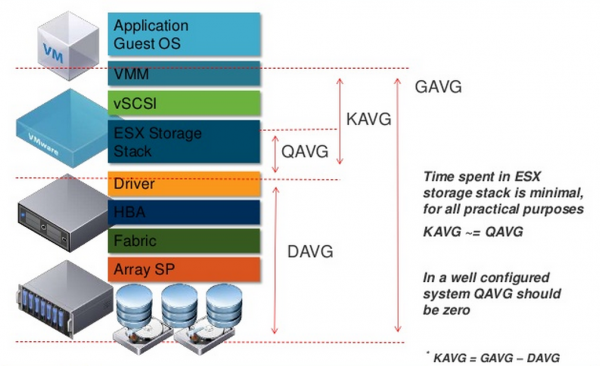
Laten we wat dieper ingaan op KAVG. Bij normale werking zou KAVG naar nul moeten streven, of in ieder geval aanzienlijk lager moeten zijn dan DAVG. De enige situatie waarin KAVG verwacht hoog is, is als er een IOPS-beperking op de VM-schijf is. In dat geval zal KAVG stijgen bij pogingen om de limiet te overschrijden.
De meest significante component van KAVG is QAVG - de wachttijd voor verwerking binnen de hypervisor. De andere componenten van KAVG zijn verwaarloosbaar klein.
De wachtrij in de schijfadapterdriver en de wachtrijen naar de lun hebben een vaste grootte. Voor omgevingen met hoge belastingen kan het nuttig zijn om deze grootte te vergroten. beschrijft hoe u de wachtrijen in de adapterdriver kunt vergroten (gelijktijdig wordt de wachtrij naar de luns vergroot). Deze instelling werkt wanneer er slechts één VM op de lun draait, wat zelden voorkomt. Als er meerdere VMs op de lun zijn, moet ook de parameter Disk.SchedNumReqOutstanding (instructie ). Door de wachtrij te vergroten, vermindert u QAVG en KAVG overeenkomstig.
Maar, nogmaals, bekijk eerst de documentatie van de HBA-leverancier en test de wijzigingen in een labomgeving.
De grootte van de wachtrij naar de lun kan worden beïnvloed door het inschakelen van het SIOC-mechanisme (Storage I/O Control). Dit zorgt voor een gelijkmatige toegang tot de lun door alle servers in de cluster door de wachtrij naar de lun dynamisch te wijzigen op de servers. Dat wil zeggen, als er op een van de hosts een VM draait die onevenredig veel prestaties vereist (noisy neighbor VM), dan vermindert SIOC de lengte van de wachtrij naar de lun op die host (DQLEN). Meer informatie .
We hebben KAVG behandeld, nu iets over DAVG. Dit is eenvoudig: DAVG is de vertraging die de externe omgeving (gegevensoverdrachtsnetwerk en opslagarray) introduceert. In elke moderne en minder moderne opslagarray zijn er prestatiestatistieken. Voor het analyseren van DAVG-problemen is het zinvol om deze statistieken te bekijken. Als alles aan de ESXi- en opslagarray-zijde in orde is, controleer dan het gegevensoverdrachtsnetwerk.
Om prestatieproblemen te voorkomen, kies de juiste Path Selection Policy (PSP) voor uw opslag. Bijna alle moderne opslagapparaten ondersteunen de PSP Round-Robin (met of zonder ALUA, Asymmetric Logical Unit Access). Dit beleid stelt u in staat om alle beschikbare paden naar de opslag te benutten. In het geval van ALUA worden alleen de paden naar de controller die de LUN bezit gebruikt. Niet alle opslagapparaten op ESXi hebben standaardregels die het beleid Round-Robin instellen. Als er geen regels voor uw opslagapparaat zijn, gebruik dan de plugin van de fabrikant die een bijpassende regel op alle hosts in de cluster zal creëren, of maak de regel zelf aan. Meer details .
Ook raden sommige fabrikanten van opslagapparaten aan om het aantal IOPS van het standaardwaarde 1000 naar 1 te wijzigen. In onze praktijk stelde dit ons in staat om meer prestaties uit de opslag te halen en de tijd die nodig is voor failover aanzienlijk te verkorten in het geval van uitval of upgrades van controllers. Controleer de aanbevelingen van de leverancier en als er geen bezwaren zijn, probeer dan deze parameter te wijzigen. Meer details .
Belangrijkste prestatiestatistieken van de schijfopslag van de virtuele machine
De prestatiestatistieken van de schijfopslag in vCenter zijn verzameld in de secties Datastore, Disk, Virtual Disk:
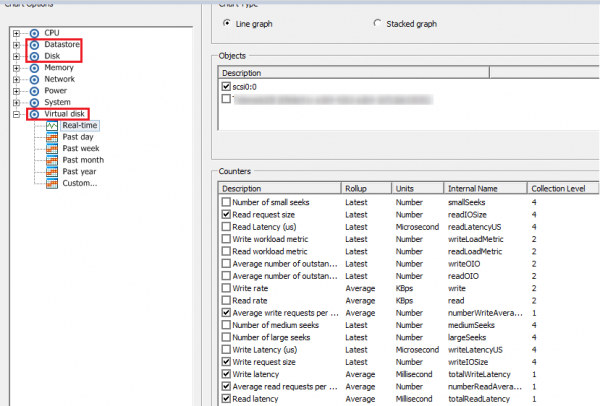
In de sectie Datastore hier bevinden zich de metrics van de schijfopslag in vSphere (datastores) waar de VM-schijven zich bevinden. Hier vindt u de standaardstatistieken voor:
- IOPS (Gemiddelde lees-/schrijfbewerkingen per seconde),
- doorvoersnelheid (Lees-/schrijfsnelheid),
- latenties (Lees-/schrijf-/hoogste latentie).
Uit de namen van de statistieken is alles in principe duidelijk. Ik wil nogmaals benadrukken dat deze statistiek niet voor een specifieke VM (of VM-schijf) geldt, maar algemeen voor de hele datastore. Naar mijn mening is het handiger om deze statistieken in ESXTOP te bekijken, aangezien de minimale meetperiode daar 2 seconden is.
In de sectie Schijf hier bevinden zich de metrics van de blokapparaten die door de VM worden gebruikt. Hier zijn statistieken over IOPS van het type summatie (aantal invoer-/uitvoeren bewerkingen over de meetperiode) en verschillende statistieken met betrekking tot bloktoegang (Commands aborted, Bus resets). Deze informatie is, naar mijn mening, ook handiger om in ESXTOP te bekijken.
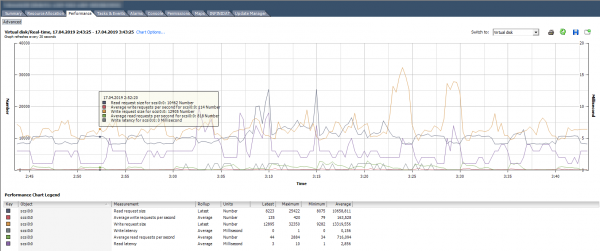
Sectie Virtuele Schijf – de meest nuttige voor het opsporen van problemen met de prestaties van het opslagsysteem van de VM. Hier kun je de prestaties per virtuele schijf bekijken. Deze informatie is essentieel om te begrijpen of er een probleem is met een specifieke virtuele machine. Naast de standaard tellers voor het aantal invoer-/uitvoeroperaties, het lees-/schrijvingsvolume en de latentie, zijn er in deze sectie nuttige tellers die de blokgrootte tonen: Lees-/Schrijfbewijkingsgrootte.
In de onderstaande afbeelding is de prestatiegrafiek van de VM-schijf te zien, waarop je het aantal IOPS, latentie en blokgrootte kunt zien.
De prestatiemetrics kunnen ook voor de gehele datastore worden bekeken, mits SIOC is ingeschakeld. Hier is basisinformatie weergegeven over de gemiddelde latentie en IOPS. Standaard kan deze informatie alleen in realtime worden bekeken.
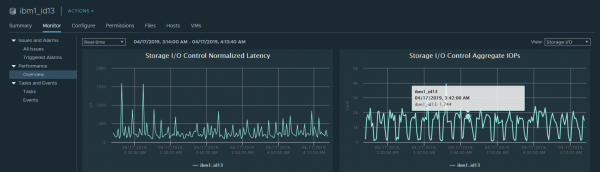
ESXTOP
In ESXTOP zijn er meerdere schermen waarop informatie over het opslagsysteem van de host als geheel, afzonderlijke virtuele machines en hun schijven wordt weergegeven.
Laten we beginnen met informatie over virtuele machines. Het scherm "Disk VM" kan worden geopend met de toets "v":
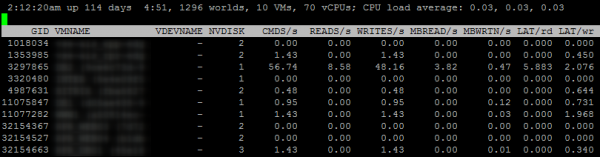
NVDISK – het aantal schijven van de VM. Om informatie over elke schijf te bekijken, druk op "e" en voer de GID van de gewenste VM in.
De waarden van de andere parameters op dit scherm zijn duidelijk uit de naam.
Een andere nuttige scherm bij het zoeken naar problemen is Disk adapter. Dit wordt geopend met de toets "d" (in de onderstaande afbeelding zijn de velden A, B, C, D, E, G geselecteerd):
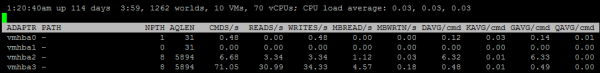
NPTH – het aantal paden naar LUN's die zichtbaar zijn vanaf deze adapter. Om informatie over elk pad op de adapter te krijgen, druk op "e" en voer de naam van de adapter in:
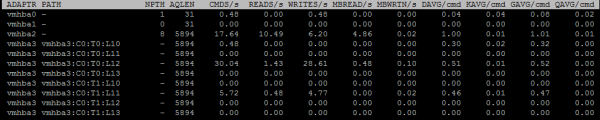
AQLEN – de maximale grootte van de wachtrij op de adapter.
Ook op dit scherm worden de latentie-tellers gepresenteerd waarover ik je eerder vertelde: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
Op het scherm Disk device, dat wordt geopend met de toets "u", wordt informatie weergegeven over afzonderlijke blokapparaten – LUN's (in de onderstaande afbeelding zijn de velden A, B, F, G, I geselecteerd). Hier kun je de status van de wachtrij naar LUN's zien.

DQLEN – de grootte van de wachtrij voor blokapparaten.
ACTV – het aantal invoer-/uitvoercommando's in de kernel van ESXi.
QUED – het aantal invoer-/uitvoercommando's in de wachtrij.
%USD – ACTV / DQLEN × 100%.
LOAD – (ACTV + QUED) / DQLEN.
Als %USD hoog is, is het raadzaam om te overwegen de wachtrij te vergroten. Hoe meer commando's in de wachtrij, hoe hoger QAVG en, dienovereenkomstig, KAVG.
Op het scherm van het schijfapparaat kan ook worden bekeken of VAAI (vStorage API for Array Integration) actief is op de opslag. Hiervoor moeten de velden A en O worden geselecteerd.
De VAAI-mechanisme maakt het mogelijk om een deel van het werk van de hypervisor rechtstreeks naar de opslag te verplaatsen, bijvoorbeeld het nullen, kopiëren van blokken of blokkeren.

Zoals te zien is op de afbeelding hierboven, werkt VAAI op deze opslag: de primitieve Zero en ATS worden actief gebruikt.
Tips voor het optimaliseren van de werking van de schijfsubsystemen op ESXi
- Let op de blokgrootte.
- Stel de optimale wachtrijgrootte in op de HBA.
- Vergeet niet SIOC in te schakelen op de datastores.
- Kies PSP in overeenstemming met de aanbevelingen van de opslagfabrikant.
- Zorg ervoor dat VAAI werkt.
Nuttige artikelen over het onderwerp:
Bron: habr.com
