

In de afgelopen jaren zijn tijdreeksdatabases (Time-series databases) geëvolueerd van een vreemde product (specifiek toegepast in open monitoringssystemen of in Big Data-projecten) naar een 'consumptiegoed'. In Rusland verdienen Yandex en ClickHouse hiervoor een speciale vermelding. Tot dat moment, als je een grote hoeveelheid tijdreeksdata moest opslaan, moest je ofwel accepteren dat je een monsterlijke Hadoop-stack moest opzetten en onderhouden, ofwel omgaan met protocollen die specifiek waren voor elk systeem.
Het kan lijken dat in het jaar 2019 een artikel over welke TSDB te gebruiken slechts uit één zin zou bestaan: 'gebruik gewoon ClickHouse'. Maar… er zijn nuances.
Inderdaad, ClickHouse ontwikkelt zich snel, de gebruikersbasis groeit, en de ondersteuning is zeer actief, maar zijn we niet gevangen in het publieke succes van ClickHouse, dat andere, mogelijk effectievere/zuiverdere oplossingen overschaduwt?
Aan het begin van vorig jaar zijn we begonnen met het herontwerpen van ons eigen monitoringsysteem, waarbij de vraag naar een geschikte database voor gegevensopslag opkwam. Over het verhaal van deze keuze wil ik hier vertellen.
Taakstelling
Voordat we beginnen, een noodzakelijke inleiding. Waarom hebben we eigenlijk ons eigen monitoringsysteem en hoe was het opgezet?
We begonnen in 2008 met het bieden van ondersteuningsdiensten, en in 2010 werd het duidelijk dat het moeilijk werd om gegevens over de processen in de klantinfrastructuur te aggregeren met de oplossingen die destijds beschikbaar waren (we hebben het over, sorry voor het ongemak, Cacti, Zabbix en het opkomende Graphite).
Onze belangrijkste vereisten waren:
- ondersteuning (op dat moment - tientallen, en in de toekomst - honderden) klanten binnen één systeem en tegelijkertijd een gecentraliseerd systeem voor meldingen;
- flexibiliteit in het beheer van het meldingssysteem (escalatie van meldingen tussen diensten, rekening houdend met schema's, kennisbank);
- de mogelijkheid voor diepgaande detaillering van grafieken (Zabbix tekende op dat moment grafieken als afbeeldingen);
- langdurige opslag van grote hoeveelheden data (een jaar of langer) en de mogelijkheid voor snelle querying.
In dit artikel is het laatste punt ons belangrijkste aandachtspunt.
Als we het hebben over opslag, waren de vereisten als volgt:
- het systeem moet snel werken;
- het is wenselijk dat het systeem een SQL-interface heeft;
- het systeem moet stabiel zijn en een actieve gebruikersbasis en ondersteuning hebben (we hebben ooit te maken gehad met de noodzaak om dergelijke systemen te ondersteunen, zoals MemcacheDB, dat niet verder werd ontwikkeld, of het gedistribueerde opslagmiddel MooseFS, waarvan de bugtracker in het Chinees werd geleid: we wilden deze geschiedenis voor ons project niet herhalen);
- naleving aan de CAP-theorema: Consistentie (vereist) - de gegevens moeten actueel zijn, we willen niet dat het meldingssysteem geen nieuwe gegevens ontvangt en ons overspoelt met meldingen over het ontbreken van gegevens in al onze projecten; Partition Tolerance (vereist) - we willen geen Split Brain-systeem; Beschikbaarheid (niet kritisch, als er een actieve replica is) - we kunnen zelf overschakelen naar het reservesysteem in geval van een storing, via code.
Verrassend genoeg bleek MySQL op dat moment de ideale oplossing voor ons te zijn. Onze datastructuur was uiterst eenvoudig: server-id, teller-id, timestamp en waarde; snelle selectie van belangrijke gegevens werd verzekerd door een grote bufferpool, en de selectie van historische gegevens gebeurde via SSD.
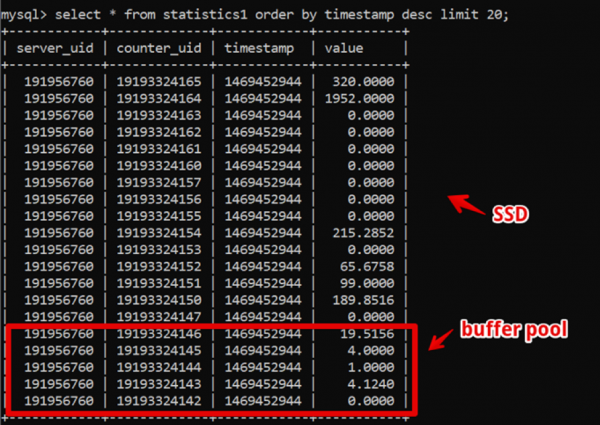
Zo bereikten we de selectie van verse gegevens van twee weken oud, met een resolutie tot op de seconde voor 200 ms vóór het volledig renderen van de gegevens, en we gebruikten dit systeem vrij lang.
Ondertussen ging de tijd voorbij en groeide de hoeveelheid gegevens. Tegen 2016 had de hoeveelheid gegevens tientallen terabytes bereikt, wat een aanzienlijke kostenpost was in de huur van SSD-opslag.
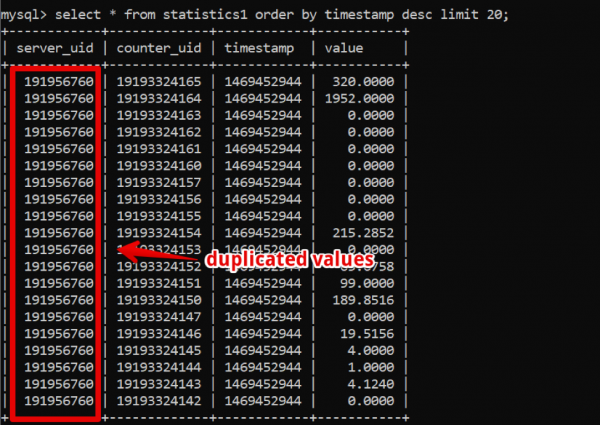
Op dat moment waren kolomgeoriënteerde databases in opkomst, waar we actief over gingen nadenken: in kolomgeoriënteerde databases worden gegevens, zoals je kunt begrijpen, in kolommen opgeslagen, en als je naar onze gegevens kijkt, zie je gemakkelijk een groot aantal duplicaten, die in het geval van het gebruik van een kolomgeoriënteerde database gecomprimeerd konden worden.
Toch bleef het cruciale systeem van het bedrijf stabiel functioneren, en we wilden niet experimenteren met de overstap naar iets anders.
In 2017, at the Percona Live conference in San Jose, the developers of Clickhouse probably introduced themselves for the first time. At first glance, the system seemed production-ready (after all, Yandex.Metrica is serious production), support was quick and straightforward, and most importantly, operation was simple. Since 2018, we started the transition process. However, by that time, there were many 'mature' and time-tested TSDB systems, and we decided to take a significant amount of time to compare alternatives to ensure that there were no alternatives to Clickhouse that met our requirements.
In addition to the requirements already specified for the storage, new ones have emerged:
- the new system must provide at least the same performance as MySQL on the same hardware;
- the storage of the new system should take up significantly less space;
- the DBMS must still be easy to manage;
- we wanted to change the application as little as possible when switching databases.
Which systems did we start considering
Apache Hive/Apache Impala
A well-established Hadoop stack. Essentially, this is a SQL interface built on top of data stored in proprietary formats on HDFS.
Advantages.
- With stable operation, it is very easy to scale data.
- There are columnar data storage solutions (less space).
- Very fast execution of parallelized tasks when resources are available.
Cons.
- It’s Hadoop, and it’s complex to operate. If we are not ready to take a ready-made solution in the cloud (and we are not ready due to cost), the entire stack will have to be assembled and maintained by admins, which is something we really don’t want.
- Data aggregates .
However:
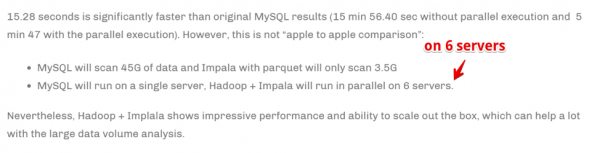
Speed is achieved by scaling the number of computing servers. Simply put, if we are a large company engaged in analytics and it is critically important for the business to aggregate information as quickly as possible (even at the cost of using a large amount of computational resources), this may be our choice. But we were not ready to drastically increase our hardware capacity for task execution speed.
Druid/Pinot
Now much more about specifically TSDB, but again — a Hadoop stack.
Er is .
In a few words: Druid/Pinot appear better than Clickhouse in cases where:
- U heeft een heterogene gegevensstructuur (in ons geval registreren we alleen tijdreeksen van servermetriek, en in wezen is dit één tabel. Maar er kunnen ook andere gevallen zijn: tijdreeksen van apparatuur, economische tijdreeksen, enz. — elk met zijn eigen structuur die verzameld en verwerkt moet worden).
- Er is echter heel veel van deze gegevens.
- Tafels en gegevens met tijdreeksen komen en gaan (dat wil zeggen, een bepaalde set gegevens komt binnen, wordt geanalyseerd en verwijderd).
- Er is geen duidelijke criteria waarop gegevens gepartitioneerd kunnen worden.
In de tegenovergestelde gevallen presteert ClickHouse beter, en dat is ons geval.
ClickHouse
- SQL-achtig.
- Eenvoudig in het beheer.
- Mensen zeggen dat het werkt.
Komt op de shortlist voor testen.
InfluxDB
Buitenlandse alternatieve voor ClickHouse. Nadelen: High Availability is alleen beschikbaar in de commerciële versie, maar dat moet worden vergeleken.
Komt op de shortlist voor testen.
Cassandra
Aan de andere kant weten we dat het wordt gebruikt voor het opslaan van metrische tijdreeksen door monitoring systemen zoals bijvoorbeeld, of OkMeter. Er zijn echter specifieke details.
Cassandra is geen kolomgebaseerde database in de gebruikelijke zin. Het lijkt meer op een rij-gebaseerde, maar in elke rij kan een verschillend aantal kolommen zitten, waardoor een kolomachtige weergave gemakkelijk kan worden georganiseerd. In dit opzicht is het begrijpelijk dat met een limiet van 2 miljard kolommen bepaalde gegevens juist in kolommen kunnen worden opgeslagen (dezelfde tijdreeksen). Bijvoorbeeld, MySQL heeft een limiet van 4096 kolommen en daar kun je gemakkelijk een fout met code 1117 tegenkomen als je probeert hetzelfde te doen.
De Cassandra-engine is gericht op het opslaan van grote hoeveelheden gegevens in een gedistribueerd systeem zonder een master, en volgens de eerder genoemde CAP-theorema is Cassandra meer gericht op AP, dat wil zeggen, op gegevensbeschikbaarheid en weerstand tegen partitionering. Hierdoor kan dit hulpmiddel uitstekend geschikt zijn als je alleen naar deze database wilt schrijven en er voldoende zelden uit leest. Het is logisch om Cassandra te gebruiken als een 'koud' opslagmedium. Dit betekent dat het functioneert als een langdurige betrouwbare opslagplaats voor grote hoeveelheden historische data die zelden nodig zijn, maar indien nodig kunnen worden opgehaald. Niettemin, om een compleet beeld te krijgen, zullen we het ook testen. Maar, zoals ik eerder zei, is er geen verlangen om de code actief aan te passen aan de gekozen database-oplossing, dus we zullen het vrij beperkt testen - zonder de database-structuur aan te passen aan de specificaties van Cassandra.
Prometheus
Uit nieuwsgierigheid hebben we besloten om de prestaties van de Prometheus-opslag te testen - gewoon om te begrijpen of we sneller zijn dan de huidige oplossingen of trager, en in welke mate.
Testmethodologie en resultaten
We hebben 5 databases getest in de volgende 6 configuraties: ClickHouse (1 node), ClickHouse (gedistribueerde tabel op 3 nodes), InfluxDB, Mysql 8, Cassandra (3 nodes) en Prometheus. Het testplan is als volgt:
- we laden historische gegevens van een week (840 miljoen waarden per dag; 208 duizend metrics);
- we genereren schrijfbelasting (we beschouwden 6 belastingmodi, zie hieronder);
- tijdens het schrijven doen we af en toe selecties om gebruikersverzoeken na te simuleren, terwijl ze met grafieken werken. Om het niet te gecompliceerd te maken, kozen we gegevens van 10 metrics (precies het aantal dat op de CPU-grafiek staat) voor een week.
We maken een belasting na die het gedrag simuleert van onze monitoringagent, die elke 15 seconden waarden naar elke metric verzendt. Hierbij is het voor ons interessant om te variëren:
- het totale aantal metrics waarin gegevens worden geschreven;
- de verzendinterval van waarden naar eenmetric;
- de batchgrootte.
Over de batchgrootte. Aangezien de meeste van onze proefdatabases niet aanbevolen zijn voor belasting met enkele inserts, hebben we een relay nodig dat de binnenkomende metrics verzamelt en ze op enige wijze groepeert en ze als batchinsert in de database schrijft.
Ook om beter te begrijpen hoe we de verkregen gegevens later moeten interpreteren, laten we ons voorstellen dat we niet gewoon een hoop metrics verzenden, maar dat de metrics zijn georganiseerd in servers — 125 metrics per server. Hier is de server gewoon een virtuele entiteit — alleen om te begrijpen dat bijvoorbeeld 10.000 metrics ongeveer overeenkomen met 80 servers.
En dus, rekening houdend met dit alles, zijn hier onze 6 schrijf laadmodi voor de database:
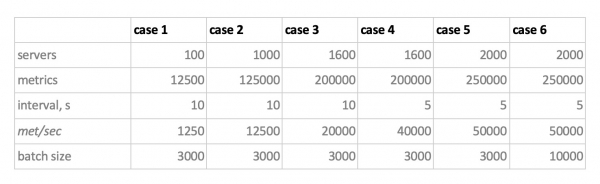
Er zijn hier twee aspecten. Ten eerste bleken dergelijke batchgroottes voor Cassandra te groot, daar gebruikten we waarden van 50 of 100. Ten tweede, aangezien Prometheus strikt in pull-modus werkt, dat wil zeggen dat het zelf gegevens ophaalt van metrics bronnen (en zelfs pushgateway, ondanks zijn naam, verandert de situatie fundamenteel niet), werden de bijbehorende belastingen gerealiseerd door een combinatie van statische configuraties.
De testresultaten zijn als volgt:
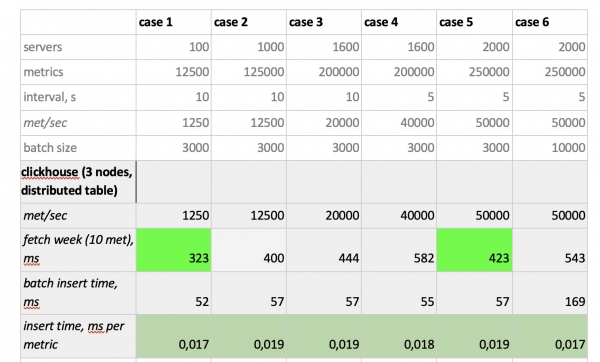
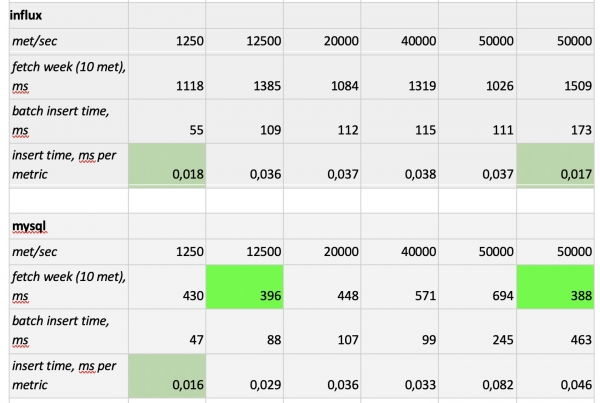
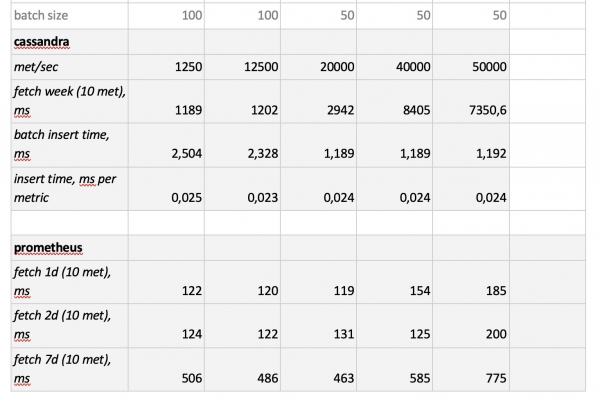
Wat opvalt: ongelooflijk snelle queries uit Prometheus, verschrikkelijk trage queries uit Cassandra, onacceptabel trage queries uit InfluxDB; ClickHouse was de snelste wat betreft schrijfsnelheid, en Prometheus doet hier niet aan mee omdat het inserts zelf intern uitvoert en we niets meten.
Uiteindelijk: ClickHouse en InfluxDB presteerden het beste, maar een cluster van Influx kan alleen worden opgebouwd op basis van de Enterprise-versie, die geld kost, terwijl ClickHouse niets kost en in Rusland is ontwikkeld. Het is logisch dat in de VS de keuze waarschijnlijk naar InfluxDB gaat, terwijl wij de voorkeur geven aan ClickHouse.
Bron: habr.com
