

De essentie van het verhaal over de meest populaire pakketbeheerder voor Kubernetes kan worden weergegeven met behulp van emoji's:
- doos — dat is Helm (dat is de meest geschikte term in de laatste Emoji-release);
- slot — veiligheid;
- mannetje — oplossing van het probleem.
In werkelijkheid is het echter iets ingewikkelder, en het verhaal zit vol technische details over hoe Helm veilig te maken.
- Kortom, wat is Helm, als je het niet wist of vergeten was. Welke problemen lost het op en waar bevindt het zich in het ecosysteem.
- Laten we de architectuur van Helm bekijken. Geen gesprek over veiligheid en hoe je een tool of oplossing veiliger kunt maken, kan zonder begrip van de componentarchitectuur.
- Laten we de componenten van Helm bespreken.
- De meest urgente vraag — toekomst — de nieuwe versie Helm 3.
Alles in dit artikel betreft Helm 2. Deze versie is momenteel in productie en het is waarschijnlijk dat jij deze momenteel gebruikt, en hierin zitten veiligheidsrisico's.
Over de spreker: Alexander Hayorov () is al 10 jaar bezig met ontwikkelen en helpt content verbeteren en is toegetreden tot het comité . Hij werkt momenteel bij Chainstack als development lead — dat is een hybride rol tussen een ontwikkelingsleider en iemand die verantwoordelijk is voor de levering van eindproducten. Dat wil zeggen, hij is op de frontlinie, waar alles gebeurt van productcreatie tot exploitatie.
Chainstack is een klein, snelgroeiend startup met als doel klanten de mogelijkheid te bieden om de infrastructuur en de complexiteit van gedecentraliseerde applicaties te vergeten, het ontwikkelingsteam bevindt zich in Singapore. Vraag Chainstack niet om cryptocurrency te kopen of verkopen, maar stel voor om te praten over enterprise blockchain frameworks, en je krijgt graag een antwoord.
Helm
Het is een pakketbeheerder (charts) voor Kubernetes. De meest duidelijke en universële manier om applicaties naar een Kubernetes-cluster te brengen.
Het gaat natuurlijk om een meer gestructureerde en industriële benadering dan het maken van je eigen YAML-manifesten en het schrijven van kleine hulpprogramma's.
Helm is het beste dat momenteel beschikbaar en populair is.
Waarom Helm? In de eerste plaats omdat het wordt ondersteund door de CNCF. Cloud Native is een grote organisatie, de moedermaatschappij van projecten zoals Kubernetes, etcd, Fluentd en anderen.
Een ander belangrijk feit is dat Helm een zeer populair project is. Toen ik in januari 2019 begon na te denken over hoe ik Helm veilig kon maken, had het project 1000 sterren op GitHub. Tegen mei waren dat er 12.000.
Veel mensen zijn geïnteresseerd in Helm, en zelfs als je het nog niet gebruikt, kunnen de kennis over de veiligheid ervan van pas komen. Veiligheid is belangrijk.
Het hoofdteam van Helm wordt ondersteund door Microsoft Azure, en daarom is het een redelijk stabiel project in tegenstelling tot veel andere. De release van Helm 3 Alpha 2 in het midden van juli getuigt ervan dat er genoeg mensen aan het project werken, en dat zij de wil en de kracht hebben om Helm te ontwikkelen en te verbeteren.
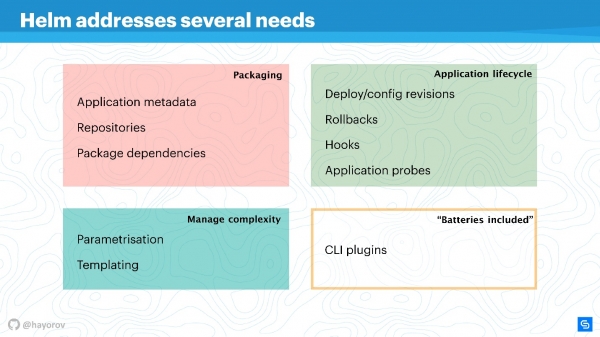
Helm lost verschillende fundamentele problemen op met betrekking tot applicatiebeheer in Kubernetes.
- Applicatie-pakettering. Zelfs een applicatie als 'Hello, World' op WordPress bestaat uit verschillende diensten, en je wilt ze graag samenpakken.
- Beheer van de complexiteit die voortkomt uit het managen van deze applicaties.
- De levenscyclus die niet eindigt na de installatie of het uitrollen van de applicatie. Het blijft leven, het moet worden bijgewerkt, en Helm helpt daarbij en probeert de juiste maatregelen en beleidslijnen hiervoor te bieden.
Pakettering is op een begrijpelijke manier ingericht: er zijn metadata in volledige overeenstemming met de werking van een gewone pakketbeheerder voor Linux, Windows of MacOS. Dat wil zeggen, een repository, afhankelijkheden van verschillende pakketten, metadata voor applicaties, instellingen, configuratie-eisen, indexering van informatie, enzovoort. Dit alles kan Helm genereren en gebruiken voor applicaties.
Beheer van complexiteit. Als je veel soortgelijke applicaties hebt, is parameterisatie nodig. Hieruit ontstaan sjablonen, maar om niet je eigen manier van het maken van sjablonen te bedenken, kun je gebruikmaken van wat Helm standaard biedt.
Applicatie levenscyclusbeheer is naar mijn mening de meest interessante en onopgeloste kwestie. Dat is de reden waarom ik destijds naar Helm kwam. We moesten de levenscyclus van de applicatie volgen en we wilden onze CI/CD en applicatiecycli in deze paradigma overbrengen.
Helm maakt het mogelijk:
- implementaties te beheren, introduceert het concept van configuratie en revisies;
- succesvol rollback uit te voeren;
- hooks te gebruiken voor verschillende gebeurtenissen;
- extra controles voor applicaties toe te voegen en erop te reageren.
Daarnaast Helm heeft "batterijen" — een enorme hoeveelheid smakelijke dingen die als plug-ins kunnen worden opgenomen en het leven kunnen vereenvoudigen. Plug-ins kunnen zelf worden geschreven, ze zijn voldoende geïsoleerd en vereisen geen strikte architectuur. Als je iets wilt implementeren, raad ik aan dit als een plug-in te doen en het later misschien aan upstream toe te voegen.
Helm is gebaseerd op drie belangrijke concepten:
- Chart Repo — een beschrijving en een array van parameterinstellingen die mogelijk zijn voor jouw manifest.
- Config — dat wil zeggen de waarden die toegepast zullen worden (tekst, numerieke waarden, enz.).
- Release verzamelt beide bovenste componenten, en samen vormen ze een Release. Releases kunnen worden versiebeheer, waardoor de levenscyclus georganiseerd kan worden: klein op het moment van installatie en groot op het moment van upgrade, downgrade of rollback.
Architectuur van Helm
In het schema wordt de high-level architectuur van Helm conceptueel weergegeven.
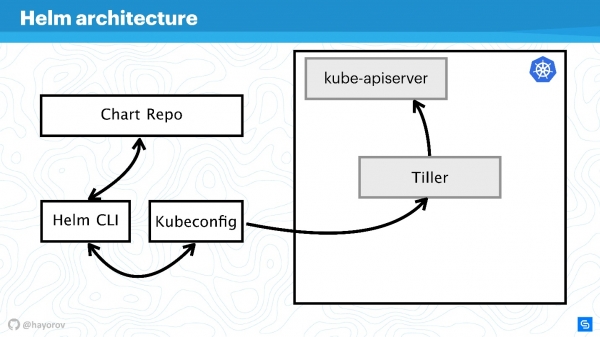
Ter herinnering, Helm is iets dat verband houdt met Kubernetes. Daarom kunnen we niet zonder een Kubernetes-cluster (rechthoek). De kube-apiserver component bevindt zich op de master. Zonder Helm hebben we Kubeconfig. Helm brengt een klein binair, als je het zo kunt noemen, Hulpmiddel Helm CLI met zich mee, dat op een computer, laptop, mainframe - op alles kan worden geïnstalleerd.
Maar dat is niet genoeg. Helm heeft een servercomponent genaamd Tiller. Hij vertegenwoordigt de belangen van Helm binnen het cluster, het is een applicatie binnen het Kubernetes-cluster, net als elke andere.
De volgende component Chart Repo — een repository met charts. Er is een officiële repository en er kan een privérepository van een bedrijf of project zijn.
Interacties
Laten we kijken hoe de componenten van de architectuur interactie hebben wanneer we een applicatie willen installeren met behulp van Helm.
- We zeggen
Helm install, we wenden ons tot de repository (Chart Repo) en krijgen de Helm-chart.
- De Helm-tool (Helm CLI) communiceert met Kubeconfig om te achterhalen naar welk cluster we moeten verwijzen.
- Nadat deze informatie is verkregen, vraagt de tool Tiller, die zich al als een applicatie in ons cluster bevindt.
- Tiller neemt contact op met de Kube-apiserver om acties in Kubernetes uit te voeren, enkele objecten (services, pods, replica's, secrets, enz.) te creëren.
Vervolgens zullen we het schema compliceren om de aanvalsvector te zien waaraan de hele architectuur van Helm blootgesteld kan worden. En daarna zullen we proberen het te beschermen.
Aanvalsvector
De eerste potentiële zwakke plek — geprivilegieerde API—gebruiker. In het kader van dit schema is dit een hacker die admin-toegang heeft gekregen tot Helm CLI.
Een niet-bevoorrechte API-gebruiker kan ook een gevaar vormen als hij ergens in de buurt is. Deze gebruiker heeft een andere context, bijvoorbeeld hij kan in één namespace van het cluster zijn vastgelegd in de Kubeconfig-instellingen.
De meest interessante aanvalsvector kan het proces zijn dat zich binnen het cluster bevindt, ergens in de buurt van Tiller en er verbinding mee kan maken. Dit kan een webserver of microservice zijn die het netwerk van het cluster ziet.
Een exotische, maar steeds populairder wordende, aanvalsmethode is gerelateerd aan Chart Repo. Een chart, gemaakt door een kwaadwillende auteur, kan onveilige resources bevatten, en je draait deze uit, vertrouwend op wat er staat. Of hij kan de chart vervangen die je downloadt van de officiële repository, en bijvoorbeeld een resource in de vorm van beleidsregels creëren en zo zijn toegang verhogen.
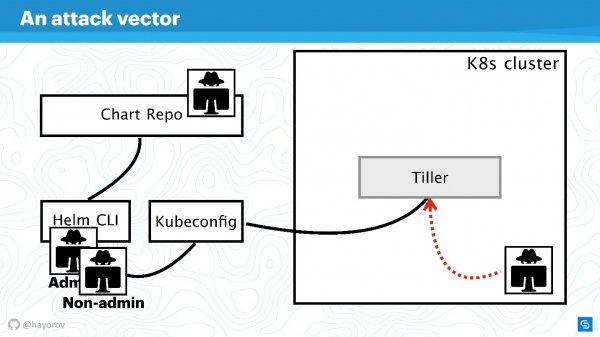
Laten we proberen ons te verdedigen tegen aanvallen vanuit al deze vier hoeken en begrijpen waar de problemen in de architectuur van Helm liggen, en waar misschien niet.
Laten we het schema uitbreiden, meer elementen toevoegen, maar alle basiscomponenten behouden.
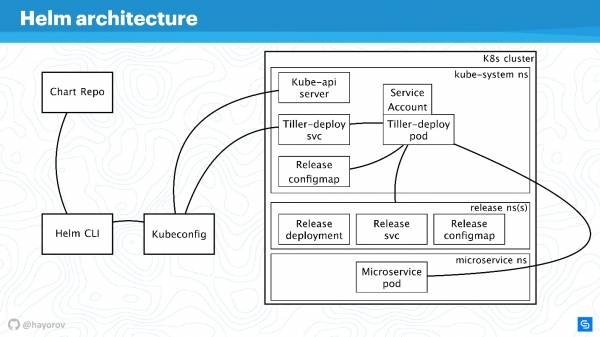
Helm CLI communiceert met Chart Repo, interactie met Kubeconfig, en de job wordt doorgegeven aan het cluster in de component Tiller.
Tiller is vertegenwoordigd door twee objecten:
- Tiller-deploy svc, dat een bepaalde service exposeert;
- Tiller-deploy pod (op de schema in een enkel exemplaar in één replica), waarop alle belasting draait en die naar het cluster communiceert.
Voor interactie worden verschillende protocollen en schema's gebruikt. Vanuit veiligheidsperspectief zijn we vooral geïnteresseerd in:
- Het mechanisme waarmee Helm CLI verbinding maakt met de chart repo: welk protocol, is er authenticatie en wat kun je daarmee doen.
- Het protocol waarlangs Helm CLI, met behulp van kubectl, communiceert met Tiller. Dit is een RPC-server die binnen het cluster is geïnstalleerd.
- Tiller zelf is beschikbaar voor microservices die zich binnen het cluster bevinden en communiceert met Kube-apiserver.
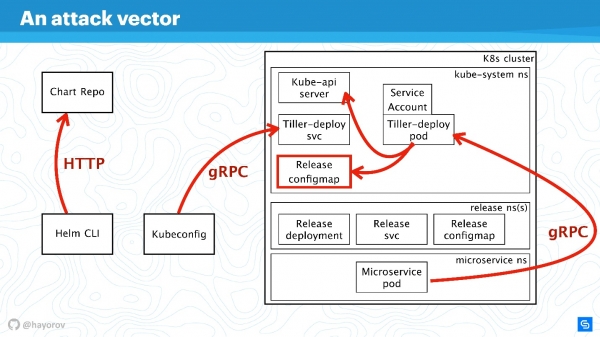
Laten we al deze richtingen één voor één bespreken.
RBAC
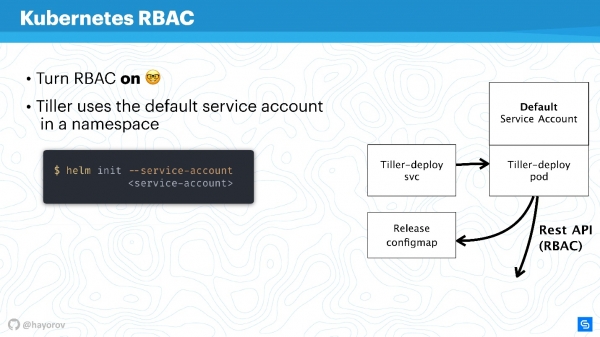
Het heeft geen zin om over enige veiligheid van Helm of een andere service binnen het cluster te spreken als RBAC niet is ingeschakeld.
Het lijkt misschien niet de meest recente aanbeveling, maar ik ben ervan overtuigd dat velen RBAC zelfs in productie nog niet hebben ingeschakeld, omdat het veel gedoe met zich meebrengt en er veel moet worden ingesteld. Desondanks moedig ik aan dit te doen.
— advocatensite voor RBAC. Hier is een enorme hoeveelheid interessante materialen verzameld die helpen om RBAC in te stellen, laten zien waarom het goed is en hoe je er in de productie in het algemeen mee kunt leven.
Ik zal proberen uit te leggen hoe Tiller en RBAC werken. Tiller werkt binnen de cluster onder een bepaalde service-account. Gewoonlijk, als RBAC niet is ingesteld, is dit een supergebruiker. In de basisconfiguratie is Tiller een admin. Daarom wordt vaak gezegd dat Tiller een SSH-tunnel naar je cluster is. Dat is in wezen zo, daarom kun je in de bovenstaande schematische weergave een aparte gespecialiseerde service-account gebruiken in plaats van het Default Service Account.
Wanneer je Helm initialiseert, en het voor het eerst op de server installeert, kun je een service-account opgeven met --service-account. Dit stelt je in staat om een gebruiker met de minimaal noodzakelijke set rechten te gebruiken. Je moet echter zo'n "keten" creëren: Role en RoleBinding.
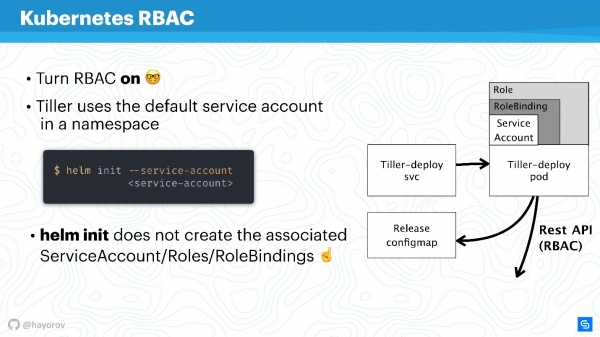
Helaas zal Helm dit niet voor je doen. Jij of je Kubernetes-clusteradmin moet van tevoren een set Role en RoleBinding voor de service-account voorbereiden om deze aan Helm over te dragen.
Er rijst de vraag — wat is het verschil tussen Role en ClusterRole? Het verschil is dat ClusterRole werkt voor alle namespaces, in tegenstelling tot de reguliere Role en RoleBinding, die alleen werken voor een specifieke namespace. Je kunt beleidsregels instellen voor de hele cluster en alle namespaces, evenals gepersonaliseerd voor elke specifieke namespace afzonderlijk.
Het is vermeldenswaard dat RBAC ook een ander groot probleem oplost. Veel mensen klagen dat Helm, helaas, geen multitenancy ondersteunt. Als meerdere teams de cluster gebruiken en Helm gebruiken, is het in principe onmogelijk om beleidsregels in te stellen en hun toegang binnen deze cluster te scheiden, omdat er een bepaalde service-account is waaronder Helm draait, en hij maakt alle middelen in de cluster aan vanuit deze account, wat soms zeer ongemakkelijk is. Dit is inderdaad het geval — net als het binaire bestand zelf, zoals het proces, Helm Tiller heeft geen begrip van multitenancy..
Er is echter een geweldige manier om Tiller meerdere keren in de cluster uit te voeren. Dit is geen probleem; Tiller kan in elke namespace worden uitgevoerd. Op die manier kun je gebruik maken van RBAC, Kubeconfig als context, en de toegang tot specifieke Helm beperken.
Dit zal er als volgt uitzien.
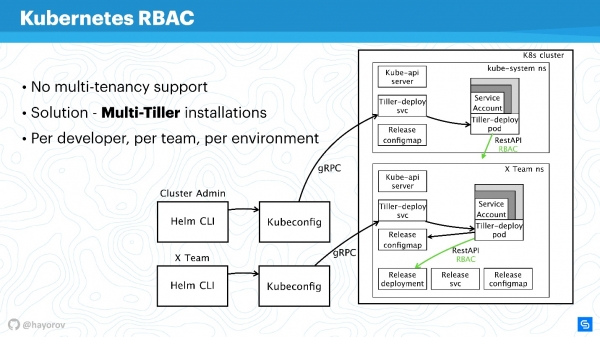
Bijvoorbeeld, er zijn twee Kubeconfig-bestanden met context voor verschillende teams (twee namespaces): Team X voor het ontwikkelteam en de admin-cluster. De admin-cluster heeft zijn eigen brede Tiller, die zich in de Kube-system namespace bevindt, en heeft daarom een geavanceerde service-account. En er is een aparte namespace voor het ontwikkelteam, waar zij hun diensten in de speciale namespace kunnen implementeren.
Dit is een werkbare aanpak, Tiller is niet zo veeleisend dat het uw budget aanzienlijk beïnvloedt. Dit is een van de snelle oplossingen.
Aarzel niet om Tiller apart in te stellen en Kubeconfig met context te verstrekken voor het team, voor een specifieke ontwikkelaar of voor de omgevingen: Dev, Staging, Production (het is onwaarschijnlijk dat alles op één cluster komt te staan, maar het is mogelijk).
Terugkomend op ons verhaal, schakelen we van RBAC naar ConfigMaps.
ConfigMaps
Helm gebruikt ConfigMaps als gegevensopslag. Toen we het over de architectuur hadden, was er geen database waarin informatie over releases, configuraties, rollbacks enz. werd opgeslagen. Hiervoor worden ConfigMaps gebruikt.
Het voornaamste probleem met ConfigMaps is bekend - ze zijn in principe onveilig, omdat ze geen gevoelige gegevens kunnen opslaan. Dit betreft alles wat niet verder dan de service mag komen, zoals wachtwoorden. De meest native manier voor Helm nu is om over te stappen van het gebruik van ConfigMaps naar secrets.
Dit wordt heel eenvoudig gedaan. U stelt de Tiller-configuratie opnieuw in en geeft aan dat de opslag secrets zullen zijn. Dan ontvangt u bij elke implementatie geen ConfigMap, maar een secret.
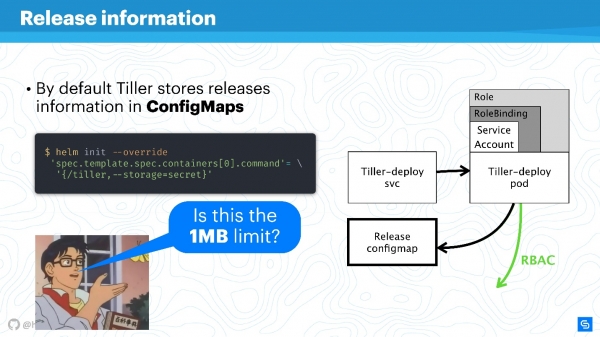
U zou kunnen tegenwerpen dat de secrets zelf een vreemde concept zijn en dat dit niet erg veilig is. Het is echter belangrijk te begrijpen dat dit wordt gedaan door de ontwikkelaars van Kubernetes zelf. Sinds versie 1.10, dat is al een tijd geleden, is het mogelijk om in ieder geval in openbare clouds de juiste opslag te verbinden voor het opslaan van secrets. Het team werkt momenteel aan manieren om de toegang tot secrets verder te verbeteren voor afzonderlijke pods of andere entiteiten.
Het is beter om de opslag Helm naar secrets te verplaatsen en deze centraal te beveiligen.
Natuurlijk blijft er een limiet voor opslag van gegevens van 1 MB.. Helm gebruikt hier etcd als een gedistribueerde opslag voor ConfigMaps. Ze hebben vastgesteld dat dit een geschikte datachunk is voor replicaties, enzovoort. Er is hierover een interessante discussie op Reddit, ik raad aan om dit grappige leesvoer in het weekend te vinden of de samenvatting te lezen. .
Chart Repos
Charts zijn het meest kwetsbaar op sociaal vlak en kunnen een bron van 'Man in the Middle' worden, vooral als je een standaardoplossing gebruikt. Het gaat vooral om de repos die via HTTP worden aangeboden.
Zeker, je moet Helm Repo via HTTPS aanbieden — dat is de beste optie en het kost niet veel.
Let op de mechanisme van chart handtekeningen. De technologie is belachelijk eenvoudig. Het is hetzelfde als wat je op GitHub gebruikt, gewoon de reguliere PGP-machine met publieke en private sleutels. Stel dit in en je kunt zeker zijn, met de juiste sleutels en door alles te ondertekenen dat het echt jouw chart is.
Daarnaast Helm-client ondersteunt TLS (niet in de zin van HTTP van de serverzijde, maar wederzijds TLS). Je kunt server- en clientsleutels gebruiken om te communiceren. Ik zeg eerlijk, ik gebruik deze mechanismen niet vanwege een gebrek aan waardering voor wederzijdse certificaten. In principe, — de belangrijkste tool voor het aanbieden van Helm Repo voor Helm 2 — ondersteunt ook basic auth. Je kunt basic auth gebruiken als dat handiger en rustiger is.
Er is ook een plugin , die het mogelijk maakt om Chart Repos op Google Cloud Storage te hosten. Dit is heel handig, werkt uitstekend en is voldoende veilig, omdat alle beschreven mechanismen worden gebruikt.
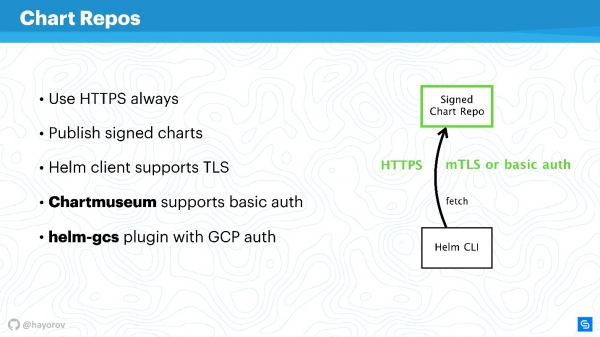
Als je HTTPS of TLS inschakelt, mTLS gebruikt, en basic auth activeert om de risico's verder te verlagen, krijg je een veilige communicatielijn tussen Helm CLI en Chart Repo.
gRPC API
De volgende stap is zeer verantwoordelijk — zorg voor de beveiliging van Tiller, die zich in het cluster bevindt en aan de ene kant een server is, terwijl hij aan de andere kant zelf naar andere componenten gaat en probeert zich voor te doen als iemand anders.
Zoals ik al zei, Tiller is een service die gRPC aanbiedt, de Helm-client komt via gRPC bij hem. Standaard is TLS natuurlijk uitgeschakeld. Waarom dit is gedaan, is een discussiepunt, ik denk dat het is om de configuratie aan het begin te vereenvoudigen.
Voor productie en zelfs voor staging raad ik aan TLS op gRPC in te schakelen.
Naar mijn mening is dit, in tegenstelling tot mTLS voor charts, hier passend en heel eenvoudig te realiseren — je genereert de PQI-infrastructuur, maakt een certificaat aan, start Tiller en geeft het certificaat door tijdens de initialisatie. Daarna kun je alle Helm-commando's uitvoeren met het gegenereerde certificaat en de privé-sleutel.
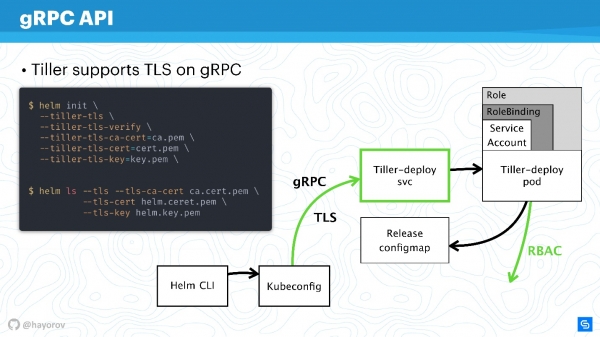
Op deze manier beveilig je jezelf tegen alle verzoeken aan Tiller van buitenaf het cluster.
Dus we hebben de verbindingskanaal naar Tiller beveiligd, hebben RBAC al besproken en de rechten van de Kubernetes apiserver aangepast, en het domein verkleind waarmee het kan communiceren.
Beveiligde Helm
Laten we eens kijken naar het uiteindelijke schema. Dit is dezelfde architectuur met dezelfde pijlen.
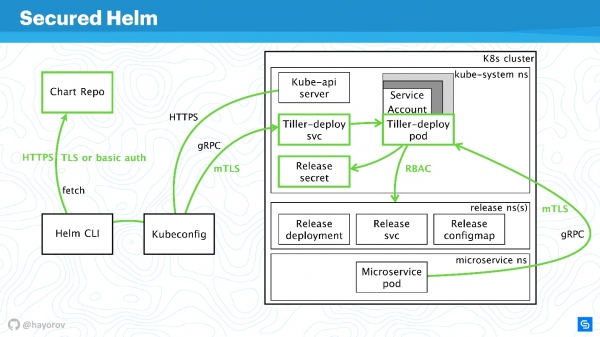
Alle verbindingen kunnen nu met vertrouwen groen worden getekend:
- voor Chart Repo gebruiken we TLS of mTLS en basic auth;
- mTLS voor Tiller, en hij is opgezet als gRPC-service met TLS, we gebruiken certificaten;
- er wordt een speciale service-account binnen het cluster gebruikt met Role en RoleBinding.
We hebben het cluster aanzienlijk beveiligd, maar iemand slim zei:
«Er is maar één absoluut veilige oplossing — een uitgeschakelld computer die in een betonnen doos zit en door soldaten wordt bewaakt».
Er zijn verschillende manieren om met gegevens te manipuleren en nieuwe aanvalsvectoren te vinden. Maar ik ben ervan overtuigd dat deze aanbevelingen helpen om een basis industriestandaard voor veiligheid te realiseren.
Bonus
Dit gedeelte is niet direct gerelateerd aan beveiliging, maar het zal ook nuttig zijn. Ik zal enkele interessante dingen laten zien waarvan niet veel mensen weten. Bijvoorbeeld, hoe je charts zoekt — officiële en niet-officiële.
In de repository er zijn momenteel ongeveer 300 charts en twee streams: stable en incubator. Wie bijdraagt weet heel goed hoe moeilijk het is om van incubator naar stable te komen, en hoe makkelijk het is om uit stable te vallen. Maar dit is niet de beste tool om charts voor Prometheus en alles wat je leuk vindt te zoeken, om één eenvoudige reden — het is geen portal waar je gemakkelijk pakketten kunt zoeken.
Maar er is een service , waarmee je charts veel gemakkelijker kunt vinden. Het belangrijkste is dat er veel meer externe repositories zijn en bijna 800 charts beschikbaar zijn. Plus, je kunt je eigen repository aansluiten, als je om welke reden dan ook je charts niet naar stable wilt sturen.
Probeer hub.helm.sh en laten we het samen ontwikkelen. Deze service valt onder het Helm-project en je kunt zelfs bijdragen aan de UI, als je frontend ontwikkelaar bent en gewoon het uiterlijk wilt verbeteren.
Ik wil ook uw aandacht vestigen op Open Service Broker API-integratie. Klinkt rommelig en onduidelijk, maar het lost problemen op waarmee iedereen wordt geconfronteerd. Laat me het uitleggen met een eenvoudig voorbeeld.
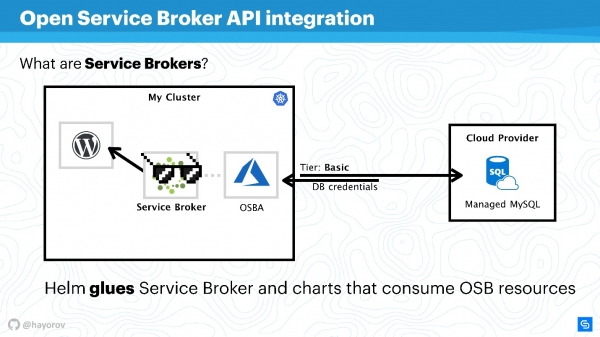
Stel je voor dat er een Kubernetes-cluster is waarin we een klassiek applicatie willen draaien — WordPress. Gewoonlijk is er een database nodig voor volledige functionaliteit. Er zijn veel verschillende oplossingen, bijvoorbeeld, je kunt je eigen stateful service draaien. Dit is niet erg handig, maar veel mensen doen het zo.
Anderen, zoals wij bij Chainstack, gebruiken managed databases, bijvoorbeeld MySQL of PostgreSQL, voor servers. Daarom bevinden onze databases zich ergens in de cloud.
Maar er is een probleem: we moeten onze service koppelen aan de database, een database flavor creëren, referenties doorgeven en deze op de een of andere manier beheren. Dit wordt meestal handmatig gedaan door een systeembeheerder of ontwikkelaar. En er is geen probleem wanneer er maar weinig applicaties zijn. Wanneer er veel zijn, heb je een combine nodig. Zo'n combine bestaat — het is de Service Broker. Het stelt je in staat om een speciale plugin voor een publiek cloud cluster te gebruiken en middelen bij de provider te bestellen via de Broker, alsof het een API is. Hiervoor kun je de native middelen van Kubernetes gebruiken.
Het is heel eenvoudig. Je kunt bijvoorbeeld Managed MySQL in Azure aanvragen met een basis tier (dit is instelbaar). Met gebruik van de Azure API zal de database worden aangemaakt en voorbereid voor gebruik. Je hoeft hier niet in te grijpen; de plugin zorgt daarvoor. Bijvoorbeeld, OSBA (de Azure-plugin) zal de referenties teruggeven aan de service en deze naar Helm doorgeven. Je kunt WordPress gebruiken met cloud MySQL, zonder je druk te maken over managed databases of stateful services van binnenuit.
Je zou kunnen zeggen dat Helm fungeert als de lijm die aan de ene kant de services implementeert en aan de andere kant de resources van cloudproviders verbruikt.
Je kunt je eigen plugin schrijven en al deze historie on-premise gebruiken. Dan heb je gewoon je eigen plugin voor de bedrijfscloudprovider. Ik raad aan om deze aanpak te proberen, vooral als je grote schaal hebt en je snel dev, staging of de volledige infrastructuur voor een functie wilt opzetten. Dit zal het leven van je operations of DevOps vereenvoudigen.
Een andere ontdekking die ik al heb genoemd, is de helm-gcs plugin, die het mogelijk maakt om Google-buckets (object storage) te gebruiken voor het opslaan van Helm-charts.
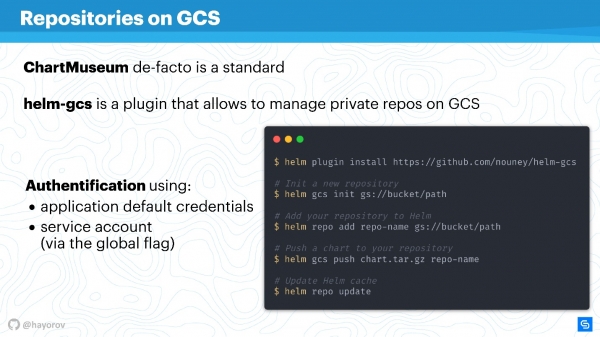
Je hebt maar vier opdrachten nodig om het te gaan gebruiken:
- installeer de plugin;
- initieer het;
- een pad instellen naar de bucket die zich in GCP bevindt;
- publiceer de charts op de gebruikelijke manier.
Het mooie is dat de native methode van GCP voor autorisatie zal worden gebruikt. Je kunt een service-account, ontwikkelaarsaccount gebruiken - wat dan ook. Dit is erg handig en kost niets om te gebruiken. Als je, net als ik, de opsless-filosofie promoot, zal dit heel handig zijn, vooral voor kleine teams.
Alternatieven
Helm is niet de enige oplossing voor het beheren van services. Er zijn veel vragen over, waarschijnlijk daarom is versie drie zo snel verschenen. Natuurlijk zijn er alternatieven.
Dit kunnen zowel gespecialiseerde oplossingen zijn, zoals Ksonnet of Metaparticle. Je kunt ook je klassieke infrastructuurbeheertools (Ansible, Terraform, Chef, etc.) gebruiken voor dezelfde doelen waarover ik sprak.
Ten slotte is er een oplossing , waarvan de populariteit toeneemt.
Operator Framework is de belangrijkste alternatieve voor Helm, die je in de gaten moet houden.
Het is meer native voor CNCF en Kubernetes, maar de instapdrempel is veel hoger, je moet meer programmeren en minder manifesten beschrijven.
Er zijn verschillende addons, zoals Draft, Scaffold. Ze vergemakkelijken het leven aanzienlijk, bijvoorbeeld voor ontwikkelaars die de cyclus van het verzenden en uitvoeren van Helm voor de implementatie van testomgevingen vereenvoudigen. Ik zou ze als capaciteitsversterkers beschouwen.
Hier is een duidelijke grafiek over waar alles zich bevindt.
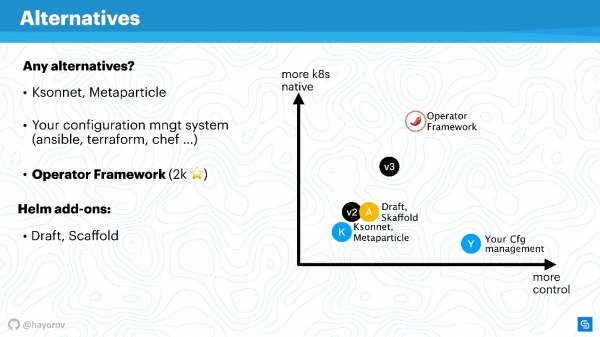
Op de horizontale as het niveau van jouw persoonlijke controle over wat er gebeurt, op de verticale as - het niveau van nativiteit van Kubernetes. Helm versie 2 bevindt zich ergens in het midden. In versie 3 zijn de verbeteringen niet enorm, maar zowel de controle als het niveau van nativiteit zijn verbeterd. Oplossingen zoals Ksonnet zijn nog steeds inferieur aan zelfs Helm 2. Maar het is de moeite waard om ze te bekijken om te weten wat er nog meer in deze wereld is. Natuurlijk heb je jouw configuratiemanagement onder controle, maar het is absoluut niet native voor Kubernetes.
Operator Framework is absoluut native voor Kubernetes en laat je het veel eleganter en grondiger beheren (maar vergeet de instapdrempel niet). Het is eerder geschikt voor gespecialiseerde applicaties en het creëren van hun management, dan voor een massale machine om een groot aantal applicaties te verpakken met behulp van Helm.
Capaciteitsversterkers verbeteren gewoon iets de controle, aanvullen de workflow of snijden de hoeken van CI/CD pipelines.
De toekomst van Helm
Het goede nieuws is dat Helm 3 eraan komt. De alpha-versie Helm 3.0.0-alpha.2 is uitgebracht en kan worden geprobeerd. Het is vrij stabiel, maar de functionaliteit is momenteel beperkt.
Waarom is Helm 3 nodig? In de eerste plaats gaat het om het verdwijnen van Tiller, als component. Dit is, zoals je al begrijpt, een enorme stap voorwaarts, omdat het vanuit beveiligingsarchitectuurperspectief alles vereenvoudigt.
Toen Helm 2 werd ontwikkeld, en dat was in de tijd van Kubernetes 1.8 of zelfs eerder, waren veel concepten onvolwassen. Bijvoorbeeld, het concept van CRD wordt nu actief geïmplementeerd, en Helm zal CRD gebruiken, om structs op te slaan. Het zal mogelijk zijn om alleen de client te gebruiken en het servergedeelte niet te hosten. Bijgevolg kunnen native Kubernetes-commando's worden gebruikt om met structs en middelen te werken. Dit is een enorme stap voorwaarts.
Er zal ondersteuning zijn voor native OCI-repositories (Open Container Initiative). Dit is een enorme initiatief, en Helm is er in de eerste plaats voor geïnteresseerd om zijn charts te hosten. Het gaat zelfs zover dat bijvoorbeeld Docker Hub veel OCI-normen ondersteunt. Ik wil niet te ver vooruitlopen, maar het is mogelijk dat traditionele Docker-repositories beginnen de mogelijkheid te bieden om je eigen Helm-charts te hosten.
Een controversieel punt voor mij is de ondersteuning van Lua, als templating engine voor het schrijven van scripts. Ik ben geen grote fan van Lua, maar dit zal een volledig optionele mogelijkheid zijn. Ik heb het drie keer gecontroleerd - het gebruik van Lua zal niet verplicht zijn. Daarom kan degene die dat wil Lua gebruiken, terwijl degenen die van Go houden - sluite je aan bij onze grote groep en gebruik go-tmpl hiervoor.
Eindelijk, wat ik absoluut miste, is de introductie van schema's en de validatie van datatypes. Er zullen geen problemen meer zijn met int of string, en je hoeft nul niet in dubbele aanhalingstekens te plaatsen. Er komt een JSON-schema dat dit expliciet voor values zal beschrijven.
Het event-driven model zal sterk worden herzien . Het is al conceptueel beschreven. Kijk in de Helm 3-tak en je zult zien hoeveel evenementen, hooks en andere zaken zijn toegevoegd, die het proces van deploying en de reacties daarop sterk zullen vereenvoudigen en tegelijkertijd meer controle zullen bieden.Helm 3 zal eenvoudiger, veiliger en interessanter zijn, niet omdat we Helm 2 niet leuk vinden, maar omdat Kubernetes geavanceerder wordt. Dit betekent dat Helm de innovaties van Kubernetes kan gebruiken en er geweldige managers voor Kubernetes mee kan creëren.
Helm 3 wordt eenvoudiger, veiliger en interessanter, niet omdat we Helm 2 niet leuk vinden, maar omdat Kubernetes geavanceerder wordt. Hierdoor kan Helm de ontwikkelingen van Kubernetes benutten en geweldige beheertools voor Kubernetes creëren.
Nog een goed nieuwtje is dat Alexander Khayev zal vertellen, Ter herinnering, de conferentie over de integratie van ontwikkelings-, test- en operationele processen vindt plaats in Moskou op 30 september en 1 oktober. Tot 20 augustus is het nog mogelijk om en uw ervaring met het oplossen van uitdagingen van de DevOps-aanpak te delen.
Volg de checkpoints van de conferentie en het laatste nieuws via en .
Bron: habr.com
