

Ik zag een publicatie waarin stond dat PVS eindelijk geleerd heeft te analyseren onder Linux, en besloot het uit te proberen op mijn projecten. En dit is wat eruit kwam.
Inhoud
Responsieve ondersteuning
Ik vroeg om een proeflicentie en kreeg deze dezelfde dag nog toegestuurd.
Duidelijke documentatie
Het is gelukt om de analyzer zonder grote problemen te starten. Er is ook hulp voor de consolecommando's (hoewel hier kritieken op zijn, zie sectie ).
Mogelijkheid voor multithread analyse
De analyzer heeft een 'standaard' optie -j, waarmee analyse parallel in meerdere taken kan worden uitgevoerd. Dit bespaart veel tijd.
Goede visualisatie
Veel verschillende outputformaten, van tekst tot een kleine webinterface. .
Eenvoudige integratie in de build.
Alle documentatie is op hun website te vinden. Ik kan alleen zeggen dat als je project met CMake wordt gebouwd, het heel eenvoudig is.
Goede beschrijvingen van diagnoses
Als je output genereert in de modus fullhtml, heeft elk bericht een link naar de beschrijving van de diagnose, met uitleg, codevoorbeelden en aanvullende links.
Het niet kennen door de analyzer van de C++ taal
Helaas maakt PVS soms fouten in de syntaxis en genereert het fout-positieve berichten bij volledig correcte code.
Bijvoorbeeld, er is een functie die teruggeeft void:
template <typename T>
auto copy (const void * source, void * destination)
    ->
        std::enable_if_t
        <
            std::is_copy_constructible<T>::value
        >
{
    new (destination) T(*static_cast<const T *>(source));
}
Ja, het sleutelwoord auto kan betekenen void, daarom is het ook auto. Maar PVS gaf de volgende berichten:
dynamic_tuple_management.hpp:29:1: error: V591 Non-void function should return a value.
dynamic_tuple_management.hpp:29:1: error: V2542 Function with a non-void return type should return a value from all exit paths.
Zeer trage website
Ja, in de webinterface is er naast elk bericht een link naar de bijbehorende diagnosebeschrijving met voorbeelden. Maar het duurt vrij lang om te wachten op de link, en soms krijg je zelfs een .
Taal
Alle beschrijvingen zijn er in het Russisch, dat is geweldig. Maar de links in het rapport leiden altijd naar de Engelse versie. Het zou fijn zijn om de mogelijkheid te hebben om de taal te schakelen, zodat je diagnoses meteen in het Russisch kunt bekijken. In de interface heb ik die mogelijkheid niet gevonden.
Het is ongemakkelijk om met de diagnostieken via de console te werken.
Laten we beginnen met het feit dat de twee gebruikte commando's (dit is pvs-studio-analyzer en plog-converter) verschillende formaten hebben voor het geven van diagnosen.
De hulp bij pvs-studio-analyzer zegt:
-a [MODE], --analysis-mode [MODE]
    MODE definieert het type waarschuwingen:
    1 - 64-bits fouten;
    2 - gereserveerd;
    4 - Algemene Analyse;
    8 - Micro-optimalisaties;
    16 - Klantspecifieke Verzoeken;
    32 - MISRA.
    Modus kan worden gecombineerd door de waarden op te tellen.
    Standaard: 4
Ik heb lang geprobeerd te begrijpen waar toegevoegd ("adding the values") sleutels moesten worden.
pvs-studio-analyzer analyze ... -a 1,4,16Ik heb geprobeerd de sleutel meerdere keren op te schrijven:
pvs-studio-analyzer analyze ... -a 1 -a 4 -a 16En pas daarna realiseerde ik me dat dit bitmaskers zijn! En dat je moet optellen, en niet toegevoegd waarden. Bijvoorbeeld, om algemene diagnosen, diagnosen over micro-optimalisaties en MISRA te krijgen, moet je ze optellen (4 + 8 + 32 = 44):
pvs-studio-analyzer analyze ... -a 44Het gebruik van bitmaskers in gebruikersinterfaces is doorgaans een slechte gewoonte. Dit kon allemaal intern worden opgeteld, en de gebruiker gewoon een set vlaggen geven.
Daarnaast is er een andere tool plog-converter, die leesbare informatie genereert over statische analyse. Het heeft andere eigenaardigheden.
De hulp bij het programma plog-converter meldt:
-a, --analyzer            Geeft de analyzer(s) en niveau(s) aan die
geselecteerd moeten worden voor filtering, d.w.z.
"GA:1,2;64:1;OP:1,2,3;CS:1;MISRA:1,2"
Standaard: GA:1,2
Hier zijn enige "niveaus" verschenen die er eerder nergens waren, en ik heb er ook niets over kunnen vinden in de documentatie.
Over het algemeen is het onduidelijk. Daarom stelde ik alles maximaal in.
Een hoop nutteloze fouten op Catch
In twee van de drie projecten die ik analyseerde, wordt de module-testbibliotheek . En een groot deel van de berichten (!!! 90 van de 138 in één en 297 van de 344 in het andere !!!) hebben de volgende vorm:
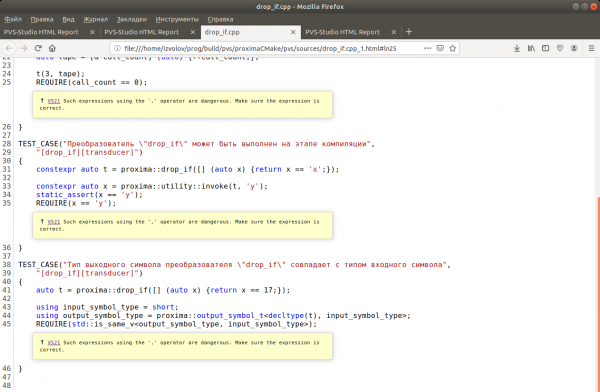
Negeert multithreading
Veel falsen positieve aanroddelingen over blijkbaar onveranderlijke variabelen of oneindige lussen, terwijl de gegevens variabelen uit verschillende threads worden aangeraakt, en als dat niet het geval was, zouden de module-tests niet afgaan.
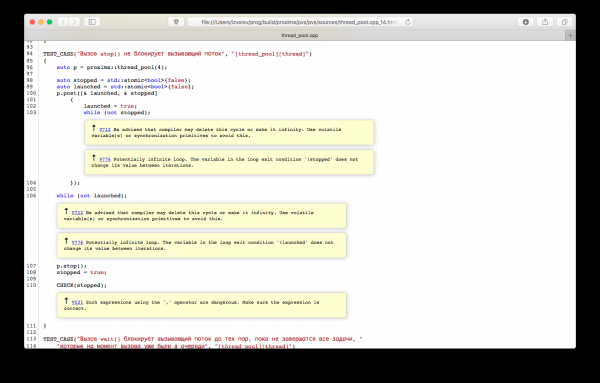
Kan een statische analyzer dit überhaupt in overweging nemen? Ik weet het niet.
PVS vond geen enkele echte fout in mijn open projecten en , en ook niet in het werkproject dat ik, om begrijpelijke redenen, niet kan tonen. Maar het is belangrijk om te vermelden dat sommige tekortkomingen eerder al waren gecorrigeerd. en .
Over het algemeen is de indruk van al deze analyzers ongeveer hetzelfde: ja, ze vangen iets, soms zelfs iets belangrijks, maar over het algemeen is de compiler voldoende.
Misschien (en persoonlijk vind ik het prettig om zo te denken) dat ons team ontwikkelpraktijken gebruikt die een minimale hoeveelheid rommelcode genereren. Het is beter om problemen te voorkomen dan om ze heroïsch te overwinnen.
Daarom neem ik de vrijheid om een paar tips te geven over hoe je in C++ kunt coderen zonder iemand zichzelf in de voet te schieten of met een hark op het hoofd te slaan.
Gebruik de compilerdiagnoses zoveel mogelijk.
Ons team gebruikt (en raden jullie aan) de volgende compileeropties:
-Werror

-Wall
-Wextra
-Wpedantic

-Wcast-align
-Wcast-qual
-Wconversion
-Wctor-dtor-privacy
-Wenum-compare
-Wfloat-equal
-Wnon-virtual-dtor
-Wold-style-cast
-Woverloaded-virtual
-Wredundant-decls
-Wsign-conversion
-Wsign-promo
Neem ze op in je project, je leert veel over je code.
Volg de standaard.
Probeer platformafhankelijke dingen te vermijden als er standaardalternatieven zijn, en als je echt niet zonder kunt, verpak ze dan in speciale blokken onder macro's (of iets anders) en zorg ervoor dat je code niet wordt gecompileerd in niet-ondersteunde omstandigheden.
Volg de standaard semantiek van operaties.
Optelling moet optelling zijn, vermenigvuldiging moet vermenigvuldiging zijn, een functie-aanroep moet een functie-aanroep zijn, kopiëren moet kopiëren, verplaatsen moet verplaatsen, een container moet iterabel zijn, een iterator moet vooruit kunnen bewegen ++ en ontleden. *. En zo verder, en zo verder.
Ik denk dat de boodschap duidelijk is. Er zijn gevestigde conventies die niet verplicht zijn om te volgen, maar waarvan alle gebruikers en lezers van je code verwachten dat ze aanwezig zijn. Probeer niet anderen te slim af te zijn, anders maak je het jezelf moeilijk.
Schrijf compatibele code.
In de eerste plaats bedoel ik de standaardbibliotheek. Het is zeer wenselijk dat de interfaces van je klassen en functies kunnen worden gebruikt met standaard- en andere bibliotheken (zoals Boost).
Wees niet bang om naar de interfaces van STL en Boost te kijken. Met zeldzame uitzonderingen zie je daar een waardig voorbeeld om na te volgen.
Gebruik open tools zoveel mogelijk.
Voor dezelfde statische analyse zijn er minstens twee gratis open-source tools die met één klik op elk project met een CMake-bouwsysteem kunnen worden aangesloten.
.
Tot slot wil ik benadrukken dat ik niet aanmoedig om PVS of andere statische analyzers niet te gebruiken. Maar ik moedig aan om na te denken over hoe het komt dat de statische analyzer voortdurend aanzienlijke fouten in uw code vindt.
Dit is slechts een gevolg. We moeten de oorzaak zoeken en aanpakken.
Bron: habr.com
