

Opmerking vertaler.: De auteur van dit materiaal is Cindy Sridharan, een ingenieur van imgix, die zich bezighoudt met API-ontwikkeling en in het bijzonder met het testen van microservices. In dit materiaal deelt ze haar uitgebreide visie op de actuele problemen op het gebied van gedistribueerde traceerbaarheid, waar volgens haar een gebrek aan echt effectieve tools bestaat om dringende problemen op te lossen.
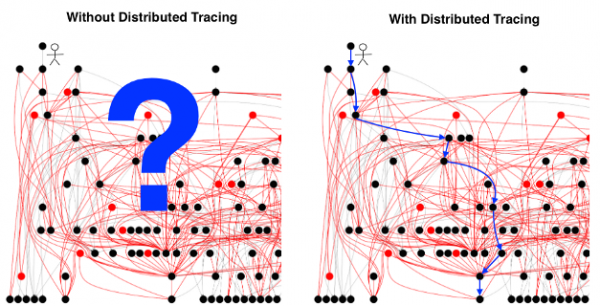
[Illustratie ontleend aan over gedistribueerde traceerbaarheid.]
Er wordt aangenomen dat moeilijk te implementeren is, en de opbrengst ervan . De 'problematiek' van traceerbaarheid wordt verklaard door tal van redenen, waarbij vaak wordt verwezen naar de arbeidsintensievere configuratie van elke component van het systeem voor het verzenden van de juiste headers met elke aanvraag. Hoewel dit probleem inderdaad aanwezig is, kan het niet als onoverkomelijk worden beschouwd. Het verklaart overigens niet waarom ontwikkelaars traceerbaarheid (zelfs al werkende) niet erg waarderen.
De grootste moeilijkheid bij gedistribueerde traceerbaarheid is niet het verzamelen van gegevens, niet de standaardisatie van distributie- en presentatietypes, en niet het bepalen wanneer, waar en hoe steekproeven moeten worden genomen. Ik probeer zeker niet deze 'gebruiksvriendelijkheidsproblemen' te presenteren als triviaal — er zijn in feite behoorlijk significante technische en (als we echt Open Source) ) politieke uitdagingen die moeten worden overwonnen voordat deze problemen als opgelost kunnen worden beschouwd.
Maar als we aannemen dat al deze problemen zijn opgelost, is de kans groot dat er op het gebied van de eindgebruikerservaringin wezen niets verandert. Traceerbaarheid brengt mogelijk nog steeds geen praktische voordelen met zich mee in de meest voorkomende foutopsporingsscenario's — zelfs nadat het is uitgerold.
Zo'n ongebruikelijke traceerbaarheid
Gedistribueerde traceerbaarheid omvat verschillende losse componenten:
- het uitrusten van applicaties en middleware met controlemechanismen;
- het overdragen van gedistribueerde context;
- het verzamelen van traceerlogs;
- het opslaan van traceerlogs;
- hun extractie en visualisatie.
Veel gesprekken over gedistribueerde tracing komen neer op het beschouwen ervan als een eenzijdige operatie, waarvan het enige doel is om volledige systeemdiagnose te ondersteunen. Dit heeft veel te maken met hoe historisch gezien het begrip gedistribueerde tracing is gevormd. , gedaan tijdens de openstelling van de Zipkin-bronnen, werd vermeld dat het [Zipkin] Twitter sneller maakt.De eerste commerciële aanbiedingen voor tracing werden ook gepromoot als .
Opmerking vertaler.Om de onderstaande tekst beter te begrijpen, definiëren we twee basisbegrippen volgens :
- Span — het basiselement van gedistribueerde tracing. Dit is een beschrijving van een bepaalde werkstroom (bijvoorbeeld een database-aanroep) met een naam, begintijd en eindtijd, tags, logs en context.
- Span's bevatten meestal verwijzingen naar andere span's, wat het mogelijk maakt om meerdere span's te combineren in Trace — een visualisatie van het levenspad van een verzoek tijdens zijn verplaatsing door een gedistribueerd systeem.
Traces bevatten ongelooflijk waardevolle gegevens die kunnen helpen bij taken zoals: testen in productie, uitvoeren van rampenhersteltests, testen met foutinjecties, enzovoort. Sommige bedrijven gebruiken tracing al voor dergelijke doeleinden. Laten we beginnen met het feit dat andere toepassingen heeft dan alleen het eenvoudig overbrengen van span's naar een opslag systeem:
- Bijvoorbeeld, Uber maakt tracingresultaten gebruik om testverkeer en productieverkeer te scheiden.
- Facebook De gegevens van trace's voor het analyseren van de kritieke pad en voor het omleiden van verkeer tijdens reguliere rampenhersteltests.
- Ook het sociale netwerk Jupyter-notebooks, waarmee ontwikkelaars willekeurige queries op de tracingresultaten kunnen uitvoeren.
- Voorstanders van (Lineage Driven Failure Injection) gebruik maken van gedistribueerde trace's voor testdoeleinden met foutinjecties.
Geen van de bovengenoemde opties betreft volledig een scenario debugging,waarin een ingenieur probeert een probleem op te lossen door naar de trace te kijken.
Als het toch op debugging aan komt, blijft het primaire interfase het diagram traceview (hoewel sommigen het ook een ‘Gantt-diagram’ of ‘cascade-diagram’). Onder traceview ik alle span' s en bijbehorende metadata die samen een trace vormen. Elk systeem voor traceerin met open bron, evenals elke commerciële trace-oplossing, biedt gebaseerd op traceview een gebruikersinterface voor visualisatie, detaillering en filtering van traces.
Het probleem met alle trace-systemen die ik tot nu toe heb bekeken, is dat de uiteindelijke visualisatie (traceview) bijna volledig de kenmerken van het genereren van de trace weerspiegelt. Zelfs wanneer alternatieve visualisaties worden aangeboden: intensiteitskaarten (heatmap), service-topologieën, latency-histogrammen — uiteindelijk komen ze allemaal neer op traceview.
In het verleden heb ik dat de meeste "innovaties" op het gebied van tracing met betrekking tot UI/UX schijnbaar beperkt blijven tot van extra metadata in de trace, het inbedden van informatie met een hoge kardinaliteit (high-cardinality) of de mogelijkheid bieden om specifieke spans te detailleren of verzoeken uit te voeren tussen en binnen traces. Daarbij traceview blijft het de voornaamste visualisatiemiddel. Zolang deze situatie aanhoudt, zal gedistribueerde tracing (in het beste geval) de 4e plaats innemen als debugger-tool, achter metrics, logs en stack traces, en in het slechtste geval een volkomen verspilling van geld en tijd blijken te zijn.
Het probleem met traceview
Het doel traceview is om een volledig beeld te geven van de beweging van een individuele aanvraag door alle componenten van het gedistribueerde systeem waarmee hij verband houdt. Sommige geavanceerdere trace-systemen bieden de mogelijkheid om specifieke spans te detailleren en een tijdsverdeling te bekijken binnenin van één proces (wanneer spans functionele grenzen hebben).
De basispremisse van de microservices-architectuur is het idee dat de organisatorische structuur meegroeid met de behoeften van het bedrijf. Voorstanders van microservices beweren dat het verdelen van verschillende zakelijke taken over aparte services kleine, autonome teams van ontwikkelaars in staat stelt om de volledige levenscyclus van deze services te beheersen, wat hun in staat stelt om zelfstandig deze services te creëren, te testen en uit te rollen. Een nadeel van deze verdeling is echter het verlies van informatie over hoe elke service met andere interacteert. In deze omstandigheden is gedistribueerde tracing een onmisbaar instrument voor debugging, complexe interacties tussen services.
Als u echt , dan kan geen enkele persoon de volledige afbeelding in zijn hoofd houden. In feite is het ontwikkelen van een tool op basis van de veronderstelling dat dit überhaupt mogelijk is, iets als een antipatroon (een ineffectieve en onproductieve aanpak). Idealiter is er een tool nodig voor debugging die helpt om het zoekgebied te verfijnen, zodat ingenieurs zich kunnen concentreren op een subset van metingen (services/gebruikers/historie etc.) die relevant zijn voor het probleemscenario dat aan de orde is. Bij het achterhalen van de oorzaak van een storing hoeven ingenieurs niet te begrijpen wat er in alle services tegelijkgebeurde, aangezien zo'n vereiste in strijd zou zijn met het principe van microservices-architectuur.
Traceview vertegenwoordigt echter juist dit. Ja, sommige tracing-systemen bieden samengedrukte traceview aan wanneer het aantal spans in een trace zo groot is dat ze niet in één visualisatie kunnen worden weergegeven. Echter, door de grote hoeveelheid informatie die zelfs in zo'n verkorte visualisatie aanwezig is, moeten ingenieurs nog steeds doorzoeken en handmatig de sample verfijnen tot een set van probleemveroorzakende services. Helaas zijn machines hierin aanzienlijk sneller dan mensen, minder foutgevoelig en geven ze meer repetitieve resultaten. Een andere reden waarom ik denk dat de traceview-methode verkeerd is, is dat deze slecht geschikt is voor hypothese-gebaseerde debugging. In wezen is debugging een
Een andere reden waarom ik de traceview-methode verkeerd vind, is dat deze slecht geschikt is voor hypothesebezorgde debugging. Fundamenteler gezien is debugging een iteratief Een proces dat begint met een hypothese, gevolgd door de controle van verschillende waarnemingen en feiten verkregen van het systeem over verschillende vectoren, conclusies/samenvattingen en verdere beoordeling van de juistheid van de hypothese.
Mogelijkheid snel en goedkoop hypothesen testen en dienovereenkomstig de mentale model verbeteren is de hoeksteen van debugging. Elke debuggingtool moet interactief zijn en de zoekruimte verkleinen of, in het geval van een valse aanroep, de gebruiker in staat stellen om terug te keren en zich op een ander deel van het systeem te concentreren. Het ideale instrument zou dit proactief, onmiddellijk de aandacht van de gebruiker vestigen op potentiële probleemgebieden.
Helaas, traceview kan het niet worden beschouwd als een instrument met een interactieve interface. Het beste dat men kan hopen bij het gebruik ervan, is een bron van verhoogde latentie te ontdekken en alle mogelijke tags en logs die ermee verband houden te bekijken. Dit helpt de ingenieur niet om patronen in het verkeer te identificeren, zoals de specificiteit van het latentieëndistributie, of correlaties tussen verschillende metingen te ontdekken. kan helpen sommige van deze problemen te omzeilen. Inderdaad, van succesvolle analyses met behulp van machine learning om afwijkende spans te identificeren en een subset van tags te identificeren die mogelijk verband houden met afwijkend gedrag. Desondanks heb ik nog geen overtuigende visualisaties gezien van de bevindingen die zijn gemaakt met behulp van machine learning of data-analyse toegepast op spans, die significant verschillen van traceview of DAG (gerichte acyclische grafiek).
Spans zijn te laag-niveau
Het fundamentele probleem met traceview is dat spans te laag-niveau primitief zijn voor zowel latentieanalyse als oorzaak-analyse. Het is alsof men individuele processorcommando's analyseert in een poging een uitzondering op te lossen, terwijl men weet dat er veel hogere niveau tools zoals backtrace zijn, die veel gemakkelijker te gebruiken zijn.
Bovendien durf ik het volgende te beweren: idealiter hebben we helemaal geen volledig overzicht nodig die plaatsvond tijdens de levenscyclus van de aanvraag, die moderne hulpmiddelen voor tracing vertegenwoordigen. In plaats daarvan is er een vorm van abstractie op een hoger niveau vereist, die informatie bevat over hetgeen er misging (evenals een beetje context). In plaats van de hele trace te observeren, kijk ik liever naar dat gedeelte, waar iets interessants of ongewoons gebeurt. Momenteel gebeurt de zoektocht handmatig: de ingenieur ontvangt de trace en analyseert zelf de spans op zoek naar iets interessants. De aanpak waarbij mensen naar spans in afzonderlijke traces staren in de hoop verdachte activiteit te ontdekken, schaalt absoluut niet (vooral wanneer ze alle metadata moeten begrijpen die in verschillende spans gecodeerd zijn, zoals span ID, RPC-methode naam, duur van de span, logs, tags, enzovoort).
Alternatieven voor traceview
De resultaten van tracing zijn het meest nuttig wanneer ze zo kunnen worden gevisualiseerd dat er een niet-triviale representatie ontstaat van wat er gebeurt in de onderling verbonden delen van het systeem. Totdat dat er niet is, blijft het debuggen in grote mate inert en afhankelijk van het vermogen van de gebruiker om de juiste correlaties op te merken, de juiste delen van het systeem te controleren of de stukjes van de puzzel aan elkaar te voegen — in tegenstelling tot tool, wat de gebruiker helpt om deze hypothesen te formuleren.
Ik ben geen visueel ontwerper en geen UX-specialist, maar in de volgende sectie wil ik enkele ideeën delen over hoe dergelijke visualisaties eruit zouden kunnen zien.
Focus op specifieke diensten
In een situatie waarin de sector consolideert rond ideeën , lijkt het redelijk dat afzonderlijke teams in de eerste plaats moeten toezien op de overeenstemming van hun diensten met deze doelen. Dit leidt tot het feit dat de service-georiënteerde visualisatie het beste is voor dergelijke teams.
Traces, vooral zonder sampling, zijn een schat aan informatie over elk component van een gedistribueerd systeem. Deze informatie kan worden gevoed aan een slimme processor, die de gebruikers zal voorzien van service-georiënteerde inzichten. Ze kunnen van tevoren worden onthuld — nog voordat de gebruiker naar de traces kijkt:
- Verdeling van latentie-diagrammen alleen voor sterk afwijkende verzoeken (afwijkende verzoeken);
- Verdeling van latentie-diagrammen voor gevallen waarin de SLO-doelen van de service niet worden gehaald;
- De meest ‘gewone’, ‘interessante’ en ‘vreemde’ tags in verzoeken die het vaakst herhaald worden;
- Verdeling van latentie voor gevallen waarin afhankelijkheden van de service de gestelde SLO-doelen niet halen;
- Verdeling van latentie over verschillende downstream services.
Sommige van deze vragen kunnen simpelweg niet door ingebouwde metrics worden beantwoord, waardoor gebruikers zorgvuldig de spans moeten onderzoeken. Dit resulteert in een uiterst gebruiksvriendelijke mechanism.
Hierdoor rijst de vraag: hoe zit het met de complexe interacties tussen verschillende services die door verschillende teams worden beheerd? Is dit niet traceview de meest geschikte tool om een dergelijke situatie weer te geven?
Mobiele ontwikkelaars, eigenaren van stateless-services, eigenaren van beheerde stateful-services (zoals databases) en platform-eigenaren kunnen geïnteresseerd zijn in een andere weergave van een gedistribueerd systeem; traceview dit is een te algemene oplossing voor deze fundamenteel verschillende behoeften. Zelfs in een zeer complexe microservices-architectuur hebben service-eigenaren geen diepgaande kennis nodig van meer dan twee of drie upstream en downstream services. In wezen is het voor gebruikers in de meeste scenario's voldoende om de vragen te beantwoorden die betrekking hebben op een beperkte set services.
Dit lijkt op het bekijken van een klein subsubset van services door een vergrootglas voor nauwkeurig onderzoek. Dit stelt de gebruiker in staat om relevantere vragen te stellen over de complexe interactie tussen deze services en hun directe afhankelijkheden. Dit is vergelijkbaar met een backtrace in de wereld van services, waar een ingenieur weet, we gaan laden, kunnen we vertellen hoe we dit gaan doen: hoe het niet is, maar ook een beter begrip heeft van wat er zich afspeelt in de omliggende services, om te begrijpen, waarom.
De door mij voorgestelde aanpak is het volledige tegenovergestelde van de 'top-down'-benadering, die gebaseerd is op traceview, waarbij de analyse begint met de volledige trace en vervolgens geleidelijk naar individuele spans gaat. Integendeel, de 'bottom-up'-aanpak begint met de analyse van een klein deel, dicht bij de mogelijke oorzaak van het incident, en breidt vervolgens het zoekgebied uit indien nodig (met mogelijke betrokkenheid van andere teams om een breder scala aan services te analyseren). Deze tweede aanpak is beter geschikt voor het snel verifiëren van initieel hypothesen. Na het verkrijgen van concrete resultaten kan men verder gaan met een meer gerichte en gedetailleerde analyse.
Topologie opbouwen
Specifiek verbonden weergaven kunnen ongelooflijk nuttig zijn als de gebruiker weet, welke service of groep services verantwoordelijk is voor de toegenomen latenties of de bron van fouten is. Echter, in een complexe omgeving kan het identificeren van de foutieve service een niet-triviale taak zijn tijdens een storing, vooral als er geen foutmeldingen van de services binnenkomen.
Het opbouwen van service-topologieën kan enorm helpen bij het vaststellen welke service een stijging van de foutfrequentie of een toename van de latentie vertoont, wat leidt tot een merkbare verslechtering van de serviceprestaties. Als we het hebben over het opbouwen van topologie, bedoel ik niet een kaart van services, die elke beschikbare service in het systeem weergeeft en bekend is om zijn . Deze voorstelling is niet beter dan traceview op basis van een gerichte acyclische grafiek. In plaats daarvan zou ik graag willen zien dynamisch gegenereerde service-topologieën, gebaseerd op specifieke attributen zoals foutfrequentie, responsetijd of op een gebruikersgedefinieerde parameter die helpt om de situatie met specifieke verdachte services te verduidelijken.
Laten we een voorbeeld bekijken. Stel je een hypothetische nieuwssite voor. De hoofdpagina service (front page) de gegevens uitwisselt met Redis, de aanbevelingsdienst, de advertentiedienst en de videoservice. De videoservice haalt video's van S3, terwijl de metadata uit DynamoDB komt. De aanbevelingsdienst krijgt metadata uit DynamoDB, laadt gegevens uit Redis en MySQL, en schrijft berichten naar Kafka. De advertentiedienst krijgt gegevens uit MySQL en schrijft berichten naar Kafka.
Hieronder staat een schematische weergave van deze topologie (topologie wordt vaak opgebouwd door commerciële programma's voor tracing). Dit kan nuttig zijn als men wil begrijpen hoe de diensten met elkaar verbonden zijn. Echter, tijdens debugging,, wanneer een bepaalde dienst (bijvoorbeeld de videoservice) een verhoogde responstijd vertoont, is zo'n topologie niet erg nuttig.
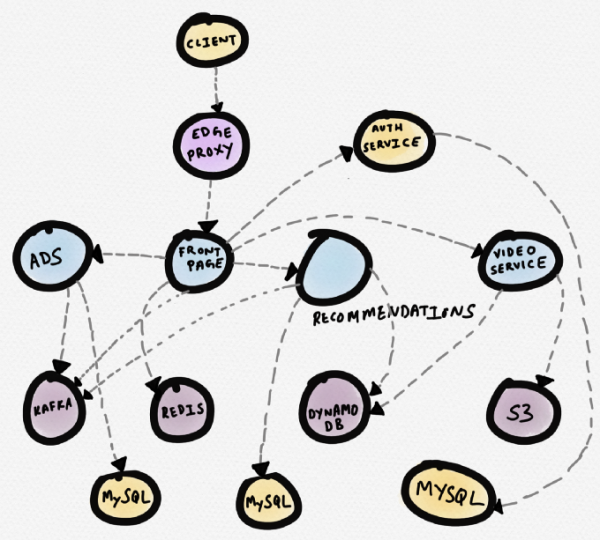
Schema van diensten van een hypothetische nieuwssite
Een diagram, zoals hieronder weergegeven, zou beter zijn. Hierin is de probleemdienst (video) recht in het midden afgebeeld. De gebruiker merkt het meteen op. Uit deze visualisatie blijkt dat de videoservice abnormaal functioneert door de verhoogde responstijd van S3, wat de laadsnelheid van een deel van de homepage beïnvloedt.
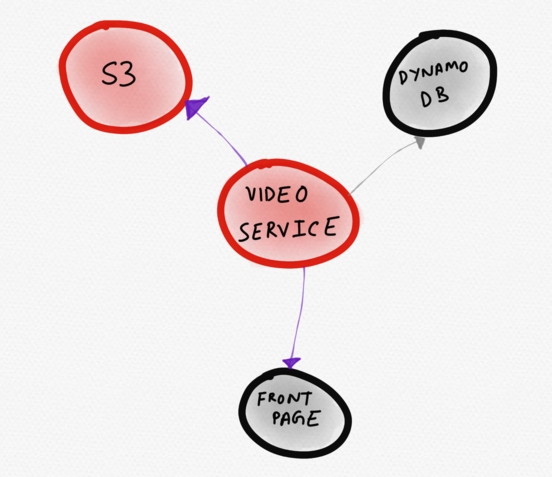
Dynamische topologie die alleen «interessante» diensten weergeeft
Dynamisch gegenereerde topologische diagrammen kunnen effectiever blijken dan statische kaarten van diensten, vooral in elastische, auto-schaalbare infrastructuren. De mogelijkheid om topologieën van diensten te vergelijken en af te stemmen, stelt de gebruiker in staat relevantere vragen te stellen. Nauwkeurigere vragen over het systeem leiden waarschijnlijker tot een beter begrip van hoe het systeem werkt.
Vergelijkende weergave
Een andere nuttige visualisatie zou een vergelijkende weergave zijn. Momenteel zijn traces niet erg geschikt voor zij aan zij vergelijking, dus worden meestal vergeleken spans. Het belangrijkste idee van dit artikel is dat spans te laag niveau zijn om de meest waardevolle informatie uit de trace-resultaten te halen.
Het vergelijken van twee traces vereist geen fundamenteel nieuwe visualisaties. Eigenlijk is iets als een histogram, dat dezelfde informatie biedt als traceview, voldoende. Het is verwonderlijk, maar zelfs deze eenvoudige methode kan veel meer opleveren dan het afzonderlijk bestuderen van twee traces. Een nog krachtigere mogelijkheid zou zijn visualiseren vergelijking van traces in totaal. Het zou uiterst nuttig zijn om te zien hoe een recent uitgerolde wijziging in de databaseconfiguratie met ingeschakelde GC (garbage collection) de responstijd van de downstream-service beïnvloedt over meerdere uren. Als wat ik hier beschrijf lijkt op een A/B-analyse van de impact van infrastructurele veranderingen, in meerdere diensten met behulp van de trace-resultaten, dan ben je niet ver van de waarheid.
Conclusie
Ik twijfel niet aan de nuttigheid van tracing zelf. Ik geloof oprecht dat er geen andere methode is om zulke rijke, causale en contextuele gegevens te verzamelen als die in een trace. Echter, ik denk ook dat alle tracingoplossingen deze gegevens extreem inefficiënt gebruiken. Zolang tracing-tools gefocust blijven op een traceview-weergave, zullen ze beperkt zijn in hun vermogen om de waardevolle informatie die uit de gegevens in traces kan worden gehaald, maximaal te benutten. Bovendien bestaat het risico van de verdere ontwikkeling van een volslagen onvriendelijke en niet-intuïtieve visuele interface, die de mogelijkheid van de gebruiker om problemen in de applicatie op te lossen, sterk zal beperken.
Debuggen van complexe systemen, zelfs met de nieuwste tools, is ongelooflijk moeilijk. Tools moeten de ontwikkelaar helpen bij het formuleren en testen van hypothesen, terwijl ze actief relevante informatie bieden, uitschieters identificeren en kenmerken in de vertragingen blootleggen. Om tracing het favoriete hulpmiddel van ontwikkelaars te maken voor het oplossen van fouten in productie of het aanpakken van problemen die meerdere diensten omvatten, zijn originele gebruikersinterfaces en visualisaties nodig die beter aansluiten bij het mentale model van ontwikkelaars die deze diensten creëren en beheren.
Er zijn serieuze mentale inspanningen nodig om een systeem te ontwerpen dat verschillende signalen in de trace-resultaten op een manier weergeeft die geoptimaliseerd is voor het vergemakkelijken van analyse en redeneringen. Het is noodzakelijk om na te denken over hoe de systeemtopologie tijdens het debuggen kan worden geabstraheerd, zodat gebruikers blinde vlekken kunnen overwinnen zonder in afzonderlijke trace- of span-gegevens te kijken.
We hebben goede mogelijkheden voor abstractie en het in lagen splitsen nodig (vooral in de UI). Zulke mogelijkheden die goed passen in een hypothesegericht debugproces, waar je iteratief vragen kunt stellen en hypothesen kunt testen. Ze zullen niet alle observability-problemen automatisch oplossen, maar ze zullen gebruikers helpen hun intuïtie te verfijnen en meer doordachte vragen te formuleren. Ik pleit voor een meer doordachte en innovatieve benadering van visualisatie. Hier ligt een echte kans om de horizon te verbreden.
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
