

In grote cloudsystemen staat de automatische belastingbalancering of het uitbalanceren van de belasting op rekencapaciteiten bijzonder hoog op de agenda. Dit probleem is ook aangepakt door Tionix (ontwikkelaar en operator van cloudservices, onderdeel van de groep van bedrijven van Rostelecom).
En aangezien onze belangrijkste ontwikkelplatform OpenStack is, en wij, net als iedereen, lui zijn, hebben we besloten om een kant-en-klaar module te kiezen die al onderdeel uitmaakt van het platform. Onze keuze viel op Watcher, dat we besloten te gebruiken voor onze behoeften.
Laten we beginnen met de termen en definities.
Termen en definities
Doel is het meetbare, observeerbare eindresultaat dat moet worden bereikt. Voor het bereiken van elk doel zijn er een of meer strategieën. Een strategie is de implementatie van een algoritme dat in staat is een oplossing voor dat doel te vinden.
Actie (Action) is een elementaire taak die de huidige status van de doelresource van de OpenStack-cluster verandert, zoals: migratie van een virtuele machine (migration), wijziging van de voedingsstaat van een knooppunt (change_node_power_state), wijziging van de status van de nova-service (change_nova_service_state), wijziging van de flavor (resize), registratie van een NOP-bericht (nop), geen acties gedurende een bepaalde tijd — pauze (sleep), migratie van een volume (volume_migrate).
Actieplan (Action Plan) is een specifieke reeks van acties die in een bepaalde volgorde worden uitgevoerd om een specifiek doel te bereiken. Het actieplan bevat ook de geschatte mondiale effectiviteit met een set prestatie-indicatoren. Het actieplan wordt gegenereerd door Watcher na een succesvolle audit, waarbij de gekozen strategie een oplossing vindt voor het bereiken van het doel. Het actieplan bestaat uit een lijst van opeenvolgende acties.
Audit (Audit) is een verzoek om het cluster te optimaliseren. Optimalisatie wordt uitgevoerd om één doel in dit cluster te bereiken. Voor elke succesvolle audit genereert Watcher een actieplan.
Auditgebied (Audit Scope) is een set van middelen binnen welke een audit wordt uitgevoerd (beschikbaarheidszone(n), aggregators van knooppunten, afzonderlijke rekeneenheden of opslagknooppunten, enz.). Het auditgebied is in elk sjabloon gedefinieerd. Als het auditgebied niet is opgegeven, wordt de audit over het gehele cluster uitgevoerd.
Audit Sjabloon (Audit Template) is een opgeslagen set instellingen voor het uitvoeren van een audit. Sjablonen zijn nodig om audits met dezelfde instellingen meerdere keren uit te voeren. Het sjabloon moet verplicht het doel van de audit bevatten; als er geen strategieën worden opgegeven, worden de meest geschikte uit de bestaande strategieën gekozen.
Cluster (Cluster) is een set fysieke machines die reken-, opslag- en netwerkmiddelen bieden en worden beheerd door dezelfde OpenStack-beheerknoop.
Cluster Data Model (Cluster Data Model, CDM) is een logische weergave van de huidige toestand en topologie van de door het cluster beheerde middelen.
Effectiviteitsindicator (Efficacy Indicator) is een indicator die aangeeft hoe de oplossing, ontwikkeld met deze strategie, presteert. Effectiviteitsindicatoren zijn specifiek voor het bepaalde doel en worden meestal gebruikt om de algehele effectiviteit van het eindplan van actie te berekenen.
Effectiviteitspecificatie (Efficacy Specification) is een set van specifieke kenmerken die aan elk Doel zijn gekoppeld en die verschillende effectiviteitsindicatoren definiëren die de strategie, die het bereiken van het overeenkomstige doel mogelijk maakt, moet bieden in zijn oplossing. In feite zal elke oplossing die door de strategie wordt voorgesteld, worden gecontroleerd op overeenstemming met de specificatie voordat de algehele effectiviteit wordt berekend.
Scoring Engine (Scoring Engine) is een uitvoerbaar bestand dat duidelijk gedefinieerde invoer- en uitvoergegevens heeft en een puur wiskundige taak uitvoert. Daarom hangt de berekening niet af van de omgeving waarin deze wordt uitgevoerd - deze zal overal hetzelfde resultaat opleveren.
Watcher Planner (Watcher Planner) — een onderdeel van het besluitvormingsmechanisme van Watcher. Deze module accepteert een set acties die door de strategie zijn gegenereerd en creëert een workflowplan dat bepaalt hoe deze verschillende acties in de tijd moeten worden gepland en wat de voorwaarden zijn voor elke actie.
Doelen en strategieën van Watcher
Doel
Strategieën
Dummy doel
Dummy Strategie
Dummy Strategie met voorbeeld Scoring Engines
Dummy strategie met herschaling
Energie besparen
Energie besparen Strategie
Server Consolidatie
Basis Offline Server Consolidatie
VM Werkbelasting Consolidatie Strategie
Werkbelasting Balanceren
Werkbelasting Balans Migratie Strategie
Opslag Capaciteits Balans Strategie
Stabilisatie van werkbelasting
Luidruchtige Buur
Luidruchtige Buur
Thermische Optimalisatie
Strategie op basis van outlet temperatuur
Luchtstroom Optimalisatie
Uniforme luchtstroom migratiestrategie
Hardwareonderhoud
Zone migratie
Niet-geclassificeerd
Actuator
Dummy doel — een reserve doel dat wordt gebruikt voor testdoeleinden (reserved goal that is used for testing purposes).
Gerelateerde strategieën: Dummy Strategie, Dummy Strategie met voorbeeld Scoring Engines en Dummy strategie met herschaling. Dummy strategie is een fictieve strategie die wordt gebruikt voor integratietests via Tempest. Deze strategie biedt geen nuttige optimalisatie; het enige doel is om Tempest-tests uit te voeren.
Dummy strategie met voorbeeld Scoring Engines — de strategie is vergelijkbaar met de vorige, met als enige verschil dat gebruik wordt gemaakt van een voorbeeld van een 'scoring engine' die telt met behulp van machine learning methodes.
Dummy strategie met herschaling — de strategie is vergelijkbaar met de vorige, met als enige verschil dat gebruik wordt gemaakt van het wijzigen van de flavor (migratie en herschaling).
Wordt niet gebruikt in productie.
Energie besparen — het energieverbruik minimaliseren. De strategie van dit doel, Saving Energy Strategy, samen met de strategie VM Workload Consolidation Strategy (Server Consolidation), kan de functie van dynamisch energiebeheer (DPM) uitvoeren, waarmee elektriciteit wordt bespaard door dynamische consolidatie van werkbelastingen, zelfs tijdens perioden van lage resourcebelasting: virtuele machines worden naar een kleiner aantal knooppunten verplaatst en niet-essentiële knooppunten worden uitgeschakeld. Na consolidatie biedt de strategie een oplossing voor het in- of uitschakelen van knooppunten op basis van specifieke parameters: 'min_free_hosts_num' — het aantal vrij beschikbare ingeschakelde knooppunten dat op belasting wacht, en 'free_used_percent' — het percentage actieve ingeschakelde knooppunten dat door machines in gebruik is. Voor de werking van de strategie moet Ironic zijn ingeschakeld en geconfigureerd om met de in- en uitschakeling van voeding op knooppunten te werken.
Parameters van de strategie
parameter
type
standaard
beschrijving
free_used_percent
Aantal
10.0
de verhouding tussen het aantal vrije computing nodes en het aantal computing nodes met virtual machines
min_free_hosts_num
Int
1
minimaal aantal vrije computing nodes
Er moeten minimaal twee nodes in de cloud zijn. De gebruikte methode is het wijzigen van de stroomstatus van de node (change_node_power_state). De strategie vereist geen verzamelingen van metrics.
Server Consolidatie — het minimaliseren van het aantal computing nodes (consolidatie). Het heeft twee strategieën: Basic Offline Server Consolidation en VM Workload Consolidation Strategy.
De strategie Basic Offline Server Consolidation minimaliseert het totale aantal gebruikte servers en minimaliseert ook het aantal migraties.
De basisstrategie vereist de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
compute.node.cpu.percent
none
cpu_util
none
Strategieparameters: migration_attempts — het aantal combinaties voor het vinden van potentiële kandidaten voor uitschakeling (standaard 0, geen beperkingen), period — de tijdsinterval in seconden voor het verkrijgen van statische aggregatie uit de metric data source (standaard 700).
Geïnspireerde methoden: migratie, wijziging van de status van de nova-dienst (change_nova_service_state).
De strategie VM Workload Consolidation Strategy is gebaseerd op een heuristisch algoritme van first-fit, dat zich richt op de gemeten CPU-belasting en probeert de nodes te minimaliseren die een te hoge of te lage belasting hebben, rekening houdend met de capaciteitsbeperkingen van de middelen. Deze strategie biedt een oplossing die leidt tot een efficiënter gebruik van de clusterbronnen, door gebruik te maken van de volgende vier fasen:
- Ontlastingsfase — verwerking van overbelaste middelen;
- Consolidatiefase — verwerking van onvoldoende gebruikte middelen;
- Optimalisatie van de oplossing — vermindering van het aantal migraties;
- Uitschakeling van ongebruikte computing nodes.
De strategie vereist de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
memory
none
disk.root.size
none
De volgende metrics zijn niet verplicht, maar verhogen de nauwkeurigheid van de strategie indien beschikbaar:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
memory.resident
none
cpu_util
none
Strategieparameters: period — de tijdsinterval in seconden voor het verkrijgen van statische aggregatie uit de metric data source (standaard 3600).
Het gebruikt dezelfde methoden als de vorige strategie. Meer details .
Werkbelasting Balanceren — balanceer de workload tussen computing nodes. Het doel heeft drie strategieën: Workload Balance Migration Strategy, Workload Stabilization, Storage Capacity Balance Strategy.
De migratiestrategie voor workloadbalans start migraties van virtuele machines op basis van de werklast van de virtuele machines op knooppunten. De beslissing om te verplaatsen wordt genomen telkens wanneer het % gebruik van CPU of RAM van een knooppunt de opgegeven drempel overschrijdt. De te verplaatsen virtuele machine moet het knooppunt dichter bij de gemiddelde werklast van alle knooppunten brengen.
Vereisten
- Gebruik van fysieke processors;
- Minimaal twee fysieke rekeneenheden;
- Geïnstalleerde en geconfigureerde Ceilometer-component — ceilometer-agent-compute, draaiend op elke rekeneenheid, en Ceilometer API, evenals het verzamelen van de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
cpu_util
none
memory.resident
none
Strategieparameters:
parameter
type
standaard
beschrijving
metrics
String
'cpu_util'
De metrics waarop dit is gebaseerd: 'cpu_util', 'memory.resident'.
threshold
Aantal
25.0
De drempel voor werklast voor migratie.
period
Aantal
300
Gecombineerde tijdsperiode van Ceilometer.
Gebruikte methode — migratie.
Workloadstabilisatie — strategie gericht op het stabiliseren van de werklast met behulp van live migratie. De strategie is gebaseerd op een standaarddeviatie-algoritme en bepaalt of er overbelasting in de cluster is en reageert daarop door migraties van machines te starten om de cluster te stabiliseren.
Vereisten
- Gebruik van fysieke processors;
- Minimaal twee fysieke rekeneenheden;
- Geïnstalleerde en geconfigureerde Ceilometer-component — ceilometer-agent-compute, draaiend op elke rekeneenheid, en Ceilometer API, evenals het verzamelen van de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
cpu_util
none
memory.resident
none
Opslagcapaciteitsbalansstrategie (strategieën geïmplementeerd vanaf Queens) — deze strategie verplaatst schijven afhankelijk van de belasting van Cinder-pools. De beslissing om te verplaatsen wordt genomen telkens wanneer de gebruiksratio van de pool de opgegeven drempel overschrijdt. De te verplaatsen schijf moet de pool dichter bij de gemiddelde belasting van alle Cinder-pools brengen.
Vereisten en beperkingen
- Minimaal twee Cinder-pools;
- Mogelijkheid tot het migreren van schijven.
- Cluster gegevensmodel — Cinder cluster data model collector.
Strategieparameters:
parameter
type
standaard
beschrijving
volume_threshold
Aantal
80.0
Drempelwaarde voor schijven voor volumebalans.
Gebruikte methode — schijfmigratie (volume_migrate).
Noisy Neighbor — identificeer en verplaats de 'luidruchtige buur' — een virtuele machine met lage prioriteit die de prestaties van een virtuele machine met hoge prioriteit negatief beïnvloedt vanuit IPC-perspectief door overmatig gebruik van Last Level Cache. Eigen strategie: Noisy Neighbor (te gebruiken parameterstrategie — cache_threshold (standaardwaarde — 35), wanneer de prestaties tot de opgegeven waarde dalen, wordt migratie gestart. Voor het functioneren van de strategie zijn ingeschakelde LLC (Last Level Cache) metrics, de laatste Intel-server met CMT-ondersteuning, evenals het verzamelen van de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
cpu_l3_cache
none
Nodig is Intel .
Cluster datamodel (standaard): Nova cluster data model collector. De gebruikte methode is migratie.
Het werken met dit doel via het Dashboard is niet volledig geïmplementeerd in Queens.
Thermische Optimalisatie — optimaliseer de temperatuurregeling. De temperatuur aan de uitgang (afvoerlucht) is een van de belangrijke thermische telemetriesystemen voor het meten van de toestand van de thermische / werklast van de server. Voor het doel is er één strategie — Outlet temperature based strategy, die beslissingen neemt over het verplaatsen van werklasten naar knooppunten met een gunstig temperatuurregime (de laagste uitgangstemperatuur), wanneer de uitgangstemperatuur van de oorspronkelijke hosts een instelbare drempel bereikt.
Voor de werking van de strategie is een server met geïnstalleerde en geconfigureerde Intel Power Node Manager 3.0 of een latere versie nodig. , evenals het verzamelen van de volgende metrics:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
hardware.ipmi.node.outlet_temperature
IPMI
Strategieparameters:
parameter
type
standaard
beschrijving
threshold
Aantal
35.0
Temperatuur drempel voor migratie.
period
Aantal
30
Tijdinterval in seconden voor het verkrijgen van statistische aggregatie uit de gegevensbron van de metriek.
Gebruikte methode — migratie.
Luchtstroom Optimalisatie — optimaliseer de ventilatiestand. Eigen strategie — Uniform Airflow using live migration. De strategie start de migratie van de virtuele machine telkens wanneer de luchtstroom van de servers ventilator de opgegeven drempel overschrijdt.
Voor de werking van de strategie zijn nodig:
- Hardware: rekeneenheden <met ondersteuning voor NodeManager 3.0;
- Minimaal twee rekeneenheden;
- Geïnstalleerd en geconfigureerd op elke rekeneenheid component ceilometer-agent-compute en Ceilometer API, die met succes kan rapporteren over dergelijke meetwaarden als luchtstroom, systeemvermogen, temperatuur aan de ingang:
de metriek
dienst
plug-ins
over het onderwerp "En hoe is het uiteindelijk afgelopen?". Op mijn uitgebreide antwoord hoorde ik "Dit zou een artikel moeten worden". Nou, als het zo is, dan wordt het een artikel. Misschien is het nuttig voor iemand. Daarin zal de lezer enkele feiten leren over de structuur van backend-codegeneratie in QEMU, en ook hoe je een Just-in-Time compiler voor een webapplicatie schrijft.
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Voor de werking van de strategie is een server met geïnstalleerde en geconfigureerde Intel Power Node Manager 3.0 of een latere versie nodig.
Beperkingen: Het concept is niet bedoeld voor productie.
Het wordt aanbevolen om dit algoritme te gebruiken met voortdurende audits, aangezien in één iteratie alleen één virtuele machine wordt gemigreerd.
Live migraties zijn mogelijk.
Strategieparameters:
parameter
type
standaard
beschrijving
threshold_airflow
Aantal
400.0
Luchtstroomdrempel voor migratie Eenheid is 0.1 CFM
threshold_inlet_t
Aantal
28.0
Ingangstemperatuur drempel voor migratiebeslissing
threshold_power
Aantal
350.0
Systeemvermogen drempel voor migratiebeslissing
period
Aantal
30
Tijdinterval in seconden voor het verkrijgen van statistische aggregatie uit de gegevensbron van de metriek.
Gebruikte methode — migratie.
Hardwareonderhoud — hardware maintenance. The strategy related to this goal is Zone migration. This strategy serves as a tool for efficient and minimal automatic migration of virtual machines and disks when technical maintenance of hardware is necessary. The strategy builds an action plan according to weights: actions with higher weights will be scheduled earlier than others. There are two configuration parameters: action weights (action_weights) and parallelization.
Limitations: configuration of action weights and parallelization is required.
Strategieparameters:
parameter
type
standaard
beschrijving
compute_nodes
array
None
Compute nodes for migration.
storage_pools
array
None
Storage nodes for migration.
parallel_total
integer
6
Total number of actions that should be performed in parallel.
parallel_per_node
integer
2
Number of actions performed in parallel for each compute node.
parallel_per_pool
integer
2
Number of actions performed in parallel for each storage pool.
priority
object
None
A list of priorities for virtual machines and disks.
with_attached_volume
boolean
False
False — virtual machines will be moved after all disks have been migrated. True — virtual machines will be moved after all attached disks have been migrated.
Elements of the compute node array:
parameter
type
standaard
beschrijving
src_node
string
None
The compute node from which the virtual machines are being moved (mandatory).
dst_node
string
None
The compute node to which the virtual machines are migrated.
Elements of the storage node array:
parameter
type
standaard
beschrijving
src_pool
string
None
The storage pool from which the disks are being moved (mandatory).
dst_pool
string
None
The storage pool to which the disks are being moved.
src_type
string
None
Source disk type (mandatory).
dst_type
string
None
Final disk type (mandatory).
Elements of object priorities:
parameter
type
standaard
beschrijving
project
array
None
Project names.
compute_node
array
None
Compute node names.
storage_pool
array
None
Storage pool names.
compute
enum
None
Virtual machine parameters [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
opslag
enum
None
Disk parameters [“size”, “created_at”].
Used methods — migration of virtual machines, migration of disks.
Niet-geclassificeerd — a secondary goal used to facilitate the strategy development process. It contains no specifications and can be used whenever a strategy is not yet linked to an existing goal. This goal can also be used as a transitional stage. The strategy associated with this goal is Actuator.
Creating a new goal
Watcher Decision Engine heeft een plug-in interface voor 'externe doelen', waarmee u een extern doel kunt integreren dat kan worden bereikt met behulp van een strategie.
Voordat u een nieuw doel creëert, moet u ervoor zorgen dat geen van de bestaande doelen aan uw behoeften voldoet.
Een nieuwe plug-in maken
Om een nieuw doel te creëren, moet u: de doelklasse uitbreiden, de klasse-methode get_name () implementeren om de unieke identificatie van het nieuwe doel dat u wilt creëren terug te geven. Deze unieke identificatie moet overeenkomen met de naam van het instappunt dat u later verklaart.
Daarna moet u de klasse-methode get_display_name () implementeren om de vertaalde weergavenaam van het doel dat u wilt creëren terug te geven (gebruik geen variabele voor het teruggeven van de vertaalde string, zodat deze automatisch kan worden samengesteld door de vertaaltool).
Implementeer de klasse-methode get_translatable_display_name (), om de vertaalsleutel (de feitelijke Engelse weergavenaam) van uw nieuwe doel terug te geven. De geretourneerde waarde moet overeenkomen met de string die in get_display_name () is vertaald.
Implementeer zijn methode get_efficacy_specification (), om de effectiviteitsspecificatie voor uw doel terug te geven. De methode get_efficacy_specification () retourneert een instantie van Unclassified (), geleverd door Watcher. Deze effectiviteitsspecificatie is nuttig in het ontwikkelingsproces van uw doel, aangezien deze overeenkomt met een lege specificatie.
→
De architectuur van Watcher (meer details ).
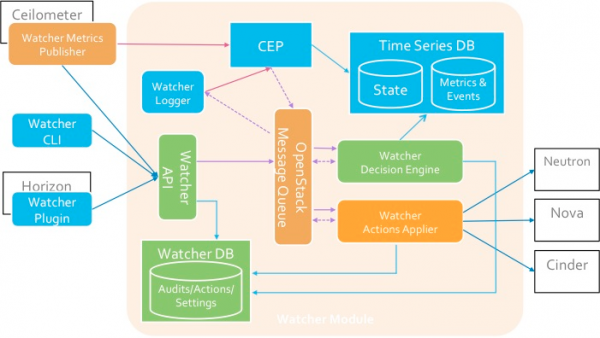
Componenten
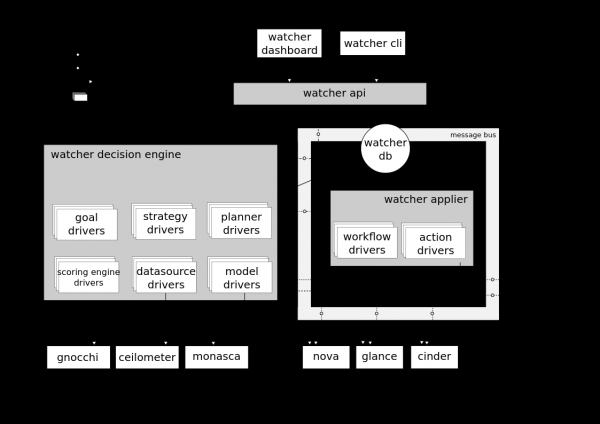
Watcher API — een component die de REST API van Watcher implementeert. Interactiemechanismen: CLI, Horizon-plug-in, Python SDK.
Watcher DB — de database van Watcher.
Watcher Applier — een component die de uitvoering van het actieplan implementeert dat is gecreëerd door de Watcher Decision Engine-component.
Watcher Decision Engine — een component die verantwoordelijk is voor het berekenen van een set mogelijke optimalisatie-acties voor de auditdoelstelling. Als er geen strategie is opgegeven, kiest de component automatisch de meest geschikte.
Watcher Metrics Publisher — een component die enkele metrics of gebeurtenissen verzamelt en berekent en deze publiceert op de CEP-eindpunt. De functionaliteit van de component kan ook worden geleverd door de Ceilometer-publicateur.
Complex Event Processing (CEP) Engine — motor voor complexe evenementverwerking. Omwille van de prestaties kunnen er meerdere exemplaren van de CEP Engine gelijktijdig draaien, elk verantwoordelijk voor een bepaald type metriek / evenement. In het Watcher-systeem start de CEP twee soorten acties: — schrijft relevante evenementen / metrieke in de tijdreeksdatabase; — stuurt relevante evenementen naar de component Watcher Decision Engine, wanneer dit evenement de uitkomst van de huidige optimalisatiestrategie kan beïnvloeden, aangezien het OpenStack-cluster geen statisch systeem is.
De interactie tussen de componenten gebeurt via het AMQP-protocol.
→
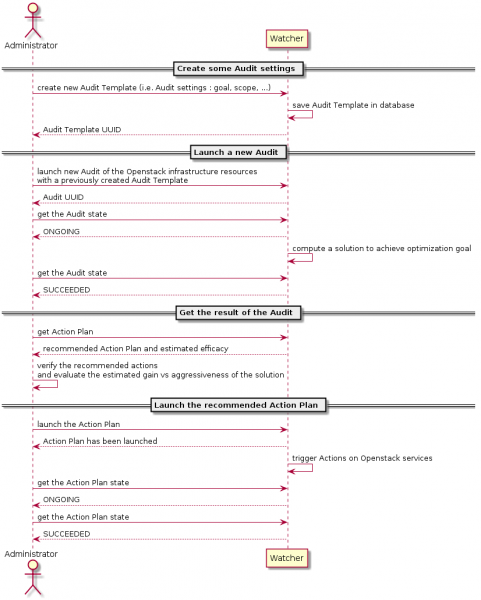
Schema van interactie met Watcher
Testresultaten van Watcher
- Op de pagina Optimalisatie — Actieplannen verschijnt een 500-fout (zowel op een schone Queens-installatie als op een stand met Tionix-modules), dat gebeurt alleen nadat de audit is gestart en het actieplan is gegenereerd; een lege opent normaal.
- Op de tab Actie-details ontstaan fouten, het lukt niet om het doel en de auditstrategie te verkrijgen (zowel op een schone Queens-installatie als op een stand met Tionix-modules).
- Audits met doel Dummy (test) worden normaal aangemaakt en uitgevoerd, actieplannen worden gegenereerd.
- Audits met doel Unclassified worden niet aangemaakt, aangezien het doel niet functioneel is en bedoeld is voor tussentijdse aanpassing bij het creëren van nieuwe strategieën.
- Audits met doel Workload Balancing (strategie Storage Capacity balance) worden succesvol aangemaakt, maar het actieplan wordt niet gegenereerd. Optimalisatie van opslagpools is niet vereist.
- Audits met doel Workload Balancing (strategie Workload Balance Migration Strategy) worden succesvol aangemaakt, maar het actieplan wordt niet gegenereerd.
- Audits met doel Workload Balancing (strategie Workload Stabilization Strategy) eindigen met een fout.
- Audits met doel Noisy Neighbor worden succesvol aangemaakt, maar het actieplan wordt niet gegenereerd.
- Audits met doel Hardware maintenance worden succesvol aangemaakt, het actieplan wordt echter niet volledig gegenereerd (prestaties worden gegenereerd, maar de actielijst zelf wordt niet gegenereerd).
- Wijzigingen in de configuraties van nova.conf (in de default sectie compute_monitors = cpu.virt_driver) op de compute- en controllerknoop lossen de fouten niet op.
- Audits met doel Server Consolidation (strategie Basic) eindigen ook met een fout.
- Audits met doel Server Consolidation (strategie VM workload consolidation) eindigen met een fout. In de logs verschijnt een fout bij het ophalen van de gegevens. Discussie over de fout, met name, .
We tried to specify in the Watcher configuration file (it didn't help — as a result, there are errors on all the Optimization pages, reverting to the original configuration file content does not fix the situation):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Audits for Saving Energy are ending with an error. According to the logs, the problem is still the absence of Ironic; it won't work without the baremetal service.
- Audits for Thermal Optimization are ending with an error. The traceback is the same as for Server Consolidation (VM workload consolidation strategy) (original data error)
- Audits for Airflow Optimization are ending with an error.
The following audit completion errors also occur. The traceback is in the logs decision-engine.log (cluster state not defined).
→ Error discussion
Conclusie
The result of our two months of research has led to a clear conclusion that to achieve a fully functional load balancing system, we will need to closely engage in refining the tools for the Openstack platform.
Watcher has proven to be a serious and rapidly evolving product with enormous potential, the full use of which will require significant and serious effort.
But more about that in the next articles of the series.
Bron: habr.com
