

In 2017 won we the competition to develop the transaction core for the investment business of Alfa-Bank and began working on it (at HighLoad++ 2018 with a presentation on the core of the investment business Vladimir Dryinkin, head of the transaction core for the investment business of Alfa-Bank). This system was designed to aggregate transaction data from various sources in different formats, unify the data, store it, and provide access to it.
During the development process, the system evolved and gained functionality, and at some point we realized that we were crystallizing something much larger than just application software created to solve a strictly defined set of tasks: we ended up with a system for building distributed applications with persistent storage. The experience we gained laid the foundation for a new product — (TDG).
I want to talk about the architecture of TDG and the solutions we came up with during the development process, introduce you to the main functionality, and show how our product can serve as a foundation for creating complete solutions.
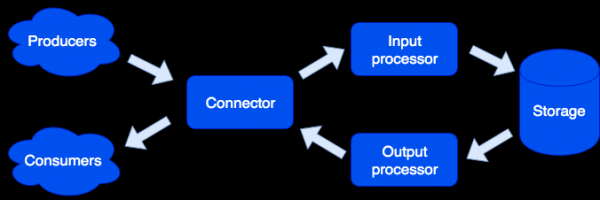
Architecturally, we divided the system into separate roles, each responsible for solving a specific set of tasks. One running instance of the application implements one or several types of roles. The cluster can have several roles of the same type:
Connector
De connector is verantwoordelijk voor de verbinding met de externe wereld; zijn taak is om verzoeken te ontvangen, deze te parseren, en als dat lukt, de gegevens door te sturen naar de input processor. We ondersteunen de indelingen HTTP, SOAP, Kafka, FIX. De architectuur maakt het eenvoudig om ondersteuning voor nieuwe indelingen toe te voegen, binnenkort komt er ondersteuning voor IBM MQ. Als de parsing van het verzoek mislukt, retourneert de connector een fout; in andere gevallen antwoorden we dat het verzoek succesvol is verwerkt, ook al is er tijdens de verdere verwerking een fout opgetreden. Dit is opzettelijk gedaan om te kunnen werken met systemen die verzoeken niet kunnen herhalen - of omgekeerd, dit te stellig doen. Om geen gegevens te verliezen, wordt een herstelwachtrij gebruikt: het object komt eerst daarin terecht en wordt pas verwijderd nadat het succesvol is verwerkt. De beheerder kan meldingen ontvangen over objecten die in de herstelwachtrij zijn achtergebleven, en na het verhelpen van de softwarefout of hardwarestoring kan hij een nieuwe poging doen.
Input processor
De input processor classificeert de ontvangen gegevens op basis van kenmerkende eigenschappen en roept de bijpassende handlers aan. Handlers zijn code in de programmeertaal Lua, die in een sandbox wordt uitgevoerd, zodat ze geen invloed kunnen uitoefenen op de werking van het systeem. In dit stadium kunnen de gegevens in de gewenste vorm worden gebracht, en indien nodig, kunnen er een willekeurig aantal taken worden gestart die de noodzakelijke logica kunnen implementeren. Bijvoorbeeld, in het MDM (Master Data Management) product dat is gebouwd op de Tarantool Data Grid, starten we bij het toevoegen van een nieuwe gebruiker, om de verwerking van het verzoek niet te vertragen, het creëren van een gouden record als een aparte taak. De sandbox ondersteunt lees-, wijzig- en toevoegingsverzoeken, en maakt het mogelijk om een bepaalde functie op alle opslagrollen uit te voeren en het resultaat te aggregeren (map/reduce).
Handlers kunnen worden beschreven in bestanden:
sum.lua

local x, y = unpack(...)
return x + y
En vervolgens worden ze in de configuratieDeclared:
functions:
  sum: { __file: sum.lua }
Waarom Lua? Lua is een zeer eenvoudige taal. Op basis van onze ervaring beginnen mensen na een paar uur kennismaking met Lua code te schrijven die hun probleem oplost. En dit zijn niet alleen professionele ontwikkelaars, maar bijvoorbeeld ook analisten. Bovendien, dankzij de jit-compiler, draait Lua zeer snel.
Opslag
Opslag bewaart persistente gegevens. Voordat ze worden opgeslagen, worden de gegevens gevalideerd volgens het dataschema. Voor de beschrijving van het schema gebruiken we een uitgebreid formaat. . Voorbeeld:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Op basis van deze beschrijving wordt automatisch DDL (Data Definition Language) gegenereerd voor de database Tarantool en schema voor gegevensaccess.
Asynchrone replicatie van gegevens wordt ondersteund (er zijn plannen om synchrone replicatie toe te voegen).
Output processor
Soms moeten externe consumenten worden op de hoogte gesteld van nieuwe gegevens, hiervoor bestaat de rol van Output processor. Na het opslaan van gegevens kunnen ze naar de bijbehorende verwerker worden gestuurd (bijvoorbeeld om ze om te zetten in de vorm die de consument vereist) — en daarna naar de connector voor verzending. Hier wordt ook een herstelbare wachtrij gebruikt: als het object door niemand is geaccepteerd, kan de administrator het later opnieuw proberen.
Schaalbaarheid
De rollen van connector, input processor en output processor hebben geen toestand, wat ons in staat stelt het systeem horizontaal te schalen door eenvoudig nieuwe exemplaren van de applicatie toe te voegen met de rol van het benodigde type. Voor horizontale schaalvergroting van de opslag wordt voor het organiseren van een cluster met behulp van virtuele buckets. Wanneer een nieuwe server wordt toegevoegd, verhuist een deel van de buckets van de oude servers op de achtergrond naar de nieuwe server; dit gebeurt transparant voor de gebruikers en heeft geen invloed op de werking van het gehele systeem.
Eigenschappen van gegevens
Objecten kunnen erg groot zijn en andere objecten bevatten. We waarborgen de atomiciteit van het toevoegen en bijwerken van gegevens door het object met al zijn afhankelijkheden naar één virtuele bucket op te slaan. Dit voorkomt dat het object over meerdere fysieke servers wordt 'uitgesmeerd'.
Versiebeheer wordt ondersteund: elke update van een object creëert een nieuwe versie, en we kunnen altijd een tijdelijke snapshot maken om te zien hoe de wereld er toen uitzag. Voor gegevens die geen lange geschiedenis vereisen, kunnen we het aantal versies beperken of zelfs alleen de laatste, dat wil zeggen feitelijk versiebeheer uitschakelen voor een bepaald type. We kunnen ook de geschiedenis in de tijd beperken: bijvoorbeeld door alle objecten van een bepaald type ouder dan 1 jaar te verwijderen. Archivering wordt ook ondersteund: we kunnen objecten ouder dan een opgegeven tijd exporteren om ruimte in het cluster vrij te maken.
Taken
Onder de interessante functies is er de mogelijkheid om taken te plannen, op verzoek van de gebruiker of programmatisch vanuit de sandbox:
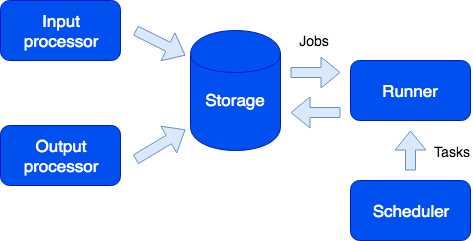
Hier zien we nog een rol — runner. Deze rol heeft geen status, en indien nodig kunnen extra instanties van de applicatie met deze rol aan het cluster worden toegevoegd. De verantwoordelijkheid van de runner is het uitvoeren van taken. Zoals eerder vermeld, kunnen vanuit de sandbox nieuwe taken worden aangemaakt; deze worden opgeslagen in de wachtrij op storage en vervolgens uitgevoerd op de runner. Dit type taken wordt Job genoemd. Daarnaast hebben we een type taak dat Task wordt genoemd — dit zijn door de gebruiker gedefinieerde taken die volgens een schema (met cron-syntax) of op verzoek worden uitgevoerd. Voor het starten en volgen van dergelijke taken hebben we een handige takenbeheerder. Om deze functionaliteit beschikbaar te maken, moet de rol scheduler ingeschakeld zijn; deze rol heeft status, zodat deze niet kan worden geschaald, wat bovendien niet nodig is; maar net als alle andere rollen kan ze een replica hebben die begint te werken als de master uitvalt.
Logger
Een andere rol heet logger. Deze verzamelt logs van alle leden van het cluster en biedt een interface voor het exporteren en bekijken ervan via een webinterface.
Diensten
Het is vermeldenswaard dat het systeem eenvoudig maken van services mogelijk maakt. In het configuratiebestand kan worden aangegeven welke aanvragen naar de door de gebruiker geschreven handler moeten worden geleid, die in de sandbox wordt uitgevoerd. In deze handler kan bijvoorbeeld een analytische query worden uitgevoerd en het resultaat worden geretourneerd.
De service wordt beschreven in het configuratiebestand:
services:
   sum:
      doc: "voegt twee getallen toe"
      function: sum
      return_type: int
      args:
         x: int
         y: int
De GraphQL API wordt automatisch gegenereerd en de service is beschikbaar voor aanroepen:
query {
   sum(x: 1, y: 2)
}
Dit leidt tot een aanroep van de handler sum, die het resultaat zal teruggeven:
3
Profilering van aanvragen en statistieken
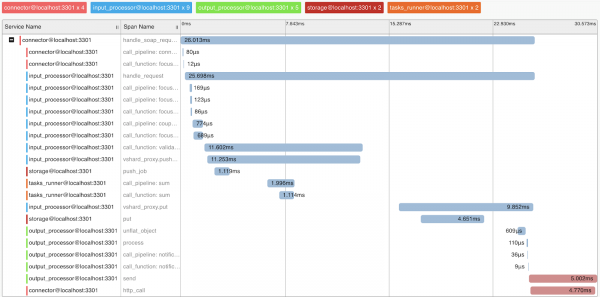
Om de werking van het systeem en de profilering van aanvragen te begrijpen, hebben we ondersteuning voor het OpenTracing-protocol geïmplementeerd. Het systeem kan op verzoek informatie verzenden naar tools die dit protocol ondersteunen, zoals Zipkin, om duidelijk te maken hoe de aanvraag werd uitgevoerd:
Natuurlijk biedt het systeem interne statistieken die verzameld kunnen worden met behulp van Prometheus en gevisualiseerd met Grafana.
Deploy
Tarantool Data Grid kan worden gedeployed vanuit RPM-pakketten of een archief, met behulp van de meegeleverde tool of Ansible, en er is ook ondersteuning voor Kubernetes ().
De applicatie die de bedrijfslogica implementeert (configuratie, handlers) wordt in de gedeployde cluster Tarantool Data Grid geladen in de vorm van een archief via de UI of met een script, via de door ons aangeboden API.
Voorbeelden van applicaties
Welke applicaties kunnen worden gemaakt met Tarantool Data Grid? In feite zijn de meeste zakelijke taken op de een of andere manier gerelateerd aan het verwerken van gegevensstromen, opslag en toegang daartoe. Dus als je grote gegevensstromen hebt die betrouwbaar opgeslagen moeten worden en toegankelijk zijn, kan ons product je veel tijd besparen in de ontwikkeling, zodat je je kunt concentreren op je bedrijfslogica.
Bijvoorbeeld, we willen informatie over de vastgoedmarkt verzamelen, zodat we later informatie hebben over de beste aanbiedingen. In dit geval identificeren we de volgende taken:
- Bots die informatie verzamelen uit openbare bronnen zijn onze gegevensbronnen. Deze taak kun je oplossen door gebruik te maken van bestaande oplossingen of door code te schrijven in elke taal.
- Daarna zal Tarantool Data Grid de gegevens accepteren en opslaan. Als het gegevensformaat uit verschillende bronnen verschilt, kun je code in Lua schrijven die de gegevens naar een uniform formaat omzet. In de voorafgaande verwerkingsfase kun je ook bijvoorbeeld dubbele aanbiedingen filteren of de informatie in de database over agentschappen die op de markt opereren, bijwerken.
- U heeft nu al een schaalbare oplossing in een cluster, die u kunt vullen met gegevens en gegevensopvragingen kunt doen. Vervolgens kunt u nieuwe functionaliteiten implementeren, bijvoorbeeld een service schrijven die een verzoek naar de gegevens doet en het meest voordelige aanbod van de dag presenteert - dit vereist een paar regels in het configuratiebestand en wat code in Lua.
Wat nu?
Onze prioriteit is het verbeteren van het gebruiksgemak voor ontwikkeling door middel van . Bijvoorbeeld, dit is een IDE met ondersteuning voor profilering en debugging van handlers die in een sandbox werken.
Daarnaast besteden we veel aandacht aan beveiligingskwesties. Op dit moment ondergaan we de certificering van FSTEK Rusland om een hoog beveiligingsniveau te bevestigen en te voldoen aan de vereiste normen voor de certificering van softwareproducten die worden gebruikt in informatie- en staatsinformatiesystemen.
Bron: habr.com
