

In het kader van het onderzoeksproject is begonnen met het toevoegen van de mogelijkheid aan GCC om het compilatieproces op te splitsen in verschillende parallel uitgevoerde threads. Momenteel wordt voor snelheidsverbetering op multicore systemen op het niveau van de make-tool het starten van afzonderlijke compilerprocessen gebruikt, waarbij elk proces een apart bestand met code compileert. Het nieuwe project experimenteert met het bieden van parallelisering op het niveau van de compiler, wat potentieel de efficiëntie op multicore systemen kan verhogen.
Voor testing is er een aparte paralleliserende tak van GCC, waarvoor een nieuwe parameter "—param=num-threads=N" is voorgesteld om het aantal threads in te stellen. In de beginfase is er voor gekozen om interprocedural optimalisaties in afzonderlijke uitvoeringsthreads uit te voeren, die cyclisch voor elke functie worden aangeroepen en goed geschikt zijn voor parallelisering. Operaties van GIMPLE, verantwoordelijk voor hardware-onafhankelijke optimalisaties die de interactie tussen functies evalueren, zijn ook in aparte threads geplaatst.
In de volgende fase is het ook gepland om interprocedural RTL-optimalisaties, die rekening houden met de specifieke kenmerken van het hardwareplatform, in aparte threads te plaatsen. Daarna wordt verwacht dat parallelisering van intra-procedural optimalisaties (IPA), toegepast op de code binnen een functie, onafhankelijk van de kenmerken van de oproep, zal worden gerealiseerd. De beperkende factor is tot nu toe de garbage collector, waaraan een globale lock is toegevoegd die het uitvoeren van garbage collection tijdens het werken in multithreaded modus uitschakelt (in de toekomst zal de garbage collector worden aangepast voor multithreaded uitvoering van GCC).
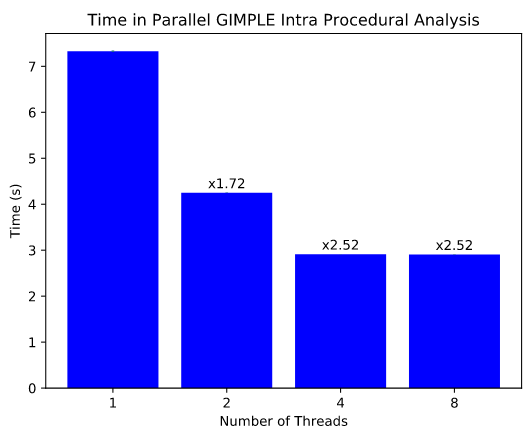
Voor het evalueren van de prestatieverandering is een testset voorbereid, die de compilatie van het bestand gimple-match.c uitvoert, dat meer dan 100.000 regels code en 1700 functies bevat. Tests op een systeem met een Intel Core i5-8250U CPU met 4 fysieke en 8 virtuele cores (Hyperthreading) toonden een vermindering van de uitvoeringstijd van Intra Procedural GIMPLE optimalisaties van 7 naar 4 seconden bij 2 threads en tot 3 seconden bij 4 threads, wat betekent dat de snelheid van de betreffende fase van de compilatie met respectievelijk 1.72 en 2.52 keer is toegenomen. De tests toonden ook aan dat het gebruik van virtuele cores bij Hyperthreading niet leidt tot een toename van de prestaties.
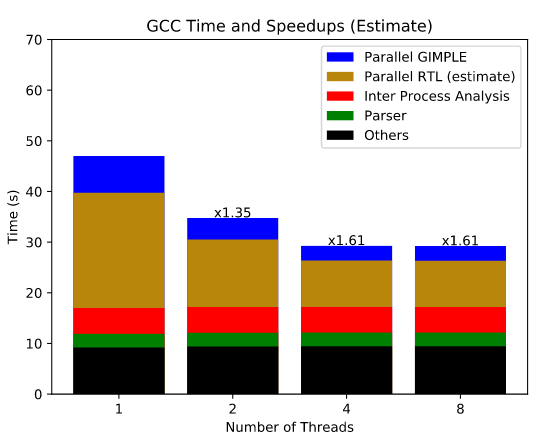
De totale bouwtijd is met ongeveer 10% verminderd, maar naar verwachting zal de parallelisering van RTL-optimalisaties meer significante resultaten opleveren, aangezien deze fase bij compilatie aanzienlijk meer tijd in beslag neemt. Naar schatting zal na de parallelisering van RTL de totale bouwtijd met 1,61 verminderd worden. Daarna kan de bouwtijd nog met 5-10% worden verkort door parallelisering van IPA-optimalisaties.
Bron: opennet.ru
