

Ik ben altijd al benieuwd geweest naar hoe ik de boeken in mijn elektronisch bibliotheek beter kan indelen. Uiteindelijk ben ik tot deze oplossing gekomen met automatische telling van pagina's en andere functies. Iedereen die geïnteresseerd is, kan verder lezen.
Deel 1. Dropbox
Alle boeken staan bij mij in Dropbox. Ik heb alles verdeeld in 4 categorieën: Studieboek, Gids, Fictie, Non-fictie. Maar gidsen voeg ik niet toe aan de tabel.
De meeste boeken zijn .epub, de rest is .pdf. Dus de uiteindelijke oplossing moet beide opties dekken.
De paden naar de boeken zijn ongeveer als volgt:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Als het boek fictie is, wordt de categorie (namelijk 'Design' in het bovenstaande geval) weggelaten.
Ik heb besloten me niet druk te maken over de Dropbox API, omdat ik hun applicatie heb die de map synchroniseert. Dus het plan is als volgt: we nemen de boeken uit de map, voeren elk boek door een woordenteller en voegen ze toe aan Notion.
Deel 2. Een rij toevoegen
De tabel moet ongeveer als volgt eruitzien. LET OP: het is beter om de kolomnamen in het Latijns schrift te maken.
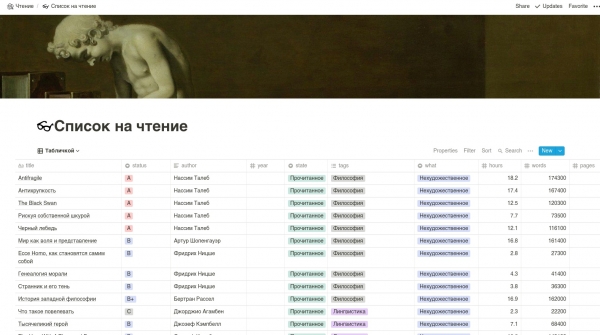
We gaan de niet-officiële API van Notion gebruiken, omdat de officiële nog niet beschikbaar is.

We gaan naar Notion, drukken op Ctrl + Shift + J, gaan naar Application -> Cookies, kopiëren token_v2 en noemen dit TOKEN. Vervolgens gaan we naar de pagina met de bibliotheektabel en kopiëren de link. We noemen dit NOTION.
Daarna schrijven we de code voor de verbinding met Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Laten we een functie schrijven om een rij aan de tabel toe te voegen.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Fictie":
            row.author = tags[2]

        elif tags[0] == "Non-fictie":
            row.tags = tags[2]

        elif tags[0] == "Studieboeken":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Wat hier gebeurt. We voegen een nieuwe rij toe aan de tabel op de eerste positie. Vervolgens splitsen we ons pad op " / " en krijgen we de tags. Tags zijn in de zin van "Fictie", "Design", wie de auteur is, enzovoorts. Vervolgens stellen we alle noodzakelijke velden van de tabel in.
Deel 3. We tellen woorden, uren en andere leuke dingen
Dit is al een iets moeilijkere taak. Zoals we ons herinneren, hebben we twee formaten: EPUB en PDF. Als het gaat om EPUB is het duidelijk — de woorden zijn daar waarschijnlijk zeker aanwezig, maar wat betreft PDF is het niet zo eenduidig: het kan simpelweg bestaan uit samengevoegde afbeeldingen.
Dus de functie voor het tellen van woorden in PDF ziet er als volgt uit: we nemen het aantal pagina's en vermenigvuldigen dat met een bepaalde constante (het gemiddelde aantal woorden per pagina).
Hier is het:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Dit zou WORDS_PER_PAGE voor een A4-pagina ongeveer gelijk zijn aan 300.
Laten we nu een functie schrijven om het aantal pagina's te tellen. We gaan gebruik maken van .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Laten we nu een functie schrijven om het aantal pagina's in EPUB te tellen. We gebruiken . Hier nemen we het boek, zetten het om naar regels, en tellen de woorden voor elke regel.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Laten we nu de leestijd berekenen. We nemen ons favoriete aantal woorden en delen het door jouw leessnelheid.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Deel 4. De onderdelen samenvoegen
We moeten alle mogelijke paden in onze boekmap doorlopen. Controleren of het boek al in Notion staat: als dat zo is, hoeven we de regel niet al te maken.
Daarna moeten we het bestandstype bepalen, afhankelijk daarvan het aantal woorden tellen. Ten slotte het boek toevoegen.
Dit is de code die we krijgen:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
En de functie om te controleren of het boek al is toegevoegd, ziet er zo uit:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Conclusie
Bedankt aan iedereen die dit artikel heeft gelezen. Ik hoop dat het je helpt om meer te lezen 🙂
Bron: habr.com
