

Dit is een mythe die vrij wijdverspreid is in de serverhardwaresector. In de praktijk zijn hypergeconvergeerde oplossingen (alles in één) echter voor veel doeleinden nodig. Historisch gezien zijn de eerste architecturen ontwikkeld door Amazon en Google voor hun diensten. Het idee was om een rekenboerderij te creëren met identieke nodes, elk met eigen schijven. Al dit werd samengevoegd door een bepaalde systeemvormende software (hypervisor) en verdeeld in virtuele machines. De hoofdtaak was het minimaliseren van de inspanning voor het onderhoud van één node en het minimaliseren van problemen bij schaling: je koopt gewoon nog een duizendtal van dezelfde servers en sluit ze aan. In de praktijk zijn dit unieke gevallen, en vaak gaat het over een kleiner aantal nodes en een iets andere architectuur.
De voordelen blijven echter hetzelfde - ongelooflijke eenvoud in schaling en beheer. Het nadeel is dat verschillende taken verschillende middelen verbruiken, en ergens zijn er veel lokale schijven, ergens is er te weinig RAM, enzovoort. Met andere woorden, bij verschillende soorten taken zal de benutting van middelen dalen.
Het bleek dat je 10-15% meer betaalt voor het gemak van configuratie. Dit veroorzaakte de mythe uit de titel. We hebben lang gezocht naar waar deze technologie optimaal toegepast zou kunnen worden, en we vonden het. Het is zo dat Cisco geen eigen storage-omgevingen had, maar ze wilden de volledige servermarkt. En ze hebben Cisco Hyperflex ontwikkeld - een oplossing met lokale opslag op de nodes.
Hierdoor ontstond plotseling een zeer goede oplossing voor back-up datacenters (Disaster Recovery). Waarom en hoe – dat vertel ik nu. En ik zal je cluster-testen laten zien.
Waar nodig
Hyperconvergentie is:
- Het verplaatsen van schijven naar rekennodes.
- Volledige integratie van de opslagsubsystemen met de virtualisatiesubsystemen.
- Verplaatsing/integratie met het netwerksubsystem.
Deze combinatie maakt het mogelijk om veel functies van storage-omgevingen op het niveau van virtualisatie te implementeren, en dat alles vanuit één beheerscherm.
In ons bedrijf zijn er veel aanvragen voor projecten voor het ontwerpen van back-up datacenters, en vaak wordt gekozen voor hypergeconvergeerde oplossingen vanwege de vele replicatiemogelijkheden (tot metroclustering) die standaard beschikbaar zijn.
In het geval van back-up datacenters gaat het meestal om een externe locatie aan de andere kant van de stad of zelfs in een andere stad. Dit maakt het mogelijk om cruciale systemen te herstellen in het geval van gedeeltelijke of volledige uitval van het primaire datacenter. Gegevens worden continu gerepliceerd vanaf de verkoopomgeving, en deze replicatie kan plaats vinden op applicatieniveau of op het niveau van een block device (SAN).
Daarom zal ik nu iets vertellen over de opzet van het systeem en de tests, en daarna over een paar scenario's van de praktische toepassing met gegevens over besparingen.
Tests
Ons exemplaar bestaat uit vier servers, elk met 10 SSD's van 960 GB. Er is een aparte schijf voor het cachen van schrijfbewerkingen en het opslaan van de service virtuele machine. De oplossing zelf is de vierde versie. De eerste was duidelijk onvoltooid (volgens de beoordelingen), de tweede was ook nog niet perfect, de derde is al behoorlijk stabiel, en deze kan een release worden genoemd na de beëindiging van de bètatest bij het brede publiek. Gedurende de testperiode heb ik geen problemen gezien, alles werkt als een trein.
Wijzigingen in v4Een heleboel bugs zijn opgelost.
In het begin kon het platform alleen werken met de hypervisor VMware ESXi en ondersteunde het een beperkt aantal nodes. Bovendien eindigde het uitrolproces niet altijd succesvol, sommige stappen moesten opnieuw worden opgestart, er waren problemen met de upgrade van oudere versies, gegevens in de GUI werden niet altijd correct weergegeven (hoewel ik nu nog steeds niet helemaal tevreden ben met de weergave van de prestatiegrafieken), en soms waren er problemen bij de interfacing met virtualisatie.
Nu zijn alle kinderziekten verholpen, HyperFlex ondersteunt zowel ESXi als Hyper-V, en daarnaast is het mogelijk:
- Een uitgebreide cluster op te zetten.
- Een cluster te creëren voor kantoren zonder gebruik te maken van Fabric Interconnect, van twee tot vier nodes (we kopen alleen servers).
- Mogelijkheid om te werken met externe SAN's.
- Ondersteuning voor containers en Kubernetes.
- Creëren van availability zones.
- Integratie met VMware SRM, als de ingebouwde functionaliteit niet voldoende is.
De architectuur verschilt niet veel van die van de belangrijkste concurrenten; een nieuw wiel uitvinden deden ze niet. Alles draait op het virtualisatieplatform VMware of Hyper-V. Hardwarematig draait het op servers van eigen ontwerp van Cisco UCS. Er zijn mensen die het platform haten vanwege de relatieve complexiteit van de initiële configuratie, de vele knopjes, het niet-triviale sjablonaire systeem en afhankelijkheden, maar er zijn ook mensen die zen hebben gevonden, zich in het idee hebben verdiept en niet meer met andere servers willen werken.
We bekijken specifiek de oplossing voor VMware, omdat de oplossing oorspronkelijk voor hen is ontwikkeld en meer functionaliteit heeft. Hyper-V is tussentijds aangepast om niet achter te blijven bij de concurrentie en te voldoen aan de verwachtingen van de markt.
Er is een cluster van servers, gevuld met schijven. Er zijn schijven voor gegevensopslag (SSD of HDD – naar uw smaak en behoeften), en er is één SSD-schijf voor caching. Bij het schrijven van gegevens naar de datastore wordt de gegevensopslag op de cache-laag (de toegewezen SSD-schijf en RAM van de service-VM) opgeslagen. Tegelijkertijd wordt een gegevensblok naar de knooppunten in het cluster gestuurd (het aantal knooppunten hangt af van de replicatiefactor van het cluster). Na bevestiging van alle knooppunten over een succesvolle opname, wordt de bevestiging naar de hypervisor en vervolgens naar de VM gestuurd. De opgeslagen gegevens worden op de achtergrond gededupliceerd, gecomprimeerd en naar de opslagdisks geschreven. Hierbij wordt altijd een groot blok en sequentieel naar de opslagdisks geschreven, wat de belasting van de opslagdisks vermindert.
Deduplicatie en compressie zijn constant ingeschakeld en kunnen niet worden uitgeschakeld. Het lezen van gegevens gebeurt rechtstreeks vanaf de opslagdisks of uit de RAM-cache. Als een hybride configuratie wordt gebruikt, wordt het lezen ook gecached op de SSD-schijf.
Gegevens zijn niet gebonden aan de huidige locatie van de virtuele machine en worden gelijkmatig over de knooppunten verdeeld. Deze aanpak zorgt ervoor dat alle schijven en netwerkkoppelingen gelijkmatig belast worden. Een duidelijk nadeel dringt zich op: we kunnen de lezingstijd niet maximaal minimaliseren, omdat er geen garantie is dat de gegevens lokaal beschikbaar zijn. Maar ik denk dat dit een kleine offer is in vergelijking met de voordelen die we krijgen. Bovendien zijn de netwerklatenties zo laag dat ze praktisch geen invloed hebben op het totale resultaat.
Het hele logica van de schijfondersteuning wordt beheerd door een speciale service-VM, de Cisco HyperFlex Data Platform controller, die op elke opslagnode wordt aangemaakt. In onze configuratie is er acht vCPU en 72 GB RAM aan de service-VM toegewezen, wat niet onaanzienlijk is. Ter herinnering, de host zelf heeft 28 fysieke kernen en 512 GB RAM beschikbaar.
De service-VM heeft directe toegang tot de fysieke schijven via de doorpassing van de SAS-controller naar de VM. Communicatie met de hypervisor vindt plaats via een speciale module, IOVisor, die in- en uitvoerbewerkingen onderschept, en via een agent die opdrachten naar de API van de hypervisor verzendt. De agent is verantwoordelijk voor het werken met HyperFlex-snapshoten en klonen.
In de hypervisor worden schijfbronnen gemonteerd als NFS- of SMB-share (afhankelijk van het type hypervisor, raad maar eens welke waar is). En onder de motorkap gaat het om een gedistribueerd bestandssysteem dat functies van volledige opslagarrays mogelijk maakt: thin provisioning, compressie en deduplicatie, snapshots op basis van de Redirect-on-Write-technologie, en synchronisatie/asynchronisatie replicatie.
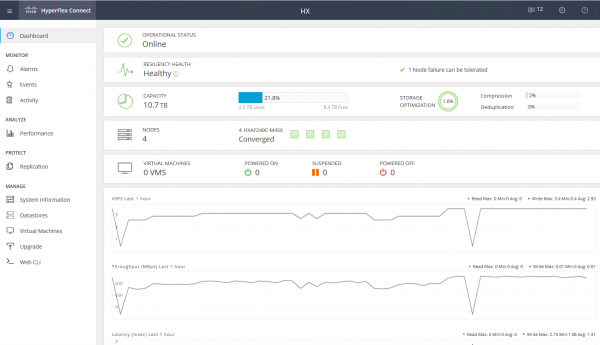
De service-VM biedt toegang tot de webinterface voor het beheer van de HyperFlex-systeemondersteuning. Er is integratie met vCenter, en de meeste dagelijkse taken kunnen vanuit daar worden uitgevoerd, maar het splitsen van datastores is bijvoorbeeld handiger vanaf een aparte webinterface, als je al bent overgeschakeld op de snelle HTML5-interface, of met de volledige Flash-client met volledige integratie. In de service-webinterface kun je de prestaties en gedetailleerde status van het systeem bekijken.
Er is ook een ander soort node in het cluster — rekennodes. Dit kunnen rackservers of blade-servers zijn zonder ingebouwde schijven. Op deze servers kunnen VM's worden uitgevoerd waarvan de gegevens zijn opgeslagen op servers met schijven. Wat betreft toegang tot gegevens, is er geen verschil tussen de typen nodes, aangezien de architectuur abstractie van de fysieke locatie van gegevens impliceert. De maximale verhouding van rekennodes tot opslagnodes is 2:1.
Het gebruik van rekennodes verhoogt de flexibiliteit bij het schalen van de clusterresources: we hoeven geen nodes met schijven aan te schaffen als we alleen behoefte hebben aan CPU/RAM. Bovendien kunnen we een blade-schap toevoegen en besparen op de plaatsing van servers in de kast.
Als resultaat hebben we een hypergeconvergeerd platform met de volgende functies:
- Tot 64 knooppunten in de cluster (tot 32 opslagknooppunten).
- Het minimale aantal knooppunten in de cluster is drie (twee voor de Edge-cluster).
- Dataredundantiemechanisme: mirroring met replicatiefactor 2 en 3.
- Metro-cluster.
- Asynchrone replicatie van VM naar een andere HyperFlex-cluster.
- Orkestratie van VM-overdracht naar een externe datacenter.
- Native snapshots met Redirect-on-Write-technologie.
- Tot 1 PB bruikbare ruimte met replicatiefactor 3 en zonder deduplicatie. Replicatiefactor 2 wordt niet meegerekend, omdat dit geen optie is voor een serieuze verkoop.
Nog een enorm voordeel — eenvoud in beheer en implementatie. Alle complexiteiten van het configureren van UCS-servers worden afgehandeld door een gespecialiseerde VM, voorbereid door Cisco-ingenieurs.
Configuratie van de testopstelling:
- 2 x Cisco UCS Fabric Interconnect 6248UP als beheerknooppunt en netwerkcomponenten (48 poorten, werkend in Ethernet 10G/FC 16G-modus).
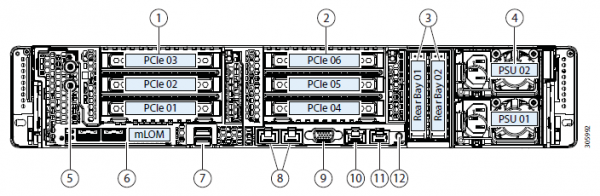
- Vier servers Cisco UCS HXAF240 M4.
Specificaties van de servers:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Netwerk global log /dev/log local0 log /dev/log local1 notice chroot /var/lib/haproxy stats timeout 30s user haproxy group haproxy daemondefaults log global mode http option httplog option dontlognull timeout connect 5000 timeout client 50000 timeout server 50000frontend http_front bind *:80 stats uri /haproxy?stats default_backend http_backbackend http_back balance roundrobin server server_name1 private_ip1:80 check server server_name2 private_ip2:80 check
UCSC-MLOM-CSC-02 (VIC 1227). 2 poorten 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass-through Controller
Opslag Schijven
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Meer configuratieoptiesNaast de geselecteerde hardware zijn momenteel de volgende opties beschikbaar:
- HXAF240c M5.
- Een of twee CPU's van Intel Silver 4110 tot Intel Platinum I8260Y. Tweede generatie is beschikbaar.
- 24 geheugenslots, modules van 16 GB RDIMM 2600 tot 128 GB LRDIMM 2933.
- Van 6 tot 23 schijven voor gegevens, één cache-schijf, één systeem- en één opstartschijf.
Capaciteitsschijven
- HX-SD960G61X-EV 960GB 2.5 Inch Enterprise Value 6G SATA SSD (1X endurance) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X endurance) SAS 3.8 TB.
- Cache-schijven
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Extreme Prestatie & Duurzaamheid.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Prestatie NVMe SSD (3X endurance) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Prestatie 12G SAS SSD (10X endurance) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Prestatie 12G SAS SED SSD (10X endurance) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise Prestatie 12G SAS SSD (3X endurance).
Systeem / Log Drives
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (Upgrade vereist).
Opstartschijven
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Verbinding met het netwerk via 40G, 25G of 10G poorten Ethernet.
Als FI kunnen HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G) worden gebruikt.
De test zelf
Voor het testen van het opslag subsystem heb ik HCIBench 2.2.1 gebruikt. Dit is een gratis tool die het genereren van belasting vanuit meerdere virtuele machines automatiseert. De belasting zelf wordt gegenereerd door een standaard fio.
Onze cluster bestaat uit vier knooppunten, replicatiefactor 3, alle schijven zijn Flash.
Voor de tests heb ik vier datastores en acht virtuele machines aangemaakt. Voor de schrijftests is het scenario aangenomen dat de cache-schijf niet volloopt.
De testresultaten zijn als volgt:
100% Lezen 100% Willekeurig
0% Lezen 100% Willekeurig
Blok/diepte van de wachtrij
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Dikgedrukt zijn de waarden gemarkeerd, waarna er geen prestatieverbetering meer is, soms is er zelfs een degradatie zichtbaar. Dit komt doordat we tegen de prestaties van het netwerk/controllers/disks aanlopen.
- Sequentieel lezen 4432 MB/s.
- Sequentieel schrijven 804 MB/s.
- Bij het falen van één controller (uitval van de virtuele machine of host) daalt de prestatie met de helft.
- Bij falen van de opslag-schijf is het prestatiedaling 1/3. De rebuild van de schijf kost 5% van de middelen van elke controller.
Met een klein blok lopen we tegen de prestaties van de controller aan (virtuele machine), zijn CPU is voor 100% belast, en bij verhoging van het blok komen we uit bij de bandbreedte van de poorten. 10 Gbit/s is onvoldoende om het potentieel van een AllFlash-systeem te benutten. Helaas konden de parameters van de geleverde demo-stand geen testen op 40 Gbit/s uitvoeren.
Volgens mijn indrukken van de tests en de architectuur, krijgen we door het algoritme dat de data tussen alle hosts plaatst, schaalbare voorspelbare prestaties, maar dit is ook een beperking bij het lezen, omdat we lokaal meer zouden kunnen behalen, hier zou een snellere netwerkverbinding kunnen helpen, bijvoorbeeld FI op 40 Gbit/s is beschikbaar.
Ook kan één schijf voor caching en deduplicatie een beperking zijn; feitelijk kunnen we in deze stand op vier SSD-schijven schrijven. Het zou geweldig zijn om de mogelijkheid te hebben om het aantal cache-schijven te verhogen en het verschil te zien.
Echt gebruik
Voor de organisatie van een reserve-datacenter kunnen twee benaderingen worden gebruikt (plaatsing van de back-up op een externe locatie wordt niet overwogen):
- Actief-Passief. Alle applicaties worden gedistribueerd in de primaire datacenter. Replica's zijn synchroon of asynchroon. In geval van uitval van de primaire datacenter moeten we de reserve activeren. Dit kan handmatig/scriptmatig/door orkestratie-applicaties worden gedaan. Hier zullen we RPO verkrijgen, gelijkwaardig aan de replicatiefrequentie, en RTO hangt af van de reactie en de vaardigheden van de beheerder, evenals de kwaliteit van het switchplan.
- Actief-Actief. In dit geval is er alleen synchronisatie-replicatie, de beschikbaarheid van de datacenters wordt bepaald door een quorum/arbitraire dat strikt op een derde locatie is geplaatst. RPO = 0, en RTO kan 0 bereiken (als de applicatie dit toestaat) of is gelijk aan de tijd die nodig is om de uitval van een knooppunt in de virtualisatiecluster te verwerken. Op het niveau van virtualisatie wordt een uitgestrekt (Metro) cluster gecreëerd, dat een Actief-Actief opslagoplossing vereist.
Gewoonlijk zien we bij klanten al een gerealiseerde architectuur met een klassieke opslagoplossing in de primaire datacenter, daarom ontwerpen we er nog een voor replicatie. Zoals ik al eerder noemde, biedt Cisco HyperFlex asynchrone replicatie en de creatie van een uitgestrekt virtualisatiecluster. Daarbij hebben we geen speciale opslag voor midrange en hoger nodig met dure replicatiefuncties en Actief-Actief toegang tot data in twee opslagsystemen.
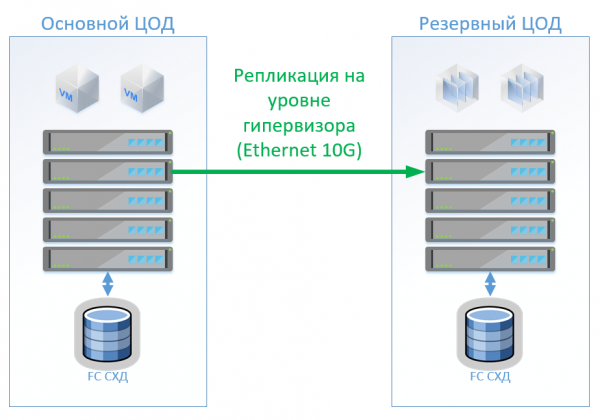
Scenario 1: We hebben een primaire en een reserve datacenter, en de virtualisatieplatform is VMware vSphere. Alle productie-systemen bevinden zich in de primaire datacenter, en de replicatie van virtuele machines gebeurt op hypervisor-niveau, zodat we de VM's niet actief hoeven te houden in de reserve datacenter. Databases en speciale applicaties worden gerepliceerd met ingebouwde middelen en de VM's blijven ingeschakeld. Bij een uitval van de primaire datacenter starten we de systemen in de reserve datacenter. We schatten dat we ongeveer 100 virtuele machines hebben. Zolang de primaire datacenter actief is, kunnen er in de reserve datacenter testomgevingen en andere systemen worden gestart die kunnen worden uitgeschakeld in het geval van een switch naar de primaire datacenter. Er is ook een optie waarbij we bidirectionele replicatie gebruiken. Wat betreft hardware zal er niets veranderen.
In het geval van een klassieke architectuur plaatsen we in elk datacenter een hybride opslagoplossing met toegang via FibreChannel, tiering, deduplicatie en compressie (maar niet online), 8 servers per locatie, met elke 2 FibreChannel- en 10G Ethernet-switches. Voor replicatie en failoverbeheer in de klassieke architectuur kunnen we VMware-tools (Replication + SRM) gebruiken of alternatieve tools die iets goedkoper en soms handiger zijn.
De afbeelding toont het schema.
In het geval van Cisco HyperFlex krijgen we de volgende architectuur:
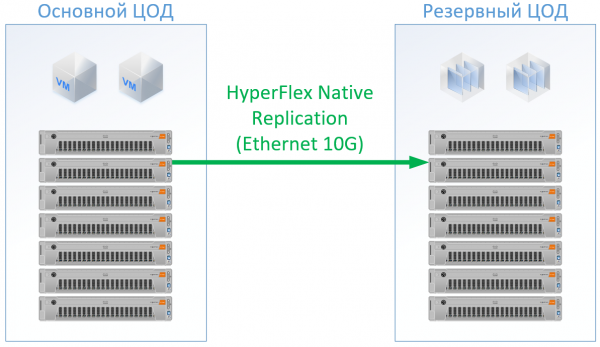
Voor HyperFlex heb ik servers met grote CPU/RAM-bronnen gebruikt, aangezien een deel van de bronnen naar de HyperFlex-controller VM gaat. Voor CPU en geheugen heb ik zelfs wat extra capaciteit in de HyperFlex-configuratie ingebracht, om niet in het voordeel van Cisco te spelen en middelen voor de andere VMs te garanderen. Daarom kunnen we de FibreChannel-switches weglaten en zijn Ethernet-poorten voor elke server niet nodig, lokaal verkeer wordt binnen de FI geschakeld.
Uiteindelijk kreeg ik de volgende configuratie voor elk datacenter:
Servers
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Storage Systems
Hybride opslag met FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x 10G Ethernet-switch 12 poorten
—
SAN
2 x FC-switch 32/16Gb 24 poorten
2 x Cisco UCS FI 6332
Licenties
VMware Ent Plus
Replicatie en/of orchestratie van VM-failover
VMware Ent Plus
Voor HyperFlex heb ik geen licenties voor replicatiesoftware opgenomen, aangezien dit standaard beschikbaar is.
Voor de klassieke architectuur heb ik een leverancier gekozen die zich bewezen heeft als een kwalitatieve en kosteneffectieve producent. Voor beide opties heb ik de gebruikelijke kortingen toegewezen, en zo kreeg ik reële prijzen.
De oplossing op basis van Cisco HyperFlex was 13% goedkoper.
Scenario 2: het creëren van twee actieve datacenters. In dit scenario ontwerpen we een uitgerokken cluster op VMware.
De klassieke architectuur bestaat uit virtualisatieservers, SAN (FC-protocol) en twee opslagoplossingen die in staat zijn te lezen en te schrijven aan wat zich tussen hen bevindt. Op elke opslagoplossing reserveren we bruikbare capaciteit voor lokale opslag.
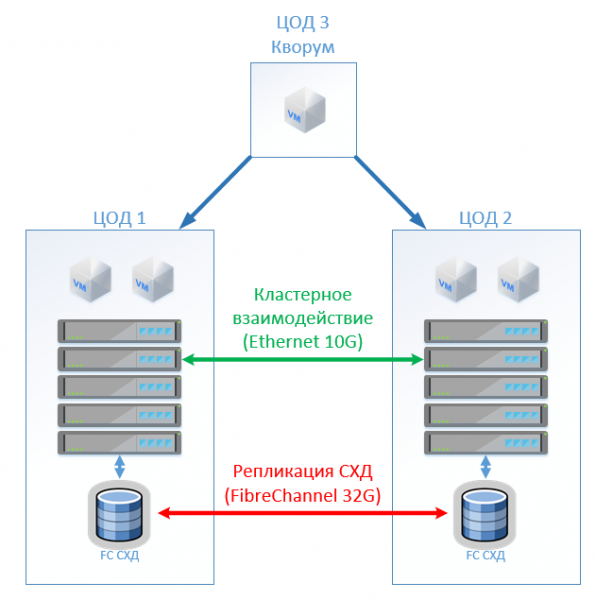
Met HyperFlex creëren we eenvoudig een Stretch Cluster met een gelijk aantal nodes op beide locaties. In dit geval wordt een replicatiefactor van 2+2 gebruikt.
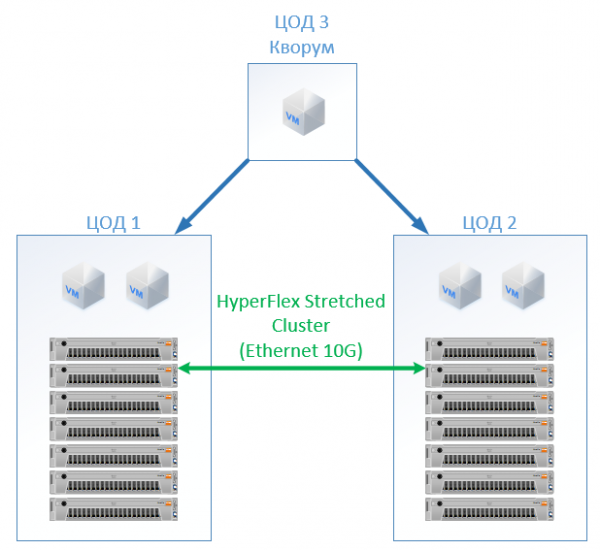
Hieruit resulteert de volgende configuratie:
Klassieke architectuur
HyperFlex
Servers
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Storage Systems
2 x AllFlash opslagoplossingen (150 TB SSD)
—
LAN
4 x 10G Ethernet-switch 24 poorten
—
SAN
4 x FC-switch 32/16Gb 24 poorten
4 x Cisco UCS FI 6332
Licenties
VMware Ent Plus
VMware Ent Plus
Bij al mijn berekeningen heb ik de netwerkinfrastructuur, kosten voor de datacenter, enz. niet meegenomen: deze zullen identiek zijn voor de klassieke architectuur en voor de HyperFlex-oplossing.
Wat betreft kosten, kwam HyperFlex 5% duurder uit. Het is belangrijk op te merken dat ik voor Cisco een ongelijkwicht had in de CPU/RAM-resources, omdat ik de geheugencanalen in de configuratie gelijkmatig vulde. De kosten zijn iets hoger, maar niet astronomisch, wat duidelijk aangeeft dat hyperconvergentie niet per se "een speeltje voor de rijken" is, maar kan concurreren met de standaard benadering van het opzetten van een datacenter. Dit kan ook interessant zijn voor degenen die al Cisco UCS-servers en de bijbehorende infrastructuur hebben.
De voordelen zijn onder andere het ontbreken van kosten voor SAN- en opslagadministratie, online compressie en deduplicatie, een enkel toegangspunt voor ondersteuning (virtualisatie, servers, ook - opslag), ruimtebesparing (maar niet in alle scenario's), en vereenvoudiging van het onderhoud.
Wat betreft ondersteuning, krijgt u deze van één leverancier - Cisco. Op basis van mijn ervaringen met Cisco UCS-servers vind ik deze goed, ik hoefde HyperFlex eigenlijk niet te openen, alles werkte al. Ingenieurs reageren snel en kunnen niet alleen standaardproblemen oplossen, maar ook complexe grensgevallen. Soms vraag ik ze: "Is het mogelijk om dit zo te doen, dit eraan te koppelen?" of "Ik heb iets geconfigureerd en het wil niet werken. Help!" - ze vinden geduldig de juiste gids en wijzen op de juiste stappen, ze zullen niet zeggen: "We lossen alleen hardwareproblemen op."
Links
- Mijn e-mail is StGeneralov@croc.ru
Bron: habr.com
