

Hallo allemaal!
Het heeft zich zo ontwikkeld dat ons kleine team, niet recentelijk en zeker niet plotseling, klaar is om enkele (en in de toekomst mogelijk alle) producten naar Kubernetes te migreren.
Er waren veel redenen hiervoor, maar onze geschiedenis gaat niet over de controverse.
Wat betreft de infrastructuur was onze keuze beperkt. vCloud Director en vCloud Director. We hebben de nieuwere gekozen en besloten om te beginnen.
Na nogmaals door 'The Hard Way' te bladeren, kwam ik zeer snel tot de conclusie dat een tool voor het automatiseren van ten minste basisprocessen, zoals deployment en sizing, al gisteren nodig was. Een diepe duik in Google onthulde een product genaamd VMware Container Service Extension (CSE) — een open-source product dat het mogelijk maakt om de creatie en sizing van k8s-clusters te automatiseren voor degenen die met vCloud werken.
Disclaimer: CSE heeft zijn beperkingen, maar voor onze doeleinden was het perfect. Ook moet de oplossing ondersteund worden door de cloudprovider, maar aangezien de serverzijde ook open-source is, eis het beschikbaarheid bij uw dichtstbijzijnde manager 🙂
Voor het gebruik is een beheerdersaccount in de vCloud-organisatie nodig en een vooraf aangemaakte routed netwerk voor het cluster (tijdens de deployment is toegang tot internet vanuit dit netwerk vereist, vergeet niet om de Firewall/NAT in te stellen). De adressering doet er niet toe. In dit voorbeeld nemen we 10.0.240.0/24.

Aangezien het cluster na creatie op een of andere manier beheerd moet worden, is het aan te raden om een VPN met routing naar het aangemaakte netwerk te hebben. We gebruiken een standaard SSL-VPN, ingesteld op de Edge Gateway van onze organisatie.
Vervolgens moet de CSE-client daar worden geïnstalleerd vanaf waar de k8s-clusters zullen worden beheerd. In mijn geval is dit mijn werk laptop en een paar goed verborgen containers die de automatisering aansteken.
De client vereist dat Python versie 3.7.3 of hoger is geïnstalleerd en de module , dus laten we dat en het een en ander installeren.
pip3 install vcd-cli

pip3 install container-service-extension
Na de installatie controleren we de versie van CSE en krijgen we het volgende:
# vcd cse version
Error: No such command "cse".
Onverwacht, maar oplosbaar. Blijkbaar moet CSE als een module aan vcd-cli worden gekoppeld.
Hiervoor moet je eerst inloggen met vcd-cli in onze organisatie:
# vcd login MyCloud.provider.com org-dev admin
Password:
admin logged in, org: 'org-dev', vdc: 'org-dev_vDC01'
Daarna zal vcd-cli een configuratiebestand aanmaken ~/.vcd-cli/profiles.yaml
Aan het einde moet je het volgende toevoegen:
extensions:
  - container_service_extension.client.cse
Daarna verifiëren we opnieuw:
# vcd cse version
CSE, Container Service Extension for VMware vCloud Director, version 2.5.0
De installatie van de klant is voltooid. Laten we proberen de eerste cluster uit te rollen.
CSE heeft verschillende sets parameters die allemaal kunnen worden bekeken.
Laten we beginnen met het aanmaken van sleutels voor wachtwoordloze toegang tot de toekomstige cluster. Dit is belangrijk, omdat de toegang met een wachtwoord op de knooppunten standaard is uitgeschakeld. Als er geen sleutels worden ingesteld, kan er veel werk via de consoles van virtuele machines worden gedaan, wat niet bepaald handig is.
# ssh-keygen
Generating public/private rsa key pair.
Enter file in which to save the key (/root/.ssh/id_rsa):
Created directory '/root/.ssh'.
Enter passphrase (empty for no passphrase):
Enter same passphrase again:
Your identification has been saved in /root/.ssh/id_rsa.
Your public key has been saved in /root/.ssh/id_rsa.pub.
We proberen de cluster te maken:
vcd cse cluster create MyCluster --network k8s_cluster_net --ssh-key ~/.ssh/id_rsa.pub --nodes 3 --enable-nfsAls we een fout krijgen Error: Sessie is verlopen of gebruiker niet ingelogd. Log opnieuw in. — log opnieuw in met vcd-cli in vCloud zoals hierboven beschreven en probeer het opnieuw.
Deze keer ging alles goed en de taak om de cluster te maken is gestart.
cluster operatie: Cluster vApp 'MyCluster' (38959587-54f4-4a49-8f2e-61c3a3e879e0) aanmaken vanuit template 'photon-v2_k8-1.12_weave-2.3.0' (herziening 1)
Het zal ongeveer 20 minuten duren om de taak te voltooien; in de tussentijd bekijken we de belangrijkste parameters voor het starten.
—network — het netwerk dat we eerder hebben aangemaakt.
—ssh-key — de sleutels die we hebben aangemaakt, die op de knooppunten van de cluster zullen worden geschreven.
—nodes n — Aantal worker knooppunten in de cluster. De master is altijd één, dat is een beperking van CSE.
—enable-nfs — maak een extra knooppunt voor een NFS-share onder persistent volumes. Een iets complexere optie, we zullen later terugkomen op wat het precies doet.
In de tussentijd kan de voortgang van het maken van de cluster visueel worden gevolgd in vCloud.
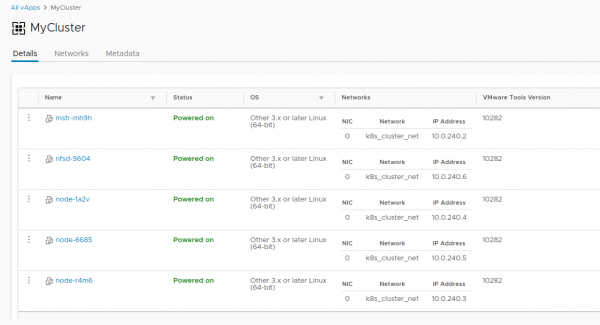
Zodra de taak voor het maken van de cluster is voltooid, is deze klaar voor gebruik.
Laten we de juistheid van de deployment controleren met het commando. vcd cse cluster info MyCluster
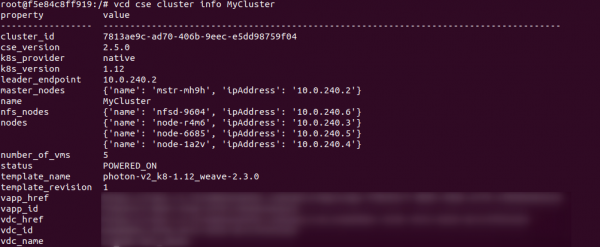
Vervolgens moeten we de configuratie van de cluster verkrijgen voor gebruik. kubectl
# vcd cse cluster config MyCluster > ./.kube/config
En we kunnen de status van de cluster nu met behulp hiervan controleren:
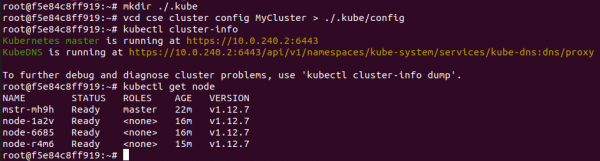
Op dit moment kan de cluster voorwaardelijk als operationeel worden beschouwd, ware het niet om de kwestie van persistent volumes. Aangezien we in vCloud zijn, is het niet mogelijk om de vSphere Provider te gebruiken. De optie —enable-nfs is bedoeld om deze ongemakken glad te strijken, maar het is niet helemaal gelukt. Handmatige aanpassing is vereist.
Eerst moet onze knooppunt een aparte onafhankelijke schijf in vCloud aanmaken. Dit garandeert dat onze gegevens niet verdwijnen bij het verwijderen van de cluster, mocht deze verwijderd worden. Laten we ook de schijf aansluiten op NFS.
# vcd disk create nfs-shares-1 100g --description 'Kubernetes NFS shares'
# vcd vapp attach mycluster nfsd-9604 nfs-shares-1
Daarna gaan we via ssh (je hebt toch echt de sleutels aangemaakt?) naar onze NFS-knooppunt en sluiten we de schijf definitief aan:
root@nfsd-9604:~# parted /dev/sdb
(parted) mklabel gpt
Waarschuwing: Het bestaande schijflabel op /dev/sdb wordt vernietigd en alle gegevens op deze schijf gaan verloren. Wilt u doorgaan?
Ja/Nee? ja
(parted) unit GB
(parted) mkpart primary 0 100
(parted) print
Model: VMware Virtual disk (scsi)
Schijf /dev/sdb: 100GB
Sector grootte (logisch/fysiek): 512B/512B
Partitietabel: gpt
Schijfvlaggen:

Nummer  Start   Eind    Grootte   Besturingssysteem  Naam     Vlaggen
 1      0.00GB  100GB  100GB               primary

(parted) quit
root@nfsd-9604:~# mkfs -t ext4 /dev/sdb1
Bestandssysteem aan het aanmaken met 24413696 4k blokken en 6111232 inodes
Bestandssysteem UUID: 8622c0f5-4044-4ebf-95a5-0372256b34f0
Back-ups van het superblok zijn opgeslagen op blokken:
	32768, 98304, 163840, 229376, 294912, 819200, 884736, 1605632, 2654208,
	4096000, 7962624, 11239424, 20480000, 23887872

Groepstabellen toewijzen: gedaan
Inode-tabellen schrijven: gedaan
Journals aanmaken (32768 blokken): gedaan
Superblokken en informatie over het bestandssysteem schrijven: gedaan
We maken een directory aan voor gegevens en monteren daar de nieuwe partitie:
mkdir /export
echo '/dev/sdb1  /export   ext4  defaults   0 0' >> /etc/fstab
mount -a
Laten we vijf testpartities aanmaken en ze delen voor de cluster:
>cd /export
>mkdir vol1 vol2 vol3 vol4 vol5
>vi /etc/exports
#Voeg dit toe aan het einde van het bestand
/export/vol1 *(rw,sync,no_root_squash,no_subtree_check)
/export/vol2 *(rw,sync,no_root_squash,no_subtree_check)
/export/vol3 *(rw,sync,no_root_squash,no_subtree_check)
/export/vol4 *(rw,sync,no_root_squash,no_subtree_check)
/export/vol5 *(rw,sync,no_root_squash,no_subtree_check)
#:wq! ;)
#Verder - exporteer de partities
>exportfs -r
Na al deze magie kunnen we een PV en PVC in onze cluster maken, ongeveer zo:
PV:
cat <<EOF | kubectl apply -f -
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfs-vol1
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteMany
  nfs:
    # Zelfde IP als de NFS-host waar we eerder naar ssh'ten.
    server: 10.150.200.22
    path: "/export/vol1"
EOF
PVC:
cat <<EOF | kubectl apply -f -
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: nfs-pvc
spec:
  accessModes:
    - ReadWriteMany
  storageClassName: ""
  resources:
    requests:
      storage: 10Gi
EOF
Hier eindigt het verhaal van het creëren van een cluster en begint het verhaal van de levenscyclus ervan. Als bonus - nog twee handige CSE-commando's die soms behoorlijk kunnen besparen of kosten:
#Увеличиваем размер кластера до 8 воркер нод
>cse cluster resize MyCluster --network k8s_cluster_net --nodes 8

#Выводим ненужные ноды из кластера с их последующим удалением
>vcd cse node delete MyCluster node-1a2v node-6685 --yes
Iedereen bedankt voor de tijd, als er vragen zijn - stel ze in de opmerkingen.
Bron: habr.com
