

De toekomst is aangebroken; technologieën zoals kunstmatige intelligentie en machine learning worden al met succes gebruikt door uw favoriete winkels, vervoersbedrijven en zelfs boerderijen die kalkoenen fokken.
En als iets bestaat, dan is er al iets over te vinden op het internet... een open project! Bekijk hoe Open Data Hub helpt bij het opschalen van nieuwe technologieën en het vermijden van moeilijkheden bij hun implementatie.
Ondanks alle voordelen van kunstmatige intelligentie (AI) en machine learning (ML) ondervinden organisaties vaak problemen bij het opschalen van deze technologieën. De belangrijkste problemen zijn meestal als volgt:
- Informatie-uitwisseling en samenwerking – informatie uitwisselen zonder extra inspanning en samenwerken in snelle iteraties is praktisch onmogelijk.
- Toegang tot gegevens – voor elke taak moet dit opnieuw en handmatig worden opgebouwd, wat veel tijd kost.
- On-demand toegang – er is geen mogelijkheid om on-demand toegang te krijgen tot de tools en platform voor machine learning, evenals tot de rekeninfrastructuur.
- Productie – modellen blijven op het prototype-niveau en worden niet naar productie gebracht.
- Het volgen en verklaren van de resultaten van AI – reproduceerbaarheid, tracing en uitleg van de resultaten van AI/ML zijn moeilijk.
Als deze problemen onopgelost blijven, hebben ze een negatieve invloed op de snelheid, efficiëntie en productiviteit van waardevolle data-analyse specialisten. Dit leidt tot frustratie, ontevredenheid over het werk en uiteindelijk vervagen de zakelijke verwachtingen omtrent AI/ML.
De verantwoordelijkheid voor het oplossen van deze problemen ligt bij IT-specialisten, die data-analisten moeten voorzien van – juist, iets dat lijkt op de cloud. Meer uitgebreid gezegd, er is een platform nodig dat keuzevrijheid biedt en eenvoudig toegankelijk is. Het moet snel, gemakkelijk inzetbaar, schaalbaar op aanvraag en robuust zijn. Het opbouwen van zo'n platform op basis van open-source technologieën helpt om vendor locking te voorkomen en een duurzaam strategisch voordeel te behouden op het gebied van kostenbeheersing.
Enkele jaren geleden vond vergelijkbare ontwikkeling plaats in de applicatieontwikkeling, wat leidde tot de opkomst van microservices, hybride cloudomgevingen, IT-automatisering en agile-processen. Om hierop in te spelen, begonnen IT-professionals containers, Kubernetes en open hybride clouds te gebruiken.
Deze ervaring wordt nu toegepast om te reageren op de uitdagingen van AI. Daarom creëren IT-specialisten platforms die zijn gebaseerd op containers, waardoor AI/ML-diensten binnen agile-processen kunnen worden ontwikkeld, innovaties worden versneld en gebouwd worden met een focus op hybride cloud.
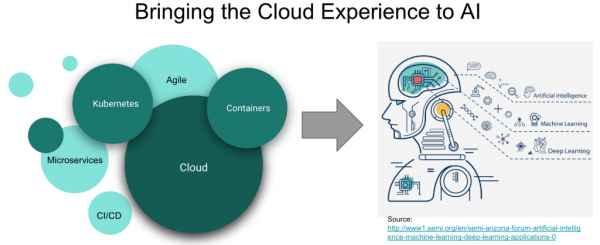
We beginnen de bouw van een dergelijk platform met Red Hat OpenShift, ons container Kubernetes-platform voor hybride cloud, dat een snelgroeiend ecosysteem van software- en hardware-oplossingen voor ML (NVIDIA, H2O.ai, Starburst, PerceptiLabs, enz.) heeft. Enkele van de klanten van Red Hat, zoals BMW Group, ExxonMobil en anderen, hebben al container-gebaseerde ML-toolchains en DevOps-processen uitgerold op basis van dit platform en het bijbehorende ecosysteem om hun ML-architecturen in industriële productie te krijgen en de werkzaamheden van data-analisten te versnellen.
Een andere reden waarom we het project Open Data Hub zijn gestart, is om een voorbeeldarchitectuur op basis van meerdere open source-projecten te demonstreren en te laten zien hoe de volledige levenscyclus van een ML-oplossing op het OpenShift-platform kan worden gerealiseerd.
Project Open Data Hub
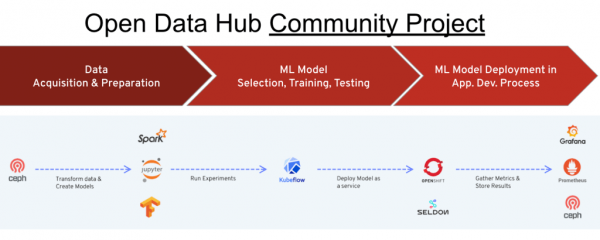
Dit is een open source-project dat zich ontwikkelt binnen de bijbehorende ontwikkelgemeenschap en de volledige cyclus van operaties realiseert – van het uploaden en transformeren van ruwe gegevens tot het vormen, trainen en onderhouden van een model – bij het oplossen van AI/ML-taken met behulp van containers en Kubernetes op het OpenShift-platform. Dit project kan worden beschouwd als een referentie-implementatie, een voorbeeld van hoe een open oplossing van het type 'AI/ML als een dienst' kan worden gebouwd op basis van OpenShift en relevante open source-tools zoals Tensorflow, JupyterHub, Spark en anderen. Het is belangrijk op te merken dat Red Hat dit project zelf gebruikt om zijn AI/ML-diensten aan te bieden. Bovendien is OpenShift geïntegreerd met belangrijke software- en hardware-oplossingen voor ML van NVIDIA, Seldon, Starburst en andere leveranciers, wat de bouw en implementatie van eigen machine learning-systemen vergemakkelijkt.
Het project Open Data Hub richt zich op de volgende gebruikerscategorieën en gebruiksscenario's:
- Een data-analist die een cloud-gebaseerde oplossing voor de uitvoering van ML-projecten nodig heeft, met zelfbediening functies.
- Een data-analist die de maximale keuze zoekt uit een breed scala van de nieuwste open-source AI/ML-tools en -platformen.
- Een data-analist die toegang nodig heeft tot gegevensbronnen tijdens het trainen van modellen.
- Een data-analist die toegang nodig heeft tot rekenbronnen (CPU, GPU, geheugen).
- Een data-analist die de mogelijkheid vereist om samen te werken en resultaten met collega's te delen, feedback te ontvangen en verbeteringen door te voeren via snelle iteraties.
- Een data-analist die wil samenwerken met ontwikkelaars (en devops-teams) zodat zijn ML-modellen en resultaten in productie kunnen worden genomen.
- Een data-engineer die data-analyse toegang moet geven tot verschillende gegevensbronnen, met inachtneming van normen en veiligheidsvereisten.
- Een IT-systeemadministrator/operator die de mogelijkheid vereist om het levenscyclusbeheer (installatie, configuratie, updates) van open-source componenten en technologieën zonder veel moeite te controleren. Ook heeft hij de juiste beheertools en quota nodig.
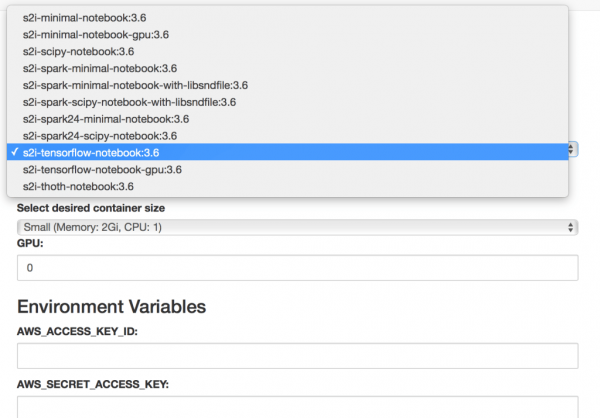
Het Open Data Hub-project verenigt een reeks open-source tools voor het realiseren van de volledige cyclus van AI/ML-operaties. Het belangrijkste werktool voor de data-analist is hier Jupyter Notebook. Deze tool is tegenwoordig erg populair onder data-analyse en verwerkingsspecialisten, en Open Data Hub stelt hen in staat om eenvoudig Jupyter Notebook-werkomgevingen te creëren en te beheren, met gebruik van de ingebouwde JupyterHub. Naast het creëren en importeren van Jupyter notities, bevat het Open Data Hub-project ook een aantal kant-en-klare notebooks in de vorm van een AI Library.
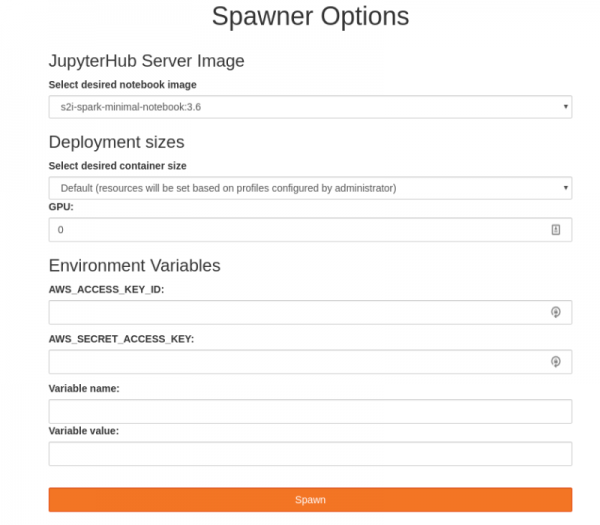
Deze bibliotheek is een verzameling open-source componenten voor machine learning en oplossingen voor typische scenarios, die snel prototyping vereenvoudigen. JupyterHub is geïntegreerd met het RBAC-toegangsmodel van OpenShift, waardoor bestaande OpenShift-accounts kunnen worden gebruikt en er een single sign-on systeem wordt gerealiseerd. Bovendien biedt JupyterHub een gebruiksvriendelijke interface genaamd spawner, waarmee een gebruiker eenvoudig de hoeveelheid rekencapaciteit (CPU-kernen, geheugen, GPU) voor de gekozen Jupyter Notebook kan configureren.
Nadat de data-analist de notebook heeft aangemaakt en geconfigureerd, neemt de Kubernetes-Planner, die onderdeel is van OpenShift, de overige zorg voor deze notebook voor zijn rekening. Gebruikers hoeven enkel hun experimenten uit te voeren, resultaten op te slaan en te delen. Daarnaast kunnen gevorderde gebruikers rechtstreeks de CLI-shell van OpenShift aanspreken vanuit Jupyter notebooks om Kubernetes-primitieven zoals Job of de functionaliteit van OpenShift, bijvoorbeeld Tekton of Knative, te gebruiken. Hiervoor kan ook de gebruiksvriendelijke OpenShift GUI, de 'OpenShift webconsole', worden ingezet.
Bij de volgende fase stelt Open Data Hub in staat om dataconstructies (data pipelines) te beheren. Dit wordt bereikt door gebruik te maken van een Ceph-object, dat wordt aangeboden als een S3-compatibele objectopslag. Apache Spark zorgt voor datastromen vanuit externe bronnen of de ingebouwde opslag Ceph S3 en maakt ook gegevenstransformaties mogelijk. Apache Kafka biedt geavanceerd beheer van dataconstructies (waar meerdere uploads en transformatiemogelijkheden, analyses en gegevensopslag kunnen plaatsvinden).
Dus, de data-analist heeft toegang tot de gegevens gekregen en een model opgebouwd. Nu wil hij de bereikte resultaten delen met collega's of applicatieontwikkelaars, waarbij hij zijn model als een dienst aanbiedt. Hiervoor is er een outputserver nodig, en Open Data Hub heeft zo'n server, genaamd Seldon, dat het mogelijk maakt om het model als een RESTful-service te publiceren.
Op een gegeven moment zijn er meerdere van zulke modellen op de Seldon-server, en ontstaat de behoefte om te monitoren hoe ze worden gebruikt. Hiervoor biedt Open Data Hub een verzameling relevante metrics en een rapportagemotor op basis van de gangbare open-source monitoringtools Prometheus en Grafana. Zo krijgen we feedback voor het monitoren van het gebruik van AI-modellen, met name in een productieomgeving.
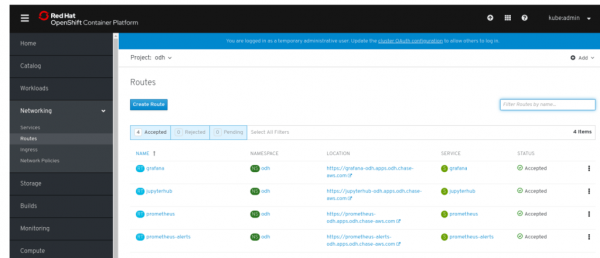
Hierdoor biedt Open Data Hub een cloud-achtige benadering gedurende de gehele cyclus van AI/ML-operaties, van toegang en gegevensvoorbereiding tot het trainen en industrieel inzetten van modellen.
Alles samenbrengen
Nu rijst de vraag hoe dit allemaal georganiseerd moet worden door de OpenShift-beheerder. Hier komt een speciale Kubernetes-operator voor Open Data Hub-projecten in beeld.
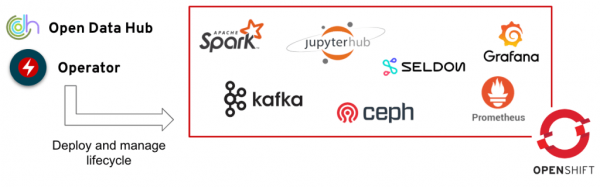
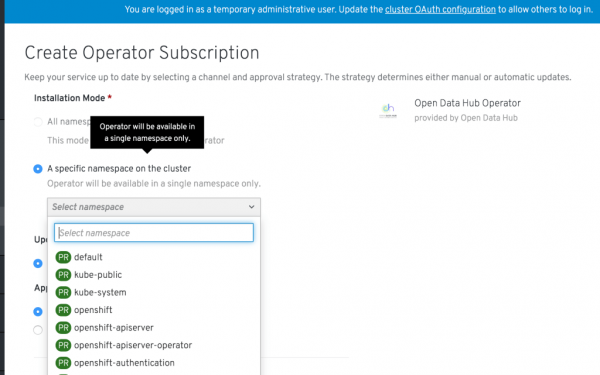
Deze operator beheert de installatie, configuratie en levenscyclus van het Open Data Hub-project, inclusief de implementatie van bovengenoemde tools zoals JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus en Grafana. Het Open Data Hub-project kan worden gevonden in de webconsole van OpenShift, onder de community-operatoren. Zo kan de OpenShift-beheerder aangeven dat de relevante OpenShift-projecten tot de categorie 'Open Data Hub-project' behoren. Dit gebeurt één keer. Daarna kan de data-analist via de webconsole van OpenShift in zijn projectruimte gaan en zien dat de relevante Kubernetes-operator is geïnstalleerd en beschikbaar is voor zijn projecten. Dan maakt hij met één muisklik een instantie van het Open Data Hub-project aan en heeft onmiddellijk toegang tot de bovengenoemde tools. En dit kan allemaal worden ingesteld in een hoge beschikbaarheid en fouttolerantie.
Als je zelf een kijkje wilt nemen bij het Open Data Hub-project, begin dan met . Technische details over de architectuur van Open Data Hub zijn te vinden , de ontwikkelingsplannen van het project – . In de toekomst is het de bedoeling om verdere integratie met Kubeflow te realiseren, een aantal regelgevings- en veiligheidskwesties op te lossen, evenals integratie met systemen op basis van regels zoals Drools en Optaplanner te organiseren. Je kunt je mening geven en deelnemen aan het project op de pagina .
Samenvattend: serieuze schaalproblemen beletten organisaties om het potentieel van kunstmatige intelligentie en machine learning volledig te benutten. Red Hat OpenShift wordt al lange tijd met succes toegepast om soortgelijke problemen in de software-industrie op te lossen. Het Open Data Hub-project, dat is gerealiseerd binnen de open source ontwikkelgemeenschap, biedt een referentie-architectuur voor het organiseren van de volledige cyclus van AI/ML-operaties op basis van het hybride cloudplatform OpenShift. We hebben een duidelijk en doordacht ontwikkelingsplan voor dit project, en we zijn vastbesloten om er een actieve en vruchtbare open AI-oplossingen ontwikkelgemeenschap rondom te creëren op het OpenShift-platform.
Bron: habr.com
