

De cloud lijkt op een magische doos — je vraagt wat je nodig hebt en de bronnen verschijnen zomaar uit het niets. Virtuele machines, databases, netwerken — dit alles behoort uitsluitend jou toe. Er zijn ook andere tenants in de cloud, maar in jouw universum ben jij de enige heerser. Je bent ervan verzekerd dat je altijd de benodigde bronnen krijgt, houdt rekening met niemand en bepaalt zelf hoe het netwerk eruitziet. Hoe werkt deze magie die de cloud in staat stelt om flexibel bronnen toe te wijzen en tenants volledig van elkaar te isoleren?
De AWS-cloud is een megacomplex systeem dat zich evolutionair ontwikkelt sinds 2006. Een deel van deze ontwikkeling heeft Vasily Pantyukhin — architect van Amazon Web Services. Als architect ziet hij niet alleen het eindresultaat, maar ook de complexiteiten die AWS overwint. Hoe beter je de werking van het systeem begrijpt, hoe meer vertrouwen je hebt. Daarom zal Vasily de geheimen van AWS-cloudservices delen. Onder de knop bespreekt hij de inrichting van fysieke AWS-servers, elastische schaalbaarheid van databases, de op maat gemaakte Amazon-database en methoden om de prestaties van virtuele machines te verhogen terwijl de kosten tegelijkertijd worden verlaagd. Kennis van de architecturale benaderingen van Amazon zal je helpen de AWS-services effectiever te gebruiken en mogelijk nieuwe ideeën geven voor het bouwen van je eigen oplossingen.
Over de spreker: Vasily Pantyukhin () begon als Unix-beheerder in .ru-bedrijven, werkzaam met grote machines van Sun Microsystem gedurende 6 jaar, en heeft 11 jaar de datacenterheid van de wereld gepredikt bij EMC. Hij evolueerde natuurlijk naar private clouds en stapte in 2017 over naar publieke clouds. Nu helpt hij met technische adviezen om te leven en te groeien in de AWS-cloud.
Disclaimer: alles hieronder is de persoonlijke mening van Vasily en deze kan afwijken van de positie van Amazon Web Services. van de presentatie waarop dit artikel is gebaseerd, is beschikbaar op ons YouTube-kanaal.
Waarom ik vertel over het functioneren van Amazon
Mijn eerste auto had een ‘handvat’ — met een handgeschakelde versnellingsbak. Dat was geweldig omdat het gevoel gaf dat ik de auto kon besturen en volledige controle had. Ook vond ik het leuk dat ik tenminste een globaal begrip had van hoe het werkte. Natuurlijk stelde ik me de werking van de versnellingsbak vrij primitief voor - ongeveer zoals de versnellingsbak van een fiets.
Alles was geweldig was, behalve één ding - vastzitten in het verkeer. Je zit daar en doet feitelijk niets, maar je schakelt constant, drukt op de koppeling, gas, rem - dat maakt je echt moe. Het probleem van verkeersopstoppingen werd gedeeltelijk opgelost toen we een automatische auto in de familie kregen. Achter het stuur heb je tijd om over dingen na te denken en naar audioboeken te luisteren.
Er kwam ook een raadsel in mijn leven, omdat ik helemaal niet meer begreep hoe mijn auto werkt. Een moderne auto is een complex apparaat. De auto past zich tegelijkertijd aan tientallen verschillende parameters aan: het indrukken van het gas, de rem, de rijstijl, de wegkwaliteit. Ik begrijp al niet meer hoe dit werkt.
Toen ik begon met Amazon Cloud, was dat voor mij ook een mysterie. Maar dit mysterie is van een heel andere orde, omdat er in de auto één bestuurder is en in AWS zijn het er miljoenen. Alle gebruikers sturen tegelijkertijd, drukken op het gas en de rem. Het is verbazingwekkend dat ze gaan waar ze willen - voor mij is dat een wonder! Het systeem past zich automatisch aan, schaalt op en elastisch aan elke gebruiker aan, zodat het lijkt alsof diegene alleen is in dit universum.
De magie vervaagde een beetje toen ik later architect bij Amazon werd. Ik zag met welke problemen we te maken hebben, hoe we deze oplossen, hoe we de diensten ontwikkelen. Met de groei van mijn begrip van de werking van het systeem groeit ook het vertrouwen in de dienst. Daarom wil ik het beeld delen van wat er onder de motorkap van AWS Cloud gebeurt.
Waar gaan we het over hebben
Ik heb een gediversifieerde aanpak gekozen - ik heb vier interessante diensten geselecteerd waarover het de moeite waard is om te praten.
Serveroptimalisatie. Vergankelijk cloud met fysieke belichaming: fysieke datacentra waar fysieke servers staan die zoemen, warm worden en knipperende lampjes hebben.
Serverless-functies (Lambda) - waarschijnlijk de meest schaalbare dienst in de cloud.
Schaalvergroting van databases. Ik zal vertellen hoe we onze eigen schaalbare databases bouwen.
Schaalvergroting van netwerken. Het laatste deel waarin ik de werking van ons netwerk zal onthullen. Het is een wonderlijke zaak - elke gebruiker van de cloud denkt dat hij alleen in de cloud is en andere huurders helemaal niet ziet.
Opmerking. In dit artikel zullen we het hebben over serveroptimalisatie en database-scaling. Netwerk-scaling wordt in het volgende artikel besproken. Waar zijn de serverless functies? Daarover is een afzonderlijke verklaring verschenen.. Hierin worden verschillende manieren van schaalvergroting besproken, en de oplossing Firecracker wordt grondig behandeld — een symbiose van de beste eigenschappen van virtuele machines en containers.
Servers
De cloud is vluchtig. Maar deze vluchtigheid heeft nog steeds een fysieke belichaming — servers. Oorspronkelijk was hun architectuur klassiek. Standaard x86-chipset, netwerkkaarten, Linux, hypervisor Xen, waarop virtuele machines werden uitgevoerd.
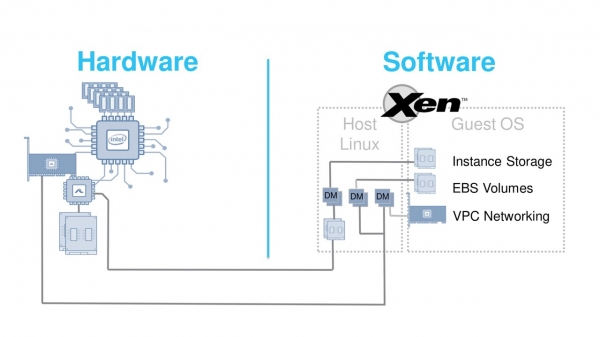
In 2012 voldeed deze architectuur prima aan zijn taken. Xen is een uitstekende hypervisor, maar heeft één ernstig nadeel. Het heeft behoorlijk hoge overheadkosten voor apparaatsimulatie.Bij de komst van nieuwe, snellere netwerkkaarten of SSD's worden deze overheadkosten te hoog. Hoe met dit probleem om te gaan? We besloten om op twee fronten tegelijk te werken — zowel de hardware als de hypervisor te optimaliseren.De taak is zeer serieus.
Optimalisatie van hardware en hypervisor
Alles in één keer goed doen zal niet mogelijk zijn. Wat 'goed' is, was aanvankelijk ook onduidelijk.
We besloten een evolutionaire benadering te hanteren — we veranderen één belangrijk element van de architectuur en brengen het in productie.
We lopen tegen alle problemen aan, luisteren naar klachten en voorstellen. Daarna veranderen we het andere component. Zo, in kleine stappen, veranderen we de gehele architectuur op basis van feedback van gebruikers en ondersteuning.
De transformaties begonnen in 2013 met het meest gecompliceerde — het netwerk. In C3 instellingen werd aan de standaard netwerkkaart een speciale Network Accelerator-kaart toegevoegd. Deze werd letterlijk aangesloten met een korte loopback-kabel aan de voorzijde. Niet mooi, maar in de cloud zie je het niet. Toch verbeterde de directe interactie met de hardware de jitter en netwerksnelheid aanzienlijk.
Daarna besloten we de toegang tot de Elastic Block Storage (EBS) te verbeteren — een combinatie van netwerk en opslag. De moeilijkheid was dat, hoewel er Network Accelerator-kaarten op de markt waren, het niet mogelijk was om gewoon een Storage Accelerator-hardware te kopen. Daarom hebben we contact opgenomen met de startup Annapurna Labs, die speciaal ontwikkelde ASIC-chips voor ons. Hiermee kunnen externe EBS-volumes als NVMe-apparaten worden aangesloten.
In instanties C4 hebben we twee problemen opgelost. De eerste was het creëren van een toekomstbestendig fundament voor een in dat moment veelbelovende, maar nieuwe technologie: NVMe. De tweede was het aanzienlijk ontlasten van de centrale processor door de verwerking van verzoeken naar EBS naar een nieuwe kaart te verplaatsen. Het is goed gelukt, en daarom is Annapurna Labs nu onderdeel van Amazon.
In november 2017 realiseerden we ons dat het tijd was om ook de hypervisor te vernieuwen.
De nieuwe hypervisor is ontwikkeld op basis van aangepaste KVM-kernelmodules.
Deze heeft de overhead voor de emulatie van apparaten aanzienlijk verminderd en maakt directe samenwerking met de nieuwe ASIC mogelijk. Instanties C5 waren de eerste virtuele machines die draaien op de nieuwe hypervisor. We hebben het genoemd Nitro.
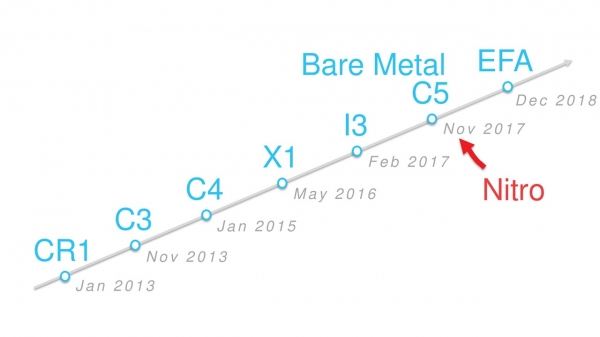 De evolutie van instanties op de tijdlijn.
Alle nieuwe typen virtuele machines die sinds november 2017 zijn verschenen, draaien op deze hypervisor. Bare Metal-instanties hebben geen hypervisor, maar ze worden ook Nitro genoemd, omdat ze gespecialiseerde Nitro-kaarten gebruiken.
In de volgende twee jaar nam het aantal Nitro-instanties toe tot meer dan een paar dozijn: A1, C5, M5, T3 en anderen.
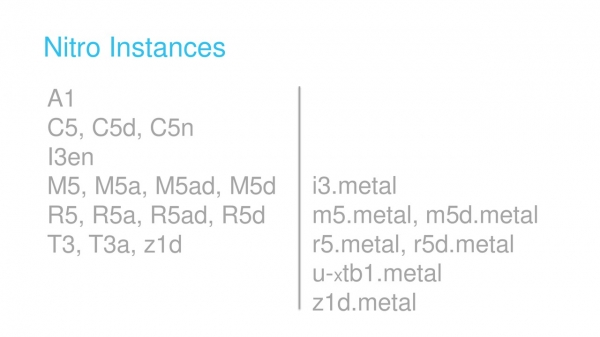
Typen instanties.
Hoe moderne Nitro-machines zijn opgebouwd
Ze hebben drie hoofdbestanddelen: de Nitro-hypervisor (daarboven genoemd), een beveiligingschip en Nitro-kaarten.
De beveiligingschip is rechtstreeks op het moederbord geïntegreerd. Hij controleert tal van belangrijke functies, zoals het controleren van de opstart van het host-besturingssysteem.
Nitro-kaarten zijn er in vier types. Al deze zijn ontwikkeld door Annapurna Labs en zijn gebaseerd op gemeenschappelijke ASIC's. Een deel van hun firmware is ook gemeenschappelijk.
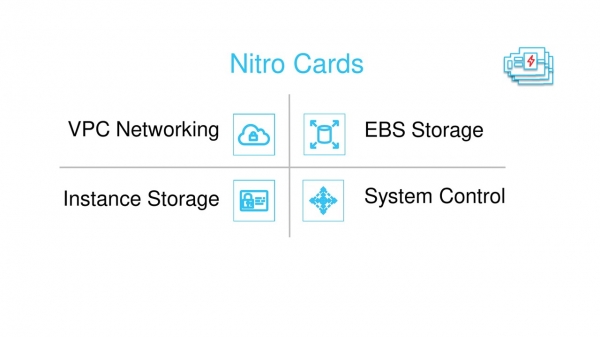
Vier types Nitro-kaarten.
Een van de kaarten is bedoeld voor gebruik met het netwerkVPC. Dit is zichtbaar in virtuele machines als een netwerkadapter ENA — Elastic Network Adaptor. Hiermee wordt ook het verkeer ingekapseld bij overdracht via het fysieke netwerk (hierover zullen we in het tweede deel van het artikel spreken), en het beheert de firewall Security Groups, verantwoordelijk voor routering en andere netwerkzaken.
Verschillende kaarten werken met block storage EBS en schijven die in de server zijn ingebouwd. Voor de gast-VM worden ze gepresenteerd als NVMe-adapters. Ze zijn ook verantwoordelijk voor de versleuteling van gegevens en schijfmonitoring.
Het Nitro-kaartsysteem, de hypervisor en de beveiligingschip zijn verenigd in een SDN-netwerk of Software Defined Network. Het beheer van dit netwerk (Control Plane) is verantwoordelijk voor kaartcontroller.
Zeker, we blijven werken aan de ontwikkeling van nieuwe ASIC's. Zo hebben we eind 2018 de Inferentia-chip gelanceerd, die efficiënter omgaat met machine learning-taken.
Inferentia Chip Machine Learning Processor.
Schaalbare database
Een traditionele database heeft een gelaagde structuur. Als we het sterk vereenvoudigen, kunnen we de volgende lagen onderscheiden.
- SQL — hierop draaien de klant- en verzoekbeheerders.
- Verzekeringen transacties — hier is alles duidelijk, ACID en zo verder.
- Caching, dat wordt verzorgd door bufferpools.
- Logging — zorgt voor de omgang met redo-logs. In MySQL worden ze Bin Logs genoemd, in PostgreSQL Write Ahead Logs (WAL).
- Opslag – direct naar schijf schrijven.
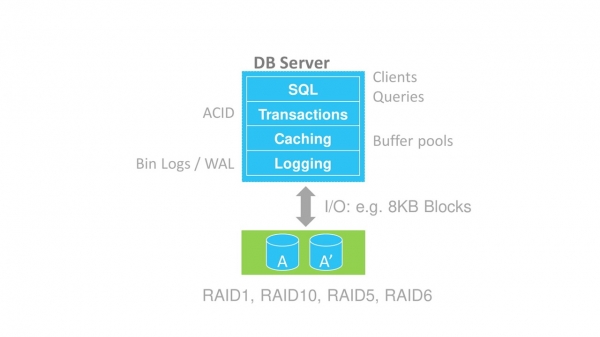
Gelaagde database-structuur.
Er zijn verschillende manieren om databases te schalen: sharding, Shared Nothing-architectuur, gedeelde schijven.
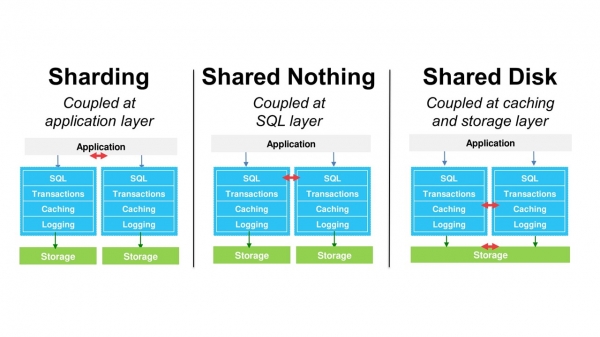
Echter, al deze methoden behouden dezelfde monolithische database-structuur. Dit beperkt de schaalbaarheid aanzienlijk. Om dit probleem op te lossen, hebben we onze eigen database ontwikkeld— Amazon Aurora. Deze is compatibel met MySQL en PostgreSQL.
Amazon Aurora
Het belangrijkste architecturale idee is om de opslag- en logniveau's los te koppelen van de hoofd-database.
Vooruitlopend kan ik zeggen dat we ook het cache-niveau onafhankelijk hebben gemaakt. De architectuur stopt met een monolith te zijn, en we verkrijgen extra vrijheden in het schalen van afzonderlijke blokken.
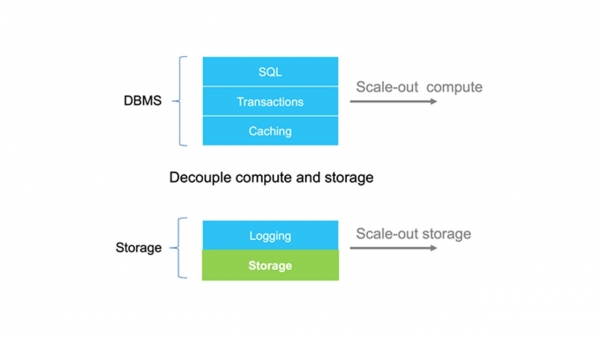
De log- en opslagniveaus zijn gescheiden van de database.
Een traditionele RDBMS schrijft gegevens naar het opslagsysteem in de vorm van blokken. In Amazon Aurora hebben we een "slimme" opslag gemaakt die kan communiceren in de taal van redo-logs. Intern verandert de opslag logs in datablocks, controleert de integriteit en maakt automatisch een back-up.
Deze aanpak maakt het mogelijk om interessante dingen te realiseren zoals clonen. Dit werkt principieel sneller en goedkoper omdat het geen volledige kopie van alle gegevens vereist.
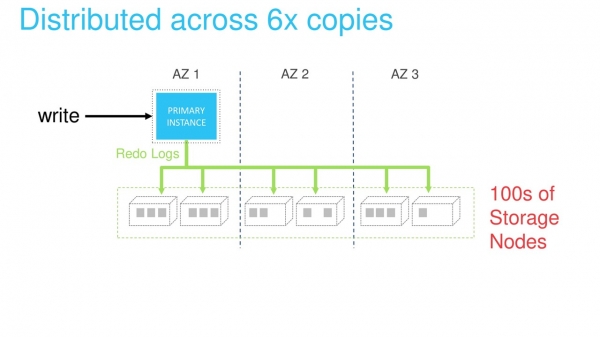
Het opslagniveau is geïmplementeerd als een gedistribueerd systeem. Het bestaat uit een zeer groot aantal fysieke servers. Iedere redo-log wordt gelijktijdig verwerkt en opgeslagen door zes knooppunten. Dit zorgt voor gegevensbescherming en load balancing.
Le leesschaalbaarheid kan worden gegarandeerd door de juiste replicaties. Een gedistribueerde opslag elimineert de noodzaak voor synchronisatie tussen de primaire database-instantie, waar we gegevens schrijf, en de andere replicaties. Actuele gegevens zijn gegarandeerd beschikbaar voor alle replicaties.
Het enige probleem is de caching van oude gegevens op de leesschijven. Maar deze uitdaging kan worden opgelost door alle redo-logboeken naar de replicaties via het interne netwerk te sturen. Als de log in de cache staat, wordt deze gemarkeerd als ongeldig en overschreven. Als deze niet in de cache staat, wordt deze eenvoudigweg genegeerd.
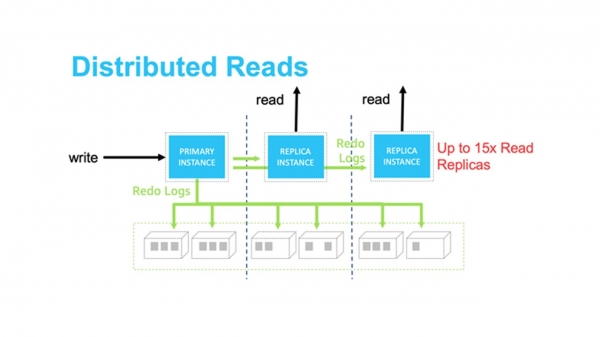
We hebben het opslagprobleem opgelost.
Hoe schaal je de niveaus van de DBMS
Hier is horizontale schaalbaarheid veel moeilijker te realiseren. Daarom volgen we een beproefd pad van klassieke verticale schaalbaarheid..
Laten we aannemen dat we een applicatie hebben die communiceert met de DBMS via een master-node.
Bij verticale schaalbaarheid hebben we een nieuwe node nodig met meer processoren en geheugen.
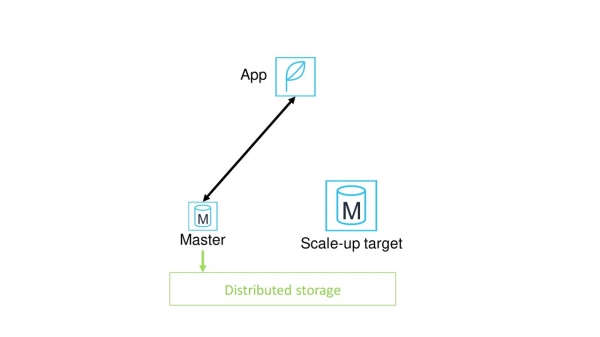
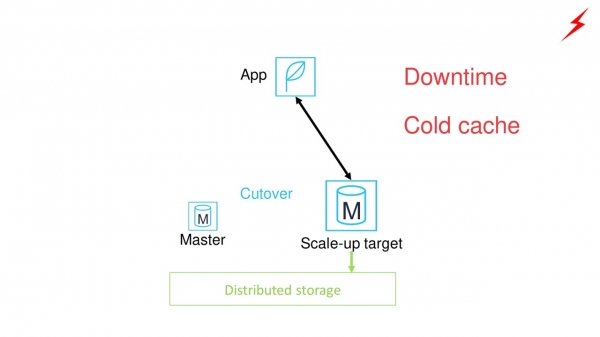
Daarna schakelen we de applicatie van de oude master-node naar de nieuwe. Dit leidt tot problemen.
- Dit vereist aanzienlijke downtime voor de applicatie.
- De nieuwe master-node heeft een koude cache. De databaseprestaties zijn pas optimaal nadat de cache is opgewarmd.
Hoe kunnen we de situatie verbeteren? Door een proxy tussen de applicatie en de master-node te plaatsen.
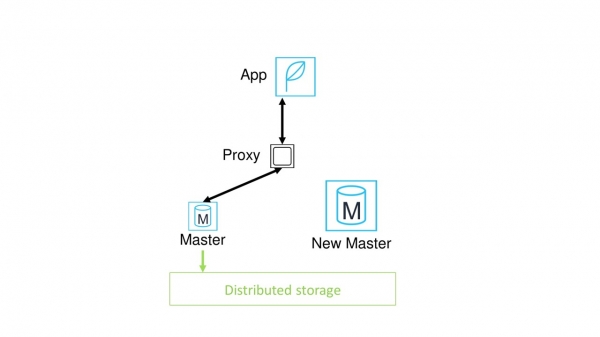
Wat levert dit ons op? Nu hoeven we alle applicaties niet handmatig naar de nieuwe node om te leiden. De overschakeling kan onder de proxy worden gedaan en is daardoor wezenlijk sneller.
Het lijkt erop dat het probleem is opgelost. Maar nee, we blijven nog steeds lijden onder de noodzaak om de cache op te warmen. Bovendien is er een nieuw probleem opgekomen — nu is de proxy een potentiële foutbron.
De uiteindelijke oplossing met Amazon Aurora serverless
Hoe hebben we deze problemen opgelost?
We hebben de proxy behouden.Dit is geen aparte instantie, maar een volledige gedistribueerde vloot van proxy's waarvan de applicaties verbinding maken met de database. Elke node kan in geval van uitval vrijwel onmiddellijk worden vervangen.
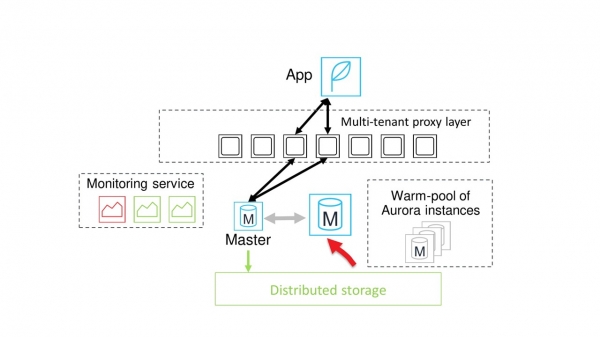
We hebben een pool van warme nodes van verschillende groottes toegevoegd.Daarom is een nieuwe node van grotere of kleinere grootte onmiddellijk beschikbaar indien nodig. We hoeven niet te wachten tot deze is opgestart.
Het gehele schaalbaarheidsproces wordt gecontroleerd door een speciaal monitoringssysteem. Monitoring houdt voortdurend de status van de huidige master-node in de gaten. Als het bijvoorbeeld ontdekt dat de CPU-belasting een kritieke waarde heeft bereikt, waarschuwt het de pool van warme instanties om een nieuwe node vrij te geven.
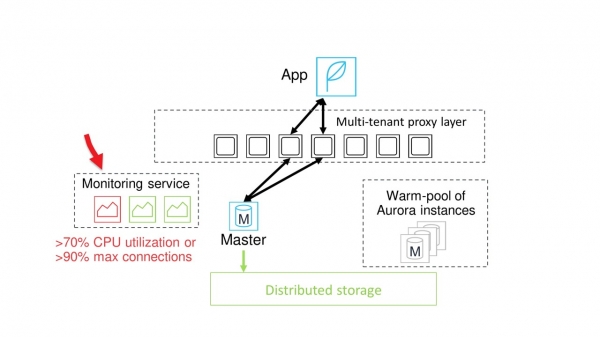
Gedetailleerde proxies, warme instanties en monitoring.
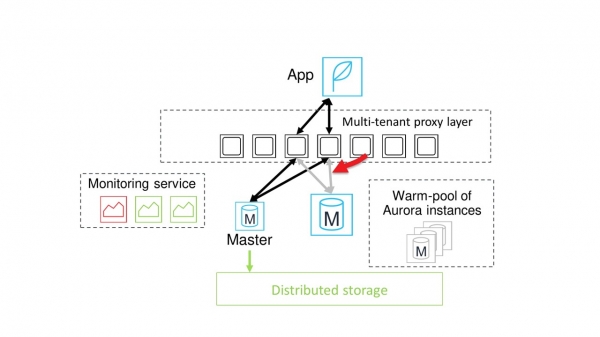
Een node met de vereiste capaciteit is beschikbaar. Buffers worden naar deze node gekopieerd en het systeem wacht op een veilig moment om over te schakelen.
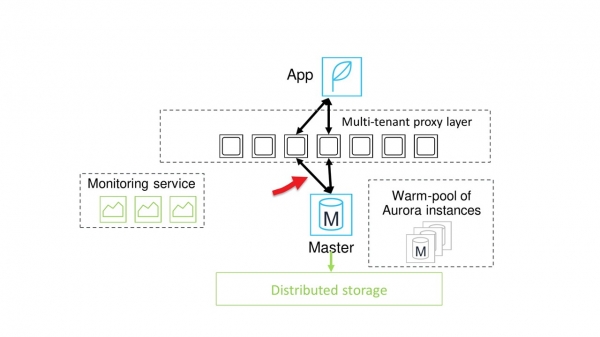
Gewoonlijk komt het moment voor de overschakeling snel. De communicatie tussen de proxy en de oude master-node wordt dan gepauzeerd, en alle sessies worden overgeschakeld naar de nieuwe node.
Het werk met de database wordt herstart.
Op de grafiek is te zien dat de pauze inderdaad erg kort is. De blauwe grafiek toont de belasting, terwijl de rode stappen de schaalmomenten aangeven. De kortdurende dalingen in de blauwe grafiek zijn precies die korte vertraging.
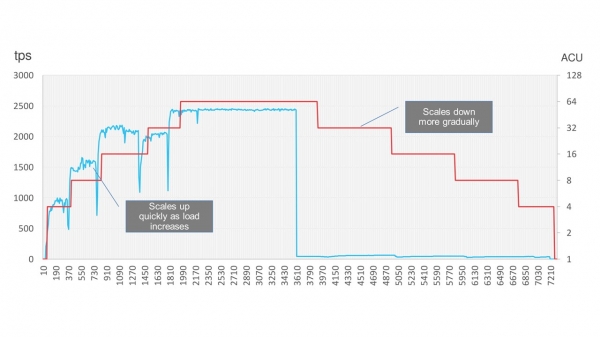
Overigens stelt Amazon Aurora je in staat om flink te besparen door de database uit te schakelen wanneer deze niet in gebruik is, bijvoorbeeld in het weekend. Na het stoppen verlaagt de database geleidelijk zijn capaciteit en schakelt deze enige tijd uit. Wanneer de belasting terugkomt, stijgt deze weer geleidelijk.
In het volgende deel van ons verhaal over de Amazon-architectuur zullen we spreken over netwerkschaalbaarheid. Abonneer je en blijf op de hoogte van updates zodat je het artikel niet mist.
Op Vasili Pantiukhin zal de presentatie geven "". Welke ontwerppatronen voor gedistribueerde systemen gebruiken Amazon-ontwikkelaars, wat zijn de oorzaken van service-uitval, wat is Cell-based architecture, Constant Work, Shuffle Sharding — het belooft interessant te worden. Minder dan een maand tot de conferentie — . Op 24 oktober verhogen we definitief de prijzen.
Bron: habr.com
