

Het netwerk van Amazon Web Services bestaat uit 69 zones verspreid over 22 regio's: Verenigde Staten, Europa, Azië, Afrika en Australië. In elke zone bevinden zich tot 8 datacenters. Elk datacenter bevat duizenden of honderdduizenden servers. Het netwerk is zo ontworpen dat alle onwaarschijnlijke scenario's van uitval worden overwogen. Bijvoorbeeld, alle regio's zijn van elkaar geïsoleerd, en de beschikbaarheidszones zijn enkele kilometers uit elkaar geplaatst. Zelfs als een kabel wordt doorgesneden, schakelt het systeem over naar reserveverbindingen, waardoor het verlies van informatie beperkt blijft tot enkele datapakketten. De principes waarop het netwerk is gebouwd en hoe het in elkaar zit, worden uitgelegd door Vasily Pantyukhin.
Vasily Pantyukhin begon als Unix-beheerder bij .ru-bedrijven, werkte 6 jaar met de grote hardware van Sun Microsystems en predikte 11 jaar lang data-centrism in de wereld bij EMC. Hij evolueerde op natuurlijke wijze naar private clouds en stapte vervolgens over naar publieke clouds. Nu, als architect bij Amazon Web Services, biedt hij technische adviezen om te leven en te groeien in de AWS-cloud.
In het vorige deel van de trilogie over de opbouw van AWS is Vasily dieper ingegaan op de opbouw van fysieke servers en de schaalvergroting van databases. Nitro-kaarten, een op KVM gebaseerde aangepaste hypervisor, de Amazon Aurora-database — hierover gaat het in het artikel ‘‘. Lees verder voor meer context, of bekijk de van de presentatie.
In dit deel gaat het over de schaalvergroting van het netwerk — een van de meest complexe systemen in AWS. De evolutie van een plat netwerk naar een Virtual Private Cloud en de opbouw ervan, de interne services Blackfoot en HyperPlane, het probleem van de 'geluidsrijke buur', en ten slotte de schaal van het netwerk, backbone en fysieke kabels. Dit alles komt aan bod.
Disclaimer: alles wat hieronder staat is de persoonlijke mening van Vasily en kan afwijken van de positie van Amazon Web Services.
Schaalvergroting van netwerken
AWS werd gelanceerd in 2006. Het netwerk was toen vrij primitief — met een platte structuur. Het bereik van privé-adressen was gemeenschappelijk voor alle tenants in de cloud. Bij het opstarten van een nieuwe virtuele machine kreeg je per ongeluk een beschikbare IP-adres uit dit bereik.
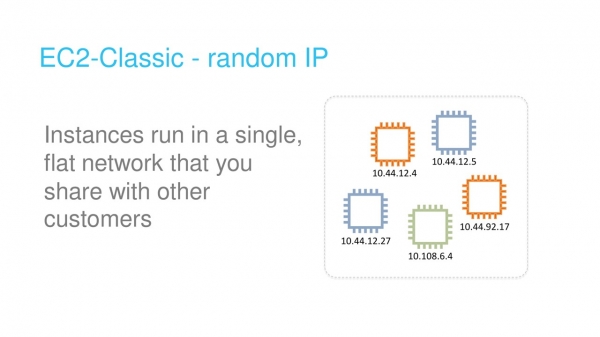
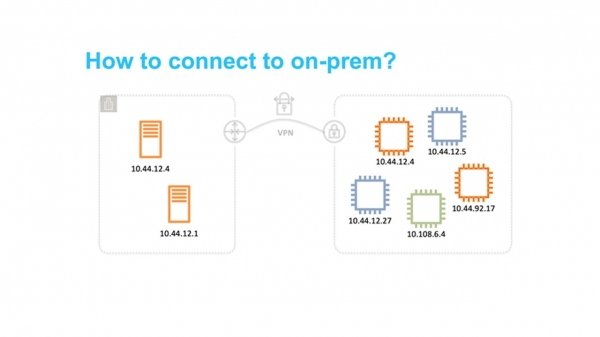
Deze aanpak was eenvoudig in uitvoering, maar beperkte het gebruik van de cloud fundamenteel. Het was bijvoorbeeld behoorlijk moeilijk om hybride oplossingen te ontwikkelen waarbij private netwerken op de grond en in AWS werden samengebracht. Het meest voorkomende probleem was de overlap van IP-adressen.
Virtual Private Cloud
De cloud is populair gebleken. Het is tijd om na te denken over de schaalbaarheid en de mogelijkheden voor gebruik door tientallen miljoenen tenants. Het platte netwerk is de grootste belemmering geworden. Daarom hebben we nagedacht over hoe we gebruikers op netwerkniveau van elkaar kunnen isoleren, zodat zij zelf IP-bereiken kunnen kiezen.
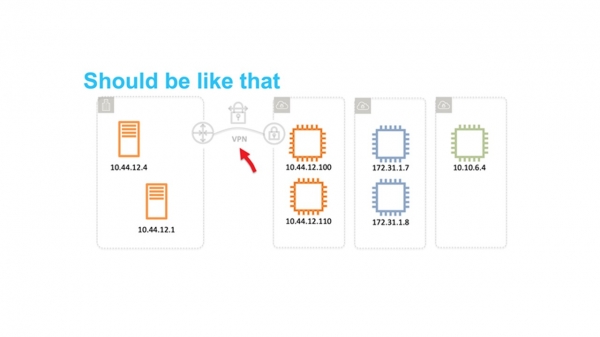
Wat komt als eerste in je op als je denkt aan netwer isolation? Natuurlijk VLAN en VRF - Virtual Routing and Forwarding.
Helaas heeft dit niet gewerkt. VLAN-ID is slechts 12 bits, wat ons slechts 4096 geïsoleerde segmenten biedt. Zelfs in de grootste switches kunnen maximaal 1-2 duizend VRF's worden gebruikt. Het combineren van VRF en VLAN levert ons slechts enkele miljoenen subnetten op. Dit is absoluut niet genoeg voor tientallen miljoenen tenants, die elk de mogelijkheid moeten hebben om meerdere subnetten te gebruiken.
Daarnaast kunnen we ons simpelweg niet veroorloven om het benodigde aantal grote dozen aan te schaffen, bijvoorbeeld van Cisco of Juniper. Er zijn twee redenen: het is extreem duur en we willen niet afhankelijk zijn van hun ontwikkelings- en patchbeleid.
Eén conclusie: we moeten onze eigen oplossing ontwikkelen.
In 2009 hebben we aangekondigd VPC — Virtual Private Cloud. De naam is populair geworden en nu gebruiken veel cloudproviders deze ook.
VPC is een virtueel netwerk SDN (Software Defined Network). We besloten om geen speciale protocollen op L2- en L3-niveau uit te vinden. Het netwerk werkt op standaard Ethernet en IP. Voor de overdracht over het netwerk wordt het verkeer van virtuele machines ingekapseld in een wrapper van ons eigen protocol. Hierin wordt het ID aangegeven dat behoort tot de VPC-tenant.
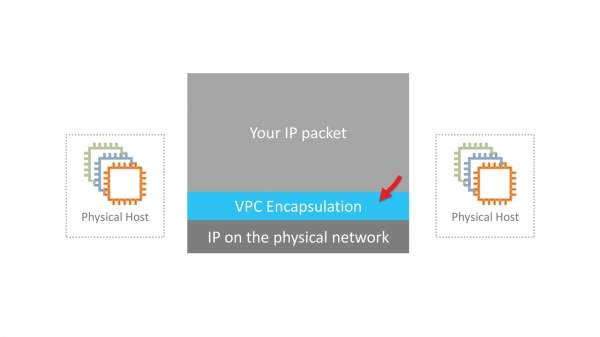
Dit klinkt eenvoudig. Echter, er moeten enkele serieuze technische uitdagingen worden opgelost. Bijvoorbeeld, waar en hoe de gegevens over de mapping van virtuele MAC/IP-adressen, VPC-ID en de bijbehorende fysieke MAC/IP's op te slaan. Op schaal van AWS is dit een enorme tabel die met minimale vertragingen moet functioneren bij toegang. Dit wordt beheerd door de mappingdienst, die dun verspreid is over het hele netwerk.
In nieuwe generatie machines wordt de encapsulatie uitgevoerd door Nitro-kaarten op hardware-niveau. In oudere instanties is de encapsulatie en decapsulatie programmatisch.
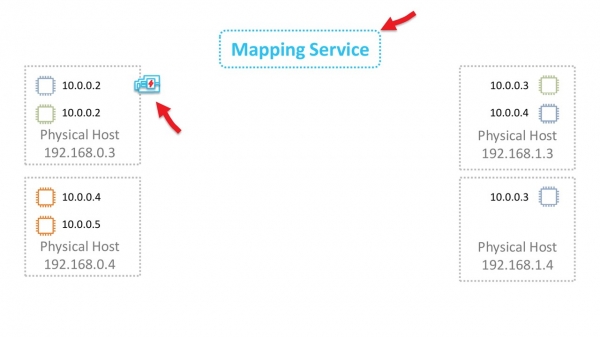
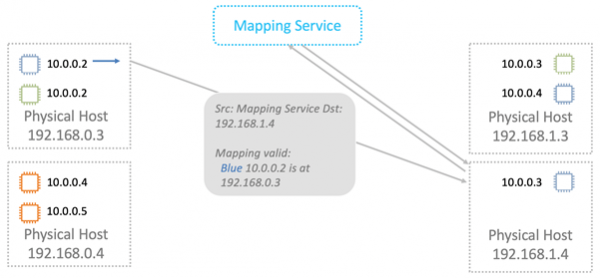
Laten we bekijken hoe het in grote lijnen werkt. We beginnen op niveau L2. Stel dat we een virtuele machine hebben met IP 10.0.0.2 op een fysieke server 192.168.0.3. Deze verzendt gegevens naar de virtuele machine 10.0.0.3, die zich bevindt op 192.168.1.4. Er wordt een ARP-verzoek gevormd dat op de netwerk Nitro-kaart terechtkomt. Voor de eenvoud gaan we ervan uit dat beide virtuele machines zich in dezelfde ‘blauwe’ VPC bevinden.
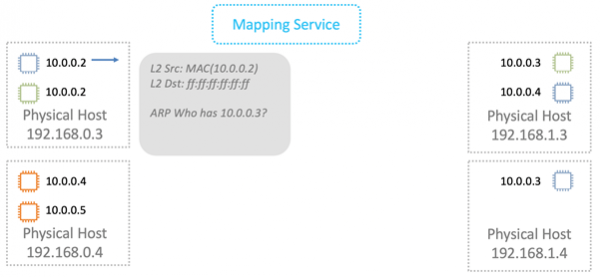
De kaart vervangt het bronadres door zijn eigen adres en stuurt het ARP-frame naar de mapperingsservice.
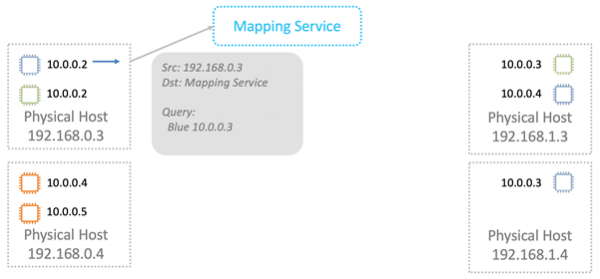
De mapperingsservice retourneert de informatie die nodig is voor verzending via het fysieke L2-netwerk.
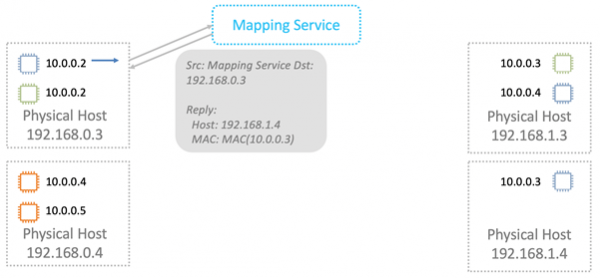
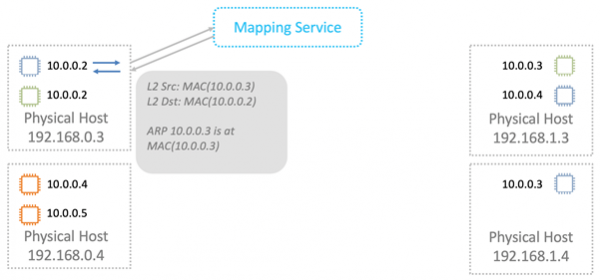
De Nitro-kaart vervangt in het ARP-antwoord het MAC-adres in het fysieke netwerk door het adres in de VPC.
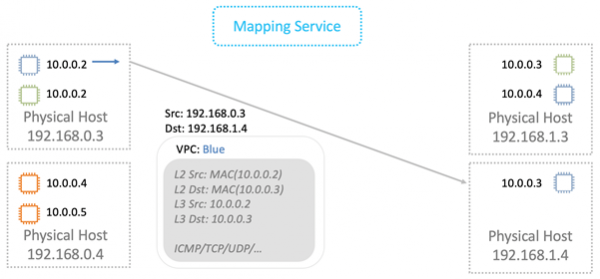
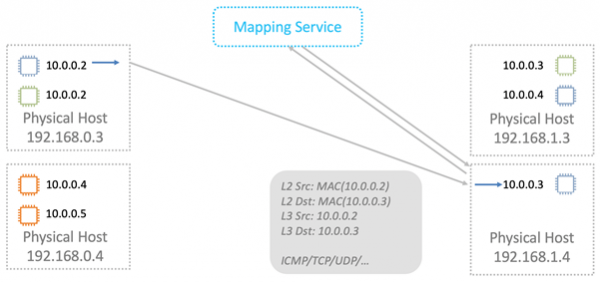
Bij het verzenden van gegevens wikkelen we de logische MAC en IP in een VPC-wrapping. We verzenden dit alles via het fysieke netwerk met behulp van de juiste IP Nitro-kaarten van de bron en de bestemming.
De fysieke machine waarvoor het pakket is bedoeld, voert een controle uit. Dit is nodig om de mogelijkheid van adresvervanging te voorkomen. De machine stuurt een speciaal verzoek naar de mapperingsservice en vraagt: 'Ik heb een pakket ontvangen op de fysieke machine 192.168.0.3, dat bedoeld is voor 10.0.0.3 in de 'blauwe' VPC. Is het legitiem?'
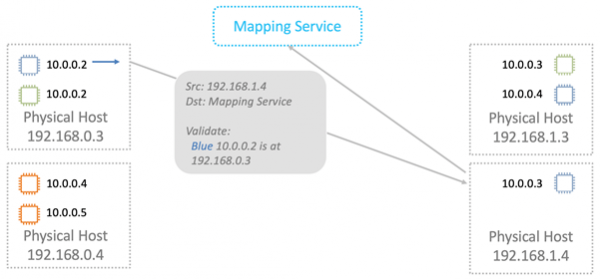
De mapperingsservice controleert zijn resource-locatie tabel en staat het pakket al dan niet toe. Bij alle nieuwe instanties is extra validatie ingebouwd in de Nitro-kaarten. Dit kan zelfs theoretisch niet worden omzeild. Daarom zal spoofing naar resources in een andere VPC niet werken.
Vervolgens worden de gegevens verzonden naar de virtuele machine waarvoor ze zijn bestemd.
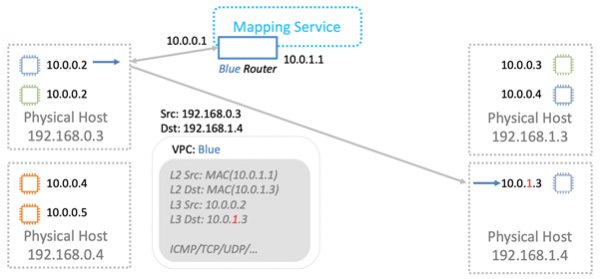
De mapperingsservice functioneert ook als een logische router voor het verzenden van gegevens tussen virtuele machines in verschillende subnetten. Conceptueel is het daar eenvoudig, ik ga het niet in detail behandelen.
Het blijkt dat bij de verzending van elk pakket de servers een beroep doen op de mapperingsservice. Hoe om te gaan met de onvermijdelijke vertragingen? Met caching, natuurlijk.
Het mooie is dat je niet de hele enorme tabel hoeft te cachen. Op de fysieke server bevinden zich virtuele machines uit een relatief klein aantal VPC's. Je hoeft alleen informatie over deze VPC's te cachen. De gegevensoverdracht naar andere VPC's is in de ‘standaard’ configuratie toch niet legitiem. Als er een functionaliteit zoals VPC-peering wordt gebruikt, wordt de informatie over de overeenkomstige VPC's aanvullend in de cache geladen.
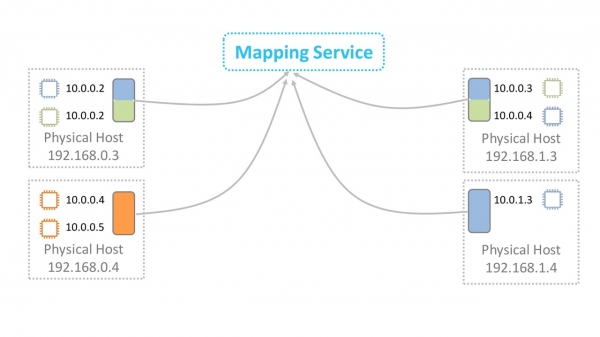
We hebben het nu begrepen met de gegevensoverdracht in VPC.
Blackfoot
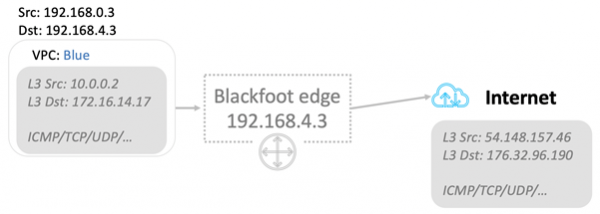
Hoe te handelen in gevallen waarin verkeer naar buiten moet worden verzonden, bijvoorbeeld naar het internet of via VPN naar het buitenland? Hier komt Blackfoot — de interne AWS-service ons van pas. Het is ontwikkeld door ons Zuid-Afrikaanse team. Daarom is de service vernoemd naar de pinguïn die in Zuid-Afrika leeft.
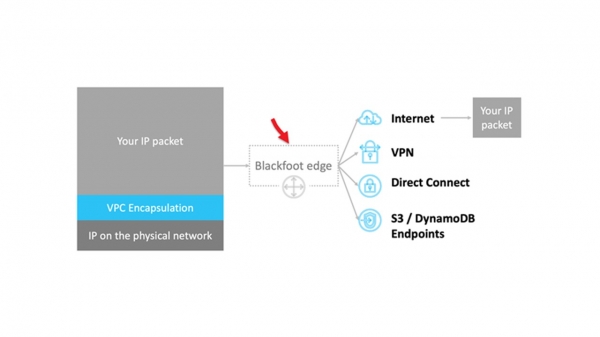
Blackfoot decapsuleert verkeer en doet wat nodig is. Gegevens worden op het internet verzonden zoals ze zijn.
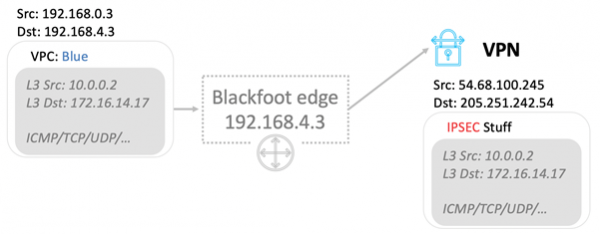
Gegevens worden gedecapsuleerd en opnieuw verpakt in een IPsec-wrapper bij gebruik van VPN.
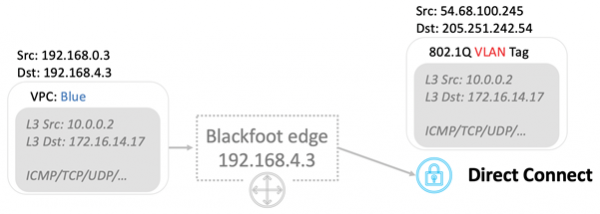
Bij gebruik van Direct Connect wordt het verkeer getagd en doorgegeven in de juiste VLAN.
HyperPlane
Dit is een interne stroomcontroledienst. Veel netwerkservices vereisen controle over de status van datastromen. Bijvoorbeeld, bij gebruik van NAT, moet stroomcontrole garanderen dat elke paar "IP: bestemmingspoort" overeenkomt met een unieke uitgaande poort. In het geval van de load balancer NLB — Network Load Balancer, moet het datastroom altijd naar dezelfde doel-virtuele machine worden geleid. Security Groups zijn een firewall met statusbehoud. Het houdt toezicht op inkomend verkeer en opent impliciet poorten voor uitgaand pakketverkeer.
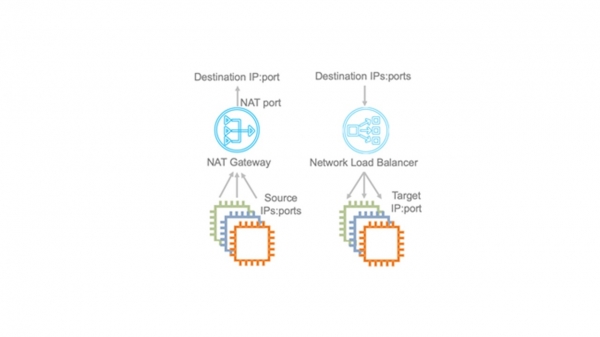
In de AWS-cloud zijn de vereisten voor doorvoertijden extreem hoog. Daarom HyperPlane is kritisch voor de functionaliteit van het hele netwerk.
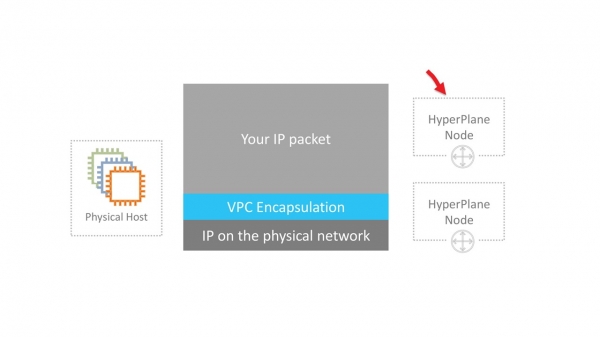
Hyperplane is gebouwd op EC2-virtuele machines. Hier is geen magie, alleen slimheid. De slimheid is dat dit virtuele machines zijn met veel RAM. Transactie-operaties worden uitsluitend in het geheugen uitgevoerd. Dit maakt latentie van slechts enkele microseconden mogelijk. Werken met schijf zou de hele prestatie vernietigen.
Hyperplane is een gedistribueerd systeem van een enorme hoeveelheid dergelijke EC2-machines. Elke virtuele machine heeft een bandbreedte van 5 GB/s. Op schaal van het gehele regionale netwerk levert dit waanzinnige terabits aan bandbreedte en stelt het in staat om miljoenen verbindingen per seconde.
HyperPlane werkt alleen met stromen. VPC-pakketencapsulatie is voor hem volkomen transparant. Een mogelijke kwetsbaarheid in deze interne service zal nog steeds de isolatie van VPC niet doorbreken. De onderliggende niveaus zijn verantwoordelijk voor de beveiliging.
Noisy neighbor
Er is nog een probleem van de "schreeuwende buur" — noisy neighbor. Stel dat we 8 nodes hebben. Deze nodes verwerken de stromen van alle cloudgebruikers. Alles lijkt goed te gaan en de belasting zou gelijkmatig over alle nodes verdeeld moeten zijn. De nodes zijn zeer krachtig en het is moeilijk om ze te overbelasten.
Maar we bouwen onze architectuur zelfs op basis van de meest onwaarschijnlijke scenario's.
Een lage waarschijnlijkheid betekent niet dat iets onmogelijk is.
We kunnen ons een situatie voorstellen waarin een of meerdere gebruikers een te grote belasting genereren. Bij het verwerken van deze belasting zijn alle HyperPlane nodes betrokken en andere gebruikers kunnen mogelijk enige afname in prestaties ervaren. Dit ondermijnt het concept van de cloud, waarin huurders geen invloed op elkaar kunnen uitoefenen.
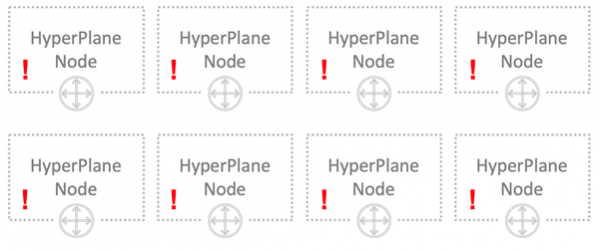
Hoe lossen we het probleem van de luidruchtige buur op? Het eerste wat in me opkomt - sharding. Onze 8 nodes worden logisch verdeeld in 4 shards met elk 2 nodes. Nu hinder de luidruchtige buur slechts een kwart van alle gebruikers, maar dat kan wel significant zijn.
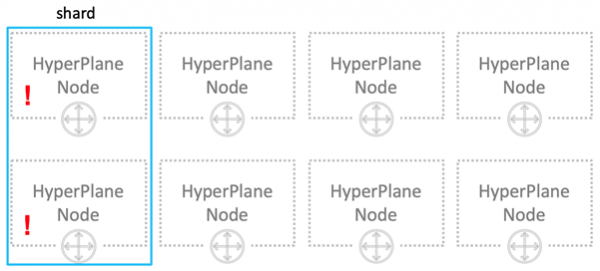
Laten we het anders aanpakken. We wijzen slechts 3 nodes per gebruiker toe.
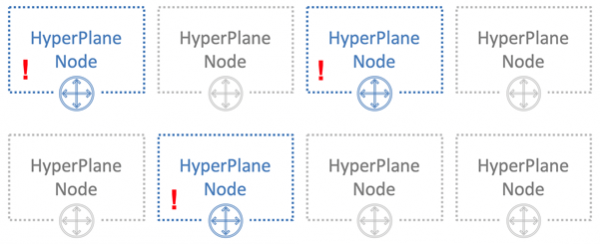
De truc is om nodes willekeurig aan verschillende gebruikers toe te wijzen. In de afbeelding hieronder overlapt de blauwe gebruiker met de nodes van een van de twee andere gebruikers - de groene en de oranje.
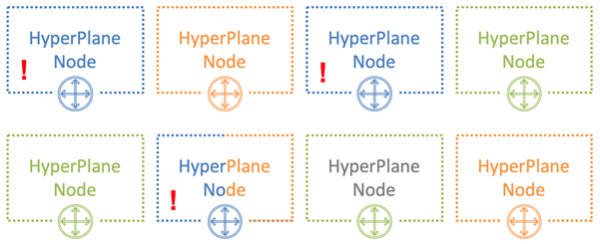
Met 8 nodes en 3 gebruikers bedraagt de kans op overlap tussen de luidruchtige buur en een van de gebruikers 54%. Met deze waarschijnlijkheid beïnvloedt de blauwe gebruiker andere huurders. Dit gebeurt echter slechts met een deel van zijn belasting. In ons voorbeeld zal deze invloed niet merkbaar zijn voor iedereen, maar slechts voor een derde van alle gebruikers. Dat is al een goed resultaat.
Aantal gebruikers die overlappen
Kans in procenten
0
18%
1
54%
2
26%
3
2%
Laten we de situatie realistischer maken - laten we 100 nodes en 5 gebruikers op 5 nodes nemen. In dit geval overlappen geen van de nodes met een kans van 77%.
Aantal gebruikers die overlappen
Kans in procenten
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
In de realiteit, met een enorme hoeveelheid HyperPlane nodes en gebruikers, is de potentiële invloed van de luidruchtige buur op andere gebruikers minimaal. Deze methode wordt genoemd shuffle sharding — . Het minimaliseert het negatieve effect van het uitvallen van nodes.Op basis van HyperPlane zijn tal van diensten gebouwd: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Schaal van het netwerk
Netwerk schaal
Laten we nu eens kijken naar de omvang van het netwerk zelf. In oktober 2019 biedt AWS zijn diensten aan in 22 regio's, met nog eens 9 gepland.
- Elke regio bevat meerdere beschikbaarheidszones - Availability Zone. In totaal zijn er wereldwijd 69.
- Elke AZ bestaat uit Datacenters. Er zijn er maximaal 8.
- In de datacenters bevinden zich enorme aantallen servers, in sommige tot 300.000.
Laten we dit alles gemiddeld nemen, vermenigvuldigen en een indrukwekkend cijfer verkrijgen dat weergeeft de schaal van de Amazon-cloud.
Tussen de beschikbaarheidszones en datacenters zijn talrijke optische verbindingen gelegd. In onze grootste regio zijn er alleen al 388 verbindingen voor communicatie tussen AZ's en verbindingscentra met andere regio's (Transit Centers). Dit resulteert in fenomenale 5000 Tbps.
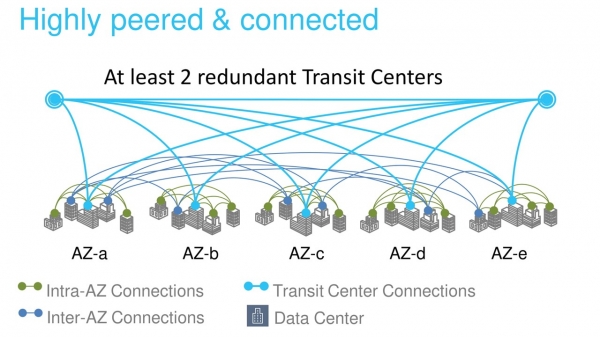
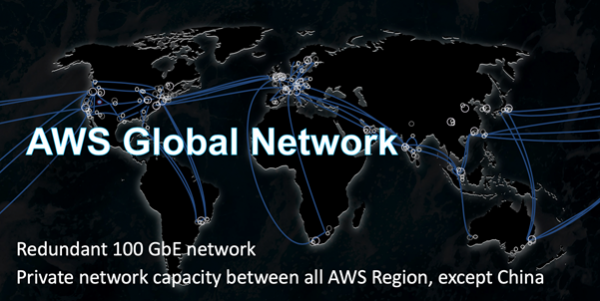
De AWS-backbone is speciaal gebouwd voor de cloud en geoptimaliseerd om met deze te werken. Wij bouwen het op verbindingen van 100 Gb/s. We hebben er volledige controle over, met uitzondering van de regio's in China. Het verkeer wordt niet gedeeld met lasten van andere bedrijven.
Natuurlijk zijn wij niet de enige cloudprovider met een particuliere backbone-netwerk. Steeds meer grote bedrijven volgen dit pad. Dit wordt bevestigd door onafhankelijke onderzoekers, bijvoorbeeld van .
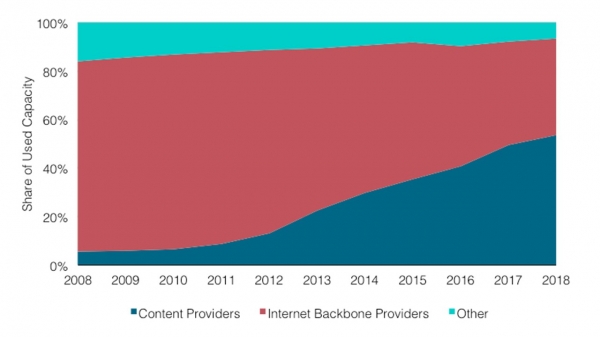
Op de grafiek is te zien dat het aandeel van contentproviders en cloudproviders toeneemt. Hierdoor daalt het aandeel van het Internet-verkeer van backbone-providers voortdurend.
Ik zal uitleggen waarom dit gebeurt. Vroeger waren de meeste webservices rechtstreeks toegankelijk en werden ze geconsumeerd vanuit het Internet. Tegenwoordig bevinden steeds meer servers zich in de cloud en zijn ze toegankelijk via CDN — Content Delivery Network. Voor toegang tot een bron gaat de gebruiker via het Internet alleen tot het dichtstbijzijnde CDN PoP - Point of Presence. Meestal is dit ergens in de buurt. Daarna verlaat hij het openbare Internet en reist over de privé-backbone, bijvoorbeeld over de Atlantische Oceaan, en komt rechtstreeks op de bron.
Het is interessant om te zien hoe het Internet er over 10 jaar uitziet als deze trend aanhoudt.
Fysieke kanalen
Wetenschappers hebben nog niet ontdekt hoe ze de snelheid van het licht in het universum kunnen verhogen, maar ze hebben flinke stappen gezet in de methoden van transmissie via glasvezel. Momenteel gebruiken we kabels met 6912 vezels. Dit helpt de kosten voor de aanleg aanzienlijk te optimaliseren.
In sommige regio's zijn we genoodzaakt speciale kabels te gebruiken. Bijvoorbeeld, in de regio Sydney gebruiken we kabels met een speciale coating tegen termieten.
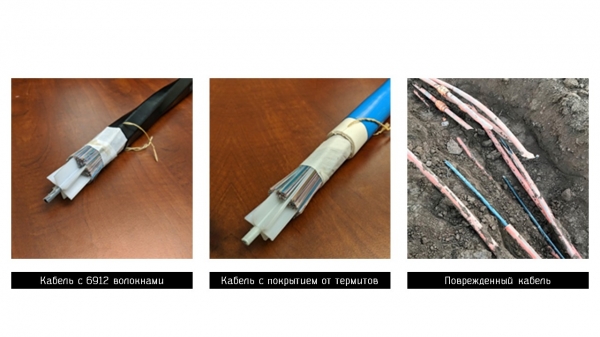
Niemand is verzekerd tegen problemen en soms worden onze kanalen beschadigd. Op de foto rechts zie je glasvezelkabels in een van de Amerikaanse regio's, die door bouwers zijn doorgesneden. Als gevolg van het ongeval zijn er slechts 13 datapakketten verloren gegaan, wat verbazingwekkend is. Nogmaals – slechts 13! Het systeem schakelde letterlijk onmiddellijk over op de reservekanalen — de schaal werkt.
We hebben snel enkele diensten en technologieën van Amazon Cloud doorgenomen. Ik hoop dat je nu minstens een idee hebt van de schaal van de taken waarmee onze ingenieurs worden geconfronteerd. Persoonlijk vind ik het heel boeiend.
Dit is het laatste deel van de trilogie van Vasili Pantjoekhin over de werking van AWS. In deel worden serveroptimalisatie en database-schaalvergroting beschreven, en in het tweede — serverless functies en Firecracker.
Op In november zal Vasili Pantjoekhin nieuwe details komen delen over de werking van Amazon. Hij over de oorzaken van storingen en het ontwerp van gedistribueerde systemen binnen Amazon. Op 24 oktober kun je nog tegen een goede prijs, en later betalen. We verwachten je op HighLoad++, kom langs — dan kunnen we praten!
Bron: habr.com
