

Hallo, Habr!
Na de nieuwjaarsfeesten hebben we de catastroferesistente cloud opnieuw opgestart op basis van twee locaties. Vandaag vertellen we hoe dit is opgezet en laten we zien wat er gebeurt met klantvirtual machines bij het falen van afzonderlijke cluster componenten en het neerstorten van een volledige locatie (spoiler – alles blijft goed gaan).
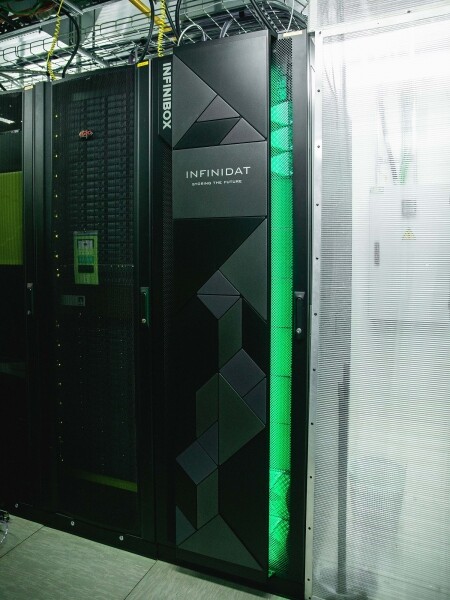
SAN van de catastroferesistente cloud op locatie OST.
Wat zit er binnenin?
Onder de motorkap van het cluster bevinden zich Cisco UCS-servers met de hypervisor VMware ESXi, twee INFINIDAT InfiniBox F2240 SAN’s, netwerktechnologie van Cisco Nexus, evenals Brocade SAN-switches. Het cluster is verspreid over twee locaties – OST en NORD, dat wil zeggen dat elke datacenter een identieke set hardware heeft. Dit maakt het dus catastroferesistent.
Binnen één locatie zijn de belangrijkste elementen ook gedupliceerd (hosts, SAN-switches, netwerkinfrastructuur).
De twee locaties zijn met elkaar verbonden via aparte glasvezelverbindingen, die ook gereserveerd zijn.
Een paar woorden over het SAN. De eerste versie van de catastroferesistente cloud hebben we gebouwd op NetApp. Hier hebben we gekozen voor INFINIDAT, en dit is de reden waarom:
- De Active-Active replicatie optie. Dit stelt de virtuele machine in staat om operationeel te blijven, zelfs bij een volledige uitval van een van de SAN’s. Ik zal verderop meer vertellen over de replicatie.
- Drie schijfcontrollers voor een hogere systeemuitvalbestendigheid. Gewoonlijk zijn het er twee.
- Klaar om te gebruiken oplossing. We kregen een reeds gemonteerde rack, die we alleen nog maar hoefden aan te sluiten op het netwerk en in te stellen.
- Aandachtige technische ondersteuning. Ingenieurs van INFINIDAT analyseren voortdurend de logs en gebeurtenissen van de SAN, installeren nieuwe versies van de firmware en helpen bij de configuratie.
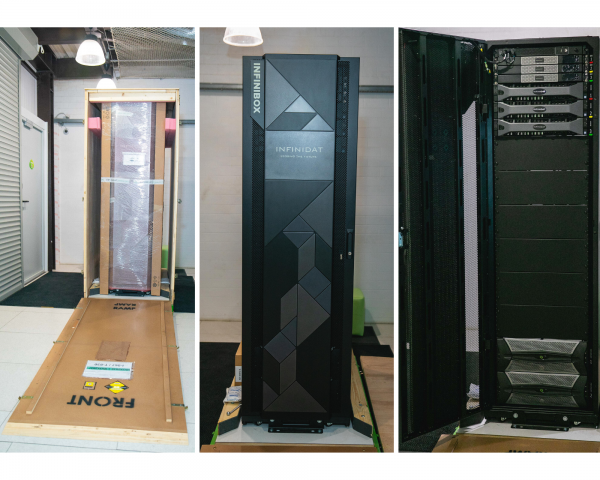
Hier zijn wat foto’s van de unpacking:
Hoe het werkt
De cloud is al binnenin uitvalbestendig. Het beschermt de klant tegen enkele hardware- en software-uitvallen. Catastroferesistent zal helpen om te beschermen tegen massale storingen binnen één locatie: bijvoorbeeld, het falen van een SAN (of cluster SDS, wat vaak voorkomt 🙂), massale fouten in het opslagnetwerk, en dergelijke. En het belangrijkste: zo’n cloud redt je als een hele locatie onbereikbaar is door een brand, blackout, overname door een kwaadaardige partij, of een invasie door buitenaardse wezens.
In al deze gevallen blijven de klantvirtual machines operationeel, en dit is waarom.
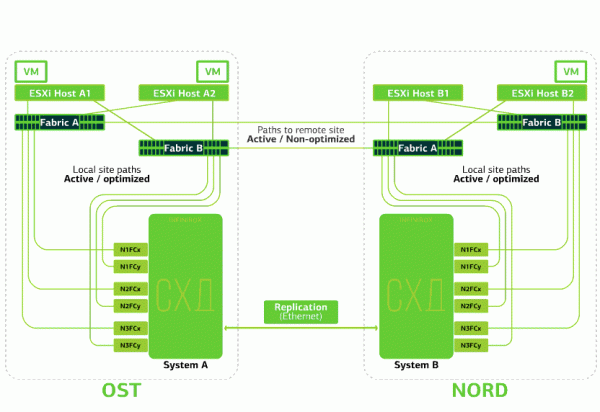
Het clusterontwerp is zo opgezet dat elke ESXi-host met klantvirtual machines kan communiceren met een van de twee opslagnetwerken. Als de opslag op de OST-locatie uitvalt, blijven de virtuele machines draaien: de hosts waarop ze draaien, zullen gegevens opvragen bij de opslag op NORD.
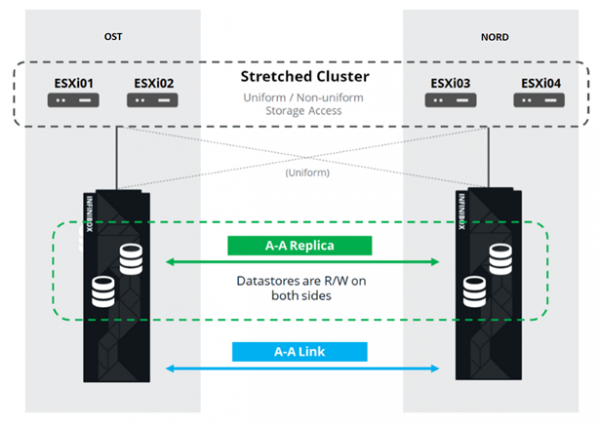
Dit is hoe het aansluitingsschema in het cluster eruitziet.
Dit is mogelijk omdat er een Inter-Switch Link is ingesteld tussen de SAN-fabrieken van de twee locaties: SAN-switch Fabric A OST is verbonden met SAN-switch Fabric A NORD, en hetzelfde geldt voor SAN-switches Fabric B.
En om ervoor te zorgen dat al deze ingewikkelde SAN-fabrieken zin hebben, is er actieve actieve replicatie tussen de twee opslagnetwerken ingesteld: informatie wordt vrijwel gelijktijdig geschreven naar de lokale en de externe opslag, RPO=0. Dit betekent dat er op één opslag de originele gegevens zijn opgeslagen, en op de andere de replicaat. Gegevens worden gerepliceerd op het niveau van de volumes van de opslag en daarop worden de gegevens van de VM (haar schijven, configuratiebestanden, swap-bestanden, enz.) opgeslagen.
De ESXi-host ziet het primaire volume en zijn replicaat als één opslagapparaat (Storage Device). Van de ESXi-host naar elk opslagapparaat lopen 24 paden:
12 paden verbinden het met de lokale opslag (optimale paden), terwijl de overige 12 met de externe opslag zijn verbonden (niet-optimale paden). In een normale situatie benadert ESXi de gegevens op de lokale opslag via de 'optimale' paden. Wanneer deze opslag uitvalt, verliest ESXi de optimale paden en schakelt over naar de 'niet-optimale'. Zo ziet het eruit op het schema.
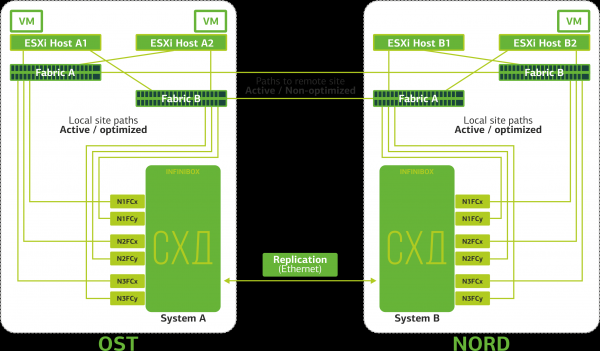
Schema van een rampbestendig cluster.
Alle klantnetwerken zijn naar beide locaties geleid via een gemeenschappelijke netwerkfabric. Op elke locatie draait een Provider Edge (PE), waar de klantnetwerken terminiert worden. De PE's zijn samengevoegd in een gemeenschappelijk cluster. Bij een uitval van de PE op één locatie wordt al het verkeer omgeleid naar de tweede locatie. Hierdoor blijven de virtuele machines op de locatie zonder PE via het netwerk toegankelijk voor de klant.
Laten we nu kijken wat er met de virtuele machines van de klant gebeurt bij verschillende uitvalscenario's. We beginnen met de lichtste scenario's en eindigen met het meest ernstige – de uitval van de hele locatie. In de voorbeelden is de primaire locatie OST en de reserve, met datakopieën, NORD.
Wat gebeurt er met de virtuele machine van de klant als…
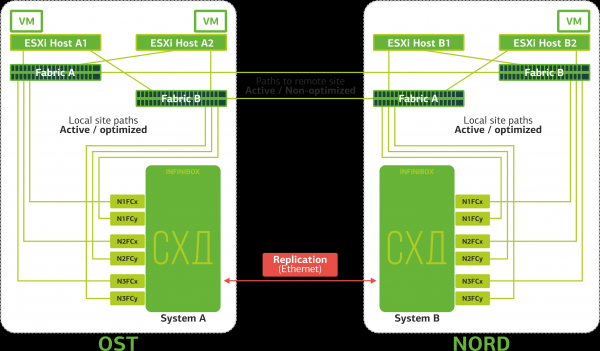
De Replication Link uitvalt. De replicatie tussen de opslag van de twee locaties stopt.
ESXi zal alleen werken met lokale schijfapparaten (via optimale paden).
Virtuele machines blijven functioneren.
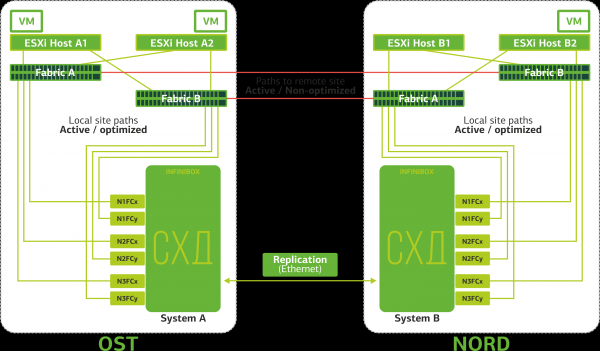
Er is een onderbreking in de ISL (Inter-Switch Link). Deze situatie is onwaarschijnlijk. Behalve misschien wanneer een razende graafmachine meerdere optische verbindingen opgraaft die via verschillende routes lopen en op locaties zijn aangesloten via verschillende invoeren. Maar goed. In dit geval verliezen de ESXi-hosts de helft van de paden en kunnen ze alleen hun lokale opslagaccessoires bereiken. Replica's worden verzameld, maar de hosts kunnen er geen toegang toe krijgen.
Virtuele machines functioneren normaal.
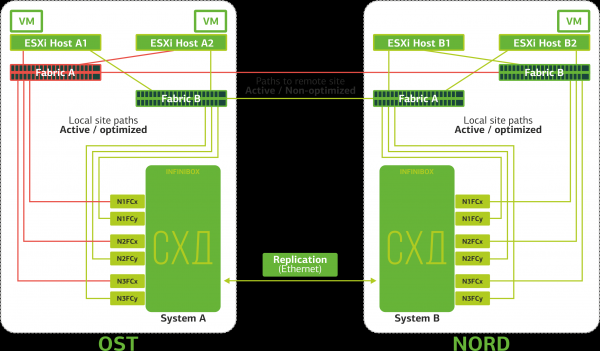
Een SAN-switch faalt op een van de locaties. ESXi-hosts verliezen een deel van de paden naar opslagaccessoires. In dit geval zullen de hosts op de locatie waar de switch is uitgevallen, alleen via hun eigen HBA werken.
De virtuele machines blijven ondertussen normaal functioneren.
Alle SAN-switches vallen uit op een van de locaties. Stel dat zo'n probleem zich voordoet op de OST-locatie. In dat geval verliezen de ESXi-hosts op deze locatie al hun paden naar lokale schijfapparaten. De standaard VMware vSphere HA-mechanisme treedt in werking: het zal alle virtuele machines op de OST-locatie maximaal binnen 140 seconden opnieuw opstarten in de NORD-locatie.
Virtuele machines die draaien op de hosts van locatie NORD functioneren normaal.
Een ESXi-host valt uit op een van de locaties. Hier wordt het vSphere HA-mechanisme opnieuw geactiveerd: de virtuele machines op de uitgevallen host worden opnieuw opgestart op andere hosts - op dezelfde of een andere locatie. De opstarttijd van de virtuele machine is tot 1 minuut.
Als alle ESXi-hosts op de OST-locatie uitvallen, zijn er geen opties meer: VMs worden opnieuw opgestart op een andere locatie. De opstarttijd blijft hetzelfde.
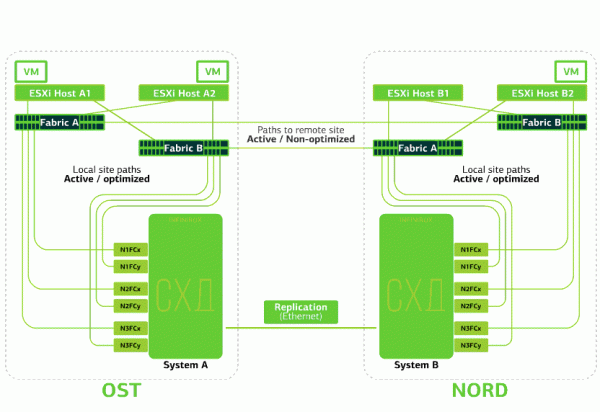
Een opslagaccessoire valt uit op een van de locaties. Stel dat een opslagaccessoire op de OST-locatie uitvalt. Dan schakelen de ESXi-hosts op de OST-locatie over naar het werken met replica's van opgeslagen data in NORD. Na het herstel van de uitgevallen opslagaccessoire vindt er een geforceerde replicatie plaats, waarna de ESXi-hosts op OST weer toegang krijgen tot hun lokale opslagaccessoire.
De virtuele machines blijven gedurende deze tijd normaal functioneren.
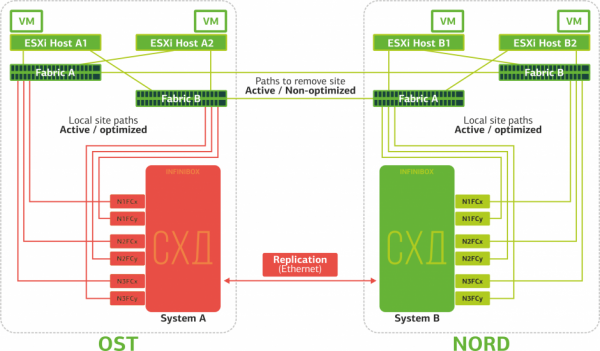
Een van de locaties valt uit. In dit geval worden alle virtuele machines opnieuw opgestart op de reserve-locatie via het vSphere HA-mechanisme. De opstarttijd van de VM is 140 seconden. Alle netwerkinstellingen van de virtuele machine blijven behouden, en deze blijft toegankelijk voor de klant via het netwerk.
Om ervoor te zorgen dat het opnieuw opstarten van machines op de reserve-locatie probleemloos verloopt, is elke locatie slechts voor de helft gevuld. De andere helft is een reserve voor het geval alle virtuele machines van de tweede, beschadigde, locatie verplaatst moeten worden.
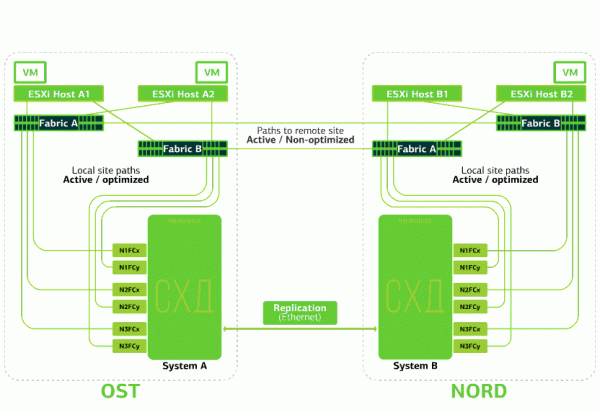
Dit zijn de uitvallen waar een rampbestendige cloud op basis van twee datacenters tegen beschermt.
Dit genoegen is niet goedkoop, aangezien naast de hoofdbronnen ook een reserve op de tweede locatie nodig is. Daarom worden in zo'n cloud bedrijfskritieke diensten geplaatst, waarvan een langdurige stilstand grote financiële en reputatieschade met zich meebrengt, of als de informatievoorziening eisen voor rampbestendigheid van de regulators of interne bedrijfsreglementen moet voldoen.
Bronnen:
Bron: habr.com
