

In 2010 had the company 50 servers and a simple network model: backend, frontend, and firewall. The number of servers grew, the model became more complex: staging environments, isolated VLANs with ACLs, then VPNs with VRFs, VLANs with ACLs on L2, VRFs with ACLs on L3. Feeling dizzy? It gets more interesting from here.
When the number of servers reached 16,000, it became impossible to operate efficiently with such a large number of heterogeneous segments. Therefore, a different solution was devised. They took the Netfilter stack, added Consul as a data source, and created a fast distributed firewall. It replaced the ACLs on the routers and was used as both an external and internal firewall. To manage the tool dynamically, they developed the BEFW system, which was implemented everywhere: from user access control in the product network to isolating network segments from each other.
How it all works and why you should take a closer look at this system will be explained by Ivan Agarakov () — the head of the infrastructure security group in the Maintenance division at the Minsk development center of the company. Ivan is a fan of SELinux, loves Perl, and writes code. As the head of the security group, he regularly works with logs, backups, and R&D to protect Wargaming from hackers and ensure the operation of all game servers in the company.
Historische achtergrond
Before I talk about how we did this, let me explain how we got here in the first place and why it was necessary. For this, let's move back nine years: to 2010, when World of Tanks had just emerged. Wargaming had about 50 servers.
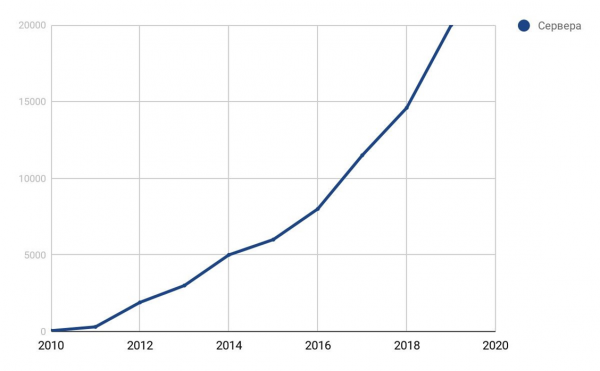
The growth chart of the company's servers.
We had a network model. For that time, it was optimal.
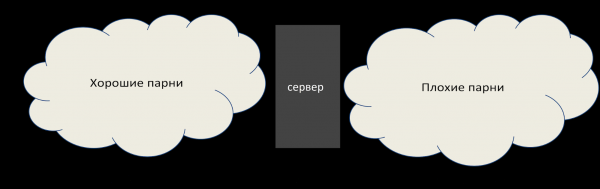
The network model in 2010.
The bad guys who want to break us live on the frontend, but there is a firewall. The backend does not have a firewall, but it has 50 servers, all of which we know. Everything works well.
In four years, the number of servers increased a hundredfold, to 5000. The first isolated networks appeared - stagings: they cannot go into production, and there often ran things that could be dangerous.
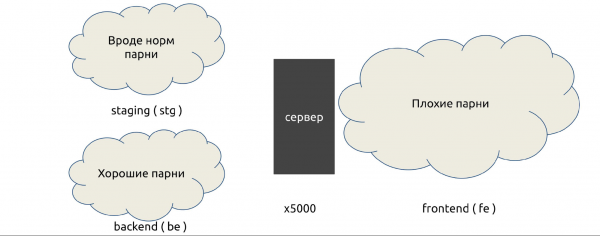
The network model in 2014.
We continued to use the same hardware, and all work was carried out on isolated VLANs: ACLs are written for VLANs that allow or deny specific connections.
In 2016 bereikte het aantal servers 8000. Wargaming nam andere studio's over, en er kwamen extra partnernetwerken. Ze lijken op ons, maar ook weer niet: voor partners werkt VLAN vaak niet, waardoor we VPN met VRF moeten gebruiken, en de isolaties worden complexer. De mix van isolaties ACL groeide.
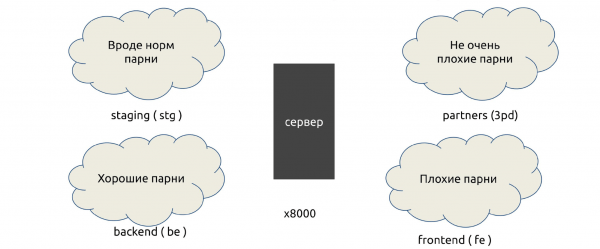
Netwerkmodel in 2016.
Begin 2018 was het wagenpark gegroeid tot 16.000. Er waren 6 segmenten, en de overige telden we niet mee, inclusief de afgesloten, waar financiële gegevens werden opgeslagen. Er kwamen container-netwerken (Kubernetes), DevOps, en cloudnetwerken die via VPN waren verbonden, bijvoorbeeld vanuit de IVS. Er waren veel regels — het was pijnlijk.
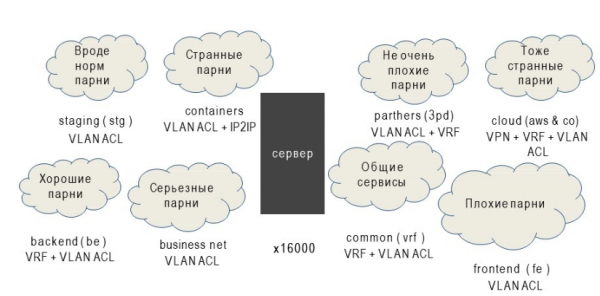
Netwerkmodel en isolatiemethoden in 2018.
Voor isolatie gebruikten we: VLAN met ACL op L2, VRF met ACL op L3, VPN en nog veel meer. Te veel.
Problemen
Iedereen leeft met ACL en VLAN. Wat is er eigenlijk mis? Op deze vraag zal Harold, die de pijn verbergt, antwoorden.
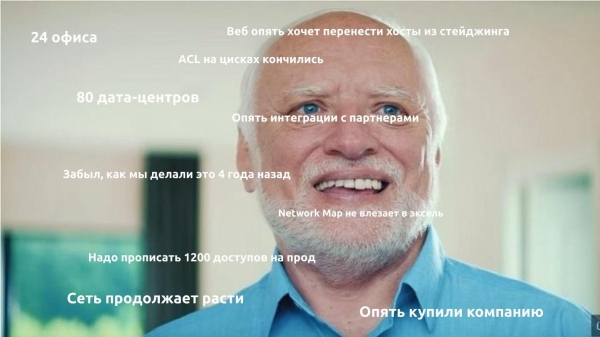
Er waren veel problemen, maar massale — vijf.
- Geometrische prijsstijging voor nieuwe regels. Elk nieuw regel werd langzamer toegevoegd dan de vorige, omdat we eerst moesten kijken of er al zo'n regel was.
- Geen firewall binnen de segmenten. Segmenten zijn op een bepaalde manier van elkaar gescheiden, binnenin zijn de middelen al onvoldoende.
- Regels werden langzaam toegepast. Met de hand kon een operator één lokaal regel in een uur schrijven. Een globale nam meerdere dagen in beslag.
- Moeilijkheden met het auditen van regels. Sterker nog, het was onmogelijk. De eerste regels werden al in 2010 geschreven, en het merendeel van de auteurs werkt al niet meer bij het bedrijf.
- Laag controle-niveau over de infrastructuur. Dit is het grootste probleem — we wisten slecht wat er eigenlijk gaande was.
Zo zag een netwerkingenieur eruit in 2018 toen hij hoorde: "We hebben nog wat ACL nodig."
Oplossingen
Begin 2018 werd besloten om hier iets aan te doen.
De kosten van integraties stijgen continu. De trigger was dat grote datacentra stopten met het ondersteunen van geïsoleerde VLAN en ACL, omdat het geheugen op de apparaten opraakte.
Oplossing: de menselijke factor weghalen en de toegang maximaal automatiseren.
Nieuwe regels worden langzaam toegepast. Oplossing: versnel de toepassing van regels, maak het gedistribueerd en parallel. Hiervoor is een gedistribueerd systeem nodig, zodat regels vanzelf worden afgeleverd, zonder rsync of SFTP naar duizend systemen.
Geen firewall binnen de segmenten. De firewall binnen segmenten begon ons te bereiken wanneer er verschillende services binnen hetzelfde netwerk verschenen. Oplossing: gebruik een firewall op hostniveau - host-based firewalls. Bijna overal hebben we Linux, en overal is er iptables, dat is geen probleem.
Moeilijkheden met het auditen van regels. Oplossing: sla alle regels op één plek op voor overzicht en beheer, zo kunnen we alles auditen.
Laag niveau van controle over de infrastructuur. Oplossing: inventariseer alle services en de toegang tussen hen.
Dit is meer een administratief proces dan een technisch. Soms hebben we 200-300 nieuwe releases per week, vooral tijdens promoties en feestdagen. Dit is alleen voor ons DevOps-team. Met zoveel releases is het onmogelijk om te begrijpen welke poorten, IP's of integraties nodig zijn. Daarom hebben we speciaal opgeleide service-managers nodig die de teams vragen: 'Wat is er eigenlijk en waarom hebben jullie dit opgezet?'
Na alles wat we hebben gelanceerd, begon de netwerktechnicus in 2019 er al zo uit te zien.
Consul
We hebben besloten dat alles wat we met de service-managers hebben gevonden, in Consul zal worden geplaatst en dat we vanuit daar regels voor iptables zullen schrijven.
Hoe hebben we besloten dit te doen?
- We verzamelen alle services, netwerken en gebruikers.
- We maken op basis daarvan iptables-regels.
- We automatizeren de controle.
- ….
- Winst.
Consul is geen externe API, het kan op elk knooppunt werken en in iptables schrijven. We moeten alleen automatische controlemechanismen bedenken die het overbodige opruimen, en het grootste deel van de problemen zal zijn opgelost! De rest werken we tijdens het proces uit.
Waarom Consul?
Heeft zich goed bewezen. In 2014-15 gebruikten we het als backend voor Vault, waar we wachtwoorden opslaan.
Verlies geen gegevens.. Gedurende het gebruik heeft Consul bij geen enkele storing gegevens verloren. Dit is een enorme plus voor het firewallbeheersysteem.
P2P-verbindingen versnellen de verspreiding van wijzigingen. Met P2P komen alle wijzigingen snel door, je hoeft niet uren te wachten.
Gemakkelijke REST API. We hebben ook naar Apache ZooKeeper gekeken, maar het heeft geen REST API, dan moeten we oplossingen achteraf implementeren.
Werkt zowel als een sleutelopslag (KV) als een catalogus (Service Discovery). Je kunt services, catalogi en datacenters tegelijkertijd opslaan. Dit is handig, niet alleen voor ons, maar ook voor de omliggende teams, omdat we bij het bouwen van een globale service grootschalig denken.
Geschreven in Go, dat deel uitmaakt van de Wargaming-stack. We houden van deze taal, we hebben veel Go-ontwikkelaars.
Krachtig ACL-systeem. Met behulp van ACL in Consul kun je beheren wie wat kan schrijven. We garanderen dat firewallregels niet met elkaar in conflict komen en dat we daar geen problemen mee hebben.
Maar Consul heeft ook nadelen.
- Het schaalt niet binnen datacenters, tenzij je de businessversie hebt. Het schaalt alleen via federatie.
- Het is zeer afhankelijk van de kwaliteit van het netwerk en de belasting van servers. Consul functioneert niet goed als server op een drukke server als er netwerkproblemen zijn, zoals onregelmatige snelheden. Dit heeft te maken met P2P-verbindingen en modellen voor het verspreiden van updates.
- Moeilijkheden met het monitoren van beschikbaarheid. De status van Consul kan aangeven dat alles goed is, terwijl het al lang niet meer functioneert.
De meeste van deze problemen hebben we opgelost tijdens de inzet van Consul, daarom hebben we voor hem gekozen. Het bedrijf heeft plannen voor een alternatieve backend, maar we hebben geleerd om met de problemen om te gaan en leven voorlopig met Consul.
Hoe Consul werkt
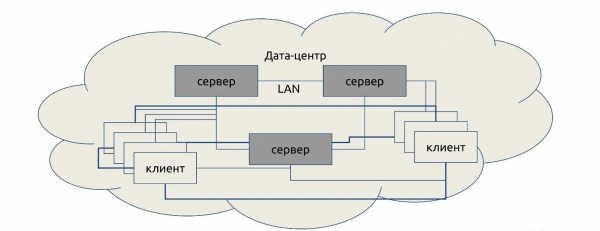
We installeren servers in een hypothetisch datacenter — van drie tot vijf. Eén of twee servers zijn niet voldoende: zij kunnen geen quorum organiseren en bepalen wie gelijk heeft als de gegevens niet overeenkomen. Meer dan vijf heeft geen zin, de prestaties zullen afnemen.
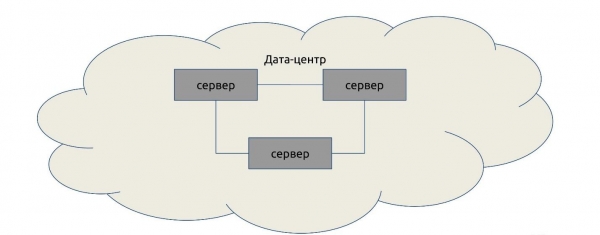
Clients verbinden zich in willekeurige volgorde met de servers: dezelfde agents, maar met de vlag server = false.
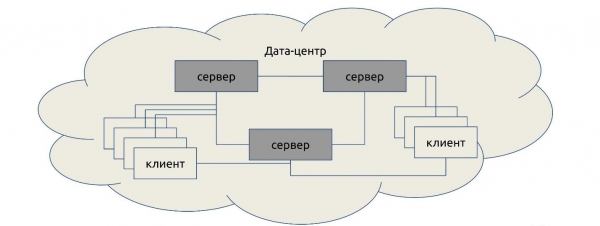
Daarna ontvangen clients een lijst van P2P-verbindingen en bouwen ze verbindingen met elkaar op.
Op globaal niveau verbinden we verschillende datacenters met elkaar. Deze zijn ook P2P met elkaar verbonden en communiceren.
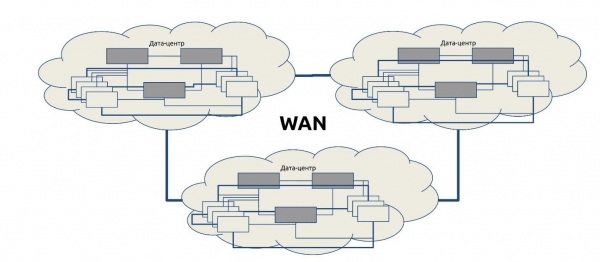
Wanneer we gegevens van een ander datacenter willen ophalen, gaat het verzoek van server naar server. Dit schema wordt genoemd het Serf-protocol. Het Serf-protocol, net als Consul, is ontwikkeld door HashiCorp.
Enkele belangrijke feitjes over Consul
Consul heeft documentatie die de werking ervan beschrijft. Ik zal alleen enkele belangrijke feiten geven die je moet weten.
Consul-servers kiezen een master uit de stemgerechtigden. Consul kiest een master uit de lijst van servers voor elk datacenter, en alle verzoeken gaan alleen naar hem, ongeacht het aantal servers. Het vastlopen van de master leidt niet tot herverkiezingen. Als er geen master is gekozen, worden verzoeken door niemand behandeld.
Je wilde horizontale schaling? Sorry, dat is er niet.
Een verzoek naar een andere datacenter gaat van master naar master, ongeacht op welke server het is aangekomen. De gekozen master ontvangt 100% van de belasting, behalve de belasting voor het doorsturen van verzoeken. Alle servers in het datacenter hebben een actuele kopie van de gegevens, maar slechts één verantwoordelijk voor de antwoorden.
De enige manier om op te schalen is door de stale-modus op de client in te schakelen.
In de stale-modus kunnen we antwoorden zonder quorum. Dit is de modus waarin we afstand doen van data-consistentie, maar iets sneller kunnen lezen dan normaal, en elk server kan antwoorden. Natuurlijk kan schrijven alleen via de master.
Consul kopieert geen gegevens tussen datacenters. Bij het opbouwen van een federatie zal elke server alleen zijn eigen gegevens hebben. Voor andere gegevens verwijst hij altijd naar iemand anders.
Atomische operaties worden niet gegarandeerd buiten een transactie. Vergeet niet dat niet alleen jij iets kunt wijzigen. Als je het anders wilt, voer je een transactie met afsluiting uit.
Blokkerende operaties garanderen geen blokkade. Het verzoek gaat van master naar master, en niet direct, dus er zijn geen garanties dat de blokkade werkt wanneer je een blokkade aanmaakt, bijvoorbeeld in een ander datacenter.
ACL biedt ook niet altijd toegang (in veel gevallen). De ACL kan mogelijk niet werken omdat deze in één datacenter van de federatie wordt opgeslagen — in het ACL datacenter (Primair DC). Als de DC je geen antwoord geeft, zal de ACL niet functioneren.
Een bevroren master leidt tot het bevriezen van de hele federatie. Bijvoorbeeld, in een federatie van 10 datacenters, als één slechte netwerklocatie is en een master uitvalt. Iedereen die met hem communiceert, zal vastlopen: er is een verzoek, er is geen antwoord, de thread blijft hangen. Je kunt niet weten wanneer dit zal gebeuren; na een uur of twee zal de hele federatie uitvallen. Je kunt hier niets aan doen.
Status, quorum en verkiezingen worden door een aparte thread behandeld. Herverkiezingen vinden niet plaats, de status toont niets. Je denkt dat je een werkende Consul hebt, je vraagt en er gebeurt niets — er is geen antwoord. Ondertussen geeft de status aan dat alles goed is.
We hebben deze kwestie ervaren en moesten specifieke delen van de datacenters opnieuw opbouwen om het te vermijden.
In de zakelijke versie van Consul Enterprise ontbreken sommige van de hierboven genoemde tekortkomingen.Het biedt veel nuttige functies: stemkeuze, distributie, schaling. Er is echter één "maar" — het licentiemodel voor het gedistribueerde systeem is erg duur.
Tip: rm -rf /var/lib/consul — het medicijn tegen alle problemen van de agent. Als er iets niet werkt, verwijder dan gewoon je gegevens en laad de gegevens van een back-up. Waarschijnlijk zal Consul dan weer werken.
BEFW
Laten we nu eens kijken naar wat we aan Consul hebben toegevoegd.
— dit is een acroniem van BackEndFireWall. Ik moest de naam van het product bedenken toen ik de repository maakte voor de eerste testcommits. Deze naam is gebleven.
Regeltemplates
De regels zijn geschreven in de iptables-syntaxis.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Alles gaat naar de BEFW-keten, behalve ESTABLISHED, RELATED en localhost. De template kan van alles zijn, dit is gewoon een voorbeeld.
Wat is het nut van BEFW?
Diensten
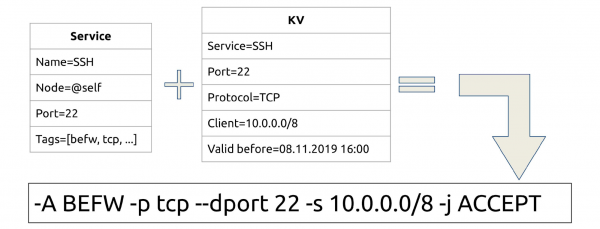
We hebben een service, waarbij er altijd een poort is, en een node waarop deze draait. Vanaf onze node kunnen we lokaal de agent vragen en achterhalen dat we een service hebben. We kunnen ook tags toevoegen.
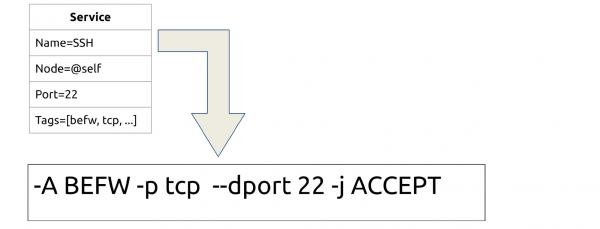
Elke service die actief is en geregistreerd staat in Consul, wordt omgezet in een iptables-regel. We hebben SSH — we openen poort 22. Het Bash-script is eenvoudig: curl en iptables, meer is er niet nodig.
Klanten
Hoe geef je toegang selectief en niet aan iedereen? Door op naam van de service IP-lijsten in de KV-opslag te verzamelen.
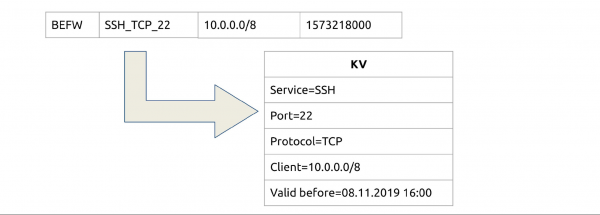
Bijvoorbeeld, we willen dat iedereen uit het tiende netwerk toegang heeft tot de SSH_TCP_22 service. We voegen een klein veld TTL? toe en nu hebben we tijdelijke permissies, bijvoorbeeld voor een dag.
Toegangen
We verbinden services en clients: we hebben een service, en voor elke service is er een KV-opslag klaar. Nu geven we toegang niet aan iedereen, maar selectief.
Groepen
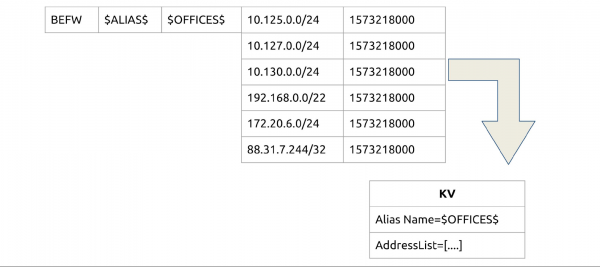
Als we elke keer duizenden IP's voor toegang moeten schrijven, worden we moe. Laten we groeperingen verzinnen — een aparte subset in de KV. We noemen het Alias (of groepen) en slaan daar groepen op volgens hetzelfde principe.
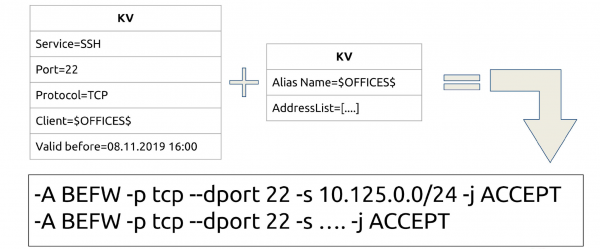
Verbindingen: nu kunnen we SSH niet specifiek inschakelen voor P2P, maar voor een hele groep of meerdere groepen. Evenzo is er TTL — we kunnen tijdelijk aan een groep toevoegen en verwijderen.
Integratie
Ons probleem — de menselijke factor en automatisering. Voorlopig hebben we het zo opgelost.
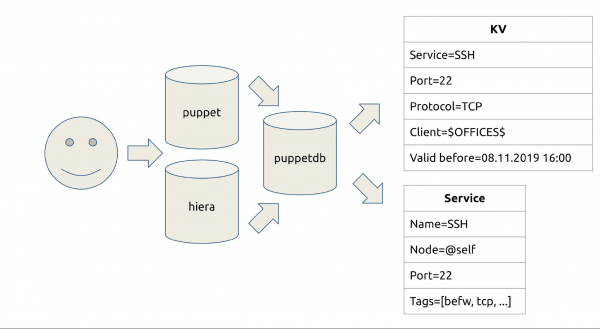
Wij werken met Puppet en dragen alles wat met het systeem te maken heeft (applicatiecode) over. In puppetdb (gewone PostgreSQL) wordt een lijst van services opgeslagen die daar draaien en deze kunnen worden gevonden op type hulpbron. Daar is ook te vinden wie contact maakt met wie. We hebben ook een systeem voor pull requests en merge requests hiervoor.
We hebben befw-sync geschreven – een eenvoudige oplossing die helpt bij het overdragen van gegevens. Eerst maken sync cookies contact met puppetdb. Daar is een HTTP API ingesteld: we vragen welke services we hebben en wat er gedaan moet worden. Vervolgens wordt er een verzoek naar Consul gestuurd.
Is er integratie? Ja, we hebben regels geschreven en pull requests goedgekeurd. Is er een poort nodig of moet er een host aan een bepaalde groep worden toegevoegd? Pull request, review – geen ‘Zoek 200 andere ACL's en probeer iets te doen.’
Optimalisatie
Een ping naar localhost met een lege regelschema kost 0,075 ms.
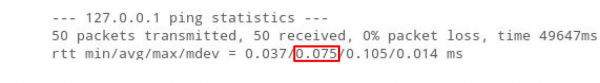
We voegen 10.000 adressen toe aan deze iptables keten. Als resultaat zal de ping vijf keer toenemen: iptables is volledig lineair, de verwerking van elk adres kost wat tijd.
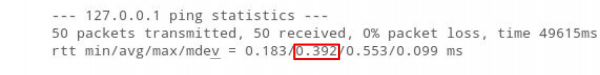
Voor de firewall waarin we duizenden ACL's migreren, hebben we veel regels, en dat introduceert latentie. Dit is slecht voor gameprotocollen.
Maar als we 10.000 adressen in ipset plaatsen, zal de ping zelfs verminderen.
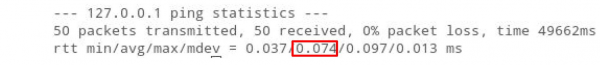
Het idee is dat 'O' (de algoritmische complexiteit) voor ipset altijd gelijk is aan 1, ongeacht het aantal regels. Er is echter een beperking – er mogen niet meer dan 65535 regels zijn. Tot nu toe gaan we hiermee om: we kunnen ze combineren, uitbreiden, en twee ipsets in één maken.
Opslag
Een logische voortzetting van het iteratieproces is het opslaan van informatie over klanten voor de service in ipset.
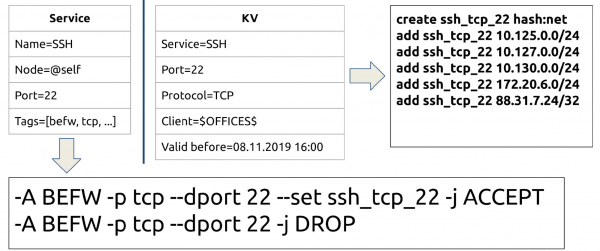
Nu hebben we dezelfde SSH, en we schrijven niet meteen 100 IP's, maar we geven de naam van het ipset op waarmee we willen communiceren, en dan de volgende regel. DROPWe kunnen het verpakken in één regel ‘Wie hier niet is, is DROP’, maar zo is het duidelijker.
Nu hebben we regels en sets. De belangrijkste taak is om de set te maken voordat we de regel schrijven, want anders schrijft iptables de regel niet.
Algemene schema
In de vorm van een schema ziet alles wat ik heb verteld er zo uit.
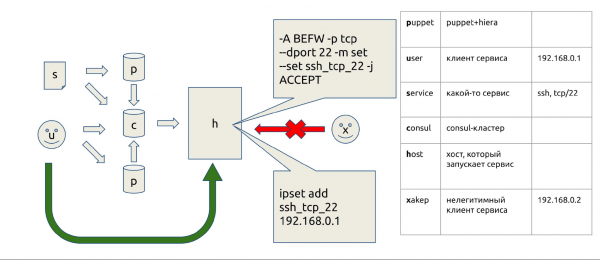
We committeren naar Puppet, alles wordt naar de host gestuurd, de services hier, ipset daar, en wie daar niet is, wordt niet binnen gelaten.
Toestaan & ontzeggen
Om de wereld snel te redden of snel iemand uit te schakelen, hebben we aan het begin van alle ketens twee ipsets gemaakt: rules_allow en rules_deny. Hoe werkt dit?
Bijvoorbeeld, iemand creëert belasting op onze Web met bots. Vroeger moest je zijn IP in de logs vinden, dit aan de netwerkingenieurs geven zodat zij de bron van het verkeer konden vinden en deze konden blokkeren. Nu gaat dit anders.
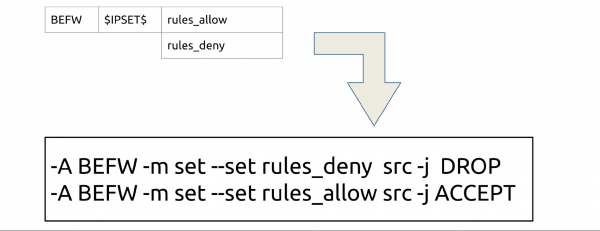
We sturen het naar Consul, wachten 2,5 seconden en het is klaar. Omdat Consul dankzij P2P snel verspreidt, werkt het overal, in elk deel van de wereld.
Een keer heb ik per ongeluk WOT volledig stopgezet door een fout met de firewall. rules_allow — dit is onze verzekering tegen zulke gevallen. Als we ergens een fout hebben gemaakt met de firewall, waardoor iets geblokkeerd wordt, kunnen we altijd een zogenaamde 0.0/0, om alles snel op te starten. Later kunnen we alles handmatig repareren.
Andere sets
Je kunt elke andere set aan de ruimte toevoegen $IPSETS$.
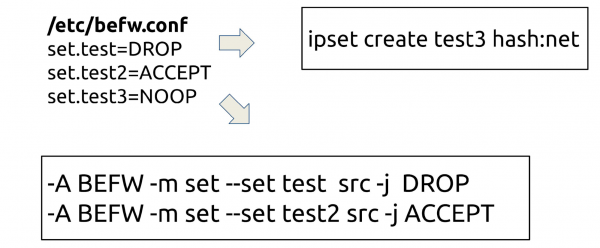
Waarom? Soms heeft iemand ipset nodig, bijvoorbeeld om het uitschakelen van een deel van de cluster te emuleren. Iedereen kan zijn eigen sets meebrengen, ze een naam geven en ze zullen uit Consul worden opgehaald. Deze sets kunnen zowel deelnemen aan iptables-regels als een soort commando zijn NOOP: de consistentie wordt ondersteund door de daemon.
Gebruikers
Vroeger was het zo: de gebruiker maakte verbinding met het netwerk en kreeg parameters via het domein. Tot de opkomst van nieuwe generatie firewalls begreep Cisco niet waar de gebruiker zich bevond en waar het IP was. Daarom werd toegang alleen verleend via de hostname van de machine.
Wat hebben wij gedaan? We hebben ons aan het moment van het verkrijgen van het adres ingevoegd. Dit gaat meestal via dot1x, Wi-Fi of VPN — alles verloopt via RADIUS. Voor elke gebruiker maken we een groep aan op basis van de gebruikersnaam en voegen we de IP toe met een TTL die gelijk is aan zijn dhcp.lease — zodra deze verloopt, verdwijnt de regel.
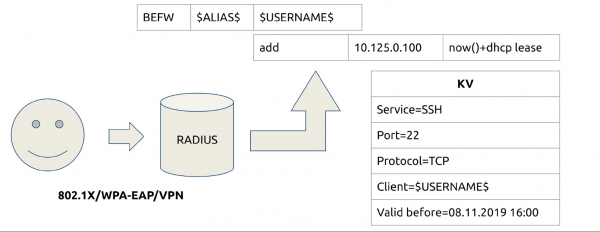
Nu kunnen we toegang tot services geven, net als in andere groepen, op basis van gebruikersnaam. We zijn verlost van de pijn met hostnames die veranderen, en hebben de belasting van netwerkingenieurs verlaagd, omdat ze Cisco niet meer nodig hebben. Nu schrijven de ingenieurs zelf hun toegangen op hun servers.
Isolatie
Tegelijkertijd zijn we begonnen met het ontrafelen van isolatie. Service-managers hebben een inventarisatie gemaakt en wij hebben al onze netwerken geanalyseerd. We splitsen ze in vergelijkbare groepen en hebben, bijvoorbeeld, op de benodigde servers groepen toegevoegd aan deny. Nu komt dezelfde isolatie van staging in rules_deny in productie, maar niet in de productie zelf.
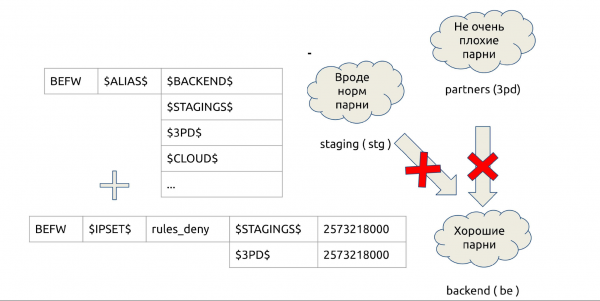
Het schema werkt snel en eenvoudig: we verwijderen alle ACL's van de servers, verlichten de hardware en verminderen het aantal geïsoleerde VLAN's.
Integriteitscontrole
Vroeger hadden we een speciale trigger die meldde wanneer iemand handmatig een firewallregel wijzigde. Ik schreef een enorme linter voor het controleren van firewallregels, wat lastig was. Nu controleert BEFW de integriteit. Het houdt nauwlettend in de gaten dat de regels die het instelt, niet worden gewijzigd. Als iemand de firewallregels aanpast, zet hij alles terug. 'Ik heb snel een proxy opgezet om vanuit huis te werken' — zulke situaties zijn er niet meer.
BEFW controleert ipset vanuit diensten en de lijst in befw.conf, en de regels van de diensten in de BEFW-keten. Maar het houdt geen toezicht op andere ketens, regels en andere ipsets.
Bescherming tegen storingen
BEFW slaat altijd de laatste succesvolle status op in de binaire structuur state.bin. Als er iets misgaat, gaat hij altijd terug naar deze state.bin.
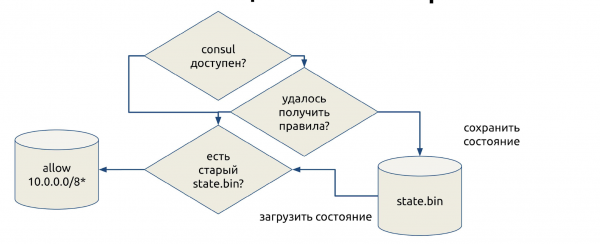
Dit is een verzekering tegen onbetrouwbaar functioneren van Consul, wanneer het geen gegevens heeft verzonden of iemand een fout heeft gemaakt en regels heeft gebruikt die niet kunnen worden toegepast. Zodat we niet zonder firewall komen te zitten, zal BEFW terugvallen op de laatste status als er op een bepaald moment een fout optreedt.
In kritieke situaties garandeert dit dat we een werkende firewall behouden. We openen alle grijze netwerken in de hoop dat een admin komt en het repareert. Ooit zal ik dit in de configuraties opnemen, maar nu hebben we gewoon drie grijze netwerken: 10/8, 172/12 en 192.168/16. Binnen ons Consul is dit een belangrijke eigenschap die helpt om verder te ontwikkelen.
Demo: tijdens de presentatie demonstreert Ivan de demomodus van BEFW. De demonstratie is gemakkelijker te bekijken op . De broncode van de demo is beschikbaar .
Valtjes
Ik zal vertellen over de bugs waarmee we te maken hadden.
ipset add set 0.0.0.0/0. Wat gebeurt er als je 0.0.0.0/0 aan ipset toevoegt? Worden alle IP's toegevoegd? Krijgen we toegang tot internet?
Nee, we krijgen een bug die ons twee uur downtime heeft gekost. Bovendien werkt de bug al sinds 2016 niet, hij staat in RedHat Bugzilla onder nummer #1297092, en we vonden hem toevallig — uit een rapport van de ontwikkelaar.
Nu staat er in BEFW een strikte regel dat 0.0.0.0/0 verandert in twee adressen: 0.0.0.0/1 en 128.0.0.0/1.
ipset restore set < file. Wat doet ipset als je het zegt restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Niets dergelijks — het doet een samenvoeging, en de oude adressen verdwijnen nergens; je sluit de toegang niet af.
We vonden de bug toen we de isolatie testten. Nu is er een vrij complex systeem — in plaats van restore wordt uitgevoerd create temp, daarna restore flush temp en restore temp. Aan het einde swap: voor atomiciteit, omdat als je eerst uitvoert flush En dit moment komt er een of andere pakket, en dat zal worden afgewezen en er zal iets misgaan. Daarom is er een beetje zwarte magie.
consul kv get -datacenter=other. Zoals ik al zei, denken we dat we bepaalde gegevens opvragen, maar we krijgen ofwel gegevens of een fout. We kunnen dit lokaal via Consul doen, maar in dat geval hangt zowel dat als het andere.
De lokale Consul-client is een wrapper rond de HTTP API. Maar hij hangt gewoon vast en reageert niet op Ctrl+C, Ctrl+Z of iets anders, alleen op kill -9 in de naastgelegen console. We zijn hierop gestuit toen we een grote cluster bouwden. Maar we hebben nog geen oplossing, we bereiden ons voor om deze fout in Consul te verhelpen.
Consul-leider reageert niet. Onze master in het datacenter reageert niet, we denken: "Zou nu het herverkiezingsalgoritme werken?"
Nee, dat zal niet werken, en de monitoring zal niks tonen: Consul zal zeggen dat de commitment index er is, de leider is gevonden, alles is goed.
Hoe gaan we hiermee om? service consul restart in cron elk uur. Als je 50 servers hebt, is dat geen probleem. Wanneer dit er 16.000 zijn, begrijp je hoe dit werkt.
Conclusie
Uiteindelijk hebben we de volgende voordelen gekregen:
- 100% dekking van alle Linux-machines.
- Snelheid.
- Automatisering.
- We hebben de hardware en netwerktechnici bevrijd van slavernij.
- Er zijn integratiemogelijkheden ontstaan die praktisch onbeperkt zijn: met Kubernetes, Ansible of Python.
Nadelen: Consul, waarmee we nu moeten leven, en de prijs van een fout is zeer hoog. Als voorbeeld, één keer om 6 uur 's avonds (prime time in Rusland) heb ik iets gewijzigd in de netwerk lijsten. We waren juist isolation aan het bouwen op de BEFW. Ik maakte ergens een fout, ik denk dat ik het verkeerde masker opgaf, maar alles viel binnen twee seconden. De monitoring gaat aan, de duty-support rent binnen: "Alles ligt plat!" De hoofd van de afdeling werd grijs toen hij aan het bedrijf uitlegde waarom het zo ging.
De prijs van een fout is zo hoog dat we een complexe preventieve procedure hebben bedacht. Als je dit implementeert in een grote productieomgeving, geef dan geen master-token van Consul aan iedereen. Dit zal slecht aflopen.
Kosten. Ik heb alleen 400 uur code geschreven. Mijn team van 4 personen besteedt 10 uur per maand aan ondersteuning voor iedereen. Vergeleken met de kosten van elke next-gen firewall is dit gratis.
Plannen. Het langetermijnplan is het zoeken naar alternatieve transportmogelijkheden in plaats van of aanvullend op Consul. Misschien wordt dat Kafka of iets dergelijks. Maar de komende jaren zullen we op Consul blijven leven.
Aanstaande plannen: integratie met Fail2ban, monitoring, nftables en mogelijk met andere distributies, metrics, uitgebreide monitoring en optimalisatie. Ondersteuning voor Kubernetes staat ook op de planning, omdat we momenteel enkele clusters hebben en de wens daaraan te werken.
Verder op de planning:
- detectie van anomalieën in het verkeer;
- beheersing van de netwerkkaart;
- ondersteuning voor Kubernetes;
- pakketassemblage voor alle systemen;
- Web-UI.
We werken voortdurend aan het uitbreiden van de configuratie, het verhogen van de metrics en optimalisatie.
Sluit je aan bij het project. Het project is geweldig geworden, maar helaas is het momenteel het project van één persoon. Kom naar en probeer iets te doen: committen, testen, iets voorstellen, je feedback geven.
Ondertussen bereiden we ons voor op , dat op 6 en 7 april in Sint-Petersburg plaatsvindt, en nodigen we ontwikkelaars van hoogbelaste systemen uit . Ervaren sprekers weten al wat ze moeten doen, en we raden nieuwkomers aan om minstens te doen. Deelname aan de conferentie als spreker heeft verschillende voordelen. Wat deze zijn, kun je bijvoorbeeld aan het einde lezen. .
Bron: habr.com
