

30 november - 1 december vond in Nizhny Novgorod de. De deelnemers kregen de opdracht om een prototype van een productoplossing te creëren met behulp van het Intel OpenVINO toolkit. De organisatoren stelden een lijst met voorbeelden van onderwerpen voor waarop men zich kon baseren bij het kiezen van een taak, maar de uiteindelijke beslissing lag bij de teams. Daarnaast werd het gebruik van modellen die niet in het product zijn opgenomen aangemoedigd.
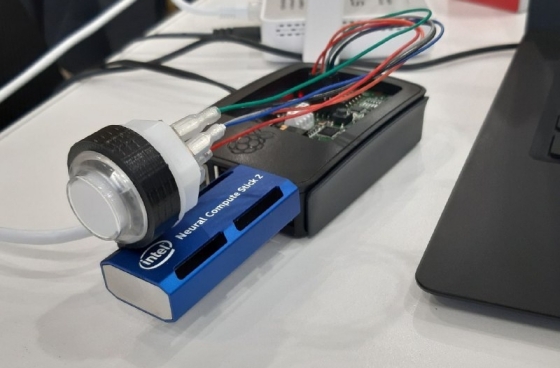
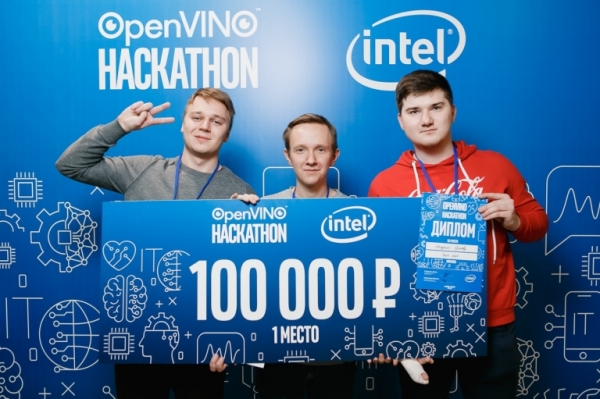
In dit artikel vertellen we hoe we ons eigen productprototype hebben ontwikkeld, waarmee we uiteindelijk de eerste plaats behaalden.
Meer dan 10 teams namen deel aan de hackathon. Het was fijn om te zien dat sommige van hen uit andere regio's kwamen. De locatie voor de hackathon was gekozen in het complex 'Kremlevsky op Pochaïna', waar binnen oude foto's van Nizhny Novgorod zijn opgehangen, een echte sfeer! (ik herinner eraan dat het centrale kantoor van Intel zich momenteel in Nizhny Novgorod bevindt). De deelnemers kregen 26 uur de tijd om code te schrijven, en aan het einde moesten ze hun oplossing presenteren. Een bijkomend voordeel was de aanwezigheid van een demo-sessie, om te verzekeren dat alles wat bedacht was daadwerkelijk was gerealiseerd, en niet alleen in de presentatie bleef steken. Merch, snacks, eten, alles was er ook!
Verder bood Intel op verzoek camera's, Raspberry Pi's en Neural Compute Stick 2 aan.
Taakkeuze
Een van de moeilijkste onderdelen van de voorbereiding op een hackathon met een vrij thema is het kiezen van een taak. We besloten meteen om iets te bedenken dat nog niet in het product aanwezig is, aangezien in de aankondiging stond dat dit ten zeerste werd aangemoedigd.
Na analyse van , die in het huidige product zijn opgenomen, komen we tot de conclusie dat de meeste ervan verschillende computer vision-taken oplossen. Het is echter erg moeilijk om een taak uit het gebied van computer vision te bedenken die niet kan worden opgelost met behulp van OpenVINO, en als die er is, is het in de open toegang moeilijk om voorgetrainde modellen te vinden. We besluiten ook in een andere richting te kijken — naar spraakverwerking en -analyse. We overwegen een interessante taak over emotieherkenning op basis van spraak. Het moet worden gezegd dat OpenVINO al een model heeft dat de emoties van een persoon op basis van het gezicht herkent, maar:
- In theorie is het mogelijk om een gecombineerde algoritme te maken dat zowel op geluid als op beeld werkt, wat een verbetering in nauwkeurigheid zou moeten opleveren.
- Camera's hebben meestal een smalle kijkhoek, om een groot gebied te dekken, zijn er meerdere camera's nodig, geluid heeft dergelijke beperkingen niet.
We ontwikkelen het idee: laten we ons baseren op een idee voor de retailsector. Tevredenheid van klanten kan bij de kassa's worden bepaald. Als een klant ontevreden is over de service en zijn stem verheft, kunnen we onmiddellijk iemand van het personeel inschakelen.
In dit geval moeten we spraakherkenning toevoegen, dit stelt ons in staat om medewerkers van klanten te onderscheiden en analytics voor individuen te creëren. Bovendien kunnen we het gedrag van de medewerkers analyseren en de sfeer binnen het team beoordelen, klinkt goed!
We formuleren de vereisten voor onze oplossing:
- Klein formaat van het doelapparaat
- Real-time werking
- Lage prijs
- Eenvoudige schaalbaarheid
Uiteindelijk kiezen we de Raspberry Pi 3 als doelapparaat met .
Het is belangrijk op te merken dat NCS het beste werkt met standaard CNN-architecturen, als we een model met aangepaste lagen willen draaien, verwacht dan 1g"55n55' n' Low-level optimalisatie.
De volgende stap is het verkrijgen van een microfoon. Een standaard USB-microfoon is ook prima, hoewel hij niet goed past bij de RPI. Maar ook hier ligt de oplossing letterlijk voor de hand. Voor stemopname gebruiken we de Voice Bonnet board van de , met een voorgemonteerde stereo microfoon.
We downloaden Raspbian van de en zetten deze op een USB-stick, we testen of de microfoon werkt met behulp van de volgende opdracht (het zal 5 seconden audio opnemen en opslaan in een bestand):
arecord -d 5 -r 16000 test.wavIk geef direct aan dat de microfoon zeer gevoelig is en goed ruis oppikt. Om dit te corrigeren, gaan we naar alsamixer, kiezen we Capture apparaten en verlagen het ingangssignaal tot 50-60%.
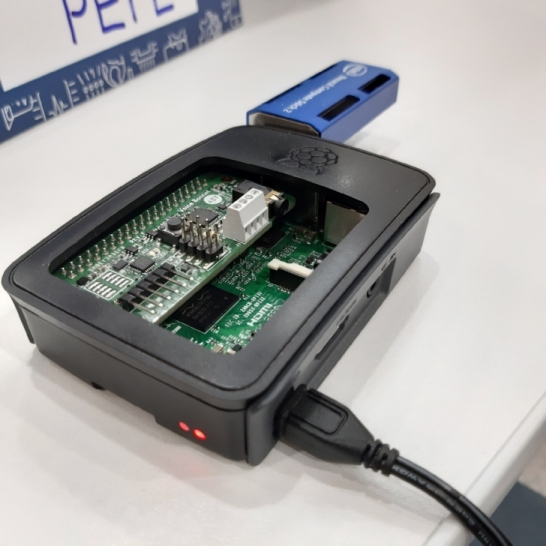
We werken de behuizing bij met een vijltje en alles past, we kunnen het zelfs afsluiten met een deksel.
We voegen een indicator-knop toe.
Tijdens het demonteren van de AIY Voice Kit herinneren we ons dat er een RGB-knop is met een programmeerbare verlichting. We zoeken naar "Google AIY Led" en vinden de documentatie:
Waarom zouden we deze knop niet gebruiken om de herkende emotie weer te geven? We hebben slechts 7 klassen, en de knop heeft 8 kleuren, dat is precies genoeg!
Sluit de knop aan via GPIO op de Voice Bonnet en laad de benodigde bibliotheken (deze zijn al geïnstalleerd in de distributie van AIY-projecten).
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Laten we een dict maken waarbij elke emotie wordt gekoppeld aan een kleur in de vorm van een RGB-tuple en een object van de klasse aiy.leds.Leds, waarmee we de kleur zullen bijwerken:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
En tenslotte, na elke nieuwe voorspelling van de emotie, zullen we de kleur van de knop bijwerken op basis van deze (volgens de sleutel).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))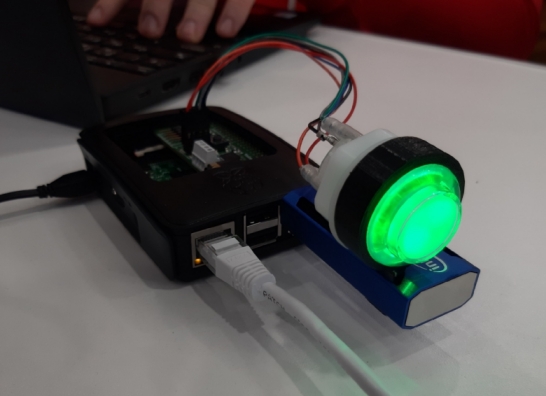
Knop, brand!
Werken met stem
We zullen pyaudio gebruiken om een stroom van de microfoon vast te leggen en webrtcvad om ruis te filteren en stem te detecteren. Daarnaast creëren we een wachtrij waarin we asynchroon fragmenten met stem zullen toevoegen en ophalen.
Aangezien webrtcvad een beperking heeft op de grootte van het ingediende fragment — het moet gelijk zijn aan 10/20/30ms, en de training van het model voor emotiedetectie (zoals we later zullen zien) werd uitgevoerd op een dataset van 48kHz, zullen we stukken opnemen van 48000×20ms/1000×1(mono)=960 bytes. Webrtcvad zal True/False retourneren voor elk van dergelijke stukjes, wat overeenkomt met de aanwezigheid of afwezigheid van stem in het stukje.
We implementeren de volgende logica:
- We zullen de stukken waar er stem is aan de lijst toevoegen, als er geen stem is, verhogen we de teller van lege stukken.
- Als de teller van lege stukken >=30 (600 ms), kijken we naar de grootte van de lijst met verzamelde stukken, als deze >250 is, voegen we het toe aan de wachtrij, als dat niet het geval is, beschouwen we de lengte van de opname als onvoldoende om deze aan het model te presenteren voor sprekeridentificatie.
- Als de teller van lege stukken nog steeds < 30 is, maar de grootte van de lijst met verzamelde stukken meer dan 300 heeft overschreden, voegen we het fragment toe aan de wachtrij voor een nauwkeuriger voorspelling. (omdat emoties in de loop van de tijd geneigd zijn te veranderen)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame, timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame, timestamp_start))
                audio_frame = []
Het is tijd om op zoek te gaan naar voorgetrainde modellen, we gaan naar github, googelen, maar onthouden dat we beperking hebben op de te gebruiken architectuur. Dit is een vrij lastige klus, omdat we modellen op onze gegevens moeten testen, en bovendien omzetten naar het interne OpenVINO-formaat — IR (Intermediate Representation). We hebben ongeveer 5-7 verschillende oplossingen van github geprobeerd, en terwijl het model voor emotieherkenning meteen werkte, moesten we met spraakherkenning langer wachten — daar worden complexere architecturen gebruikt.
We stoppen bij de volgende:
- Emoties uit de stem —
Het werkt volgens het volgende principe: audio wordt in stukken van een bepaalde grootte gesneden, voor elk van deze stukken extraheren we en geven deze vervolgens door aan de CNN - Spraakherkenning —
Hier werken we in plaats van met MFCC met een spectrogram, na FFT geven we het signaal door aan de CNN, waar we een vectorrepresenteert van de stem krijgen.
Verder gaan we het hebben over het converteren van modellen, laten we beginnen met de theorie. OpenVINO omvat verschillende modules:
- Open Model Zoo, modellen waarvan we konden gebruiken en opnemen in ons product
- Model Optimizer, waarmee we modellen uit verschillende frameworkformaten (Tensorflow, ONNX, enz.) kunnen omzetten naar het Intermediate Representation-formaat, waar we verder mee zullen werken
- Inference Engine stelt ons in staat om modellen in IR-formaat uit te voeren op Intel-processors, Myriad-chips en Neural Compute Stick versnellers
- De meest efficiënte versie van OpenCV (met ondersteuning voor Inference Engine)
Elk model in IR-formaat wordt beschreven door twee bestanden: .xml en .bin.
Modellen worden door Model Optimizer als volgt naar IR-format geconverteerd:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typestelt u in staat om het gegevensformaat te kiezen waar het model mee zal werken. FP32, FP16, en INT8 worden ondersteund. Het kiezen van het optimale gegevenstype kan een aanzienlijke prestatieverbetering opleveren.
--input_shapegeef de dimensionaliteit van de invoergegevens aan. Er lijkt een mogelijkheid te zijn om deze dynamisch te wijzigen in de C++ API, maar we hebben dat niet verder onderzocht en voor een van de modellen hebben we het gewoon gefixeerd.
Laten we nu proberen het al geconverteerde model in IR-formaat te laden via de DNN-module in OpenCV en een forwardpass hierop uit te voeren.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)De laatste regel in dit geval stelt ons in staat om de berekeningen naar de Neural Compute Stick te leiden; normaal gesproken worden de berekeningen op de CPU uitgevoerd, maar in het geval van de Raspberry Pi werkt dat niet, we hebben de stick nodig.
Het logische vervolg is als volgt: we splitsen onze audio op in vensters van een bepaalde grootte (in ons geval 0.4s), en elke van deze vensters transformeren we in MFCC, die we vervolgens aan het netwerk doorgeven:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Daarna nemen we de meest voorkomende klasse voor alle vensters. Een eenvoudige oplossing, maar voor een hackathon is het niet nodig om iets te ingewikkelds te bedenken, alleen als we tijd over hebben. We hebben nog veel te doen, dus laten we verder gaan — we richten ons nu op spraakherkenning. We moeten een soort database maken waarin de spectrogrammen van eerder opgenomen stemmen worden opgeslagen. Omdat we niet veel tijd meer hebben, benaderen we dit probleem zoals we kunnen.
Specifiek maken we een script om een fragment van een stem op te nemen (dit werkt op dezelfde manier als hierboven beschreven, alleen zal het bij het onderbreken via het toetsenbord de stem in een bestand opslaan).
Laten we het proberen:
python3 voice_db/record_voice.py test.wavWe nemen de stemmen van verschillende mensen op (in ons geval drie teamleden).
Vervolgens voeren we voor elke opgenomen stem een snelle Fourier-transformatie uit, krijgen we een spectrogram en slaan we dit op als een numpy-array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Meer details in het bestand
create_base.py
Uiteindelijk zullen we bij het uitvoeren van het hoofdscript aan het begin embeddings uit deze spectrogrammen ontvangen:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Nadat we de embedding uit het afgespeelde fragment hebben ontvangen, kunnen we bepalen aan wie deze toebehoort door de cosinusafstand van het fragment tot alle stemmen in de database te nemen (hoe kleiner, hoe waarschijnlijker) — voor de demo hebben we een drempel van 0.3 ingesteld:
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Ten slotte wil ik opmerken dat de inferentiesnelheid snel was en het mogelijk maakte om nog 1-2 modellen toe te voegen (voor een sample van 7 seconden duurde de inferentie 2.5). We hadden geen tijd meer om nieuwe modellen toe te voegen en richtten ons op het schrijven van een prototype webapplicatie.
Webapplicatie
Belangrijk punt: neem een router mee van huis en stel je lokale netwerk in, dit helpt om het apparaat en de laptops met elkaar te verbinden via het netwerk.
De backend fungeert als een doorlopende berichtenlijn tussen de frontend en de Raspberry Pi, gebaseerd op websockettechnologie (http over tcp-protocol).
De eerste stap is het ontvangen van verwerkte informatie van de Raspberry, dat wil zeggen de in json verpakte predicties, die halverwege hun pad in de database worden opgeslagen, zodat statistieken over de emotionele achtergrond van de gebruiker over een bepaalde periode kunnen worden gevormd. Vervolgens wordt dit pakket naar de frontend verzonden, die abonnementen gebruikt en pakketten ontvangt van de websocket-endpoint. Het hele backend-mechanisme is gebouwd in de programmeertaal golang, omdat deze goed geschikt is voor asynchrone taken, waarmee goroutines goed omgaan.
Bij toegang tot de endpoint registreert de gebruiker zich en wordt in de structuur opgenomen, waarna zijn bericht wordt ontvangen. Zowel de gebruiker als het bericht worden in de gezamenlijke hub opgenomen, waaruit de berichten verder worden verzonden (naar de geabonneerde frontend), en als de gebruiker de verbinding verbreekt (Raspberry of frontend), wordt zijn abonnement geannuleerd en wordt hij uit de hub verwijderd.
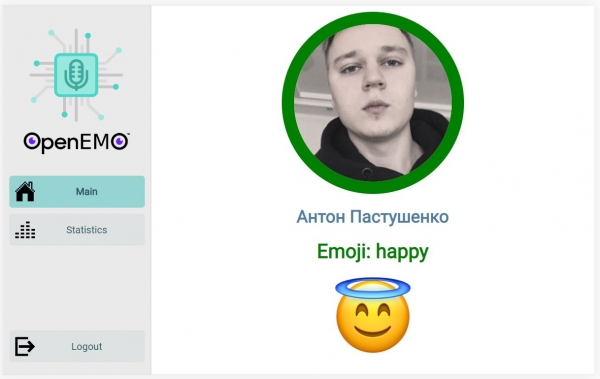
We wachten op de verbinding met de backendDe front-end is een webapplicatie die is geschreven in JavaScript met behulp van de React-bibliotheek om het ontwikkelingsproces te versnellen en te vereenvoudigen. Het doel van deze applicatie is om gegevens te visualiseren die zijn verkregen via algoritmes die draaien aan de back-end kant en rechtstreeks op de Raspberry Pi. Op de pagina is er routing naar secties, gerealiseerd met behulp van react-router, maar de belangrijkste belangstelling gaat uit naar de startpagina, waar in realtime een continue stroom van gegevens van de server binnenkomt via de WebSocket-technologie. De Raspberry Pi detecteert stemmen, bepaalt de toebehoren aan een specifieke persoon uit de geregistreerde database en stuurt een lijst met waarschijnlijkheid naar de klant. De klant toont de laatste actuele gegevens, geeft de avatar weer van de persoon die met de grootste waarschijnlijkheid in de microfoon heeft gesproken, evenals de emotie waarmee hij zijn woorden uitspreekt.

Startpagina met bijgewerkte voorspellingenConclusie
We konden niet alles af krijgen zoals we hadden gepland, simpelweg omdat we niet op tijd waren, dus de grote hoop was op de demo, dat alles zou functioneren. In de presentatie werd verteld over hoe alles is opgebouwd, welke modellen zijn genomen, met welke problemen we zijn geconfronteerd. Vervolgens was er een demo-gedeelte — experts liepen door de zaal in willekeurige volgorde en gingen naar elk team om de werkende prototype te bekijken. Ze stelden ons vragen, en iedereen antwoordde op zijn deel, op de laptop lieten we de webversie zien, en alles werkte zoals verwacht.
Ik wil opmerken dat de totale kosten van onze oplossing 150$ bedragen:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (je kunt ook de respeakerkaart nemen) ~ 15$
- Intel NCS 2 ~ 100$
Hoe te verbeteren:
- Registratie vanaf de client gebruiken — vragen om een tekst voor te lezen die we willekeurig genereren
- Nog enkele modellen toevoegen: aan de stem kan de geslacht en leeftijd worden bepaald
- Gelijktijdig klinkende stemmen scheiden (diarisatie)
Repository:

Vermoeid, maar gelukkigTot slot willen we de organisatoren en deelnemers bedanken. Van de projecten van andere teams vonden wij persoonlijk de oplossing voor het monitoren van beschikbare parkeerplaatsen het leukst. Voor ons was het een ongelooflijk toffe ervaring om in het product en de ontwikkeling te duiken. Ik hoop dat er steeds meer interessante evenementen in de regio's zullen plaatsvinden, ook op het gebied van AI.
Bron: habr.com
