

Hallo, Habr! Ik presenteer u de vertaling van het artikel
.
Wanneer het gaat om relationele databases kan ik niet helpen maar denken dat er iets ontbreekt. Ze worden overal gebruikt. Er zijn veel verschillende databases: van de kleine en handige SQLite tot de krachtige Teradata. Maar er zijn maar een paar artikelen die uitleggen hoe een database werkt. Je kunt zelf zoeken met de query "howdoesarelationaldatabasework" om te zien hoe weinig resultaten er zijn. Bovendien zijn deze artikelen kort. Als je echter op zoek bent naar de nieuwste trendy technologieën (BigData, NoSQL of JavaScript), vind je meer diepgaande artikelen die uitleggen hoe ze werken.
Zijn relationele databases te oud en te saai om buiten universitaire cursussen, onderzoeksdocumenten en boeken te worden uitgelegd?
Als ontwikkelaar haat ik het om iets te gebruiken wat ik niet begrijp. En als databases al meer dan 40 jaar worden gebruikt, moet er een reden voor zijn. In die jaren heb ik honderden uren besteed om deze vreemde zwarte dozen die ik elke dag gebruik, echt te begrijpen. Relationele databases zijn heel interessant omdat ze zijn gebaseerd op nuttige en herbruikbare concepten. Als je geïnteresseerd bent in het begrijpen van databases, maar nooit de tijd of de wens hebt gehad om je in dit uitgebreide onderwerp te verdiepen, dan zal je deze artikel leuk vinden.
Hoewel de titel van dit artikel duidelijk is, is het doel van dit artikel niet om te begrijpen hoe je een database gebruikt. Daarom moet je al weten hoe je een eenvoudige join-query en basisqueries schrijft CRUD; anders moet je deze artikel misschien niet begrijpen. Dit is het enige dat je moet weten, ik zal alles verder uitleggen.
Ik begin met enkele basisprincipes van computerwetenschappen, zoals de tijdcomplexiteit van algoritmes (BigO). Ik weet dat sommige van jullie deze conceptie haten, maar zonder deze kun je de nuances binnen een database niet begrijpen. Aangezien dit een enorm onderwerp is, zal ik me richten op hetgeen ik belangrijk vind: hoe een database omgaat met SQL een query. Ik zal alleen de belangrijkste concepten van databasesintroduceren, zodat je aan het einde van het artikel een idee hebt van wat er onder de motorkap gebeurt.
Aangezien dit een lang en technisch artikel is dat veel algoritmen en datastructuren omvat, neem de tijd om het te lezen. Sommige concepten kunnen moeilijk te begrijpen zijn; je kunt ze overslaan en toch een algemeen begrip krijgen.
Voor degenen die beter geïnformeerd zijn, is dit artikel verdeeld in 3 delen:
- Overzicht van low-level en high-level databasecomponenten
- Overzicht van het optimalisatieproces van queries
- Overzicht van transactiemanagement en bufferpool
Terug naar de basis
Jaren geleden (in een ver, ver sterrenstelsel...) moesten ontwikkelaars precies weten hoeveel bewerkingen ze codeerden. Ze kenden hun algoritmen en datastructuren uit hun hoofd, omdat ze zich geen belasting van de CPU en het geheugen van hun trage computers konden veroorloven.
In dit deel zal ik je herinneren aan sommige van deze concepten, omdat ze essentieel zijn voor het begrip van databases. Ik zal ook het begrip introduceren van database-index.
O(1) vs O(n2)
Tegenwoordig maken veel ontwikkelaars zich geen zorgen over de tijdcomplexiteit van algoritmen… en ze hebben gelijk!
Maar wanneer je met grote hoeveelheden gegevens werkt (en ik heb het niet over duizenden) of als je vecht om milliseconden, wordt het cruciaal om dit concept te begrijpen. En zoals je begrijpt, moeten databases zich met beide situaties bezighouden! Ik zal je niet langer laten duurt dan nodig is om de essentie te begrijpen. Dit helpt ons later om het concept van kostgebaseerde optimalisatie te begrijpen (cost based optimization).
Concept
Tijdcomplexiteit van een algoritme wordt gebruikt om te zien hoeveel tijd het algoritme in beslag zal nemen voor een bepaalde hoeveelheid gegevens. Om deze complexiteit te beschrijven, worden wiskundige notaties van de grote O gebruikt. Deze notatie wordt gebruikt met een functie die beschrijft hoeveel bewerkingen een algoritme vereist voor een bepaalde hoeveelheid invoergegevens.
Bijvoorbeeld, wanneer ik zeg "dit algoritme heeft een complexiteit van O (some_function() )", betekent dit dat het algoritme some_function(a_certain_amount_of_data) bewerkingen nodig heeft om een bepaalde hoeveelheid gegevens te verwerken.
Tegelijkertijd kunnen meerdere mensen aan hetzelfde project werken het is niet de hoeveelheid gegevens **, maar hoe, ** het aantal bewerkingen toeneemt bij een toename van de hoeveelheid gegevens. Tijdcomplexiteit geeft geen exact aantal bewerkingen, maar is een goede manier om de uitvoeringstijd te schatten.
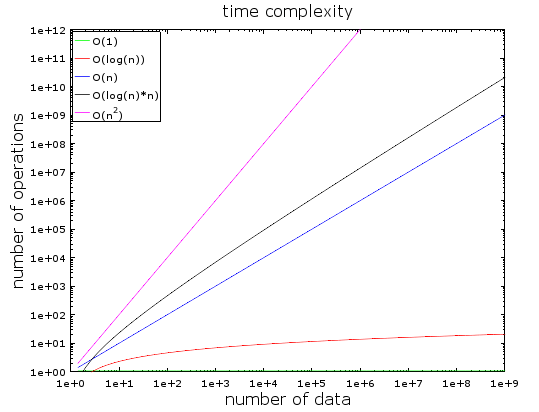
In deze grafiek kunt u de relatie zien tussen het aantal bewerkingen en de hoeveelheid invoergegevens voor verschillende types tijdcomplexiteit van algoritmen. Ik heb een logaritmische schaal gebruikt om ze weer te geven. Met andere woorden, de hoeveelheid gegevens groeit snel van 1 tot 1 miljard. We kunnen zien dat:
- O(1) of constante complexiteit blijft constant (anders zou het geen constante complexiteit heten).
- O(log(n)) blijft laag, zelfs met miljarden gegevens.
- De slechtste complexiteit is — O(n2), waar het aantal bewerkingen snel toeneemt.
- De andere twee complexiteiten nemen ook snel toe.
Voorbeelden
Bij een klein aantal gegevens is het verschil tussen O(1) en O(n2) verwaarloosbaar. Stel bijvoorbeeld dat u een algoritme heeft dat 2000 elementen moet verwerken.
- Het O (1) algoritme kost u 1 bewerking
- Het O (log (n)) algoritme kost u 7 bewerkingen
- Het O (n) algoritme kost u 2.000 bewerkingen
- Het O (n * log (n)) algoritme kost u 14.000 bewerkingen
- Het O (n2) algoritme kost u 4.000.000 bewerkingen
Het verschil tussen O(1) en O(n2) lijkt groot (4 miljoen bewerkingen) maar u verliest maximaal 2 ms, gewoon de tijd om met uw ogen te knipperen. Inderdaad, moderne processoren kunnen . Daarom zijn prestaties en optimalisatie geen probleem in veel IT-projecten.
Zoals ik al zei, is het nog steeds belangrijk om dit concept te begrijpen bij het werken met enorme hoeveelheden gegevens. Als dit keer het algoritme 1.000.000 elementen moet verwerken (wat niet veel is voor een database):
- Het O (1) algoritme kost u 1 bewerking
- Het O (log (n)) algoritme kost u 14 bewerkingen
- Het O (n) algoritme kost u 1.000.000 bewerkingen
- Het O (n * log (n)) algoritme kost u 14.000.000 bewerkingen
- Het O (n2) algoritme kost u 1.000.000.000.000 bewerkingen
Ik heb geen berekeningen gemaakt, maar ik zou zeggen dat je met het O (n2) algoritme tijd hebt om een kopje koffie te drinken (zelfs twee!). Als je nog een 0 toevoegt aan de hoeveelheid gegevens, heb je zelfs tijd om een dutje te doen.
Laten we dieper ingaan
Ter referentie:
- Zoeken in een goede hash-tabel vindt een element in O (1).
- Zoeken in een goed gebalanceerde boom levert resultaat op in O (log (n)).
- Zoeken in een array levert resultaat op in O (n).
- De beste sorteeralgoritmen hebben een complexiteit van O (n * log (n)).
- Een slecht sorteeralgoritme heeft een complexiteit van O (n2).
Opmerking: in de volgende delen zullen we deze algoritmen en datastructuren zien.
Er zijn verschillende typen tijdcomplexiteit van een algoritme:
- gemiddeld geval
- beste scenario
- en slechtste scenario
Tijdcomplexiteit is vaak het slechtste scenario.
Ik heb alleen over de tijdcomplexiteit van algoritmes gesproken, maar complexiteit is ook van toepassing op:
- geheugenverbruik door het algoritme
- schijfinvoer/-uitvoer door het algoritme
Natuurlijk zijn er complexiteiten die erger zijn dan n2, bijvoorbeeld:
- n4: dat is vreselijk! Sommige van de genoemde algoritmes hebben zo'n complexiteit.
- 3n: dat is nog erger! Een van de algoritmes die we halverwege dit artikel zullen bekijken, heeft deze complexiteit (en wordt inderdaad in veel databases gebruikt).
- factorial n: je krijgt nooit je resultaten, zelfs niet met een kleine hoeveelheid gegevens.
- nn: als je met deze complexiteit te maken krijgt, moet je jezelf afvragen of dit echt jouw vakgebied is ...
Opmerking: ik heb je geen echte definitie van de notatie 'grote O' gegeven, maar gewoon een idee. Je kunt dit artikel lezen voor een echte (asymptotische) definitie. MergeSort (Merge Sort)
Wat doe je als je een collectie moet sorteren? Wat? Je roept de functie sort() aan… Oké, goed antwoord… Maar voor databases moet je begrijpen hoe deze functie sort() werkt.
Er zijn verschillende goede sorteeralgoritmes, dus ik concentreer me op het belangrijkste:
merge sort . Misschien begrijp je nu niet waarom het sorteren van gegevens nuttig is, maar dat moet je begrijpen na het gedeelte over het optimaliseren van queries. Bovendien zal het begrijpen van merge sort ons later helpen om de algemene join-operatie van databases te begrijpen, genaamd(merge join) merge join Merge.
Zoals veel nuttige algoritmes is merge sort gebaseerd op een truc: het samenvoegen van 2 gesorteerde arrays van grootte N/2 in een N-elementen gesorteerde array kost slechts N bewerkingen. Deze bewerking wordt samenvoegen genoemd.
Laten we eens kijken wat dit betekent aan de hand van een eenvoudig voorbeeld:
In deze afbeelding zie je dat je maar één iteratie hoeft uit te voeren over 2 arrays van 4 elementen om de uiteindelijke gesorteerde array van 8 elementen te bouwen. Aangezien beide 4-element arrays al gesorteerd zijn:
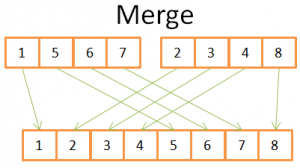
1) vergelijk je beide huidige elementen in de twee arrays (aan het begin is de huidige = eerste).
- 1) U vergelijkt beide huidige elementen in twee arrays (waarbij de huidige gelijk is aan de eerste)
- 2) neem dan het kleinste om in een array van 8 elementen te plaatsen
- 3) en ga verder naar het volgende element in de array waar je het kleinste element vandaan hebt gehaald
- en herhaal 1, 2, 3 totdat je het laatste element van een van de arrays hebt bereikt.
- Vervolgens neem je de overige elementen van de andere array om in de array van 8 elementen te plaatsen.
Dit werkt omdat beide 4-elementenarrays gesorteerd zijn, en daarom hoef je daar niet 'terug' in deze arrays.
Nu we deze truc begrijpen, hier is mijn pseudocode voor merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //recursieve aanroepen
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //samensmelten van de 2 kleine gesorteerde arrays in een grote
   array result := merge(new_left_array,new_right_array);
   return result;
Merge sort deelt de taak op in kleinere taken en vindt vervolgens de resultaten van deze kleinere taken om het resultaat van de oorspronkelijke taak te krijgen (opmerking: dit type algoritmes wordt 'Divide and Conquer' genoemd). Maak je geen zorgen als je dit algoritme niet begrijpt; ik snapte het niet de eerste keer dat ik het zag. Als dat helpt, zie ik dit algoritme als een tweefasig algoritme:
- Verdelingsfase, waar de array wordt verdeeld in kleinere arrays
- Sorteerfase, waar kleine arrays worden samengevoegd (door middel van samenvoegen) om een grotere array te vormen.
Verdelingsfase (Division phase)
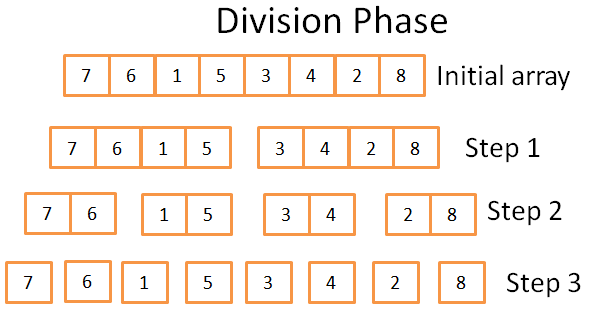
In de deel fase wordt de array in eenheidsarrays verdeeld in 3 stappen. Het formele aantal stappen is log(N) (aangezien N=8, log(N) = 3).
Hoe weet ik dit?
Ik ben een genie! Kortom — wiskunde. Het idee is dat elke stap de grootte van de oorspronkelijke array halveert. Het aantal stappen is het aantal keren dat je de oorspronkelijke array kunt splitsen in twee. Dit is de exacte definitie van een logaritme (met basis 2).
Sorteerfase (Sorting phase)
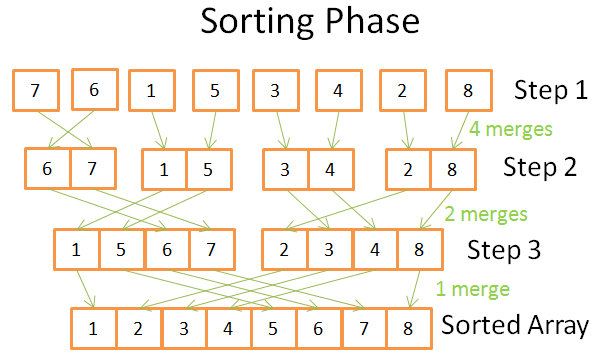
In de sorteerfase begin je met eenheids (één element) arrays. In elke fase pas je verschillende samenvoegoperaties toe, en de totale kosten bedragen N = 8 operaties:
- In de eerste fase heb je 4 samenvoegingen, die 2 operaties kosten elk
- In de tweede fase heb je 2 samenvoegingen, die 4 operaties kosten elk
- In de derde fase heb je 1 samenvoeging, die 8 operaties kost
Aangezien er log(N) stappen zijn, de totale kosten N * log(N) operaties.
Voordelen van merge sort
Waarom is dit algoritme zo krachtig?
Omdat:
- U kunt het aanpassen om het gebruik van geheugen te verminderen, zodat u geen nieuwe arrays maakt, maar direct de invoerarray wijzigt.
Opmerking: dit type algoritme wordt genoemd (sorteren zonder extra geheugen).
- U kunt het aanpassen voor gelijktijdig gebruik van schijfruimte en een klein geheugenverbruik zonder aanzienlijke kosten voor schijf in-/uitvoer. Het idee is om alleen die delen in het geheugen te laden die momenteel worden verwerkt. Dit is belangrijk wanneer u een tabel van enkele gigabytes wilt sorteren met een geheugenbuffer van slechts 100 megabyte.
Opmerking: dit type algoritme wordt genoemd .
- U kunt het aanpassen om op meerdere processen/thread's/servers uit te voeren.
Bijvoorbeeld, gedistribueerde mergesort is een van de belangrijkste componenten (wat een framework is in big data).
- Dit algoritme kan lood in goud veranderen (echt waar!).
Dit sorteeralgoritme wordt in de meeste (zo niet alle) databases gebruikt, maar het is niet de enige. Als u meer wilt weten, kunt u dit , dat de voor- en nadelen van veelvoorkomende sorteeralgoritmen in databases bespreekt.
Array, Boom en Hash-tabel
Nu we het idee van tijdcomplexiteit en sortering begrijpen, moet ik u informeren over 3 datastructuren. Dit is belangrijk omdat ze de basis zijn van moderne databases. Ik zal ook het concept introduceren van database-index.
Array
Een 2-dimensionale array is de eenvoudigste datastructuur. Een tabel kan worden beschouwd als een array. Bijvoorbeeld:
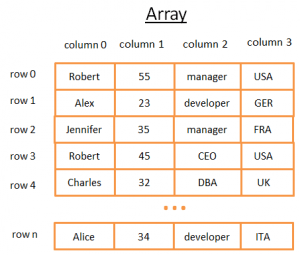
Deze 2-dimensionale array vertegenwoordigt een tabel met rijen en kolommen:
- Elke rij vertegenwoordigt een entiteit
- De kolommen bevatten eigenschappen die de entiteit beschrijven.
- Elke kolom bevat gegevens van een bepaald type (integer, string, datum ...).
Het is handig om gegevens op te slaan en te visualiseren, maar wanneer u een specifieke waarde wilt vinden, is dit niet ideaal.
Bijvoorbeeld, als u alle jongens wilt vinden die in het Verenigd Koninkrijk werken, moet u elke rij bekijken om te bepalen of die rij tot het Verenigd Koninkrijk behoort. Dit zal u N bewerkingen kosten., waar N — aantal rijen, wat goed is, maar kan er een snellere manier zijn? Het is tijd om ons te verdiepen in bomen.
Opmerking: de meeste moderne databases bieden uitgebreide arrays voor efficiënte opslag van tabellen: heap-georganiseerde tabellen en index-georganiseerde tabellen. Maar dit verandert niets aan het probleem van snel zoeken naar een bepaalde voorwaarde in een groep kolommen.
Boom en database-index
Een binaire zoekboom is een binaire boom met een speciale eigenschap: de sleutel in elke knoop moet zijn:
- groter dan alle sleutels die in de linkerknoop zijn opgeslagen
- kleiner dan alle sleutels die in de rechterknop zijn opgeslagen
Laten we eens kijken wat dit visueel betekent
Idee
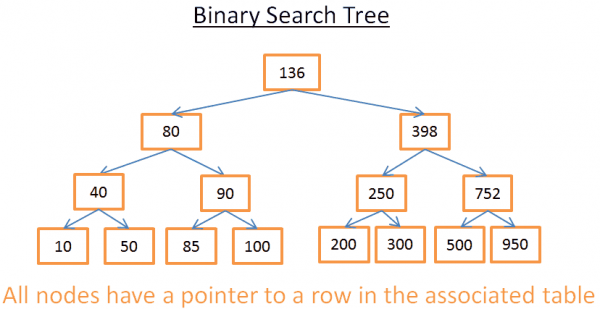
Deze boom heeft N = 15 elementen. Stel dat ik 208 zoek:
- Ik begin met de wortel, wiens sleutel 136 is. Aangezien 136 < 208, kijk ik naar de rechterknop van knoop 136.
- 398 > 208, dus kijk ik naar de linkerknoop van knoop 398
- 250 > 208, dus kijk ik naar de linkerknoop van knoop 250
- 200 < 208, dus kijk ik naar de rechterknop van knoop 200. Maar 200 heeft geen rechterknop, de waarde bestaat niet (want als het bestond, zou het in de rechterknop van 200 staan).
Laten we zeggen dat ik nu 40 zoek
- Ik begin met de wortel, wiens sleutel 136 is. Aangezien 136 > 40, kijk ik naar de linkerknoop van knoop 136.
- 80 > 40, dus kijk ik naar de linkerknoop van knoop 80
- 40= 40, de knoop bestaat. Ik haal de rij-ID binnen de knoop op (dit staat niet op de afbeelding) en kijk in de tabel voor de gegeven rij-ID.
- Door de rij-ID te kennen, kan ik precies weten waar de gegevens zich in de tabel bevinden, en dus kan ik ze direct ophalen.
Uiteindelijk kosten beide zoekopdrachten me het aantal niveaus binnen de boom. Als je aandachtig leest over de merge-sort, zou je moeten zien dat hier log(N) niveaus zijn. Dat betekent: de kosten van zoeken is log(N), niet slecht!
Laten we terugkeren naar ons probleem
Maar dit is heel abstract, dus laten we terugkeren naar ons probleem. In plaats van een eenvoudige integer, stel je een string voor die het land van iemand in de eerdere tabel vertegenwoordigt. Stel je voor dat je een boom hebt die het veld "country" (kolom 3) van de tabel bevat:
- Als je wilt weten wie er in het Verenigd Koninkrijk werkt
- kijk je naar de boom om de knoop te vinden die het Verenigd Koninkrijk vertegenwoordigt
- binnen "UKnode" vind je de locatie van de werknemersrecords in het Verenigd Koninkrijk.
Deze zoekopdracht kost log(N) bewerkingen in plaats van N bewerkingen als je een array direct zou gebruiken. Wat je net hebt gepresenteerd, was de database-index.
Je kunt een indexboom bouwen voor elke combinatie van velden (string, getal, 2 strings, getal en string, datum ...) zolang je een functie hebt om de sleutels (d.w.z. groepen velden) te vergelijken zodat je kunt bepalen de volgorde van de sleutels (wat het geval is voor elke basistype in de database).
B+TreeIndex
Hoewel deze boom goed werkt voor het ophalen van een specifieke waarde, is er een GROTE probleem wanneer je meerdere elementen tussen twee waarden wilt ophalen. Dit kost O(N) omdat je elke knoop in de boom moet bekijken en moet controleren of deze tussen de twee waarden ligt (bijvoorbeeld met een ordelijke doorloop van de boom). Bovendien is deze bewerking niet handig voor disk I/O, aangezien je de hele boom moet lezen. We moeten een manier vinden om intervallaanvragenefficiënt uit te voeren. Moderne databases gebruiken een gemodificeerde versie van de vorige boom genaamd B+Tree om dit probleem op te lossen. In een B+Tree:
- alleen de onderste knopen (bladeren) bewaren informatie (de locatie van rijen in de gekoppelde tabel)
- de andere knopen zijn hier voor routering naar de juiste knoop tijdens het zoeken.
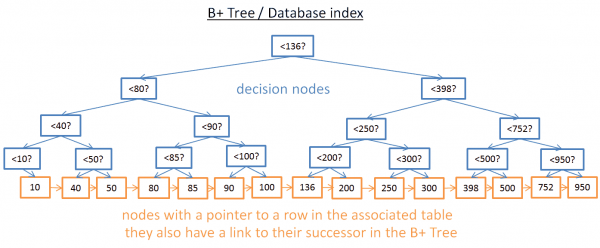
Zoals je kunt zien, zijn er hier meer knopen (twee keer zoveel). Inderdaad, er zijn extra knopen, 'besluitvormingsknopen', die je helpen de juiste knoop te vinden (die de locatie van rijen in de gekoppelde tabel opslaat). Maar de zoekcomplexiteit blijft nog steeds O(log(N)) (er is slechts nog een niveau). Het grote verschil is dat de knopen op het lagere niveau verbonden zijn met hun opvolgers.
Met deze B+Tree, als je zoekt naar waarden van 40 tot 100:
- Je hoeft alleen 40 te zoeken (of de dichtstbijzijnde waarde na 40, als 40 niet bestaat), zoals je deed met de vorige boom.
- Verzamel dan de opvolgers van 40 met directe verwijzingen naar de opvolgers totdat je 100 bereikt.
Stel dat je M opvolgers hebt gevonden en de boom N knopen heeft. Het zoeken naar een specifieke knoop kost log(N) zoals bij de vorige boom. Maar zodra je deze knoop hebt, ontvang je M opvolgers in M bewerkingen met verwijzingen naar hun opvolgers. Deze zoekopdracht kost slechts M+log(N) bewerkingen vergeleken met N bewerkingen met de vorige boom. Bovendien hoeft u de volledige boom niet te lezen (slechts M + log (N) knopen), wat betekent dat er minder schijfruimte wordt gebruikt. Als M klein is (bijvoorbeeld 200 regels) en N groot (1.000.000 regels), zal dit een GROOT verschil zijn.
Maar hier zijn er nieuwe problemen (weer!). Als je een regel aan de database toevoegt of verwijdert (en dus ook in de bijbehorende B+Tree-index):
- moet je de volgorde tussen de knopen binnen de B+Tree behouden, anders kun je de knopen binnen een ongeordende boom niet vinden.
- moet je het minimaal mogelijke aantal niveaus in de B+Tree behouden, anders wordt de tijdcomplexiteit in O (log (N)) O (N).
Met andere woorden, de B+Tree moet zelfordelijk en gebalanceerd zijn. Gelukkig is dit mogelijk met slimme verwijder- en invoegoperaties. Maar dit kost veel: invoegen en verwijderen in de B+Tree kost O (log (N)). Daarom hebben sommigen van jullie gehoord dat het gebruik van te veel indexen geen goed idee is.Inderdaad, vertraging bij het snel invoegen / bijwerken / verwijderen van een regel in de tabel,aangezien de database de indexen van de tabel moet bijwerken met de kostbare operatie O (log (N)) voor elke index. Bovendien betekent het toevoegen van indexen een grotere belasting voor de transactiemanager (wordt aan het einde van het artikel beschreven).
Voor meer gedetailleerde informatie kunt u het artikel op Wikipedia over bekijken. Als je een voorbeeld van een B+Tree-implementatie in een database wilt, kijk dan naar en de toonaangevende ontwikkelaar van MySQL. Ze zijn beide gefocust op hoe InnoDB (de MySQL-engine) indexen beheert.
Opmerking: een lezer vertelde me dat, vanwege laag-niveau optimalisaties, de B+Tree volledig gebalanceerd moet zijn.
Hashtable (Hash-tabel)
Onze laatste belangrijke datastructuur is de hash-tabel. Dit is zeer nuttig wanneer je snel waarden wilt zoeken. Bovendien zal het begrijpen van de hash-tabel ons later helpen om de algemene operatie van het verbinden met de database, die een hash-verbinding heet, te begrijpen ( hash join). Deze datastructuur wordt ook door de database gebruikt om enkele interne zaken op te slaan (bijvoorbeeld, lock table of buffer pool, we zullen beide concepten later zien).
Een hash-tabel is een gegevensstructuur die snel een element vindt op basis van zijn sleutel. Om een hash-tabel te bouwen, moet je bepalen:
- sleutel voor je elementen
- hashfunctie voor de sleutels. De berekende hashwaarden van de sleutels geven de locatie van de elementen aan (genaamd segmenten ).
- functie voor het vergelijken van sleutels. Zodra je het juiste segment hebt gevonden, moet je het element dat je zoekt binnen het segment vinden met deze vergelijking.
Een eenvoudig voorbeeld
Laten we een visueel voorbeeld nemen:
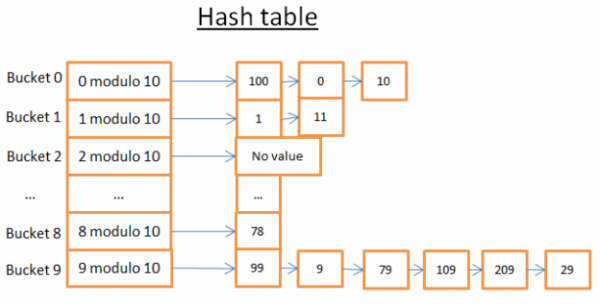
Deze hash-tabel heeft 10 segmenten. Aangezien ik lui ben, heb ik slechts 5 segmenten getekend, maar ik weet dat jullie slim zijn, dus laat ik jullie de andere 5 zelf voorstellen. Ik heb een hashfunctie gebruikt op basis van de modulo 10 van de sleutel. Met andere woorden, ik behoud alleen het laatste cijfer van de sleutel van het element om zijn segment te vinden:
- als het laatste cijfer 0 is, komt het element in segment 0,
- als het laatste cijfer 1 is, komt het element in segment 1,
- als het laatste cijfer 2 is, komt het element in segment 2,
- …
De vergelijkingsfunctie die ik heb gebruikt, is simpelweg gelijkheid tussen twee gehele getallen.
Stel dat je het element 78 wilt verkrijgen:
- De hash-tabel berekent de hashcode voor 78, wat gelijk is aan 8.
- De hash-tabel kijkt in segment 8, en het eerste element dat ze vindt, is 78.
- Ze geeft je het element 78 terug
- Het zoeken kost maar 2 bewerkingen (één voor het berekenen van de waarde van de hashfunctie, en de andere voor het zoeken van het element binnen het segment).
Stel nu dat je het element 59 wilt verkrijgen:
- De hash-tabel berekent de hashcode voor 59, wat gelijk is aan 9.
- De hash-tabel zoekt in segment 9, het eerste gevonden element is 99. Aangezien 99!=59, is element 99 niet het juiste element.
- Met dezelfde logica wordt het tweede element (9), het derde (79), …, het laatste (29) genomen.
- Element niet gevonden.
- Het zoeken kostte 7 bewerkingen.
Een goede hashfunctie
Zoals je kunt zien, is de kostprijs niet gelijk, afhankelijk van de waarde die je zoekt!
Als ik nu de hashfunctie wijzig naar modulo 1 000 000 van de sleutel (dat wil zeggen, de laatste 6 cijfers neem), kost de tweede zoekopdracht slechts 1 bewerking, omdat er geen elementen in segment 000059 zijn. De echte uitdaging is het vinden van een goede hashfunctie die segmenten genereert, die zeer weinig elementen bevatten..
In mijn voorbeeld is het gemakkelijk om een goede hashfunctie te vinden. Maar dit is een eenvoudig voorbeeld; het wordt moeilijker om een goede hashfunctie te vinden wanneer de sleutel:
- een string (bijvoorbeeld - achternaam)
- 2 strings (bijvoorbeeld - achternaam en voornaam)
- 2 strings en een datum (bijvoorbeeld - achternaam, voornaam en geboortedatum)
- …
Met een goede hashfunctie is de zoekoperatie in de hashtabel O(1).
Array vs hashtabel
Waarom niet gewoon een array gebruiken?
Hm, goede vraag.
- Een hashtabel kan deels in het geheugen zijn geladen,terwijl de overige segmenten op de schijf kunnen blijven.
- Met een array moet je gebruikmaken van een aaneengeschakeld geheugenpad. Als je een grote tabel laadt, is het heel moeilijk om genoeg aaneengeschakeld geheugen te vinden..
- Voor een hashtabel kun je de gewenste sleutel kiezen (bijvoorbeeld het land en de achternaam van de persoon).
Voor meer informatie kun je het artikel lezen over , wat een efficiënte implementatie van een hashtabel is; je hoeft Java niet te begrijpen om de concepten in dit artikel te begrijpen.
Bron: habr.com
