

Voorwoord
Er is een eenvoudige en zeer nuttige tool in de wereld — , en het is zo dat het al lange tijd ingeburgerd is in ons productieproces (hoewel het me niet gelukt is om de versie te installeren, maar die was zeker niet de laatste beschikbare). We gebruiken het voor het doel waarvoor het is gemaakt — het maken van binaire patches. Als je kijkt naar wat er in de repository is, dan word je een beetje treurig: in feite is het al lang geleden verlaten en is veel daarvan ernstig verouderd (onder andere heb ik een tijdje terug een paar aanpassingen gedaan met een voormalige collega, maar dat is al heel lang geleden). Kortom, ik besloot dit project weer leven in te blazen: ik heb een fork gemaakt, wat ik niet van plan ben te gebruiken weggegooid, en het project overgezet naar , ik heb 'hot' microfuncties ingelined, grote arrays van de stack verwijderd (en arrays van variabele lengte, waar ik oprecht 'last van heb'), en ik heb de profiler weer eens doorgelaten — en ontdekte dat ongeveer 40% van de tijd werd besteed aan …
Wat is er aan de hand met fwrite?
In deze code wordt fwrite (in mijn specifieke testgeval: het maken van een patch tussen twee vergelijkbare bestanden van 300 MB, waarbij de invoer volledig in het geheugen is) miljoenen keren aangeroepen met een kleine buffer. Het is duidelijk dat dit ding gaat vertragen, en daarom zou ik op de een of andere manier op deze ellende willen inwerken. Ik heb voorlopig geen zin om allerlei datastromen of asynchrone invoer/uitvoer te implementeren, ik wilde een eenvoudigere oplossing vinden. Het eerste wat in me opkwam was om de buffergrootte te vergroten
setvbuf(file, nullptr, _IOFBF, 64* 1024)maar ik kreeg niet echt een verbetering van het resultaat (nu werd er ongeveer 37% van de tijd aan fwrite besteed) — dat betekent dat het probleem toch niet ligt in het vaak opslaan van gegevens op de schijf. Door 'onder de motorkap' van fwrite te kijken, kun je zien dat er binnenin een lock/unlock van de FILE-structuur ongeveer zo gebeurt (pseudocode, de hele analyse is gedaan onder Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Als we de profiler geloven, wordt er maar 6% van de tijd aan _fwrite_nolock besteed, de rest is overhead. In mijn specifieke geval is thread-safety een duidelijke overbodigheid, die ik zal opgeven door de aanroep van fwrite te vervangen door — je hoeft zelfs niet te rommelen met argumenten. Kortom: deze eenvoudige manipulatie heeft de kosten voor het schrijven van het resultaat drastisch verlaagd, die in de oorspronkelijke variant bijna de helft van de tijd kosten besloegen. Overigens, in de wereld van POSIX bestaat er een soortgelijke functie — . Over het algemeen geldt hetzelfde voor fread. Op deze manier kan je met een paar #define een vrij platformonafhankelijke oplossing krijgen zonder onnodige blokkeringen als die niet nodig zijn (wat inderdaad vaak het geval is).
fwrite, _fwrite_nolock, setvbuf
Laten we ons abstraheren van het originele project en ons richten op het testen van een specifiek geval: het schrijven van een groot bestand (512 MB) in extreem kleine porties — van 1 byte. Test systeem: AMD Ryzen 7 1700, 16 GB RAM, HDD 7200 rpm 64 MB cache, Windows 10 1809, het binaire bestand werd in 32-bit gecompileerd, optimalisaties zijn ingeschakeld, de bibliotheek is statisch gelinkt.
Voorbeeld voor het uitvoeren van het experiment:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
De variabelen zullen TEST_BUFFER_SIZE zijn, en voor een paar gevallen vervangen we fwrite_unlocked door fwrite. Laten we beginnen met het geval fwrite zonder expliciete buffer grootte (we commentariëren setvbuf en de gerelateerde code uit): tijd 27048906 µs, schrijfsnelheid — 18.93 MB/s. Nu stellen we de buffer grootte in op 64 KB: tijd — 25037111 µs, snelheid — 20.44 MB/s. Laten we nu de werking van _fwrite_nolock testen zonder setvbuf aan te roepen: 7262221 µs, snelheid — 70.5 MB/s!
Laten we verder experimenteren met de buffer grootte (setvbuf):
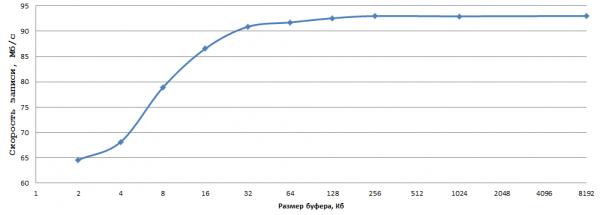
De gegevens zijn verkregen door het middelen van 5 experimenten, ik had geen zin om de foutmarges te berekenen. Voor mij is 93 MB/s bij het schrijven van 1 byte op een gewone HDD een zeer goed resultaat, je moet gewoon de optimale buffer grootte kiezen (in mijn geval 256 KB — precies goed) en fwrite vervangen door _fwrite_nolock/fwrite_unlocked (tenzij je natuurlijk thread-veiligheid nodig hebt).
Evenzo met fread onder dergelijke omstandigheden. Aangezien ik geen 'hardware'-machine met Linux bij de hand heb (single-board computers tellen niet mee), besloot ik een beperkt experiment uit te voeren op een virtuele machine (Hyper-V, OpenSUSE 15, GCC 8.3.1) — de patroon is in principe hetzelfde: 'pure' fwrite 20 MB/s, fwrite + buffer van 256 KB gaf 23 MB/s, fwrite_unlocked met dezelfde buffer — 35 MB/s (het binaire bestand was 64-bit, gecompileerd met g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Naschrift
Het doel van dit artikel is om een eenvoudige en effectieve werkwijze te beschrijven (met de functies _fwrite_nolock/fwrite_unlocked ben ik eerder niet in aanraking gekomen, ze zijn niet zo populair - en dat is zonde). Ik pretends niet dat het materiaal nieuw is, maar ik hoop dat het artikel nuttig zal zijn voor de gemeenschap.
Bron: habr.com
