

Hallo allemaal.
Ik ben een Linux-systeembeheerder, verhuisd vanuit Rusland naar Australië met een onafhankelijke professionele visum in 2015, maar dit artikel gaat niet over hoe een biggetje een tractor kan kopen. Dergelijke artikelen zijn al genoeg aanwezig (maar als er interesse is, kan ik daar ook over schrijven). Ik wil graag vertellen over hoe ik op mijn werk in Australië als Linux-ops-engineer het initiatief nam voor de migratie van het ene monitoringssysteem naar het andere. Concreet: Nagios => Icinga2.
Het artikel is deels technisch en deels over het communiceren met mensen en de problemen die voortkomen uit culturele verschillen en werkmethoden.
Helaas markeert de tag «code» geen Puppet- en YAML-code, dus moest ik «plaintext» gebruiken.
Niets wees er op dat er die dag iets mis zou gaan op de ochtend van 21 december 2016. Zoals gewoonlijk las ik Habr anoniem in de eerste dertig minuten van mijn werkdag, terwijl ik koffie dronk en stuitte op .
Aangezien mijn bedrijf Nagios gebruikte, creëerde ik zonder enige aarzeling een ticket in Redmine en deelde de link in de algemene chat, omdat ik het belangrijk vond. Initiatief wordt zelfs in Australië bestraft, dus de hoofdingenieur legde dit probleem bij mij, aangezien ik het had ontdekt.
Screenshot van Redmine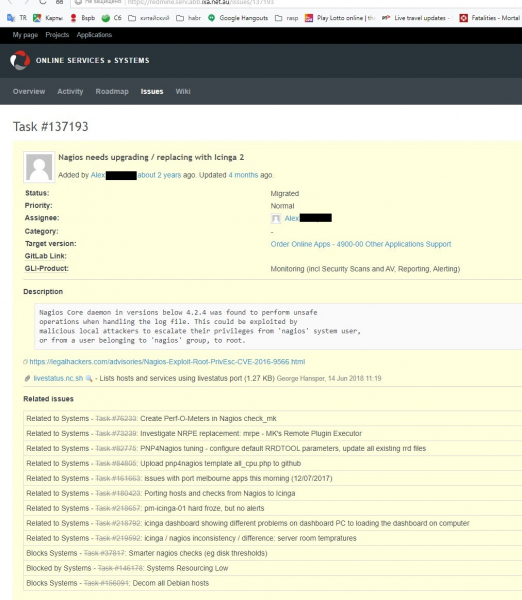
In onze afdeling is het gebruikelijk om minstens één alternatief voor te stellen, zelfs als de keuze duidelijk is, dus begon ik met googelen welke monitoringsystemen momenteel relevant zijn, aangezien ik in mijn laatste functie in Rusland mijn eigen primitieve, maar functionele zelfgebouwde monitoringsysteem had. Python, de Polytechnische Universiteit van Sint-Petersburg en de metro zijn de besten. Nee, de metro is waardeloos. Dit is persoonlijk (11 jaar ervaring) en verdient een apart artikel, maar niet nu.
Een beetje over de regels voor het aanbrengen van wijzigingen in de infrastructuurconfiguratie op mijn huidige werkplek. We gebruiken Puppet, Gitlab en het principe van Infrastructure as Code, dus:
- Geen handmatige wijzigingen via SSH door handmatige wijzigingen van bestanden op virtuele machines. In drie jaar tijd heb ik hier vaak problemen mee gehad, de laatste keer een week geleden en ik denk niet dat dit de laatste keer was. Maar echt — één regel in de configuratie aanpassen, de service opnieuw starten en kijken of het probleem is opgelost — 10 seconden. Een nieuwe branch in Gitlab aanmaken, de wijzigingen pushen, wachten tot r10k draait op Puppetmaster, Puppet starten —environment=mybranch en nog een paar minuten wachten tot alles klaar is — minimaal 5 minuten.
- Alle wijzigingen worden aangebracht door een Merge Request in Gitlab aan te maken en goedkeuring van minimaal één teamlid is noodzakelijk. Serieuze wijzigingen vereisen goedkeuring van twee of drie teamleden volgens de beslissing van de teamleider.
- Alle wijzigingen zijn op de een of andere manier tekstueel (aangezien Puppet-manifesten, scripts en Hiera-gegevens tekst zijn), binaire bestanden worden sterk afgeraden en goedkeuring voor dergelijke bestanden vereist goede redenen.
Dus, de opties die ik heb overwogen:
- Munin — als er meer dan 10 servers in de infrastructuur zijn, wordt het beheer een hel (uit . Ik had er niet veel zin in om dit te controleren, dus ik geloofde het maar).
- Zabbix — ik had er al een tijd naar gekeken, zelfs in Rusland, maar toen was het te veel voor mijn taken. Hier moest ik het laten varen vanwege het gebruik van Puppet als configuratiebeheerder en Gitlab als versiebeheersysteem. Op dat moment, voor zover ik begreep — Zabbix slaat de hele configuratie op in een database, waardoor het onduidelijk was hoe de configuratie in de huidige omstandigheden kon worden beheerd en hoe veranderingen konden worden gevolgd.
- Prometheus — dat is waar we uiteindelijk naartoe zullen gaan, gezien de stemming in de afdeling, maar op dat moment kon ik het niet aan en kon ik geen echt werkend voorbeeld (Proof of Concept) tonen, dus moest ik het laten varen.
- Er waren ook enkele andere opties, die ofwel een volledige herontwikkeling van het systeem vereisten, ofwel in een embryonale staat verkeren / afgewezen zijn en om die reden zijn verworpen.
Uiteindelijk heb ik gekozen voor Icinga2 om drie redenen:
1 — compatibiliteit met Nrpe (de clientdienst die controles voert op commando's van Nagios). Dit was erg belangrijk, omdat we op dat moment 135 (nu in 2019 zijn het er 165) virtuele machines hadden met een hoop zelfgemaakte services/controles en het alles opnieuw doen zou een enorme hoofdpijn zijn geweest.
2 — alle configuratiebestanden zijn tekstbestanden, wat het eenvoudig maakt om dit aan te passen, merge requests te maken en te zien wat is toegevoegd of verwijderd.
3 — dit is een levend en groeiend OpenSource-project. We zijn groot voorstander van OpenSource en dragen ons steentje bij door het creëren van Pull Requests en Issues om problemen op te lossen.
Dus, laten we beginnen met Icinga2.
Het eerste waarmee ik geconfronteerd werd, was de inertie van mijn collega’s. Iedereen was gewend aan Nagios/Nadgios (hoewel we zelfs hier niet konden komen tot een compromis over hoe we het moesten uitspreken) en de interface van CheckMK. De interface van Icinga ziet er totaal anders uit (dat was een nadeel), maar je hebt de mogelijkheid om flexibel in te stellen wat je precies wilt zien met filters op vrijwel elke parameter (dat was een voordeel, maar daar heb ik best voor moeten vechten).
Filters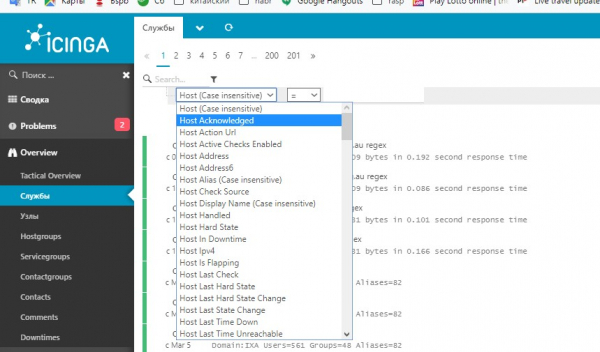
Beoordeel de verhouding van de scrollbalkgrootte tot de grootte van het scrolveld.
Ten tweede — iedereen was gewend om de hele infrastructuur op één monitor te zien, omdat CheckMk de mogelijkheid biedt om met meerdere Nagios-hosts te werken, maar de interface van Icinga kon dat niet (het kon het in werkelijkheid wel, maar daarover later meer). Een alternatief was iets dat Thruk heette, maar het ontwerp ervan wekte kokhalsneigingen op bij alle teamleden, behalve één — degene die het voorstelde (niet ik).
Thruk kan in de prullenbak — unanieme beslissing van het team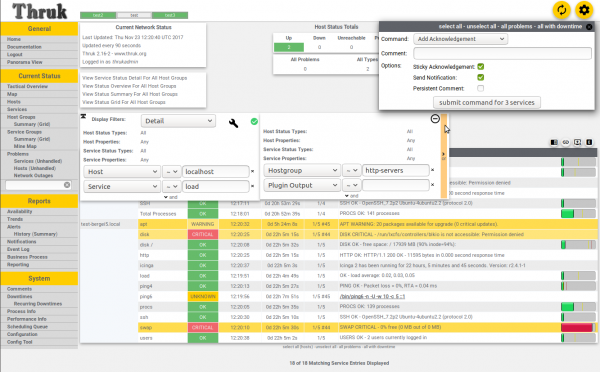
Na een paar dagen van brainstorming stelde ik het idee voor van clusterbewaking, waarbij er één masterhost in de productiezone is en twee ondergeschikten – één in dev/test en één externe host, gevestigd bij een andere provider, met als doel onze diensten te monitoren vanuit het perspectief van de klant of een buitenstaander. Deze configuratie maakte het mogelijk om alle problemen in één webinterface te zien en werkte heel goed, maar Puppet... Het probleem met Puppet was dat de masterhost nu op de hoogte moest zijn van alle hosts en diensten/checks in het systeem en deze moest verdelen over de zones (dev-test, staging-prod, ext), maar het verzenden van wijzigingen via de Icinga API duurt een paar seconden, terwijl het compileren van de Puppet-catalogus voor alle diensten voor alle hosts een paar minuten in beslag neemt. Dit wordt me nog steeds verweten, hoewel ik al meerdere keren heb uitgelegd hoe alles werkt en waarom het zo lang duurt.
Derde punt – een hoop SnowFlakes (sneeuwvlokken) – dingen die uit het algemene systeem vallen omdat ze iets bijzonders hebben, waardoor de algemene regels niet van toepassing zijn. Dit werd opgelost door een frontale aanval – als er waarschuwingen zijn, maar alles in feite in orde is, dan moet je dieper graven en uitzoeken waarom het alarm afgaat, terwijl dat niet zou moeten. Of, andersom – waarom Nagios in paniek raakt, terwijl Icinga dat niet doet.
Vierde punt – Nagios werkte hier drie jaar voor mij en had aanvankelijk meer vertrouwen dan mijn hipsterachtige nieuwe systeem, dus elke keer als Icinga paniek veroorzaakte, deed niemand iets totdat Nagios hetzelfde probleem aan de orde stelde. Maar heel zelden gaf Icinga echte waarschuwingen eerder dan Nagios en ik beschouw dit als een serieus probleem, waarover ik zal vertellen in de sectie 'Conclusies'.
Uiteindelijk duurde de implementatie meer dan 5 maanden (oorspronkelijk gepland voor 28 juni 2018, in werkelijkheid 3 december 2018), voornamelijk vanwege de 'parity check' – dat probleem waarbij er verschillende diensten in Nagios zijn waar niemand de laatste paar jaar iets van heeft gehoord, maar JUIST NU geven ze, verdorie, crit zonder enige reden en moest ik uitleggen waarom ze niet op mijn paneel staan en moest ik ze toevoegen aan Icinga, zodat 'de parity check compleet is' (alle diensten/checks in Nagios komen overeen met de diensten/checks in Icinga).
Implementatie:
Ten eerste — de strijd tussen Code en Data, in Puppet-stijl. Alle gegevens, echt alles, moeten in Hiera staan en op geen andere manier. Alle code staat in .pp-bestanden. Variabelen, abstracties, functies — alles gaat in pp.
Uiteindelijk hebben we een heleboel virtuele machines (165 op het moment van schrijven) en 68 webapplicaties die gemonitord moeten worden op hun functionaliteit en de geldigheid van SSL-certificaten. Maar door historische problemen komen de informatie voor het monitoren van de applicaties uit een aparte gitlab-repository en is het gegevensformaat sinds Puppet 3 niet veranderd, wat extra complicaties in de configuratie met zich meebrengt.
Puppet-code voor applicaties, bescherm je ogen
definieer profielen::diensten::bewaking::docker_apps(
  Hash $app_lijst,
  Hash $toegang_apps_van,
  Hash $apps_toegangs_lijst,
  Hash $webhost_standaarden,
  Hash $webcheck_standaarden,
  Hash $dienst_overschrijvingen,
  Hash $doelgroepen,
  Hash $app_controles,
  )
{
#### APPS ####
  $zone = $naam
  $app_lijst.elke | String $app_naam, Hash $app_data |
  {

    $meld_groep = { 'meld_groep' => ($webcheck_standaarden[$zone]['meld_groep'] + pick($app_data['meld_groep'], {} )) } # voegt meldingen toe voor de standaardgroep (systemen) + elke groep gedefinieerd in int/pm_docker_apps.eyaml

    $data = merge($webhost_standaarden, $toegang_apps_van, $app_data)

    $site_domein = $app_data['site_domein']

    $regexp = pick($app_data['controle_regex'], 'html')        # Kies een regex om te controleren

    $controle_url = $app_data['controle_url'] ? {
      undef   => { 'http_uri' => '\/ ' },
      standaard => { 'http_uri' => $app_data['controle_url'] }
    }

    $controle_regex = $regexp ?{
      'afwezig' => {},
      standaard  => {'http_verwacht_body_regex' => $regexp}
    }

    $site_domein.elke | String $vhost, Hash $vdata | {        # Split een app op domeinen indien er twee of meer zijn
      $vhost_naam = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_naam + $controle_regex + $controle_url

      $web_ipadres = is_array($vdata['web_ipadres']) ? {  # Maak IP-adres een array indien dit niet het geval is, omdat askizzy 2 ips heeft en het een array is
        waar  => $vdata['web_ipadres'],
        niet_waar => [$vdata['web_ipadres']],
      }

      $toegang_van_zones = [$zone] + $apps_toegangs_lijst[$data['toegankelijk_van']] # Voeg standaardzone (waar de app is gedefinieerd) en extra zones toe indien ze bestaan
      $web_ipadres.elke | String $ip_adres | {            # Voor elk IP (als we meerdere hebben)
        $suffix = length($web_ipadres) ? {                  # Als we meer dan één hebben - voeg IP toe als een suffix aan deze hostnaam om duplicatie van middelen te voorkomen
          1       => '',
          standaard => "_${ip_adres}"
        }
        $octets = split($ip_adres, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Het gebruik van de laatste octet zorgt voor een botsing tussen nginx-vip 203.15.70.94 en ext. ip 49.255.194.94

        $toegang_van_zones.elke | $zone_prefix |{
          $zone_doel = $doelgroepen[$zone_prefix]

          $nginx_vip_naam = "${zone_prefix}_nginx-vip-${ip_tag}" # Als het een host voor ext is - wordt de prefix 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_naam => {
              zorg ervoor        => aanwezig,
              doel        => $zone_doel,
              adres       => $ip_adres,
              controle_opdracht => 'hostalive',
              groepen        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_controles['ssl']
          $regex_vars = $app_controles['http'] + $vars + $webcheck_standaarden[$zone] + $meld_groep

          if !gedefinieerd( Profielen::Diensten::Bewaking::Host[$nginx_vip_naam] ) {
          zorg ervoor_middelen('profielen::diensten::bewaking::host', $nginx_host_vip)
          }

          if !gedefinieerd( Icinga2::Object::Dienst["${nginx_vip_naam}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_naam}_ssl":
              zorg ervoor         => $data['zorg ervoor'],
              toewijzen         => ["host.naam == $nginx_vip_naam",],
              groepen         => ['webchecks',],
              controle_opdracht  => 'ssl',
              controle_interval => $dienst_overschrijvingen['ssl']['controle_interval'],
              doel         => $doelgroepen['diensten'],
              toepassen          => waar,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'afwezig'{
            if !gedefinieerd(Icinga2::Object::Dienst["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                zorg ervoor          => $data['zorg ervoor'],
                toewijzen          => ["match(*_nginx-vip-${ip_tag}, host.naam)",],
                groepen          => ['webchecks',],
                controle_opdracht   => 'http',
                controle_interval  => $dienst_overschrijvingen['regex']['controle_interval'],
                doel          => $doelgroepen['diensten'],
                inschakelen_hapering => waar,
                toepassen           => waar,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
De configuratiecode van hosts en services ziet er ook vreselijk uit:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # zal worden ingeschakeld wanneer we volledig naar icinga overgaan
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Zorg ervoor dat de node het $location feit is ingesteld (int, pm, ext)')
    }
  }

  file { '\/etc\/icinga2\/conf.d\/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"\/etc\/icinga2\/conf.d\/${file_name}":
      ensure => present,
      source => "puppet:\/\/modules\/profiles\/services\/monitoring\/default_config\/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # Dit is voor ruimteschipinvasie wanneer deze klaar is.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Splits de site-lijsten op in hostgroepen - docker_host\/gluster_host\/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Splits de grouplijsten op in hosts
      # Is deze host in de array $hosts_has_large_disks ? Als dat zo is, stel dan host.vars.has_large_disks in
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Merging vars afzonderlijk

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Alle hosts beheerd door API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Split api hosts op in zones
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Splits de site-lijsten op in hostgroepen - docker_host\/gluster_host\/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Splits de grouplijsten op in hosts
          # Is deze host in de array $hosts_has_large_disks ? Als dat zo is, stel dan host.vars.has_large_disks in
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}\/${zone}\/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### EINDE VAN HOSTS ####

####   SERVICES   ####

  $services.each | String $service_group, Hash $s_list |{             # Service_group en lijst van services in die groep
    $service_list = $s_list['checks']                                 # Lijst van daadwerkelijke controles, apart van SG instellingen
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # globale servicedefaults + servicegroepinstellingen
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Als we de standaard check_timeout overschrijven, maar niet nrpe_timeout, maak nrpe_timeout dezelfde als check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga converteert 1m automatisch naar 60!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Standaard gebruiken we nrpe en alle opdrachten worden via nrpe uitgevoerd. Dus vars.nrpe_command = $service_name is een standaardwaarde
      # Als het server-side Icinga-opdracht is - hebben we 'nrpe_command' niet nodig
      # maar er is geen schade om die variabele te hebben en de code is korter

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Assembleren $vars van globale standaard service-instellingen, servicegroepinstellingen, deze specifieke check-instellingen en laten we de nrpe-instellingen niet vergeten.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick is overal vereist, anders ontstaat er "De waarde '' kan niet worden geconverteerd naar Numeric"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Ken de standaardgroep toe (systemen) als er geen andere groepen zijn gedefinieerd

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Dit moet afzonderlijk worden samengevoegd, omdat we het als onderdeel van MERGED_DATA samenvoegen, arrays in plaats van ze samen te voegen, waardoor we enkele "toewijzen" en "negeren" waarden verliezen

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### EINDE VAN SERVICES ####

#### ANDERE SAUW ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Merging meldinstellingen voor gebruikers met andere instellingen
  $users_oncall = deep_merge($users, $oncall)
  # Magie. Niet aanraken.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles\/os\/redhat\/centos7\/sudoers\/icinga.erb',
  }

}
Ik werk nog steeds aan deze code en verbeter deze waar mogelijk. Maar het is precies deze code die het mogelijk maakte om een eenvoudige en duidelijke syntaxis in Hiera te gebruiken:
Gegevens
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Alle controles zijn opgedeeld in groepen, waarbij elke groep standaardinstellingen heeft voor waar en hoe vaak deze controles worden uitgevoerd, welke meldingen moeten worden verzonden en aan wie.
Bij elke controle kunnen alle opties worden overschreven en wordt dit uiteindelijk gecombineerd met de standaardinstellingen voor alle controles in zijn geheel. Daarom lijkt de config.pp-code zo complex — daar vindt een samensmelting van alle standaardinstellingen met de groepsinstellingen en vervolgens met elke individuele controle plaats.
Daarnaast is een zeer belangrijke verandering de mogelijkheid om functies in de instellingen te gebruiken, bijvoorbeeld een functie om de poort, het adres en de URL voor http_regex te vervangen.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Dit betekent — als er in de hostdefinitie een variabele is http_port — gebruik deze, anders 443. Bijvoorbeeld, de webinterface van jabber draait op 9090, terwijl Unifi draait op 7443.
http_vhost betekent dat DNS wordt genegeerd en dat dit adres moet worden gebruikt.
Als in de host een uri is opgegeven — volg deze, anders gebruik "\/".
Er kwam een grappig verhaal naar voren met http_ssl — deze functie wilde gewoon niet worden uitgeschakeld op verzoek. Ik heb lang naar deze regel gekeken, totdat ik me realiseerde dat de variabele in de hostdefinitie was:
http_ssl: falseWordt ingevoerd in de uitdrukking
if(host.vars.http_ssl) { return false } else { return true }hoe false en uiteindelijk krijgen we
if(false) { return false } else { return true }dat wil zeggen dat de ssl-controle altijd actief is. Dit werd opgelost door de syntaxis te vervangen:
http_ssl: noConclusies:
Voordelen:
- We hebben nu één monitoringsysteem in plaats van twee, zoals de afgelopen 7-8 maanden, of eentje, verouderd en kwetsbaar.
- De datastructuur van hosts/services (controles) is nu (naar mijn mening) veel leesbaarder en begrijpelijker. Voor anderen bleek het minder duidelijk, dus heb ik een paar pagina's op de lokale wiki gemaakt om uit te leggen hoe alles werkt en waar je wat moet aanpassen.
- Er is de mogelijkheid tot flexibele configuratie van controles met behulp van variabelen en functies, bijvoorbeeld voor het controleren van http_regexp kan het vereiste patroon, de statuscode, url en poort in de hostinstellingen worden opgegeven.
- Er zijn verschillende dashboards, waarvoor je elke keer een eigen lijst van weergegeven waarschuwingen kunt definiëren en alles via Puppet en merge requests kunt beheren.
Nadelen:
- De traagheid van teamleden — Nagios werkte, werkte en werkte, terwijl jouw Icinga constant vastloopt en traag is. Hoe kan ik de geschiedenis bekijken? Oh, verrek, die wordt niet automatisch vernieuwd... (Echt probleem — de geschiedenis van waarschuwingen wordt alleen bijgewerkt bij een F5)
- De traagheid van het systeem — als ik in de webinterface op 'nu controleren' (check now) klik, hangt het resultaat af van het weer op Mars, vooral bij complexe diensten die tientallen seconden nodig hebben om uit te voeren. Zo'n resultaat is normaal.

- Over het algemeen, als ik kijk naar de halfjaarlijkse statistieken van de werking van de twee systemen naast elkaar, werkte Nagios altijd sneller dan Icinga en dat irriteert me enorm. Het lijkt erop dat ze iets hebben geknoeid met de timers en dat de controle elke vijf minuten in feite om de 5:30 gaat of iets dergelijks.
- Als je de service op elk moment opnieuw opstart (systemctl restart icinga2) — zullen alle controles die op dat moment in uitvoering zijn, de melding critical op het scherm tonen en van de buitenkant lijkt het alsof alles helemaal is ingestort ().
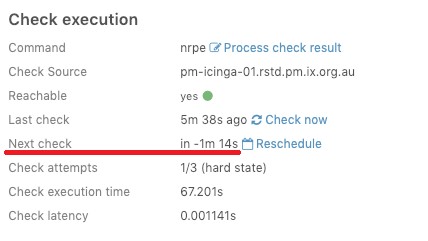
Maar over het algemeen — het werkt.
Bron: habr.com
