

Ik stuitte op interessant materiaal over kunstmatige intelligentie in games. Met een uitleg van de basisprincipes van AI aan de hand van eenvoudige voorbeelden, en bovendien vol handige tools en methoden voor een gemakkelijke ontwikkeling en ontwerp. Hoe, waar en wanneer ze te gebruiken, is ook besproken.
De meeste voorbeelden zijn geschreven in pseudocode, dus diepgaande programmeerkennis is niet vereist. Hieronder staat 35 pagina's tekst met afbeeldingen en GIF's, dus bereid je voor.
UPD. Sorry, maar ik heb deze artikel al vertaald op Habra. . Je kunt zijn versie lezen , maar om de een of andere reden is het artikel aan me voorbij gegaan (ik heb het met de zoekfunctie geprobeerd, maar iets ging mis). Aangezien ik in een blog schrijf dat gewijd is aan gameontwikkeling, besloot ik mijn versie van de vertaling voor mijn volgers achter te laten (sommige punten zijn anders gepresenteerd, andere zijn op advies van de ontwikkelaars opzettelijk weggelaten).
Wat is AI?
Gaming AI richt zich op de acties die een object moet ondernemen, afhankelijk van de omstandigheden waarin het zich bevindt. Dit wordt meestal 'beheer van intelligente agenten' genoemd, waarbij een agent een gamepersonage, voertuig, bot, en soms iets meer abstracts kan zijn: een hele groep entiteiten of zelfs een beschaving. In elk geval is het iets dat zijn omgeving moet waarnemen, op basis daarvan beslissingen moet nemen en volgens die beslissingen moet handelen. Dit heet de Sense/Think/Act cyclus (Waarnemen/Denken/Handelen):
- Sense: de agent verzamelt of ontvangt informatie over dingen in zijn omgeving die invloed kunnen hebben op zijn gedrag (dreigingen in de buurt, verzamelbare objecten, interessante plekken om te verkennen).
- Think: de agent beslist hoe te reageren (overweegt of het veilig genoeg is om items te verzamelen of dat hij eerst moet vechten/verstoppen).
- Act: de agent onderneemt acties om de eerdere beslissing uit te voeren (begint te bewegen naar de tegenstander of het object).
- …nu is de situatie veranderd door de acties van de personages, waardoor de cyclus zich herhaalt met nieuwe gegevens.
AI concentreert zich doorgaans op het Sense-gedeelte van de cyclus. Bijvoorbeeld, autonome voertuigen maken opnames van de weg, combineren deze met gegevens van radar en lidar, en interpretereren deze. Dit wordt meestal gedaan door machine learning, dat de binnenkomende gegevens verwerkt en betekenis geeft, door semantische informatie te extraheren zoals "er is een andere auto 20 meter voor je". Dit zijn zogenaamde classificatieproblemen.
Spellen hebben geen gecompliceerd systeem nodig om informatie te extraheren, aangezien het grootste deel van de gegevens al een integraal onderdeel ervan is. Het is niet nodig om algoritmen voor beeldherkenning te draaien om te bepalen of er een vijand voor je is — het spel weet dat al en geeft informatie direct door in het besluitvormingsproces. Daarom is het onderdeel van de Sense-cyclus vaak veel eenvoudiger dan Think en Act.
Beperkingen van game AI
AI heeft een aantal beperkingen waaraan moet worden voldaan:
- AI hoeft niet van tevoren te worden getraind, zoals bij een machine learning-algoritme. Het is zinloos om een neuraal netwerk in de ontwikkelingsfase te schrijven om tientallen duizenden spelers te observeren en de beste manier van spelen tegen hen te leren. Waarom? Omdat het spel nog niet is uitgebracht, en er zijn geen spelers.
- Het spel moet vermaken en een uitdaging vormen, daarom mogen agenten niet de beste aanpak tegen mensen vinden.
- Agenten moeten er realistisch uitzien, zodat spelers het gevoel hebben tegen echte mensen te spelen. Het AlphaGo-programma overtrof de mens, maar de gekozen stappen waren ver weg van het traditionele begrip van het spel. Als het spel een menselijke tegenstander imiteert, mag dat gevoel er niet zijn. Het algoritme moet worden aangepast zodat het plausibele beslissingen neemt, niet perfecte.
- AI moet in realtime werken. Dit betekent dat het algoritme de CPU niet langdurig kan monopolizeren voor besluitvorming. Zelfs 10 milliseconden daarvoor is te lang, omdat de meeste spellen tussen de 16 en 33 milliseconden nodig hebben om de volledige verwerking uit te voeren en naar de volgende grafische frame over te gaan.
- Idealiter wordt ten minste een deel van het systeem door gegevens aangestuurd, zodat 'niet-programmeurs' wijzigingen kunnen aanbrengen en aanpassingen sneller plaatsvinden.
Laten we de AI-benaderingen bekijken die de hele cyclus Sense/Think/Act bestrijken.
Basic decision-making
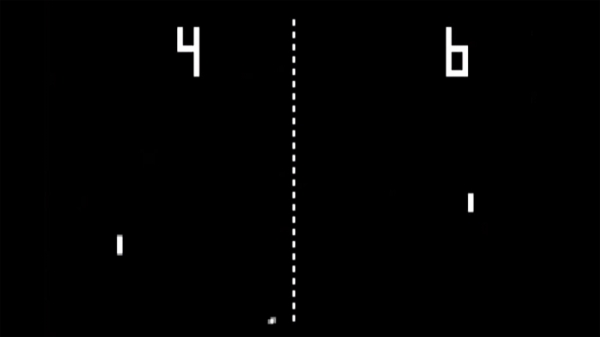
Laten we beginnen met het eenvoudigste spel: Pong. Doel: verplaats het platform (paddle) zodat de bal ervan kan stuiteren en niet er langs kan vliegen. Dit is als tennis, waarin je verliest als je de bal niet terugslaat. Voor de AI is de taak relatief eenvoudig: bepalen in welke richting het platform moet worden verplaatst.
Voorwaardelijke operators
Voor de AI in Pong is er een duidelijke oplossing: altijd proberen het platform onder de bal te plaatsen.
Een eenvoudig algoritme hiervoor, geschreven in pseudocode:
elke frame/update terwijl het spel loopt:
als de bal links van de paddle is:
verplaats paddle naar links
anders als de bal rechts van de paddle is:
verplaats paddle naar rechts
Als het platform met de snelheid van de bal beweegt, is dit het ideale algoritme voor de AI in Pong. Je hoeft het niet ingewikkelder te maken, als er niet veel gegevens en mogelijke acties voor de agent zijn.
Deze aanpak is zo eenvoudig dat de hele cyclus Sense/Think/Act nauwelijks merkbaar is. Maar hij is er:
- De Sense-gedeelte bevindt zich in de twee if-operators. Het spel weet waar de bal is en waar het platform is, dus de AI vraagt deze informatie op.
- Het Think-gedeelte bestaat ook uit twee if-operators. Deze vertegenwoordigen twee beslissingen die in dit geval elkaar uitsluiten. Als resultaat wordt een van de drie acties gekozen: verplaats het platform naar links, verplaats het naar rechts, of doe niets als het al goed is gepositioneerd.
- De Act-gedeelte bevindt zich in de operators Move Paddle Left en Move Paddle Right. Afhankelijk van het ontwerp van het spel kunnen ze het platform onmiddellijk of met een bepaalde snelheid verplaatsen.
Dergelijke benaderingen worden reagerend genoemd - er zijn eenvoudige regels (in dit geval de if-operators in de code) die reageren op de huidige staat van de wereld en handelen.
Beslissingsboom
Het voorbeeld met het spel Pong is feitelijk gelijk aan het formele concept van AI dat een beslissingsboom wordt genoemd. Het algoritme doorloopt deze om een 'blad' te bereiken - een beslissing over welke actie te ondernemen.
Laten we een stroomdiagram maken van de beslissingsboom voor ons platformalgoritme:
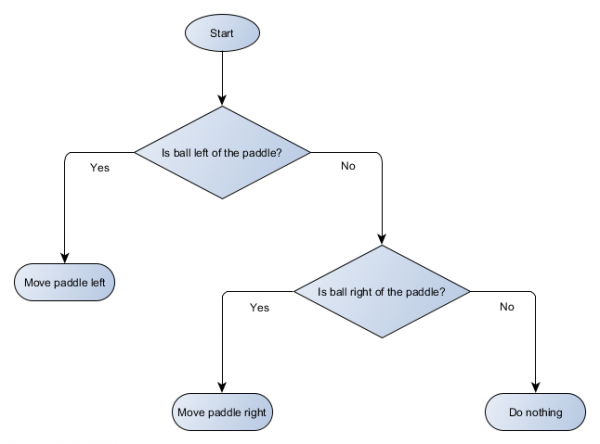
Elke deel van de boom wordt een node (knoop) genoemd - de AI gebruikt grafentheorie om dergelijke structuren te beschrijven. Er zijn twee soorten knopen:
- Beslissingsknopen: een keuze maken tussen twee alternatieven op basis van de controle van een bepaalde voorwaarde, waarbij elk alternatief als een afzonderlijke knoop wordt gepresenteerd.
- Eindknopen: actie om uit te voeren, wat de definitieve beslissing vertegenwoordigt.
Het algoritme begint bij de eerste knoop ('wortel') van de boom. Het neemt ofwel een beslissing over welke dochterknoop te volgen, of het voert de actie uit die in de knoop is opgeslagen en eindigt.
Wat is het voordeel als een beslissingsboom hetzelfde doet als if-operators in het vorige gedeelte? Hier is er een gemeenschappelijk systeem waarbij elke beslissing slechts één voorwaarde en twee mogelijke uitkomsten heeft. Dit stelt de ontwikkelaar in staat om AI te creëren op basis van gegevens die beslissingen in de boom vertegenwoordigen, zonder het in de code vast te leggen. Laten we het in de vorm van een tabel voorstellen:
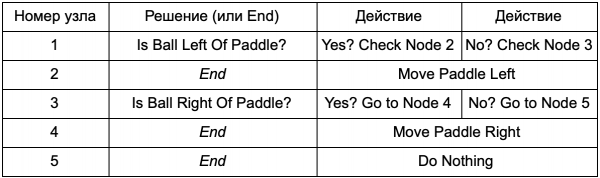
Aan de codezijde krijg je een systeem voor het lezen van rijen. Maak een knoop voor elk van hen, verbind de logica voor het nemen van beslissingen op basis van de tweede kolom en dochterknopen op basis van de derde en vierde kolom. Je moet nog steeds voorwaarden en acties programmeren, maar nu zal de structuur van het spel complexer zijn. Je voegt extra beslissingen en acties toe en configureert vervolgens de hele AI door eenvoudig het tekstbestand met de boomdefinitie te bewerken. Vervolgens geef je het bestand door aan de game designer, die het gedrag kan wijzigen zonder de game opnieuw te compileren en de code te veranderen.
Beslissingsbomen zijn zeer nuttig wanneer ze automatisch worden opgebouwd op basis van een groot aantal voorbeelden (bijvoorbeeld met behulp van het ID3-algoritme). Dit maakt ze een effectief en hoogwaardig hulpmiddel voor het classificeren van situaties op basis van verkregen gegevens. Echter, we gaan verder dan een eenvoudig systeem voor het kiezen van acties door agenten.
Scripts
We hebben het systeem van de beslissingsboom besproken, dat gebruikmaakte van vooraf gedefinieerde voorwaarden en acties. De persoon die de AI ontwerpt, kan de boom organiseren zoals hij wil, maar hij moet nog steeds rekenen op de coder die dit allemaal heeft geprogrammeerd. Wat als we de ontwerper tools konden geven om zijn eigen voorwaarden of acties te creëren?
Zodat de programmeur geen code hoeft te schrijven voor de voorwaarden Is Ball Left Of Paddle en Is Ball Right Of Paddle, kan hij een systeem maken waarin de ontwerper voorwaarden kan vastleggen om deze waarden te controleren. Dan zouden de gegevens van de beslissingsboom er als volgt uitzien:
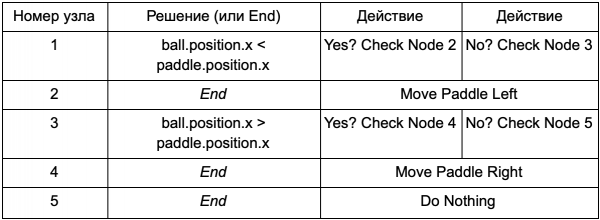
In wezen is dit hetzelfde als in de eerste tabel, maar de oplossingen hebben hun eigen code, die een beetje lijkt op de voorwaarde in een if-operator. Aan de codezijde zou dit worden gelezen in de tweede kolom voor de knooppunten van beslissingen, maar in plaats van te zoeken naar een specifieke voorwaarde om uit te voeren (Is Ball Left Of Paddle), evalueert het een voorwaardelijke expressie en retourneert het respectievelijk true of false. Dit gebeurt met behulp van de scripts taal Lua of Angelscript. Hiermee kan de ontwikkelaar objecten in zijn spel (bal en paddle) aannemen en variabelen aanmaken die beschikbaar zullen zijn in het script (ball.position). Bovendien is de scripts taal eenvoudiger dan C++. Het vereist geen volledige compilatiefase, waardoor het perfect is voor snelle aanpassingen van de game logica en het 'niet-coders' mogelijk maakt om zelf de gewenste functies te creëren.
In het gegeven voorbeeld wordt de scripts taal alleen gebruikt voor de evaluatie van de voorwaardelijke expressie, maar het kan ook voor acties worden gebruikt. Bijvoorbeeld, de gegevens Move Paddle Right kunnen een scripts operator worden (ball.position.x += 10). Op deze manier kan de actie ook in het script worden gedefinieerd, zonder de noodzaak om Move Paddle Right te programmeren.
Je kunt nog verder gaan en de beslissingsboom volledig in de scripts taal schrijven. Dit zou code zijn in de vorm van hardcoded voorwaardelijke operators, maar ze zouden zich in externe scripts bestanden bevinden, wat betekent dat ze kunnen worden gewijzigd zonder de hele applicatie opnieuw te compileren. Vaak kan het scripts bestand zelfs tijdens het spel worden gewijzigd om snel verschillende AI-reacties te testen.
Reageren op gebeurtenissen
De bovenstaande voorbeelden zijn perfect voor Pong. Ze draaien continu een cyclus van Sense/Think/Act en handelen op basis van de laatste staat van de wereld. Maar in complexere spellen moet er op afzonderlijke gebeurtenissen worden gereageerd, en niet alles in één keer worden geëvalueerd. Pong is in dit geval al een minder goed voorbeeld. Laten we een ander voorbeeld kiezen.
Stel je een shooter voor waarin vijanden stil blijven staan totdat ze de speler opmerken, waarna ze handelen op basis van hun 'specialisatie': sommigen zullen 'rushen', anderen zullen vanop afstand aanvallen. Dit is nog steeds een basis reagerend systeem — 'als de speler wordt gezien, doe dan iets' — maar het kan logisch worden opgesplitst in de gebeurtenis Player Seen (speler gezien) en de reactie (kiezen een antwoord en voer het uit).
Dit brengt ons terug bij de cyclus Sense/Think/Act. We kunnen de Sense-gedeelte coderen, dat bij elke frame controleert of de AI de speler ziet. Als dat niet zo is, gebeurt er niets, maar als hij dat wel doet, wordt er een evenement Player Seen aangemaakt. De code zal een apart gedeelte hebben waarin staat: „wanneer het evenement Player Seen plaatsvindt, doe “, waar de reactie is die je nodig hebt om te verwijzen naar de Think en Act delen. Op deze manier stel je de reacties in op het evenement Player Seen: voor een 'rushende' character — ChargeAndAttack, en voor een sniper — HideAndSnipe. Deze koppelingen kunnen in een gegevensbestand worden aangemaakt voor snelle bewerking zonder opnieuw te compileren. Ook hier kan een scriptscript worden gebruikt.
Complexe beslissingen nemen
Hoewel eenvoudige reactieve systemen zeer effectief zijn, zijn er veel situaties waarin ze niet voldoende zijn. Soms is het nodig om verschillende beslissingen te nemen op basis van wat de agent op dat moment doet, maar het is moeilijk om dit als een voorwaarde weer te geven. Soms zijn er te veel voorwaarden om ze effectief in een beslissingsboom of script te verwerken. Soms moet je van tevoren inschatten hoe de situatie zal veranderen voordat je een beslissing neemt over de volgende stap. Voor deze problemen zijn complexere benaderingen nodig.
Finite state machine
Een finite state machine of FSM (gediscretiseerde toestandmachine) is een manier om te zeggen dat onze agent zich momenteel in een van de verschillende mogelijke toestanden bevindt en dat hij van de ene toestand naar de andere kan overgaan. Er zijn een bepaald aantal van die toestanden — daar komt de naam vandaan. Het beste voorbeeld uit het leven is een verkeerslicht. Op verschillende plaatsen zijn er verschillende volgordes van lichten, maar het principe is hetzelfde — elke toestand vertegenwoordigt iets (stop, ga enz.). Een verkeerslicht bevindt zich op elk moment in slechts één toestand en schakelt van de ene naar de andere op basis van eenvoudige regels.
Met NPC's in games is het een vergelijkbaar verhaal. Laten we bijvoorbeeld een bewaker nemen met de volgende toestanden:
- Patrouillerend (Patrolling).
- Aanvallend (Attacking).
- Vluchtend (Fleeing).
En de volgende voorwaarden voor het veranderen van zijn toestand:
- Als de bewaker een vijand ziet, valt hij aan.
- Als de bewaker aanvalt maar de vijand niet meer ziet, keert hij terug naar patrouilleren.
- Als de bewaker aanvalt maar ernstig gewond is, vlucht hij.
Je kunt ook if-operators schrijven met de toestandvariabele van de wacht en verschillende controles: is er een vijand in de buurt, wat is het gezondheidsniveau van de NPC, enzovoort. Laten we nog een paar toestanden toevoegen:
- Inactiviteit (Idling) - tussen patrouilles.
- Zoeken (Searching) - wanneer een opgemerkte vijand zich heeft verstopt.
- Hulp vragen (Finding Help) - wanneer een vijand is gezien, maar te sterk is om alleen tegen te vechten.
De keuze voor elk van hen is beperkt - bijvoorbeeld, de wacht zal niet op zoek gaan naar een verborgen vijand als hij een laag gezondheid heeft.
Uiteindelijk kan een enorme lijst van "als" te groot worden, daarom should we een methode formaliseren die ons in staat stelt om de toestanden en overgangen tussen toestanden in gedachten te houden. <x и y, но не z>, dan <p>Om dit te doen, zullen we alle toestanden in overweging nemen en onder elke toestand een lijst maken van alle overgangen naar andere toestanden, samen met de voorwaarden die daarvoor nodig zijn.
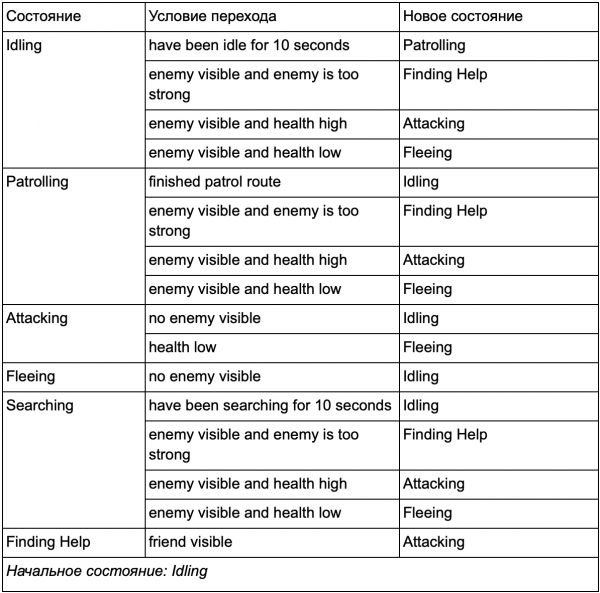
Dit is de staatsoverdrachtentabel - een complexe manier om de FSM weer te geven. Laten we een diagram tekenen en een volledig overzicht krijgen van hoe het gedrag van de NPC verandert.
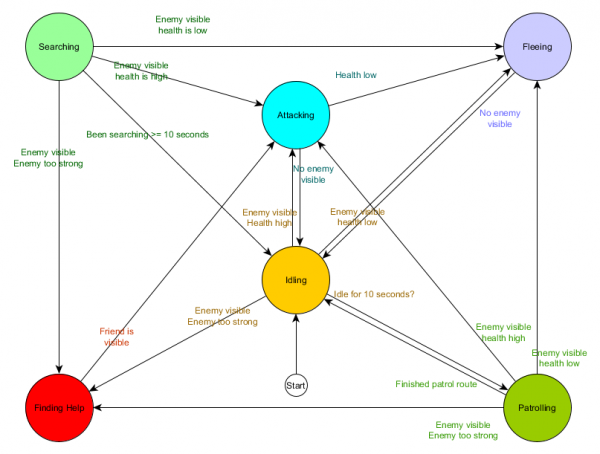
Het diagram weerspiegelt het besluitvormingsproces voor deze agent op basis van de huidige situatie. Elke pijl toont een overgang tussen toestanden, als de voorwaarde ernaast waar is.
Bij elke update controleren we de huidige toestand van de agent, bekijken we de lijst met overgangen, en als de voorwaarden voor de overgang zijn vervuld, neemt hij een nieuwe toestand aan. Bijvoorbeeld, bij elke frame wordt gecontroleerd of de 10-seconden timer is verlopen, en als dat het geval is, gaat de wacht vanuit de toestand Idling naar Patrolling. Op dezelfde manier controleert de toestand Attacking de gezondheid van de agent - als deze laag is, gaat hij naar de toestand Fleeing.
Dit is de verwerking van overgangen tussen toestanden, maar wat is er met het gedrag dat verband houdt met de toestanden zelf? Wat betreft de implementatie van daadwerkelijk gedrag voor een specifieke toestand, zijn er doorgaans twee soorten 'hooks' waar we acties aan de FSM toewijzen:
- Acties die we periodiek uitvoeren voor de huidige toestand.
- Acties die we ondernemen bij de overgang van de ene toestand naar de andere.
Voorbeelden van het eerste type. De toestand Patrolling zal elke frame de agent langs de patrouilleroute bewegen. De toestand Attacking zal elke frame proberen een aanval te starten of over te gaan naar een toestand wanneer dat mogelijk is.
Voor het tweede type bekijken we de overgang 'als de vijand zichtbaar is en de vijand te sterk is, ga dan naar de toestand Finding Help. De agent moet kiezen waar hij hulp kan zoeken en deze informatie opslaan, zodat de toestand Finding Help weet waar hij moet kijken. Zodra hulp is gevonden, gaat de agent terug naar de toestand Attacking. Op dat moment wil hij de bondgenoot waarschuwen voor de dreiging, dus kan de actie NotifyFriendOfThreat ontstaan.
En opnieuw kunnen we dit systeem bekijken door de lens van de cyclus Sense / Think / Act. Sense wordt belichaamd in de gegevens die worden gebruikt door de overgangslogica. Think zijn de overgangen die beschikbaar zijn in elke toestand. En Act wordt uitgevoerd door acties die periodiek binnen de toestand of tijdens de overgangen tussen toestanden worden ondernomen.
Af en toe kan continue controle van de overgangsvoorwaarden kostbaar zijn. Bijvoorbeeld, als elke agent complexe berekeningen bij elke frame uitvoert om te bepalen of hij vijanden ziet en of hij kan overstappen van de toestand Patrolling naar Attacking - dit kost veel rekenkracht.
Belangrijke veranderingen in de wereldtoestand kunnen worden beschouwd als evenementen die naar voren worden gebracht zodra ze zich voordoen. In plaats van dat de FSM bij elke frame de overgangsvoorwaarde 'kan mijn agent de speler zien?' controleert, kan een afzonderlijk systeem worden ingesteld om de controles minder vaak uit te voeren (bijvoorbeeld 5 keer per seconde). Het resultaat wordt Player Seen, wanneer de controle slaagt.
Dit wordt doorgegeven aan de FSM, die nu moet overstappen naar de voorwaarde Player Seen event received en dienovereenkomstig moet reageren. Het eindresultaat is hetzelfde, met uitzondering van een bijna onmerkbare vertraging voordat er wordt gereageerd. De prestaties zijn daarentegen verbeterd dankzij de scheiding van een deel van Sense in een apart onderdeel van het programma.
Hierarchische eindige toestenmachine
Echter, werken met grote FSM's is niet altijd praktisch. Als we de aanvallen toestand willen uitbreiden door deze te vervangen door aparte MeleeAttacking (nabij gevecht) en RangedAttacking (ver weg gevecht), zullen we de overgangen vanuit alle andere toestanden die leiden naar de toestand Attacking (huidige en toekomstige) moeten aanpassen.
Je hebt waarschijnlijk opgemerkt dat er in ons voorbeeld veel dubbele overgangen zijn. De meeste overgangen in de Idling-toestand zijn identiek aan de overgangen in de Patrolling-toestand. Het zou goed zijn om ons niet te herhalen, vooral niet als we meer vergelijkbare toestanden toevoegen. Het heeft zin om Idling en Patrolling onder een gezamenlijke label "niet-gevechts" te groeperen, waarbij er slechts één gemeenschappelijke set overgangen naar gevechtsstanden is. Als we deze label als een toestand beschouwen, worden Idling en Patrolling subtoestanden. Een voorbeeld van het gebruik van een aparte overgangstabel voor de nieuwe niet-gevechts subtoestand:
Hoofdstaten:
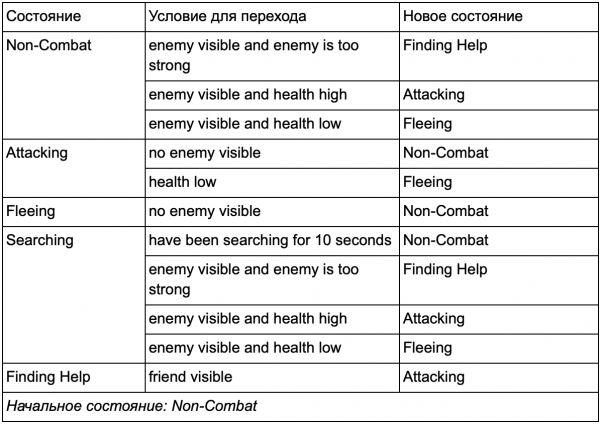
Staat buiten strijd:
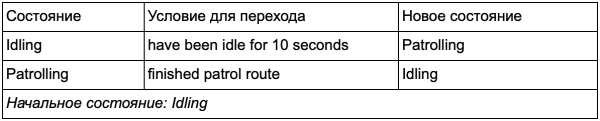
En in diagramvorm:
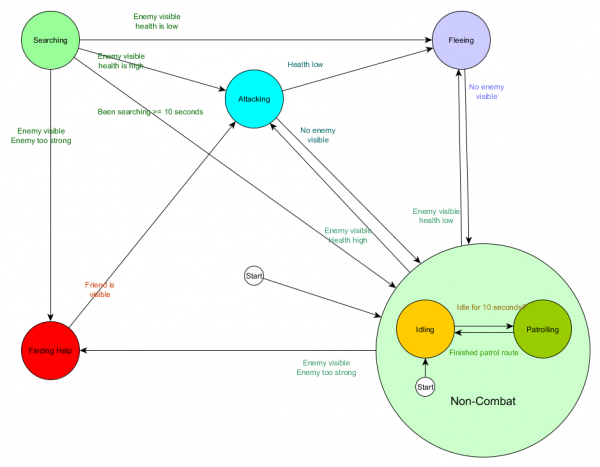
Dit is hetzelfde systeem, maar met een nieuwe niet-gevechtstoestand die Idling en Patrolling omvat. Elke toestand bevat een FSM met subtoestanden (en deze subtoestanden bevatten op hun beurt eigen FSM's — en zo verder, zoveel als je nodig hebt), wat resulteert in een Hiërarchische Eindige Toestandsmachine of HFSM. Door de niet-gevechtstoestand te groeperen, hebben we een hoop overbodige overgangen geëlimineerd. Hetzelfde kunnen we doen voor elke nieuwe toestand met gemeenschappelijke overgangen. Bijvoorbeeld, als we in de toekomst de toestand Aanvallen uitbreiden tot MeleeAanvallen en MissileAanvallen, zullen deze subtoestanden zijn die tussen elkaar overgaan op basis van de afstand tot de vijand en de beschikbaarheid van munitie. Uiteindelijk kunnen complexe gedragsmodellen en submodellen van gedrag worden gepresenteerd met een minimum aan dubbele overgangen.
Gedragsboom
Met HFSM worden complexe combinaties van gedragingen eenvoudig gecreëerd. Er is echter een klein probleem, want besluitvorming in de vorm van overgangsregels is nauw verbonden met de huidige toestand. En in veel spellen is dat precies wat nodig is. Goed gebruik van de hiërarchie van toestanden kan het aantal herhalingen bij overgangen verminderen. Maar soms zijn er regels nodig die onafhankelijk van de huidige toestand werken of die in vrijwel elke toestand toepasbaar zijn. Bijvoorbeeld, als de gezondheid van de agent tot 25% is gedaald, wil je dat hij wegloopt, ongeacht of hij in strijd is, lui is of praat — je moet deze voorwaarde aan elke toestand toevoegen. En als je ontwerper later de drempel voor lage gezondheid van 25% naar 10% wil veranderen, moet je daar opnieuw mee aan de slag.
Ideaal voor deze situatie is een systeem waarin de beslissingen "in welke toestand te zijn" buiten de toestanden zelf liggen, zodat aanpassingen op één plek kunnen worden gemaakt zonder de overgangsvoorwaarden te beïnvloeden. Hier komen de gedragspaden in beeld.
Er zijn verschillende manieren om dit te implementeren, maar het principe is in grote lijnen hetzelfde en lijkt op een beslissingsboom: het algoritme begint bij een „wortel” knooppunt, en in de boom zijn er knooppunten die ofwel beslissingen ofwel acties vertegenwoordigen. Er zijn echter enkele belangrijke verschillen:
- Nu geven de knooppunten een van de drie waarden terug: Succeeded (als het werk is uitgevoerd), Failed (als het niet kan worden gestart) of Running (als het nog steeds actief is en er geen eindresultaat is).
- Er zijn geen beslissingsknooppunten meer om te kiezen tussen twee alternatieven. In plaats daarvan zijn er Decorator-knooppunten, die één dochterknooppunt hebben. Als zij slagen, voeren zij hun enige dochterknooppunt uit.
- Actie-uitvoerende knooppunten geven een waarde van Running terug om de acties die worden uitgevoerd weer te geven.
Deze kleine set knooppunten kan worden gecombineerd om een groot aantal complexe gedragsmodellen te creëren. Laten we de HFSM van de bewaker uit het vorige voorbeeld voorstellen als een gedragsboom:
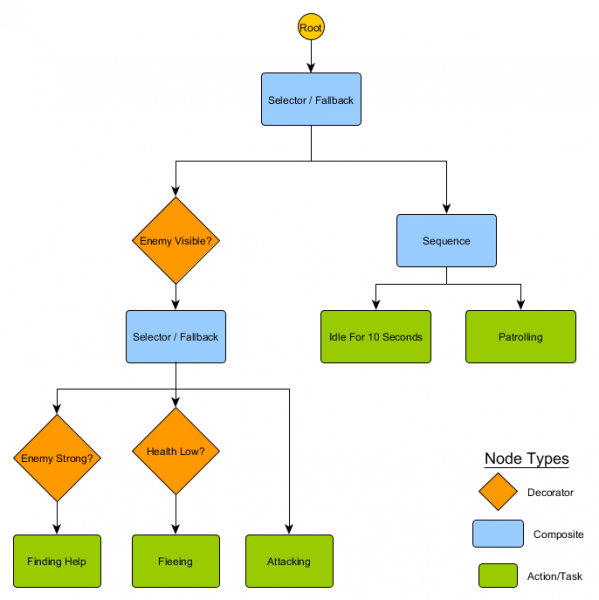
Met deze structuur mag er geen expliciete overgang zijn van de toestanden Idling/Patrolling naar de toestand Attacking of andere. Als de vijand zichtbaar is en de gezondheid van het personage laag is, stopt de uitvoering op het knooppunt Fleeing, ongeacht welk knooppunt eerder werd uitgevoerd – Patrolling, Idling, Attacking of een ander.
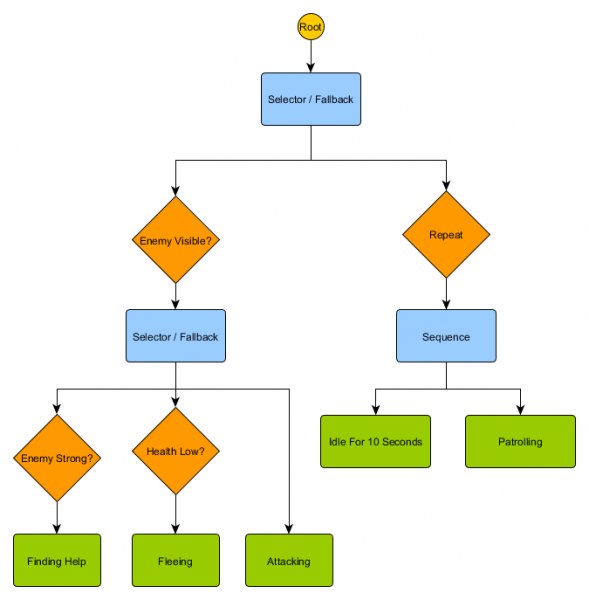
Gedragspaden zijn complex – er zijn veel manieren om ze samen te stellen, en het kan problematisch zijn om de juiste combinatie van decorateurs en samengestelde knooppunten te vinden. Er zijn ook vragen over hoe vaak de boom moet worden gecontroleerd – willen we elke keer door de hele boom gaan of alleen als een van de voorwaarden veranderd is? Hoe met de toestand van de knooppunten om te gaan – hoe weten we wanneer we 10 seconden in de toestand Idling zaten of hoe kunnen we weten welke knooppunten de laatste keer werden uitgevoerd om de volgorde correct af te handelen?
Dat is precies waarom er zoveel implementaties zijn. In sommige systemen zijn decoratorknooppunten vervangen door ingebouwde decorateurs. Ze evalueren de boom opnieuw bij veranderingen in de decoratorvoorwaarden, helpen bij het koppelen van knooppunten en zorgen voor periodieke updates.
Utility-based systeem
Sommige games hebben tal van verschillende mechanics. Het is wenselijk dat ze allemaal profiteren van eenvoudige en algemene overgangsregels, maar niet per se in de vorm van een volledige gedragsboom. In plaats van een duidelijke set keuzes of een boom van mogelijke acties te hebben, is het eenvoudiger om alle acties te bestuderen en diegene te kiezen die op dat moment het meest geschikt is.
Een utility-based systeem helpt hier precies mee. Dit is een systeem waarin de agent tal van acties heeft en zelf kiest welke uit te voeren, gebaseerd op de relatieve nuttigheid van elke actie. Waar nuttigheid een arbitraire maat is voor hoe belangrijk of wenselijk het is dat deze actie door de agent wordt uitgevoerd.
De berekende nuttigheid van een actie op basis van de huidige staat en omgeving kan door de agent op elk moment worden gecontroleerd, waarna hij de meest geschikte andere staat kan kiezen. Dit lijkt op een FSM, behalve dat de overgangen worden bepaald door de evaluatie van elke potentiële staat, inclusief de huidige. Let op dat we de meest bruikbare actie kiezen om naar over te gaan (of we blijven staan als we deze al hebben uitgevoerd). Voor meer variëteit kan dit een gewogen, maar willekeurige keuze zijn uit een korte lijst.
Het systeem kent een willekeurige reeks nuttigheidswaarden toe — bijvoorbeeld van 0 (volledig ongewenst) tot 100 (volledig gewenst). Elke actie heeft een aantal parameters die van invloed zijn op de berekening van deze waarde. Terugkomend op ons voorbeeld met de bewaker:
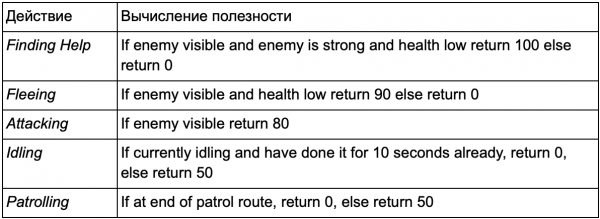
Overgangen tussen acties zijn niet eenduidig — elke staat kan volgen op elke andere. De prioriteiten van acties liggen in de teruggegeven nuttigheidswaarden. Als een vijand zichtbaar is, en deze vijand sterk is, en de gezondheid van het karakter laag is, dan zullen zowel Fleeing als FindingHelp hoge niet-nul waarden teruggeven. In dit geval zal FindingHelp altijd hoger zijn. Evenzo geven niet-strijd acties nooit meer dan 50 terug, waardoor ze altijd lager zullen zijn dan gevechtsacties. Dit moet in overweging worden genomen bij het creëren van acties en het berekenen van hun nuttigheid.
In ons voorbeeld geven acties of een vaste constante waarde terug, of een van de twee vaste waarden. Een realistischere systeem zou een schatting uit een continu bereik van waarden teruggeven. Bijvoorbeeld, de actie Fleeing levert hogere nutwaardes op wanneer de gezondheid van de agent laag is, terwijl de actie Attacking lagere waarden oplevert als de vijand te sterk is. Dit betekent dat de actie Fleeing prioriteit heeft boven Attacking in elke situatie waarin de agent voelt dat hij niet genoeg gezondheid heeft om de tegenstander te verslaan. Hierdoor kunnen de prioriteiten van acties worden aangepast op basis van een aantal criteria, wat deze benadering flexibeler en variabeler maakt dan een gedragsboom of FSM.
Elke actie heeft veel voorwaarden voor de berekening van het programma. Deze kunnen worden geschreven in scripts of als een reeks wiskundige formules. In The Sims, dat de dagelijkse routine van een personage codeert, wordt een extra niveau van berekeningen toegevoegd - de agent ontvangt een reeks 'motivaties' die de nutwaardes beïnvloeden. Als het personage hongerig is, zal het na verloop van tijd nog hongeriger worden, en de nutwaarde van de actie EatFood zal toenemen totdat het personage deze uitvoert, waardoor het honger niveau afneemt en de waarde van EatFood weer nul wordt.
Het idee om acties te kiezen op basis van een waarderingssysteem is vrij eenvoudig, dus een utility-based systeem kan worden gebruikt als onderdeel van besluitvormingsprocessen voor AI, en niet als volledige vervanging. Een beslissingsboom kan de nutwaarde van twee kindknopen opvragen en de hogere kiezen. Evenzo kan een gedragsboom een samengestelde Utility-knoop hebben om de nutwaarde van acties te evalueren, om te beslissen welke kindelement moet worden uitgevoerd.
Beweging en navigatie
In de eerdere voorbeelden hadden we een platform dat we naar links of rechts verplaatsten, en een bewaker die patrouilleerde of aanviel. Maar hoe verwerken we precies de beweging van de agent over een bepaalde periode? Hoe stellen we de snelheid in, hoe vermijden we obstakels, en hoe plannen we een route als het moeilijker is om de bestemming te bereiken dan gewoon recht vooruit te bewegen? Laten we dat verkennen.
Beheer
In het begin nemen we aan dat elke agent een snelheidswaarde heeft, die aangeeft hoe snel hij beweegt en in welke richting. Deze kan worden gemeten in meters per seconde, kilometers per uur, pixels per seconde, enz. Als we de Sense/Think/Act-cyclus in gedachten houden, kunnen we ons voorstellen dat het Think-gedeelte de snelheid kiest, en het Act-gedeelte deze snelheid aan de agent toepast. Gewoonlijk is er in games een fysisch systeem dat deze taak voor je uitvoert door de snelheid van elk object te berekenen en aan te passen. Daarom kan de AI zich beperken tot één taak: beslissen welke snelheid de agent moet hebben. Als bekend is waar de agent moet zijn, dan moet deze in de juiste richting worden verplaatst met de vastgestelde snelheid. Een zeer triviale vergelijking:
desired_travel = destination_position – agent_position
Stel je een 2D-wereld voor. De agent bevindt zich op het punt (-2,-2), de bestemming ligt ergens in het noordoosten op punt (30, 20), en de benodigde route voor de agent om daar te komen is (32, 22). Laten we aannemen dat deze posities in meters worden gemeten – als we de snelheid van de agent op 5 meter per seconde nemen, zullen we onze verplaatsingsvector schalen en een snelheid van ongeveer (4.12, 2.83) krijgen. Met deze waarden zou de agent bijna na 8 seconden op de bestemming zijn.
Waarden kunnen op elk moment opnieuw worden berekend. Als de agent halverwege het doel is, zou de verplaatsing de helft van de lengte zijn, maar aangezien de maximale snelheid van de agent 5 m/s is (zoals we hierboven hebben besloten), blijft de snelheid gelijk. Dit werkt ook voor bewegende doelen, waardoor de agent kleine aanpassingen kan maken terwijl zij zich bewegen.
Maar we willen meer variabiliteit – bijvoorbeeld, langzaam de snelheid verhogen om een personage te simuleren dat van een stilstaande positie naar rennen gaat. Hetzelfde kan gedaan worden aan het einde voordat men stopt. Deze functies staan bekend als steering behaviours, elk met specifieke namen: Seek (zoeken), Flee (vluchten), Arrival (aankomst), enz. Het idee is dat versnelling krachten op de snelheid van de agent kunnen worden toegepast, gebaseerd op de vergelijking van de positie van de agent en de huidige snelheid met het doel, zodat verschillende manieren van verplaatsen naar het doel kunnen worden gebruikt.
Elk gedrag heeft een iets ander doel. Seek en Arrival zijn manieren voor de agent om naar een doelpunt te bewegen. Obstacle Avoidance (obstakelontwijking) en Separation (scheiding) corrigeren de beweging van de agent om obstakels op de weg naar het doel te vermijden. Alignment (afstemming) en Cohesion (samenhang) houden de agents samen in beweging. Een willekeurig aantal verschillende stuurgedragingen kan worden opgeteld tot één padvector die rekening houdt met alle factoren. Een agent die gebruikmaakt van de gedragingen Arrival, Separation en Obstacle Avoidance, houdt zich op afstand van muren en andere agents. Deze aanpak werkt goed in open omgevingen zonder onnodige details.
In moeilijkere omstandigheden werkt het combineren van verschillende gedragingen minder goed — bijvoorbeeld, de agent kan vast komen te zitten in een muur door een conflict tussen Arrival en Obstacle Avoidance. Daarom moeten we opties overwegen die complexer zijn dan alleen het optellen van alle waarden. Een manier om dit te doen: in plaats van de resultaten van elk gedrag op te tellen, kunnen we beweging in verschillende richtingen overwegen en de beste optie kiezen.
Echter, in een complexe omgeving met doodlopende wegen en keuzes over welke kant op te gaan, hebben we iets meer geavanceerds nodig.
Pad vinden
Stuurgedragingen zijn uitstekend geschikt voor eenvoudige beweging op open terrein (zoals een voetbalveld of arena), waar van A naar B gaan een directe route met kleine afwijkingen langs obstakels is. Voor complexe routes hebben we pathfinding nodig, wat een manier is om de wereld te verkennen en beslissingen te nemen over de route erdoorheen.
De eenvoudigste manier is om een raster over elk vierkant naast de agent te leggen en te beoordelen in welke vierkanten beweging is toegestaan. Als een van deze vierkanten de bestemming is, volg dan het pad van elk vierkant naar het vorige, totdat je aan het begin bent gekomen. Dit is het pad. Anders herhaal je het proces met de dichtstbijzijnde andere vierkanten, totdat je de bestemming vindt of er geen vierkanten meer zijn (wat betekent dat er geen mogelijk pad is). Dit staat formeel bekend als Breadth-First Search of BFS (breedte-eerst zoeken). Bij elke stap kijkt het in alle richtingen (vandaar de term 'breedte'). De zoekruimte lijkt op een golffront dat zich voortbeweegt, totdat het de gewenste locatie bereikt — het zoekgebied breidt zich bij elke stap uit totdat het de eindbestemming bereikt, waarna het pad naar het begin kan worden teruggevolgd.
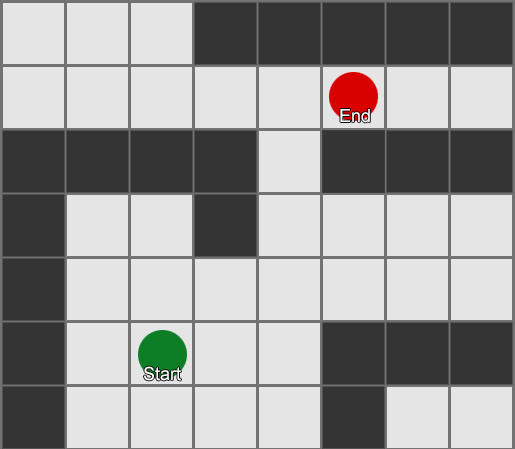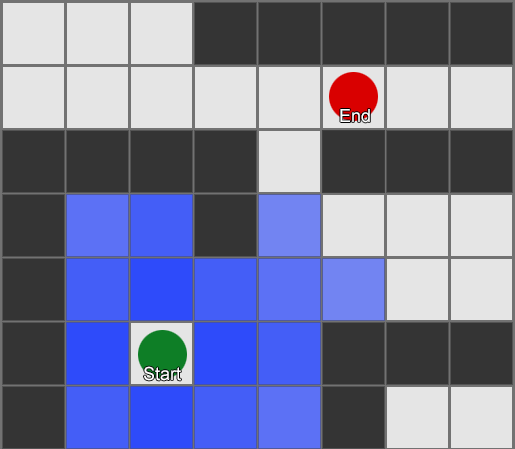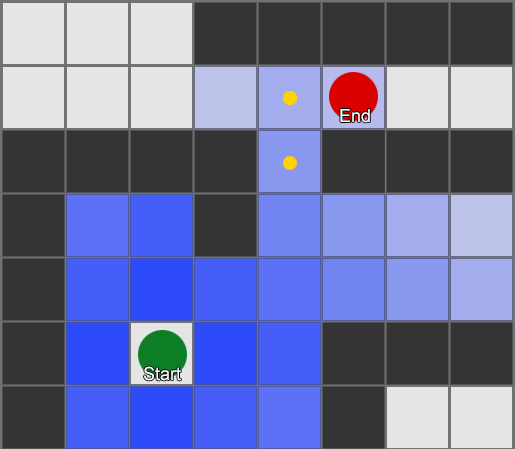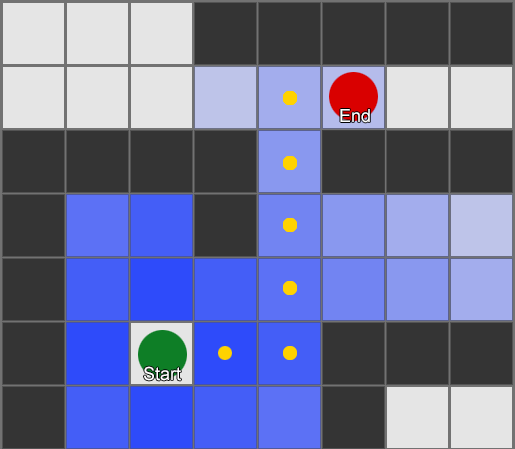
Hierdoor krijg je een lijst van vierkanten die het benodigde pad vormen. Dit is het pad (vandaar pathfinding) — een lijst van plaatsen die de agent zal bezoeken op weg naar de bestemming.
Aangezien we de positie van elk vierkant in de wereld weten, kunnen we steering behaviours gebruiken om over het pad te bewegen — van knooppunt 1 naar knooppunt 2, vervolgens van knooppunt 2 naar knooppunt 3, enzovoort. De eenvoudigste optie is om naar het midden van het volgende vierkant te bewegen, maar het is nog beter om halverwege de rand tussen het huidige vierkant en het volgende te stoppen. Hierdoor kan de agent de hoeken afsnijden bij scherpe bochten.
Het BFS-algoritme heeft ook nadelen — het verkent net zoveel vierkanten in de 'verkeerde' richting als in de 'juiste'. Hier komt een geavanceerder algoritme genaamd A* (A ster) in beeld. Het werkt op dezelfde manier, maar in plaats van blind de aangrenzende vierkanten (en dan de aangrenzende aangrenzende vierkanten, enzovoort) te verkennen, verzamelt het knooppunten in een lijst en sorteert deze zodat het volgende onderzochte knooppunt altijd datgene is dat leidt tot het kortste pad. De knooppunten worden gesorteerd op basis van een heuristiek die rekening houdt met twee dingen — de 'kosten' van de hypothetische route naar het benodigde vierkant (inclusief eventuele bewegingskosten) en een schatting van hoe ver dat vierkant van de bestemming is (waardoor het zoeken in de juiste richting wordt geleid).
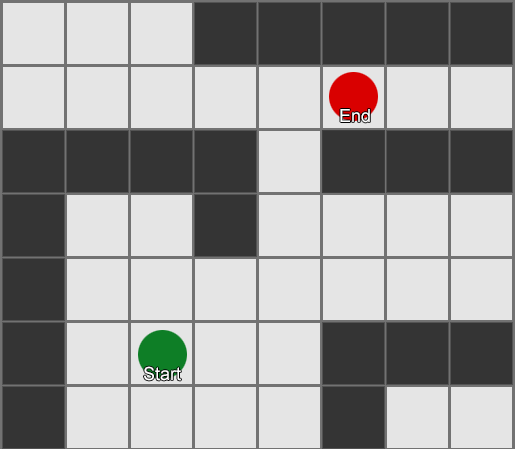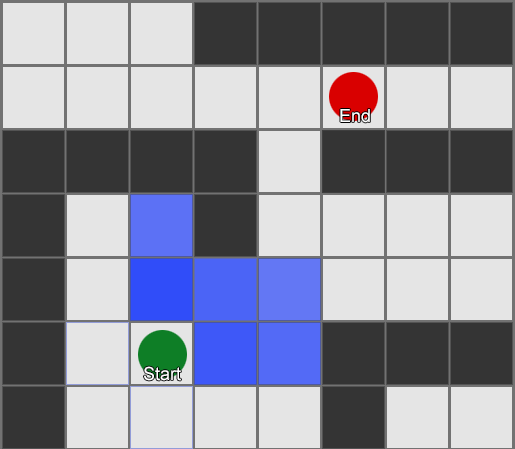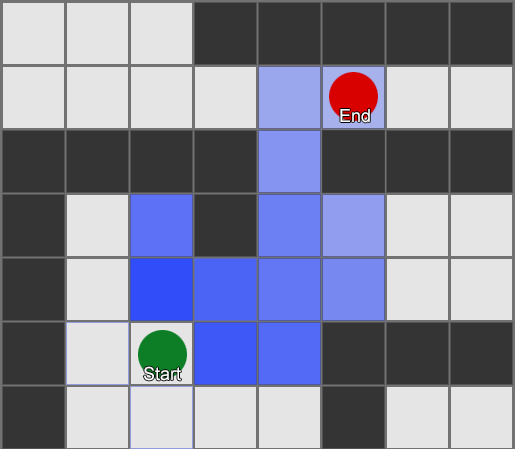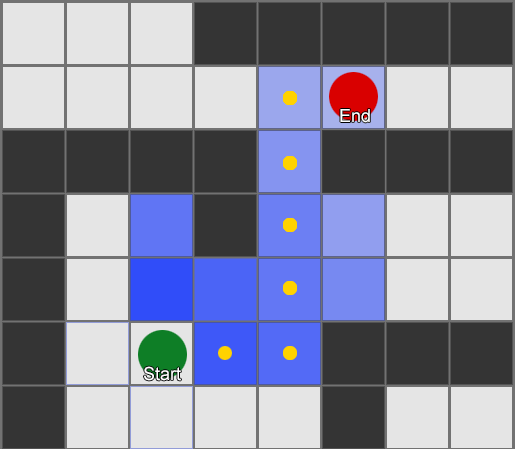
In dit voorbeeld ziet u dat de agent één vierkant tegelijk verkent, telkens het meest veelbelovende aangrenzende vierkant kiest. Het resulterende pad is hetzelfde als bij BFS, maar er zijn in het proces minder vierkanten overwogen — wat van groot belang is voor de prestaties van het spel.
Beweging zonder raster
Maar de meeste spellen zijn niet op een raster gebaseerd, en vaak is het onmogelijk om dit te doen zonder de realiteit te schaden. Er zijn compromissen nodig. Hoe groot moeten de vierkanten zijn? Te groot — en ze kunnen kleine gangen of bochten niet goed weergeven, te klein — er zullen te veel vierkanten zijn om te doorzoeken, wat uiteindelijk veel tijd kost.
Het eerste dat je moet begrijpen is dat een raster ons een grafiek van verbonden knooppunten geeft. De algoritmen A* en BFS werken feitelijk op grafieken en maken zich helemaal geen zorgen over ons raster. We zouden knooppunten op elke plek in de spelwereld kunnen plaatsen: zolang er een verbinding is tussen twee verbonden knooppunten, evenals tussen het start- en eindpunt en minstens één van de knooppunten — zal het algoritme net zo goed werken als voorheen. Dit wordt vaak een waypoint-systeem genoemd, omdat elk knooppunt een significante positie in de wereld vertegenwoordigt die deel kan uitmaken van elk aantal hypothetische paden.
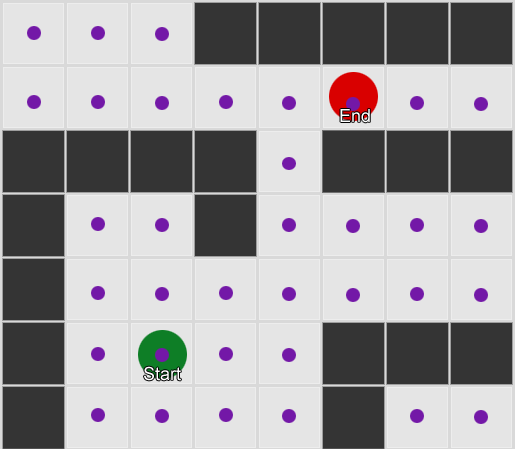
Voorbeeld 1: een knooppunt in elk vierkant. De zoekopdracht begint vanuit het knooppunt waar de agent zich bevindt en eindigt in het knooppunt van het gewenste vierkant.
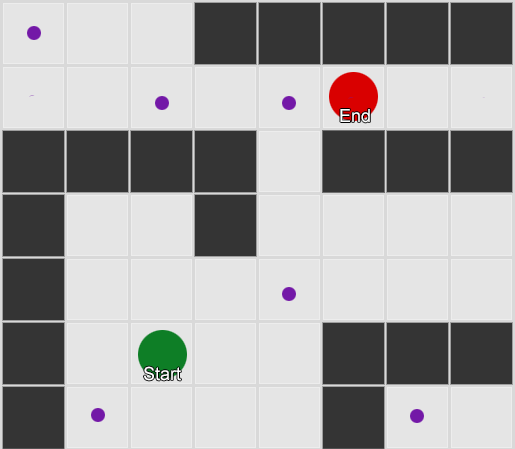
Voorbeeld 2: een kleinere set knooppunten (waypoints). De zoekopdracht begint in het vierkant met de agent, gaat door de benodigde knooppunten en gaat dan door naar de bestemming.
Dit is een behoorlijk flexibel en krachtig systeem. Maar er is enige voorzichtigheid nodig bij de beslissing waar en hoe een waypoint te plaatsen, anders kunnen agents gewoon de dichtstbijzijnde locatie niet zien en niet starten met het pad. Het zou gemakkelijker zijn als we waypoints automatisch op basis van de geometrie van de wereld konden plaatsen.
Hier komt de navigation mesh of navmesh (navigatieraster) in beeld. Dit is meestal een 2D-raster van driehoeken dat op de geometrie van de wereld wordt gelegd — overal waar de agent is toegestaan om te lopen. Elke driehoek in het raster wordt een knooppunt in de grafiek en heeft tot drie aangrenzende driehoeken, die buur knooppunten worden in de grafiek.
Dit beeld is een voorbeeld uit de Unity-engine — deze heeft de geometrie in de wereld geanalyseerd en een navmesh (lichtblauw op de screenshot) gemaakt. Elk polygon in de navmesh is een gebied waar een agent kan staan of zich van het ene polygon naar het andere kan verplaatsen. In dit voorbeeld zijn de polygons kleiner dan de verdiepingen waarop ze zich bevinden — dit is gedaan om rekening te houden met de afmetingen van de agent die buiten zijn nominale positie zou kunnen uitsteken.
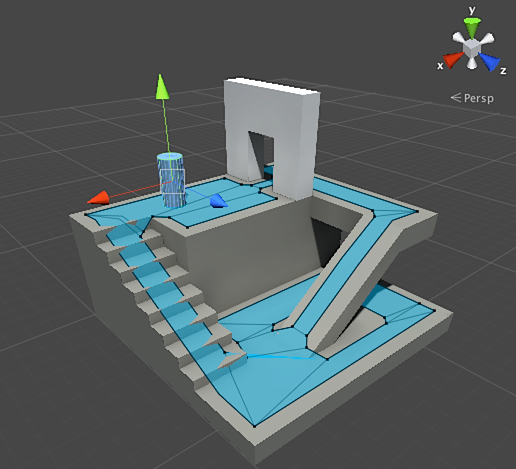
We kunnen een route door dit netwerk zoeken, opnieuw gebruikmakend van de A*-algoritme. Dit zal ons een praktisch perfecte route geven in de wereld, die rekening houdt met alle geometrie en tegelijkertijd geen onnodige knooppunten en waypoint-creatie vereist.
Pathfinding is een te uitgebreid onderwerp om in slechts één artikel behandeld te worden. Als je het in meer detail wilt bestuderen, kan de .
Planning
We hebben met pathfinding vastgesteld dat het soms niet voldoende is om gewoon een richting te kiezen en te bewegen — we moeten een route kiezen en een paar bochten maken om bij de volgende bestemming te komen. We kunnen dit idee samenvatten: het bereiken van een doel is niet gewoon de volgende stap, maar eerder een hele volgorde, waarbij het soms nodig is vooruit te kijken naar een paar stappen om te begrijpen wat de eerste stap zou moeten zijn. Dit noemen we planning. Pathfinding kan worden beschouwd als een van de verschillende aanvullende aspecten van planning. Vanuit het perspectief van onze Sense/Think/Act-cyclus is dit het gedeelte waar Think verschillende delen van Act voor de toekomst plant.
Laten we het voorbeeld van het kaartspel Magic: The Gathering nemen. We spelen eerst met de volgende set kaarten in handen:
- Swamp — geeft 1 zwarte mana (landkaart).
- Forest — geeft 1 groene mana (landkaart).
- Fugitive Wizard — vereist 1 blauwe mana om te spelen.
- Elvish Mystic — vereist 1 groene mana om te spelen.
De overige drie kaarten negeren we ter vereenvoudiging. Volgens de regels mag een speler 1 landkaart per beurt spelen, hij kan die kaart 'tap' om mana te genereren, en vervolgens spreuken gebruiken (inclusief het oproepen van wezens) met het aantal beschikbare mana. In deze situatie weet de menselijke speler dat hij Forest moet spelen, 1 groene mana moet tap'en, en daarna Elvish Mystic moet oproepen. Maar hoe komt de spel-AI hierachter?
Eenvoudige planning
Een triviale benadering is om elke actie één voor één te proberen totdat er geen geschikte meer overblijven. Kijkend naar de kaarten ziet de AI dat deze Swamp kan spelen. En speelt het. Zijn er nog andere acties mogelijk in deze beurt? Hij kan noch Elvish Mystic noch Fugitive Wizard oproepen, omdat daarvoor respectievelijk groene en blauwe mana vereist is, terwijl Swamp alleen zwarte mana geeft. En hij kan al geen Forest meer spelen, omdat hij al Swamp heeft gespeeld. De spel-AI heeft dus volgens de regels gespeeld, maar deed dit slecht. Dit kan verbeterd worden.
Planning kan een lijst van acties vinden die het spel in de gewenste toestand brengen. Evenals elke vierkant op de route buren had (in pathfinding), heeft elke actie in het plan ook buren of opvolgers. We kunnen deze acties en daaropvolgende acties zoeken tot we de gewenste staat bereiken.
In ons voorbeeld is het gewenste resultaat 'oproepen van een wezen, als dat mogelijk is'. Aan het begin van de beurt zien we slechts twee mogelijke acties die volgens de spelregels zijn toegestaan:
1. Speel Swamp (resultaat: Swamp in het spel)
2. Speel Forest (resultaat: Forest in het spel)
Elke ondernomen actie kan leiden tot verdere acties en andere blokkeren, wederom afhankelijk van de spelregels. Stel je voor dat we Swamp hebben gespeeld - dit verwijdert Swamp als volgende stap (we hebben het al gespeeld), en het verwijdert ook Forest (omdat de regels bepalen dat je één landkaart per beurt kunt spelen). Daarna voegt de AI als volgende stap - het verkrijgen van 1 zwarte mana, omdat er geen andere opties zijn. Als hij doorgaat en ervoor kiest om de Swamp te tappen, krijgt hij 1 eenheid zwarte mana en kan daar niets mee doen.
1. Speel Swamp (resultaat: Swamp in het spel)
1.1 'Tappen' Swamp (resultaat: Swamp 'getapt', +1 eenheid zwarte mana)
Geen beschikbare acties – EIND
2. Speel Forest (resultaat: Forest in het spel)
De lijst met acties is kort gekomen, we zijn vastgelopen. We herhalen het proces voor de volgende actie. We spelen Forest, openen de actie 'krijg 1 groene mana', wat op zijn beurt de derde actie opent - oproepen van Elvish Mystic.
1. Speel Swamp (resultaat: Swamp in het spel)
1.1 'Tappen' Swamp (resultaat: Swamp 'getapt', +1 eenheid zwarte mana)
Geen beschikbare acties – EIND
2. Speel Forest (resultaat: Forest in het spel)
2.1 'Tappen' Forest (resultaat: Forest 'getapt', +1 eenheid groene mana)
2.1.1 Oproepen van Elvish Mystic (resultaat: Elvish Mystic in het spel, -1 eenheid groene mana)
Geen beschikbare acties – EIND
Ten slotte hebben we alle mogelijke acties bestudeerd en een plan gevonden om een wezen op te roepen.
Dit is een zeer vereenvoudigd voorbeeld. Het is aan te raden om de best mogelijke optie te kiezen, en niet zomaar een die aan bepaalde criteria voldoet. Over het algemeen kun je potentiële plannen evalueren op basis van het uiteindelijke resultaat of de totale voordelen van hun uitvoering. Je kunt jezelf 1 punt geven voor het spelen van een landkaart en 3 punten voor het oproepen van een wezen. Het spelen van Swamp zou een plan zijn dat 1 punt oplevert. En het spelen van Forest → Tap the Forest → oproepen van Elvish Mystic zou direct 4 punten geven.
Zo werkt planning in Magic: The Gathering, maar dezelfde logica kan ook in andere situaties worden toegepast. Bijvoorbeeld, een stuk verplaatsen om ruimte vrij te maken voor een loper in schaken. Of je achter een muur verschuilen om veilig te kunnen schieten in XCOM. Kortom, je snapt de essentie.
Verbeterde planning
Soms zijn er te veel mogelijke acties om elk potentieel scenario te overwegen. Terugkomend op het voorbeeld van Magic: The Gathering: stel dat er in het spel een aantal land- en wezenkaarten op jouw hand liggen - het aantal mogelijke combinaties van zetten kan in de tientallen lopen. Er zijn verschillende manieren om dit probleem aan te pakken.
De eerste methode is backwards chaining (omgekeerd ketenen). In plaats van alle combinaties te doorlopen, is het beter om te beginnen met het eindresultaat en een directe route te proberen vinden. In plaats van van de wortel van de boom naar een bepaald blad te gaan, bewegen we in de omgekeerde richting - van het blad naar de wortel. Deze methode is eenvoudiger en sneller.
Als de tegenstander 1 gezondheidspunt heeft, kun je een plan vinden om '1 of meer schade toe te brengen'. Om dit te bereiken moet je een reeks voorwaarden vervullen:
1. Schade kan worden toegebracht door een spreuk - deze moet in je hand zitten.
2. Om de spreuk te spelen - heb je mana nodig.
3. Om mana te verkrijgen - moet je een landkaart spelen.
4. Om een landkaart te spelen - moet je deze in je hand hebben.
Een andere methode is best-first search (beste eerste zoekopdracht). In plaats van alle paden door te lopen, kiezen we de meest geschikte. Dit geeft vaak het optimale plan zonder onnodige zoekkosten. A* is een vorm van beste eerste zoekopdracht - door de meest veelbelovende routes vanaf het begin te verkennen, kan het al de beste weg vinden zonder de andere opties te hoeven controleren.
Een interessante en steeds populairder wordende variant van best-first search is Monte Carlo Tree Search. In plaats van te raden welke plannen het beste zijn bij het kiezen van elke volgende actie, kiest het algoritme willekeurige opvolgers bij elke stap, totdat het het einde bereikt (wanneer het plan leidt tot een overwinning of nederlaag). Vervolgens wordt het uiteindelijke resultaat gebruikt om de 'gewicht'-waarde van de vorige opties te verhogen of te verlagen. Door dit proces meerdere keren achter elkaar te herhalen, biedt het algoritme een goede beoordeling van welke volgende stap het beste is, zelfs als de situatie verandert (als de tegenstander maatregelen neemt om de speler te dwarsbomen).
In het verhaal over planning in games kan Goal-Oriented Action Planning of GOAP (doelgerichte actieplanning) niet worden gemist. Dit is een veelgebruikte en besproken methode, maar afgezien van enkele onderscheidende details is het in wezen een methode voor backwards chaining, waarover we eerder hebben gesproken. Als de taak was 'de speler te vernietigen', en de speler zich achter dekking bevindt, kan het plan als volgt zijn: vernietig met een granaat → pak het → gooi het.
Gewoonlijk zijn er meerdere doelen, elk met hun eigen prioriteit. Als het doel met de hoogste prioriteit niet kan worden bereikt (geen enkele combinatie van acties creëert het plan 'de speler te vernietigen' omdat de speler niet zichtbaar is), zal de AI terugkeren naar doelen met een lagere prioriteit.
Training en aanpassing
We hebben al besproken dat de game-AI meestal geen machine learning gebruikt, omdat dit niet geschikt is voor het aansturen van agenten in real-time. Maar dat betekent niet dat er niets uit dit gebied kan worden geleend. We willen een tegenstander in een shooter hebben waar je iets van kunt leren. Bijvoorbeeld, leren over de beste posities op de kaart. Of een tegenstander in een vechtgame die vaak gebruikte combo's van de speler zou blokkeren, waardoor ze gemotiveerd worden om andere te gebruiken. Dus machine learning kan in zulke situaties zeer nuttig zijn.
Statistieken en waarschijnlijkheden
Voordat we naar complexere voorbeelden gaan, laten we eens kijken hoe ver we kunnen gaan door een paar eenvoudige metingen te nemen en deze te gebruiken om beslissingen te nemen. Bijvoorbeeld, de strategie in real-time—hoe kunnen we bepalen of een speler in de eerste paar minuten van het spel een aanval kan starten en welke verdediging we hiervoor moeten voorbereiden? We kunnen de eerdere ervaringen van de speler bestuderen om te begrijpen wat hun toekomstige reacties kunnen zijn. Laten we beginnen met het feit dat we dergelijke gegevens nog niet hebben, maar we kunnen ze verzamelen—iedere keer dat de AI tegen een mens speelt, kan het de tijd van de eerste aanval noteren. Na een paar sessies hebben we een gemiddelde tijd waarbinnen de speler in de toekomst zal aanvallen.
Gemiddelde waarden hebben ook een probleem: als een speler 20 keer 'gegend' heeft en 20 keer langzaam heeft gespeeld, zullen de benodigde waarden ergens in het midden liggen, wat ons niets nuttigs oplevert. Een van de oplossingen is om de invoergegevens te beperken—we kunnen de laatste 20 beschouwingen in overweging nemen.
Een vergelijkbare aanpak wordt gebruikt bij het beoordelen van de waarschijnlijkheid van bepaalde acties, waarbij wordt aangenomen dat de eerdere voorkeuren van de speler hetzelfde zullen zijn in de toekomst. Als de speler ons vijf keer met een fireball aanvalt, twee keer met een lightning spell en één keer met een melee-aanval, is het duidelijk dat hij de voorkeur geeft aan de fireball. We extrapoleren en zien de kans op het gebruik van verschillende wapens: fireball=62,5%, lightning=25% en melee=12,5%. Onze spel-AI moet zich voorbereiden op brandbescherming.
Een andere interessante methode is het gebruik van de Naive Bayes Classifier om grote hoeveelheden invoergegevens te bestuderen en de situatie te classificeren, zodat de AI op de juiste manier reageert. Bayesiaanse classifiers zijn het meest bekend vanwege hun gebruik in spamfilters voor e-mail. Daar onderzoeken ze woorden, vergelijken ze deze met waar deze woorden eerder zijn verschenen (in spam of niet), en trekken ze conclusies over binnenkomende berichten. We kunnen hetzelfde doen, zelfs met minder invoergegevens. Op basis van alle nuttige informatie die de AI ziet (bijvoorbeeld welke vijandelijke eenheden zijn gemaakt, of welke spreuken ze gebruiken, of welke technologieën ze hebben onderzocht), en het eindresultaat (oorlog of vrede, 'rushen' of verdedigen, enz.)—kies zullen we het juiste gedrag voor de AI.
Al deze leermethoden zijn voldoende, maar het is wenselijk om ze te baseren op gegevens uit testen. AI leert zich aan te passen aan verschillende strategieën die uw playtesters hebben gebruikt. AI die zich aanpast aan de speler na de release, kan te voorspelbaar worden of, anders gezegd, te moeilijk zijn om te verslaan.
Aanpassing op basis van waarden
Gezien de invulling van onze game wereld en regels, kunnen we de set waarden aanpassen die invloed hebben op beslissingen, in plaats van alleen de invoergegevens te gebruiken. We doen het als volgt:
- Laat AI gegevens verzamelen over de staat van de wereld en belangrijke gebeurtenissen tijdens het spel (zoals hierboven aangegeven).
- We passen een aantal belangrijke waarden aan op basis van deze gegevens.
- We implementeren onze beslissingen, gebaseerd op de verwerking of evaluatie van deze waarden.
Bijvoorbeeld, een agent heeft verschillende kamers om uit te kiezen op de kaart van een first-person shooter. Elke kamer heeft een eigen waarde die bepaalt hoe wenselijk het is om deze te bezoeken. AI kiest willekeurig welke kamer te betreden, gebaseerd op de waarde. Dan onthoudt de agent in welke kamer hij is gedood en verlaagt de waarde daarvan (de kans dat hij daar terugkeert). Hetzelfde geldt voor de tegenovergestelde situatie: als de agent veel tegenstanders verslaat, stijgt de waarde van de kamer.
Markov-model
Wat als we de verzamelde gegevens gebruiken om te voorspellen? Als we elke kamer onthouden waarin we de speler gedurende een bepaalde periode zien, kunnen we voorspellen naar welke kamer de speler kan gaan. Door de bewegingen van de speler door de kamers (waarden) te volgen en vast te leggen, kunnen we deze voorspellen.
Laten we drie kamers nemen: rood, groen en blauw. En ook de waarnemingen die we tijdens de spelsessie hebben vastgelegd:
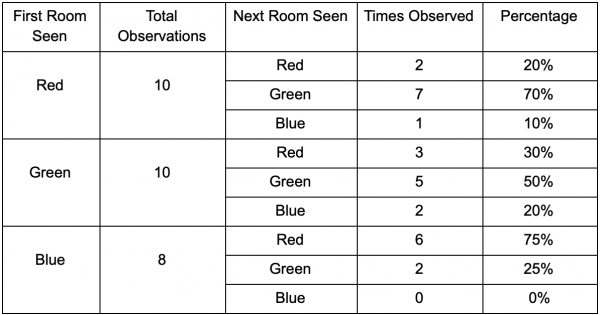
Het aantal waarnemingen voor elke kamer is bijna gelijk — waar we een goede plek voor een hinderlaag kunnen maken, weten we nog steeds niet. Het verzamelen van statistieken wordt ook bemoeilijkt door het respawnen van spelers, die gelijkmatig over de kaart verschijnen. Maar gegevens over de volgende kamer waar ze binnenkomen na hun verschijnen op de kaart, zijn al nuttig.
Het is duidelijk dat de groene kamer goed in de smaak valt bij de spelers - de meeste mensen uit de rode kamer gaan erheen, waarvan 50% daar ook blijft. De blauwe kamer daarentegen is niet populair; vrijwel niemand gaat erin, en als ze dat doen, blijven ze niet lang.
Maar de gegevens vertellen ons iets belangrijkers - wanneer een speler in de blauwe kamer is, is de volgende kamer waar we hem waarschijnlijk zullen zien de rode, niet de groene. Ondanks dat de groene kamer populairder is dan de rode, verandert de situatie als de speler in de blauwe is. De volgende toestand (dat wil zeggen de kamer waar de speler naartoe zal gaan) hangt af van de vorige toestand (de kamer waar de speler zich nu bevindt). Door het onderzoeken van afhankelijkheden voorspellen we nauwkeuriger dan wanneer we gewoon de waarnemingen onafhankelijk zouden tellen.
Het voorspellen van de toekomstige toestand op basis van gegevens uit de vorige toestand wordt een Markov-model genoemd, en dergelijke voorbeelden (met kamers) worden Markov-ketens genoemd. Aangezien modellen de waarschijnlijkheid van veranderingen tussen opeenvolgende toestanden weergeven, worden ze visueel weergegeven als FSM met een waarschijnlijkheid rond elke overgang. Eerder gebruikten we FSM om de gedragsstatus van de agent weer te geven, maar dit concept kan worden uitgebreid naar elke toestand, ongeacht of deze met een agent te maken heeft of niet. In dit geval vertegenwoordigen de toestanden de kamer die de agent bezet:
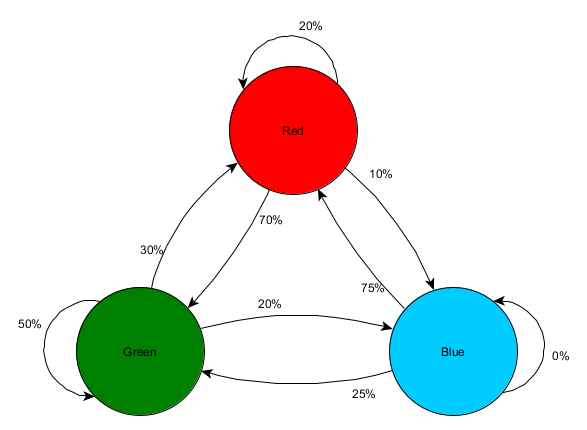
Dit is een eenvoudige manier om de relatieve waarschijnlijkheid van toestandsveranderingen weer te geven, waarmee AI een mogelijkheid krijgt om de volgende toestand te voorspellen. Er kan enkele stappen vooruit worden voorspeld.
Als de speler in de groene kamer is, is er 50% kans dat hij daar blijft bij de volgende waarneming. Maar wat is de kans dat hij daar zelfs nog steeds is na een volgende? Er is niet alleen een kans dat de speler in de groene kamer blijft na twee waarnemingen, maar ook de kans dat hij is weggegaan en daarna terugkeert. Hier is een nieuwe tabel op basis van de nieuwe gegevens:
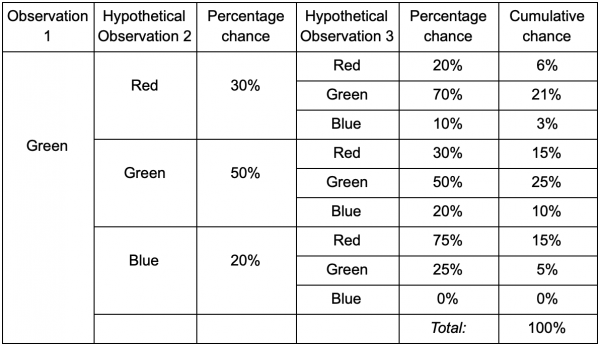
Hieruit blijkt dat de kans om de speler in de groene kamer te zien na twee waarnemingen gelijk zal zijn aan 51% - 21% dat hij uit de rode kamer komt, 5% dat de speler de blauwe kamer tussen de twee bezoeken heeft bezocht, en 25% dat de speler helemaal niet uit de groene kamer is gegaan.
Een tabel is gewoon een visueel hulpmiddel; de procedure vereist alleen het vermenigvuldigen van kansen op elke stap. Dit betekent dat je ver in de toekomst kunt kijken met één aanname: we veronderstellen dat de kans om een kamer binnen te gaan volledig afhankelijk is van de huidige kamer. Dit wordt de Markov-eigenschap genoemd — de toekomstige staat hangt alleen af van het huidige. Maar dit is niet honderd procent nauwkeurig. Spelers kunnen hun beslissingen veranderen op basis van andere factoren: gezondheid of hoeveelheid munitie. Omdat we deze waarden niet vastleggen, zullen onze voorspellingen minder nauwkeurig zijn.
N-Grammen
En wat te denken van het voorbeeld met vechten en het voorspellen van combo-aanvallen van de speler? Hetzelfde! Maar in plaats van één staat of gebeurtenis onderzoeken we hele reeksen van wat een combo-aanval vormt.
Een van de manieren om dit te doen is door elke invoer (bijvoorbeeld Kick, Punch of Block) in een buffer op te slaan en de hele buffer als een gebeurtenis vast te leggen. Dus als de speler herhaaldelijk Kick, Kick, Punch indrukt om de SuperDeathFist-aanval te gebruiken, slaat het AI-systeem alle invoeren in de buffer op en onthoudt de laatste drie, gebruikt op elke stap.
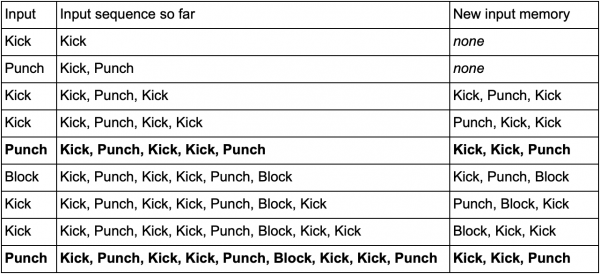
(Vetgedrukt zijn de regels wanneer de speler de SuperDeathFist-aanval start.)
AI zal alle opties zien wanneer de speler Kick kiest, gevolgd door nog een Kick, en daarna opmerkt dat de volgende invoer altijd Punch is. Dit stelt de agent in staat om de SuperDeathFist-combo-aanval te voorspellen en deze te blokkeren, indien mogelijk.
Deze reeksen van gebeurtenissen worden N-grammen genoemd, waarbij N het aantal opgeslagen elementen is. In het vorige voorbeeld was dit een 3-gram (trigram), wat betekent: de eerste twee invoeren worden gebruikt om de derde te voorspellen. Evenzo in een 5-gram voorspellen de eerste vier invoeren de vijfde, enzovoort.
De ontwikkelaar moet de grootte van de N-grammen zorgvuldig kiezen. Een kleiner N vereist minder geheugen, maar slaat ook minder geschiedenis op. Bijvoorbeeld, een 2-gram (bigram) zou Kick, Kick of Kick, Punch registreren, maar kan Kick, Kick, Punch niet opslaan, waardoor de AI niet op de SuperDeathFist-combo kan reageren.
Aan de andere kant vereisen grotere getallen meer geheugen en zal het voor de AI moeilijker zijn om te leren, omdat er veel meer mogelijke opties zullen zijn. Als je drie mogelijke invoeren had: Kick, Punch of Block, en we gebruikten een 10-gram, zou dat ongeveer 60.000 verschillende mogelijkheden opleveren.
Een bigrammodel is een eenvoudige Markov-keten - elk paar "vorige toestand/huidige toestand" is een bigram, en je kunt de tweede toestand voorspellen op basis van de eerste. Een trigram en grotere N-grams kunnen ook worden beschouwd als Markov-ketens, waarbij alle elementen (behalve de laatste in de N-gram) samen de eerste toestand vormen, en het laatste element de tweede toestand is. Een voorbeeld met vechten toont de kans van overgaan van de toestand Kick en Kick naar de toestand Kick en Punch. Door meerdere records van de invoergeschiedenis als één eenheid te beschouwen, transformeren we de invoervolgorde in een deel van een geheel. Dit geeft ons de Markov-eigenschap, die het mogelijk maakt om Markov-ketens te gebruiken voor het voorspellen van de volgende invoer en te raden welke combo-beweging de volgende zal zijn.
Conclusie
We hebben gesproken over de meest voorkomende tools en benaderingen in de ontwikkeling van kunstmatige intelligentie. En we hebben ook situaties besproken waarin ze moeten worden toegepast en waar ze bijzonder nuttig zijn.
Dit zou voldoende moeten zijn om de basisprincipes van game AI te begrijpen. Maar natuurlijk zijn dit lang niet alle methoden. Minder populaire, maar niet minder effectieve omvatten:
- optimalisatie-algoritmen, waaronder hill climbing, gradient descent en genetische algoritmen
- competitieve zoek/planning algoritmen (minimax en alpha-beta pruning)
- classificatiemethoden (perceptrons, neurale netwerken en support vector machines)
- systemen voor het verwerken van perceptie en geheugen van agenten
- architecturale benaderingen voor AI (hybride systemen, subsetarchitecturen en andere manieren om AI-systemen te combineren)
- animatietools (planning en coördinatie van beweging)
- prestatiefactoren (niveau van detail, anytime-algoritmen en timeslicing)
Online bronnen over het onderwerp:
1. Op GameDev.net is er , evenals .
2. bevat een schat aan presentaties en artikelen over een breed scala aan onderwerpen gerelateerd aan de ontwikkeling van game AI.
3. bevat onderwerpen van de GDC AI-summit, waarvan veel gratis beschikbaar zijn.
4. Nuttige materialen zijn ook te vinden op de site .
5. Tommy Thompson, AI-onderzoeker en game-ontwikkelaar, maakt video's op het YouTube-kanaal met uitleg en studie van AI in commerciële games.
Boeken over het onderwerp:
1. De boekenset Game AI Pro bestaat uit verzamelingen van korte artikelen die uitleggen hoe specifieke functies geïmplementeerd kunnen worden of hoe bepaalde problemen opgelost kunnen worden.
2. De serie AI Game Programming Wisdom is de voorganger van de serie Game AI Pro. Hierin staan oudere methoden, maar bijna alle zijn vandaag de dag nog steeds relevant.
3. — is een van de basisboeken voor iedereen die de algemene domeinen van kunstmatige intelligentie wil begrijpen. Dit boek is niet over gameontwikkeling — het leert de basisprincipes van AI.
Bron: habr.com
