

Fault tolerance and high availability are broad topics, so we will dedicate separate articles to RabbitMQ and Kafka. This article is about RabbitMQ, and the next one will be about Kafka, in comparison to RabbitMQ. The article is long, so make yourself comfortable.
We will discuss fault tolerance strategies, consistency, and high availability (HA), as well as the trade-offs that come with each strategy. RabbitMQ can operate on a cluster of nodes, classifying it as a distributed system. When it comes to distributed systems, we often talk about consistency and availability.
These concepts describe how a system behaves during a failure. Network connection failure, server failure, hard disk failure, temporary server unavailability due to garbage collection, packet loss, or slowed network connection. All of these can lead to data loss or conflicts. It turns out that it is practically impossible to have a system that is both completely consistent (without data loss, without data discrepancies) and available (able to accept read and write operations) for all types of failures.
We will see that consistency and availability are on opposite ends of the spectrum, and you need to choose which way to optimize. The good news is that with RabbitMQ such a choice is possible. You have some 'nerdy' levers to shift the balance towards greater consistency or greater availability.
We will pay special attention to which configurations lead to data loss due to acknowledged messages. There is a chain of responsibility between publishers, brokers, and consumers. Once a message is handed over to the broker, it is their job not to lose the message. When the broker acknowledges receipt of the message to the publisher, we do not expect it to be lost. But we will see that this can indeed happen depending on your broker and publisher's configuration.
Single-node resilience primitives
Resilient queues/routing
In RabbitMQ zijn er twee soorten wachtrijen: duurzame (durable) en niet-duurzame (non-durable). Alle wachtrijen worden opgeslagen in de Mnesia-database. Duurzame wachtrijen worden opnieuw verklaard bij het opstarten van de node en overleven daarom een herstart, systeemfout of servercrash (zolang de gegevens behouden blijven). Dit betekent dat zolang je de routing (exchange) en wachtrij als duurzaam declareert, de infrastructuur van wachtrijen/routing opnieuw operationeel zal zijn.
Niet-duurzame wachtrijen en routing worden verwijderd bij het herstarten van de node.
Duurzame berichten
Het feit dat een wachtrij duurzaam is, betekent niet dat al zijn berichten de herstart van de node overleven. Alleen de berichten die door de publisher als duurzaam (persistent) zijn ingesteld, worden hersteld. Duurzame berichten creëren echt een extra belasting voor de broker, maar als het verlies van een bericht onacceptabel is, is er geen andere optie.
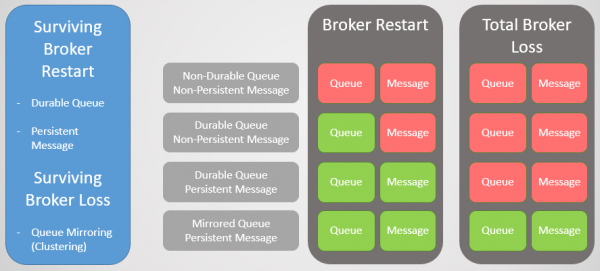
Figuur 1. Duurzaamheidsmatrix
Clustering met wachtrijspiegeling
Om het verlies van de broker te overleven, hebben we redundantie nodig. We kunnen meerdere RabbitMQ-nodes in een cluster samenvoegen en vervolgens extra redundantie toevoegen door wachtrijen tussen verschillende nodes te repliceren. Op deze manier, als één node uitvalt, verliezen we geen gegevens en blijven we beschikbaar.
Wachrijspiegeling:
- één hoofdwachtrij (master), die alle schrijf- en leesopdrachten ontvangt
- één of meerdere spiegels, die alle berichten en metadata uit de hoofdwachtrij ontvangen. Deze spiegels zijn niet bedoeld voor schaalvergroting, maar uitsluitend voor redundantie.
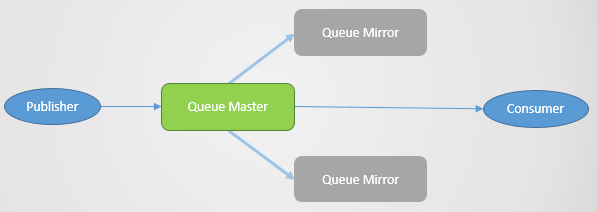
Figuur 2. Wachrijspiegeling
Wachrijspiegeling wordt ingesteld met de juiste beleidsregels. In deze beleidsregels kan de replicatiefactor worden gekozen en zelfs de nodes waarop de wachtrij moet worden geplaatst. Voorbeelden:
ha-mode: allha-mode: exactly, ha-params: 2(één master en één spiegel)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Bevestiging aan de publisher
Voor een consistente opslag zijn bevestigingen van de publisher nodig (Publisher Confirms). Zonder deze bestaat de kans op verlies van berichten. De bevestiging wordt naar de publisher gestuurd nadat het bericht op de schijf is opgeslagen. RabbitMQ slaat berichten niet op bij ontvangst, maar op een periodieke basis, ongeveer enkele honderden milliseconden. Wanneer een wachtrij wordt gespiegeld, wordt de bevestiging pas verzonden nadat alle spiegels ook hun kopie van het bericht op de schijf hebben opgeslagen. Dit betekent dat het gebruik van bevestigingen vertraging met zich meebrengt, maar als gegevensbeveiliging van belang is, zijn ze noodzakelijk.
Foutbestendige wachtrij
Wanneer de broker stopt of crasht, vallen alle hoofd wachtrijen (masters) op deze node samen met hem uit. Vervolgens kiest het cluster de oudste spiegel van elke master en promoot deze tot de nieuwe master.
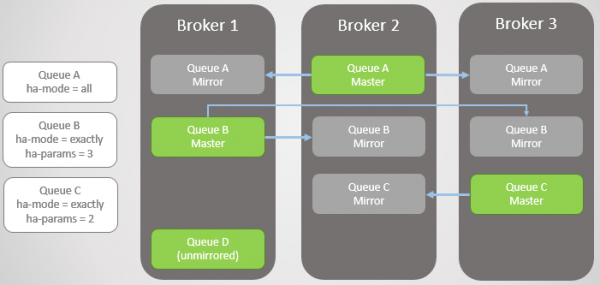
Figuur 3. Meerdere gespiegelde wachtrijen en hun beleidsregels
Broker 3 crasht. Merk op dat de spiegel van Wachtrij C op Broker 2 wordt gepromoveerd tot master. Let ook op dat er een nieuwe spiegel voor Wachtrij C wordt aangemaakt op Broker 1. RabbitMQ probeert altijd de replicatiefactor te handhaven zoals aangegeven in uw beleidsregels.
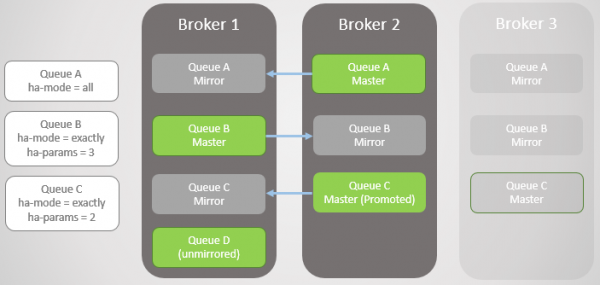
Figuur 4. Broker 3 valt uit, wat de storing van Wachtrij C veroorzaakt
De volgende Broker 1 valt uit! We hebben nog maar één broker over. De spiegel van Wachtrij B wordt gepromoveerd tot master.
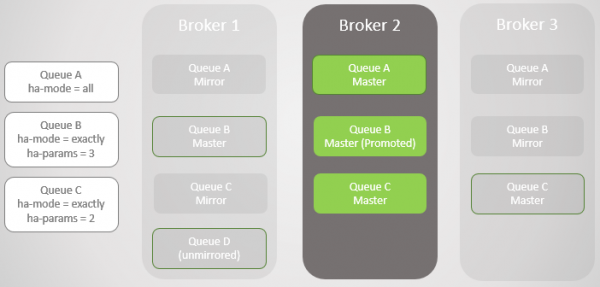
Figuur 5
We hebben Broker 1 hersteld. Ongeacht hoe succesvol de gegevens de verlies en herstart van de broker hebben doorstaan, worden alle gespiegelde wachtrijberichten verworpen bij de herstart. Dit is belangrijk om op te merken, omdat er gevolgen aan verbonden zijn. We zullen deze gevolgen snel bespreken. Broker 1 is nu weer lid van het cluster, en het cluster probeert zich aan de beleidsregels te houden en maakt daarom spiegels aan op Broker 1.
In dit geval was het verlies van Broker 1 volledig, evenals de gegevens, dus de niet-gespiegelde Wachtrij B is volledig verloren.
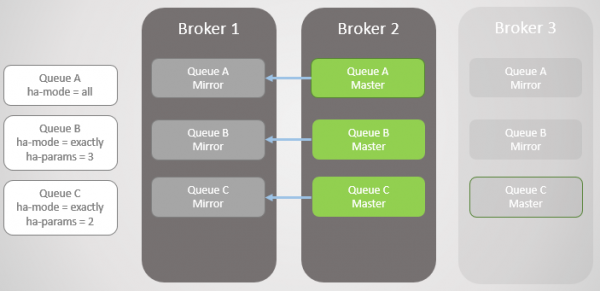
Figuur 6. Broker 1 komt weer online
Broker 3 is weer operationeel, zodat de wachtrijen A en B hun gehanteerde spiegels terugkrijgen om in hun HA-beleid te voorzien. Maar nu staan alle hoofdwachtrijen op één knooppunt! Dit is niet ideaal, een gelijkmatige verdeling over de knooppunten is beter. Helaas zijn er hier geen speciale opties voor het herschikken van de master. We komen hier later op terug, want eerst moet de synchronisatie van de wachtrij worden besproken.
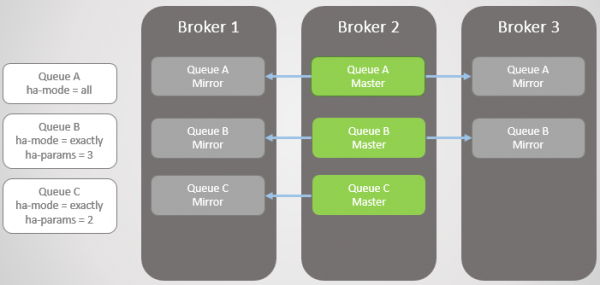
Figuur 7. Broker 3 komt weer operationeel. Alle hoofdwachtrijen staan op één knooppunt!
Zo heeft u nu een idee hoe spiegels redundantie en fouttolerantie bieden. Dit garandeert beschikbaarheid in het geval van een storing van een knooppunt en beschermt tegen gegevensverlies. Maar we zijn nog niet klaar, want het is in werkelijkheid veel ingewikkelder.
Synchronisatie
Bij het aanmaken van een nieuw spiegel worden alle nieuwe berichten altijd gerepliceerd naar deze spiegel en naar andere. Wat betreft bestaande gegevens in de hoofdwachtrij, kunnen we ze repliceren naar de nieuwe spiegel, die een volledige kopie van de master wordt. We kunnen ook besluiten om bestaande berichten niet te repliceren en laten de hoofdwachtrij en de nieuwe spiegel synchroniseren in de tijd, waarbij nieuwe berichten aan het einde komen en bestaande berichten uit het begin van de hoofdwachtrij verdwijnen.
Deze synchronisatie gebeurt automatisch of handmatig en wordt beheerd via het beleid van de wachtrijen. Laten we een voorbeeld bekijken.
We hebben twee gespiegelde wachtrijen. Wachtrij A synchroniseert automatisch, terwijl Wachtrij B handmatig synchroniseert. In beide wachtrijen zijn tien berichten.
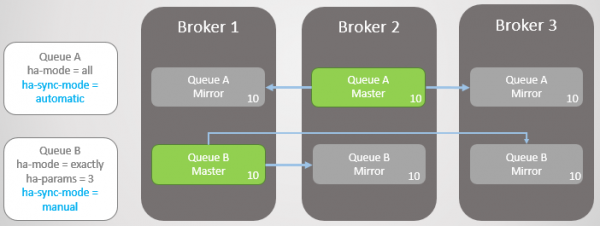
Figuur 8. Twee wachtrijen met verschillende synchronisatiestanden
Nu verliezen we Broker 3.
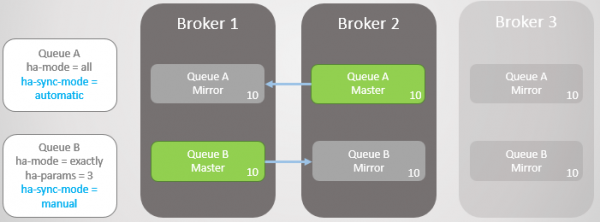
Figuur 9. Broker 3 is uitgevallen
Broker 3 komt weer operationeel. De cluster creëert een spiegel voor elke wachtrij op een nieuw knooppunt en synchroniseert automatisch de nieuwe Wachtrij A met de master. Echter, de spiegel van de nieuwe Wachtrij B blijft leeg. Zo hebben we volledige redundantie voor Wachtrij A en slechts één spiegel voor de bestaande berichten van Wachtrij B.
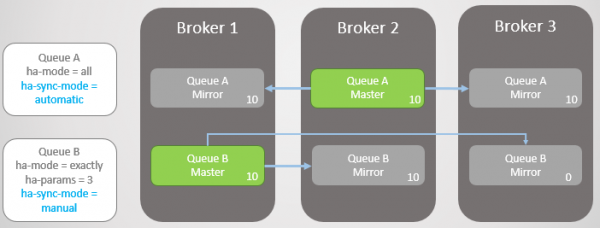
Figuur 10. De nieuwe spiegel van Wachtrij A ontvangt alle bestaande berichten, terwijl de nieuwe spiegel van Wachtrij B dat niet doet
In beide wachtrijen komen nog eens tien berichten binnen. Dan valt Broker 2 uit, en Wachtrij A keert terug naar het oudste spiegelbeeld dat zich op Broker 1 bevindt. Bij de storing vindt er geen dataverlies plaats. In Wachtrij B zijn er twintig berichten in de master en slechts tien in de spiegel, omdat deze wachtrij de oorspronkelijke tien berichten nooit heeft gerepliceerd.
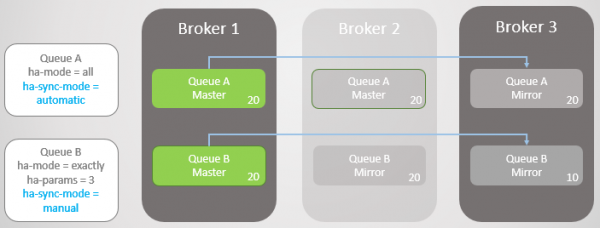
Fig. 11. Wachtrij A keert terug naar Broker 1 zonder verlies van berichten.
In beide wachtrijen komen weer tien berichten binnen. Nu valt Broker 1 uit. Wachtrij A schakelt zonder problemen over naar de spiegel zonder verlies van berichten. Echter, Wachtrij B ondervindt problemen. Op dit moment kunnen we ofwel de beschikbaarheid ofwel de consistentie optimaliseren.
Als we de beschikbaarheid willen optimaliseren, dan moet het beleid ha-promote-on-failure worden ingesteld op altijd. Deze waarde is standaard, dus het is ook mogelijk om het beleid helemaal niet op te geven. In dat geval staan we in wezen uitval toe in ongesynchroniseerde spiegels. Dit leidt tot dataverlies, maar de wachtrij blijft lees- en schrijfbaar.
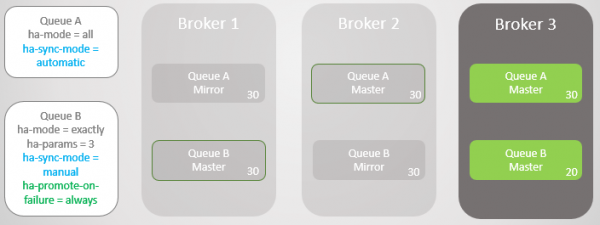
Fig. 12. Wachtrij A keert terug naar Broker 3 zonder verlies van berichten. Wachtrij B keert terug naar Broker 3 met verlies van tien berichten.
We kunnen ook instellen ha-promote-on-failure op de waarde van when-synced. In dat geval wacht de wachtrij in plaats van terug te keren naar de spiegel tot Broker 1 met zijn gegevens weer operationeel is. Na zijn terugkeer komt de hoofdwachtrij weer op Broker 1 zonder verlies van gegevens. Beschikbaarheid wordt opgeofferd voor gegevensveiligheid. Maar dit is een risicovolle modus, die zelfs kan leiden tot volledig dataverlies, wat we binnenkort zullen bekijken.
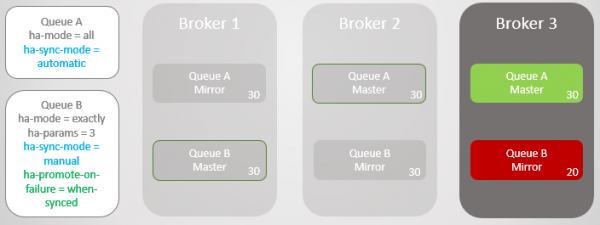
Fig. 13. Wachtrij B blijft niet toegankelijk na de uitval van Broker 1.
Je zou kunnen vragen: "Misschien is het beter om automatische synchronisatie nooit te gebruiken?". Het antwoord is dat synchronisatie een blokkering is. Tijdens de synchronisatie kan de hoofdwachtrij geen lees- of schrijfoperaties uitvoeren!
Laten we een voorbeeld overwegen. We hebben nu zeer grote wachtrijen. Hoe kunnen ze zo groot worden? Om verschillende redenen:
- Wachtrijen worden niet actief gebruikt.
- Dit zijn supersnelle wachtrijen, en op dit moment werken de consumenten langzaam.
- Dit zijn supersnelle wachtrijen, er is een storing opgetreden, en de consumenten halen in.
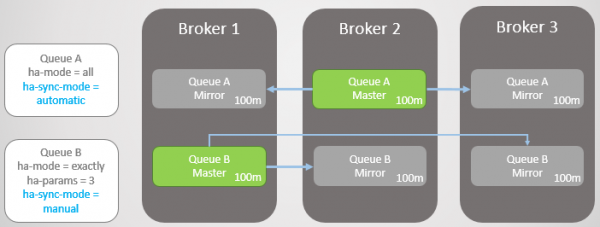
Fig. 14. Twee grote wachtrijen met verschillende synchronisatiemodi
Nu valt Broker 3 uit.
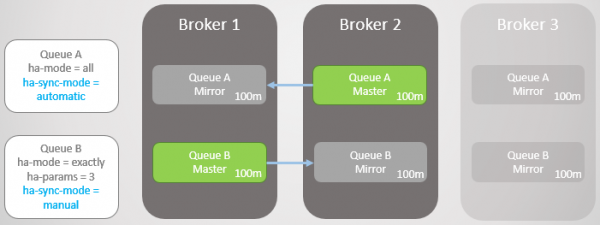
Fig. 15. Broker 3 valt uit, waarbij er één master en één mirror in elke wachtrij overblijft
Broker 3 komt weer online, en nieuwe spiegels worden aangemaakt. Hoofdwachtrij A begint bestaande berichten naar de nieuwe mirror te repliceren, en gedurende deze tijd is de wachtrij niet beschikbaar. De replicatie van gegevens duurt twee uur, wat leidt tot twee uur stilstand voor deze wachtrij!
Echter, Wachtrij B blijft gedurende de hele periode beschikbaar. Het heeft wat redundantie opgeofferd voor beschikbaarheid.
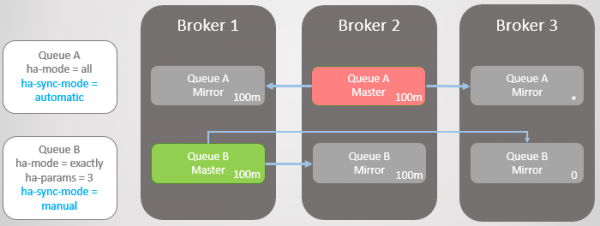
Fig. 16. De wachtrij blijft tijdens synchronisatie niet beschikbaar
Na twee uur wordt Wachtrij A ook weer beschikbaar en kan het opnieuw lees- en schrijfoperaties uitvoeren.
Updates
Dit blokkeren tijdens de synchronisatie bemoeilijkt het bijwerken van clusters met zeer grote wachtrijen. Op een bepaald moment moet de node met de master opnieuw worden opgestart, wat betekent dat we ofwel naar de mirror overschakelen, of de wachtrij uitschakelen tijdens de serverupdate. Als we kiezen voor overschakelen, verliezen we berichten als de spiegels niet gesynchroniseerd zijn. Standaard wordt tijdens het uitschakelen van de broker niet overgeschakeld op een niet-gesynchroniseerde mirror. Dit betekent dat zodra de broker terugkomt, we geen berichten verliezen; de enige schade was de stilstand van de wachtrij. Het gedrag bij het uitschakelen van de broker wordt bepaald door het beleid ha-promote-on-shutdown. Een van de twee waarden kan worden ingesteld:
altijd= overschakelen naar niet-gesynchroniseerde spiegels is ingeschakeldwhen-synced= overschakelen alleen naar de gesynchroniseerde mirror, anders wordt de wachtrij niet beschikbaar voor lezen en schrijven. De wachtrij komt weer online zodra de broker terugkomt
Hoe dan ook, met grote wachtrijen moet worden gekozen tussen dataverlies en onbeschikbaarheid.
Wanneer beschikbaarheid de gegevensbeveiliging verhoogt
Voordat een beslissing wordt genomen, moet nog een complicatie in overweging worden genomen. Hoewel automatische synchronisatie beter is voor redundantie, hoe beïnvloedt het de gegevensbeveiliging? Natuurlijk, met betere redundantie heeft RabbitMQ minder kans om bestaande berichten te verliezen, maar hoe zit het met nieuwe berichten van publishers?
Hier moet het volgende in overweging worden genomen:
- Kan een publisher gewoon een fout teruggeven, waarna de bovenliggende service of gebruiker later een nieuwe poging doet?
- Kan een publisher een bericht lokaal of in een database opslaan om later opnieuw te proberen?
Als de publisher slechts een bericht kan afwijzen, verbetert het verbeteren van de beschikbaarheid ook de beveiliging van gegevens.
Daarom moeten we naar een balans zoeken, en de oplossing hangt af van de specifieke situatie.
Problemen met ha-promote-on-failure=when-synced
Idee ha-promote-on-failure= when-synced bestaat uit het voorkómen van overschakelen naar een niet-synchroon spiegel en zo het verlies van gegevens te vermijden. De wachtrij blijft onleesbaar en niet schrijfbaar. In plaats daarvan proberen we de gecrashte broker met onbeschadigde gegevens weer op te starten, zodat deze als master verder kan werken zonder gegevensverlies.
Maar (en dat is een groot maar) als de broker zijn gegevens heeft verloren, hebben we een groot probleem: de wachtrij is verloren! Alle gegevens zijn verdwenen! Zelfs als je spiegelt die meestal de hoofdwachtrij inhalen, worden ook deze spiegels afgewezen.
Om een knooppunt met dezelfde naam opnieuw toe te voegen, zeggen we tegen het cluster de verloren knooppunt te vergeten (met het commando rabbitmqctl forget_cluster_node) en een nieuwe broker met dezelfde hostnaam te starten. Zolang het cluster de verloren knooppunt herinnert, herinnert het zich de oude wachtrij en niet-synchrone spiegels. Wanneer we het cluster zeggen de verloren knooppunt te vergeten, wordt deze wachtrij ook vergeten. Nu moet deze opnieuw worden aangekondigd. We hebben alle gegevens verloren, hoewel we spiegels met een gedeeltelijke set gegevens hadden. Het zou beter zijn geweest om over te schakelen naar een niet-synchroon spiegel!
Daarom is handmatige synchronisatie (en het niet uitvoeren van synchronisatie) in combinatie met ha-promote-on-failure=when-synced, naar mijn mening, behoorlijk riskant. Documenten zeggen dat deze optie bestaat voor gegevensbeveiliging, maar het is een dubbelzijdig mes.
Herbalanceren van masters
Zoals beloofd, keren we terug naar het probleem van het samenklonteren van alle masters op één of enkele knooppunten. Dit kan zelfs gebeuren door een "rolling" update van het cluster. In een cluster met drie knooppunten zullen alle hoofdwachtrijen zich op één of twee knooppunten verzamelen.
Herbalanceren van masters kan problematisch zijn om twee redenen:
- Er zijn geen goede tools voor het uitvoeren van herbalancering
- Synchronisatie van wachtrijen
Voor herbalancering is er een derde partij , die niet officieel wordt ondersteund. Met betrekking tot externe plugins in de RabbitMQ-handleiding : «De plugin biedt enkele extra hulpmiddelen voor configuratie en rapportage, maar wordt niet ondersteund of geverifieerd door het RabbitMQ-team. Gebruik het op eigen risico».
Er is nog een andere truc om de primaire wachtrij te verplaatsen via HA-beleidsregels. Dit wordt genoemd in de handleiding voor dit doel. Het werkt als volgt:
- Verwijdert alle spiegels met behulp van een tijdelijke beleidsregel met een hogere prioriteit dan de bestaande HA-beleidsregel.
- Wijzigt de tijdelijke HA-beleidsregel om de modus 'nodes' te gebruiken met de vermelding van de node waaraan de primaire wachtrij moet worden verplaatst.
- Synchroniseert de wachtrij voor gedwongen migratie.
- Na voltooiing van de migratie verwijdert het de tijdelijke beleidsregel. De oorspronkelijke HA-beleidsregel komt weer in werking en het vereiste aantal spiegels wordt aangemaakt.
Een nadeel van deze aanpak is dat deze mogelijk niet werkt als je grote wachtrijen of strikte eisen aan redundantie hebt.
Laten we nu bekijken hoe RabbitMQ-clusters omgaan met netwerkpartities.
Verbetering van consistentie
Nodes in een gedistribueerd systeem zijn verbonden via netwerkkoppelingen, en deze netwerkkoppelingen kunnen en zullen uitvallen. De frequentie van uitval hangt af van de lokale infrastructuur of de betrouwbaarheid van de gekozen cloud. Hoe dan ook, gedistribueerde systemen moeten in staat zijn om hiermee om te gaan. We staan opnieuw voor de keuze tussen beschikbaarheid en consistentie, en het goede nieuws is dat RabbitMQ beide opties biedt (maar nooit tegelijkertijd).
Met RabbitMQ hebben we twee hoofdmogelijkheden:
- Logisch splitsen (split-brain) toestaan. Dit zorgt voor beschikbaarheid, maar kan gegevensverlies veroorzaken.
- Logisch splitsen verbieden. Dit kan leiden tot tijdelijk verlies van beschikbaarheid, afhankelijk van hoe clients verbinding maken met het cluster. Het kan ook leiden tot totale onbeschikbaarheid in een cluster bestaande uit twee nodes.
Maar wat is logisch splitsen? Dit is wanneer een cluster in tweeën wordt gesplitst door het verlies van netwerkkoppelingen. Aan elke kant worden spiegels gepromoveerd tot master, zodat uiteindelijk meerdere masters op elke wachtrij staan.
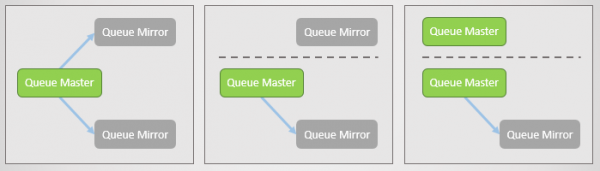
Figuur 17. De hoofdqueue en twee spiegels, elk op een aparte knooppunt. Dan ontstaat er een netwerkstoring en scheidt één spiegel. De gescheiden knooppunt ziet dat de twee andere zijn uitgevallen en bevordert zijn spiegels tot de master. Nu hebben we twee hoofdqueues, en beide staan schrijf- en leesoperaties toe.
Als publishers gegevens naar beide masters verzenden, krijgen we twee uiteenlopende kopieën van de queue.
Verschillende modi van RabbitMQ bieden ofwel beschikbaarheid ofwel consistentie.
De modus Ignore (standaardinstelling)
Deze modus biedt beschikbaarheid. Na een verlies van connectiviteit vindt er een logische splitsing plaats. Na het herstellen van de connectiviteit moet de beheerder beslissen welke sectie de voorkeur heeft. De verliezende kant wordt opnieuw opgestart, en alle verzamelde gegevens aan die kant gaan verloren.
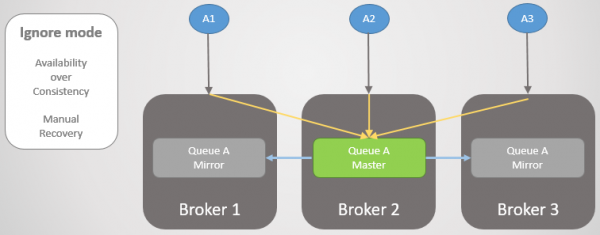
Figuur 18. Drie publishers zijn verbonden met drie brokers. Intern stuurt het cluster alle verzoeken naar de hoofqueue op Broker 2.
Nu verliezen we Broker 3. Deze ziet dat de andere brokers zijn uitgevallen en bevordert zijn spiegel tot master. Dit leidt tot een logische splitsing.
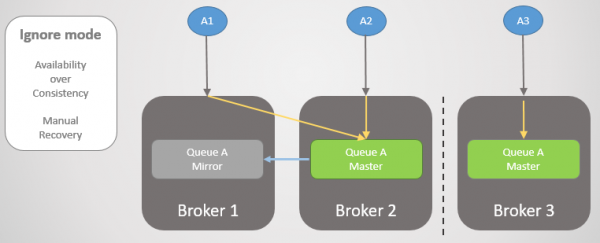
Figuur 19. Logische splitsing (split-brain). Schrijfacties gaan naar twee hoofdqueues en twee kopieën divergeren.
De connectiviteit herstelt zich, maar de logische splitsing blijft bestaan. De beheerder moet handmatig de verliezende kant kiezen. In het onderstaande geval herstart de beheerder Broker 3. Alle berichten die niet zijn verzonden, gaan verloren.
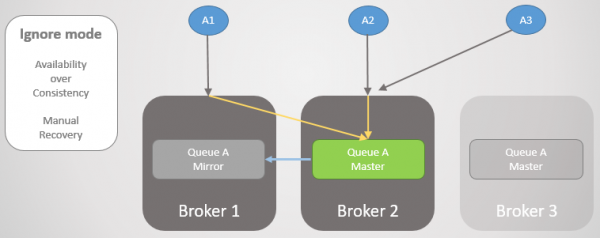
Figuur 20. De beheerder schakelt Broker 3 uit.
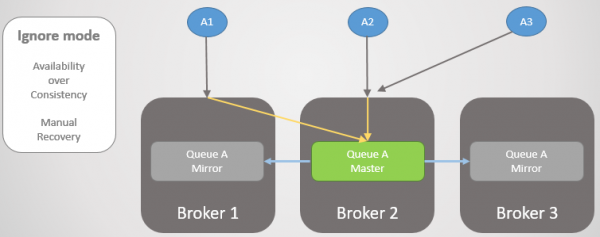
Figuur 21. De beheerder start Broker 3, en deze voegt zich bij het cluster, waarbij alle berichten die daar waren achtergebleven verloren gaan.
Tijdens het verlies van connectiviteit en na het herstel was het cluster en deze queue beschikbaar voor lezen en schrijven.
De modus Autoheal
Werkt vergelijkbaar met de modus Ignore, met dien verstande dat het cluster automatisch de verliezende kant kiest na een splitsing en herstel van connectiviteit. De verliezende kant keert leeg terug naar het cluster, en de queue verliest alle berichten die alleen naar die kant waren verzonden.
De modus Pause Minority
Als we logische splitsing willen voorkomen, is onze enige optie om te stoppen met lezen en schrijven aan de kleinere kant na de clusteronderbreking. Wanneer de broker ziet dat hij aan de kleinere kant is, stopt hij met werken, d.w.z. hij sluit alle bestaande verbindingen en weigert nieuwe. Een keer per seconde controleert hij het herstel van de connectiviteit. Zodra de connectiviteit hersteld is, herstart hij en voegt zich weer bij het cluster.
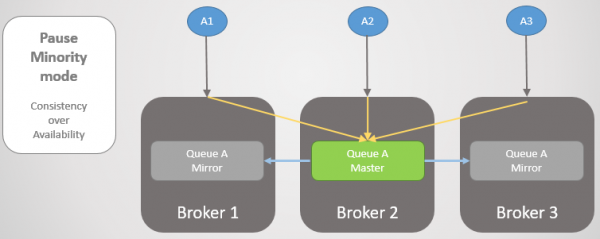
Figuur 22. Drie publishers zijn verbonden met drie brokers. Intern stuurt het cluster alle aanvragen naar de hoofqueue op Broker 2.
Daarna scheiden Brokers 1 en 2 zich van Broker 3. In plaats van zijn spiegel naar master te verhogen, stopt Broker 3 met werken en wordt onbereikbaar.
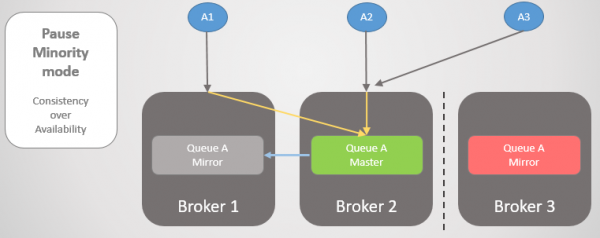
Figuur 23. Broker 3 stopt met werken, ontkoppelt alle klanten en weigert verbindingsaanvragen.
Zodra de connectiviteit hersteld is, keert hij terug naar het cluster.
Laten we een ander voorbeeld bekijken, waarbij de hoofqueue op Broker 3 staat.
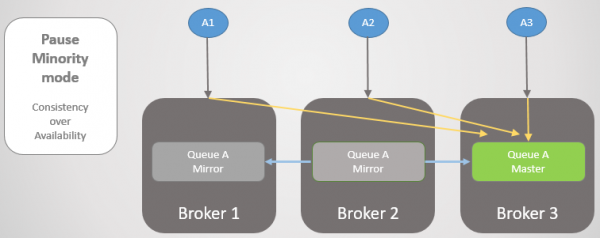
Figuur 24. De hoofqueue op Broker 3.
Dan treedt dezelfde connectiviteitsverliezen op. Broker 3 gaat op pauze, omdat hij aan de kleinere kant staat. Aan de andere kant zien de knooppunten dat Broker 3 is uitgevallen, zodat de oudere spiegel van Brokers 1 en 2 naar master wordt verhoogd.
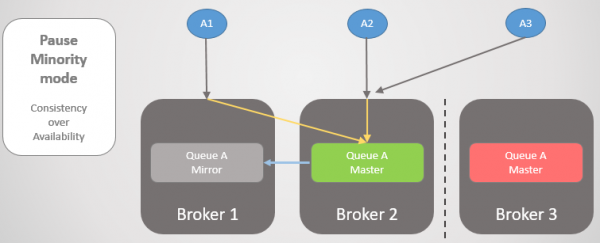
Figuur 25. Overschakeling naar Broker 2 bij de onbereikbaarheid van Broker 3.
Wanneer de connectiviteit is hersteld, zal Broker 3 zich bij het cluster voegen.

Figuur 26. Het cluster is teruggekeerd naar normale werking.
Hier is het belangrijk om te begrijpen dat we consistentie bereiken, maar ook beschikbaarheid kunnen verkrijgen. als we kunnen de klanten met succes naar het grotere deel van de sectie overbrengen. Voor de meeste situaties zou ik persoonlijk de Pause Minority-modus kiezen, maar dit hangt echt af van het specifieke geval.
Om beschikbaarheid te waarborgen, is het belangrijk om ervoor te zorgen dat klanten succesvol verbinding maken met de knoop. Laten we onze opties bekijken.
Het waarborgen van de connectiviteit van klanten
Wij hebben verschillende manieren om klanten na een verbindingsverlies naar de hoofdcluster of naar werkende knooppunten (na uitval van een knooppunt) te leiden. Laten we eerst herinneren dat een specifieke wachtrij op een bepaald knooppunt wordt geplaatst, maar dat de routering en beleidsregels op alle knooppunten worden gerepliceerd. Klanten kunnen verbinding maken met elk knooppunt, en de interne routering zal hen naar de juiste plek sturen. Maar wanneer een knooppunt is gepauzeerd, weigert het verbindingen, waardoor klanten verbinding moeten maken met een ander knooppunt. Als een knooppunt is uitgevallen, kan het daar nauwelijks iets aan doen.
Onze opties:
- Toegang tot het cluster gebeurt via een load balancer die simpelweg de knooppunten in een ronde afloopt, waarbij klanten opnieuw verbinding proberen te maken tot een succesvolle verbinding is gemaakt. Als een knooppunt niet werkt of is gepauzeerd, zullen de verbindingspogingen naar dat knooppunt mislukken, maar volgende pogingen zullen naar andere servers gaan (in cyclische modus). Dit is geschikt voor kortdurend verbindingsverlies of een server die snel weer online kan komen.
- Toegang tot het cluster via een load balancer en het verwijderen van gepauzeerde/uitgevallen knooppunten uit de lijst zodra deze zijn gedetecteerd. Als dit snel gebeurt en klanten in staat zijn om opnieuw verbinding te maken, krijgen we een constante beschikbaarheid.
- Geef elke klant een lijst van alle knooppunten, en de klant kiest willekeurig een van hen bij het maken van een verbinding. Als bij het maken van de verbinding een fout optreedt, gaat hij naar het volgende knooppunt in de lijst totdat hij verbinding maakt.
- Verwijder het verkeer van het uitgevallen/gepauzeerde knooppunt met behulp van DNS. Dit wordt gedaan met een korte TTL.
Conclusies
RabbitMQ-cluster heeft zijn eigen voordelen en nadelen. De meest ernstige nadelen zijn dat:
- bij het aansluiten op het cluster knooppunten hun gegevens afwijzen;
- blokkering synchronisatie leidt tot onbeschikbaarheid van de wachtrij.
Alle moeilijke beslissingen komen voort uit deze twee kenmerken van de architectuur. Als RabbitMQ gegevens zou kunnen opslaan bij het opnieuw verbinden van de cluster, zou de synchronisatie sneller plaatsvinden. Als het in staat zou zijn om niet-blokkerende synchronisatie uit te voeren, zou het beter grote wachtrijen ondersteunen. Het oplossen van deze twee problemen zou de prestaties van RabbitMQ als fouttolerante en hoogbeschikbare messaging-technologie aanzienlijk verbeteren. Ik zou RabbitMQ met clustering in de volgende situaties niet aanraden:
- Onbetrouwbaar netwerk.
- Onbetrouwbare opslag.
- Zeer grote wachtrijen.
Wat betreft instellingen voor hoge beschikbaarheid, overweeg de volgende:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(ofautoheal)- betrouwbare berichten
- zorg ervoor dat clients verbinding maken met de actieve node wanneer een node uitvalt
Voor consistentie (gegevensbeveiliging) overweeg de volgende instellingen:
- Publisher Confirms en Handmatige Bevestigingen aan de kant van de consument
ha-promote-on-failure=when-synced, als uitgevers later opnieuw kunnen proberen en als je zeer betrouwbare opslag hebt! Anders zet je=always.ha-sync-mode=automatic(maar voor grote inactieve wachtrijen kan handmatige modus nodig zijn; bovendien, overweeg of een onbeschikbaarheid kan leiden tot verlies van berichten)- Pause Minority modus
- betrouwbare berichten
We hebben nog niet alle aspecten van fouttolerantie en hoge beschikbaarheid behandeld; bijvoorbeeld hoe veilig administratieve procedures uit te voeren (zoals geleidelijke updates). We moeten ook praten over federatie en de Shovel-plugin.
Als ik nog iets ben vergeten, laat het me weten.
Zie ook mijn , waar ik een ramp op de RabbitMQ-cluster uitvoer met Docker en Blockade om enkele scenario's van berichtverlies te testen zoals beschreven in dit artikel.
Vorige artikelen in de serie:
Nr. 1 —
Nr. 2 —
Nr. 3 —
Bron: habr.com
