

In dit artikel bespreken we functionele afhankelijkheden in databases - wat ze zijn, waar ze worden toegepast en welke algoritmes er zijn voor hun opsporing.
We zullen functionele afhankelijkheden beschouwen in de context van relationele databases. Heel grof gezegd, wordt de informatie in zulke databases opgeslagen in tabellen. Vervolgens gebruiken we benaderende concepten die in de strikte relationele theorie niet uitwisselbaar zijn: de tabel zelf noemen we een relatie, de kolommen zijn attributen (hun verzameling is het schema van de relatie), en de set van waarden van een rij op een subset van attributen is een tuple.
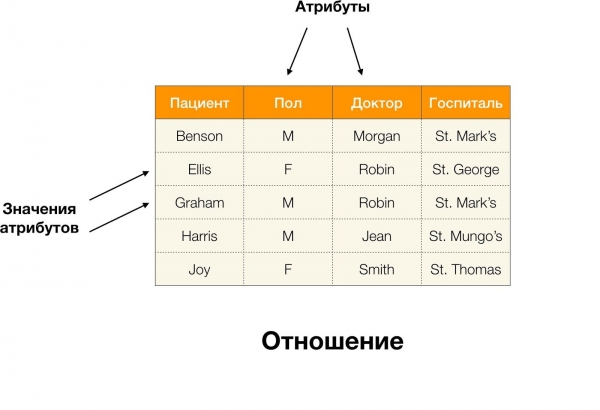
Bijvoorbeeld, in de bovenstaande tabel, (Benson, M, M organ) is een tuple op de attributen (Patiënt, Geslacht, Arts).
Formeler wordt dit als volgt genoteerd:  [Patiënt, Geslacht, Arts] = (Benson, M, M organ).
Nu kunnen we het concept van functionele afhankelijkheid (FA) introduceren:
Definitie 1. Relatie R voldoet aan FA X → Y (waarbij X, Y ⊆ R) dan en alleen dan wanneer voor elke tuple  ,
 ∈ R geldt: als
 [X] =
 [X], dan
 [Y] =
 [Y]. In dat geval zegt men dat X (de determinant, of de bepalende verzameling van attributen) functioneel Y (de afhankelijke verzameling) bepaalt.
Met andere woorden, het bestaan van FA X → Y betekent dat als we twee tuples hebben in R en ze komen overeen op de attributen X, dan zullen ze ook overeenkomen op de attributen Y.
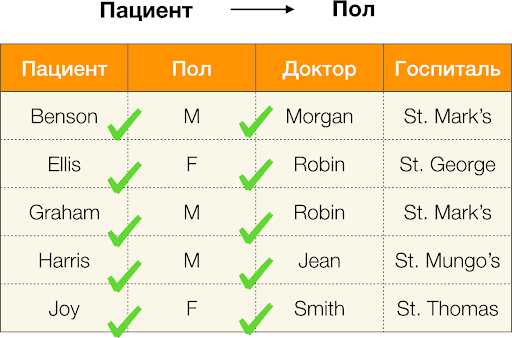
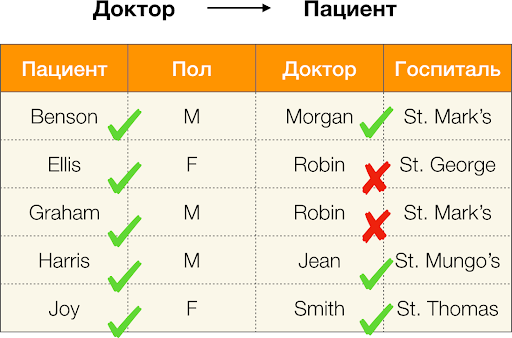
En nu stap voor stap. Laten we de attributen bekijken Patiënt en Geslacht voor wie we willen weten of er afhankelijkheden tussen hen zijn of niet. Voor zulke attributen kunnen de volgende afhankelijkheden bestaan:
- Patiënt → Geslacht
- Geslacht → Patiënt
Volgens de bovenstaande definitie, om de eerste afhankelijkheid te behouden, moet elke unieke waarde in de kolom Patiënt slechts één waarde in de kolom hebben. GeslachtEn voor de voorbeeldtabel is dit ook echt het geval. Echter, in de andere richting werkt dit niet, dat wil zeggen, de tweede afhankelijkheid geldt niet, en het attribuut Geslacht is geen determinant voor Patiënt.Evenzo, als we de afhankelijkheid Arts → Patiëntnemen, kunnen we opmerken dat deze wordt geschonden, omdat de waarde Robin voor dit attribuut verschillende waarden heeft — Ellis en Graham.
Functionele afhankelijkheden maken het mogelijk om de bestaande relaties tussen verzamelingen van tabelattributen te bepalen. Daarom zullen we hierna de meest interessante relaties beschouwen, meer specifiek die X → Y, dat wil zeggen:
- niet-triviaal zijn, wat betekent dat de rechterkant van de afhankelijkheid geen subset van de linkerkant is (Y ̸⊆ X);
- minimaal zijn, dat wil zeggen dat er geen dergelijke afhankelijkheid bestaat Z → Y, dat Z ⊂ X.
De tot nu toe besproken afhankelijkheden waren strikt, wat betekent dat ze geen enkele overtreding binnen de tabel toelaten, maar daarnaast zijn er afhankelijkheden die enige inconsistentie tussen de waarden van de tuples toelaten. Deze afhankelijkheden worden in een aparte klasse geplaatst, worden benaderend genoemd en mogen in een bepaald aantal tuples overtreden worden. Dit aantal wordt geregeld door de maximale foutgrens emax. Bijvoorbeeld, een foutpercentage  = 0.01 kan betekenen dat de afhankelijkheid met een percentage van 1% van de bestaande tuples binnen de beschouwde verzameling attributen kan worden overtreden. Dit betekent dat bij 1000 records maximaal 10 tuples de functionele afhankelijkheid kunnen overtreden. Wij zullen echter een iets andere metriek overwegen, gebaseerd op paren van verschillende waarden van de vergeleken tuples. Voor de afhankelijkheid X → Y bij de relatie , die de eerste regel van het verzoek, de headers en de gegevens scheidt. wordt dit als volgt berekend:

Laten we de fout berekenen voor Arts → Patiënt uit het bovenstaande voorbeeld. We hebben twee tuples waarvan de waarden verschillen op het attribuut Patiënt, maar overeenkomen op Arts:  [Arts, Patiënt] = (Robin, Ellis) en
 [Arts, Patiënt] = (Robin, Graham). Volgen we de definitie van de fout, moeten we alle conflictueuze paren in overweging nemen, wat betekent dat er twee zullen zijn: (
 ,
 ) en de inversie daarvan (
 ,
 ). Laten we dit in de formule invoegen en we krijgen:

En nu proberen we de vraag te beantwoorden: "Waarom is dit alles nodig?" In feite zijn er verschillende soorten functionele afhankelijkheden. Het eerste type zijn afhankelijkheden die door de beheerder worden bepaald tijdens het ontwerp van de database. Dit aantal is meestal klein, ze zijn strikt, en hun belangrijkste toepassing is normalisatie van gegevens en het ontwerp van het relationele schema.
Het tweede type zijn afhankelijkheden die "verborgen" gegevens en voorheen onbekende verbindingen tussen attributen vertegenwoordigen. Dit betekent dat deze afhankelijkheden niet zijn overwogen tijdens het ontwerp en pas worden ontdekt voor de bestaande dataset, om vervolgens op basis van de vele onthulde functionele afhankelijkheden (FZ) conclusies over de opgeslagen informatie te trekken. Laten we bekijken hoe de gevonden functionele afhankelijkheden (zowel exacte als benaderde) nuttig kunnen zijn in bepaalde gegevens.
Vandaag de dag worden afhankelijkheden vooral toegepast in dat cleansing. Dit houdt in het ontwikkelen van processen voor het identificeren van "vuile gegevens" met daaropvolgende correctie. Duidelijke voorbeelden van "vuile gegevens" zijn duplicaten, fouten in gegevens of typefouten, ontbrekende waarden, verouderde gegevens, onnodige spaties, enzovoort.
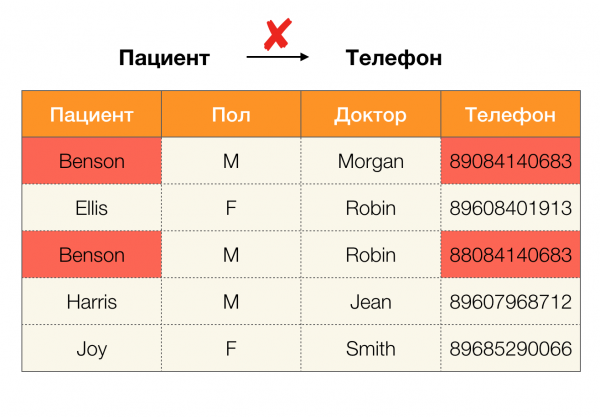
Voorbeeld van een fout in gegevens:
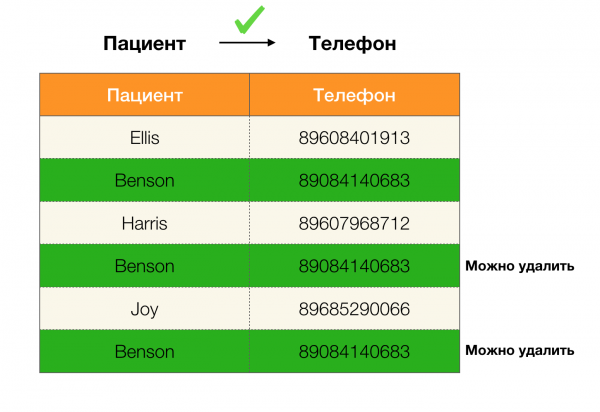
Voorbeeld van duplicaten in gegevens:
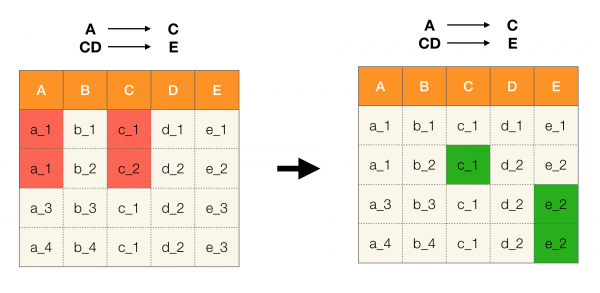
Bijvoorbeeld, we hebben een tabel en een set FZ die moeten worden nageleefd. Dat cleansing houdt in dit geval in dat de gegevens zodanig moeten worden gewijzigd dat de FZ waar worden. Hierbij moet het aantal wijzigingen minimaal zijn (voor deze procedure bestaan er algoritmes, waar we in dit artikel niet op zullen ingaan). Hieronder is een voorbeeld van zo'n transformatie van gegevens weergegeven. Links staat de oorspronkelijke relatie, waarin duidelijk niet aan de noodzakelijke FZ wordt voldaan (in het rood is een voorbeeld van een schending van een van de FZ gemarkeerd). Rechts is de bijgewerkte relatie weergegeven, waarbij de groene cellen de gewijzigde waarden tonen. Na deze procedure werden de noodzakelijke afhankelijkheden behouden.
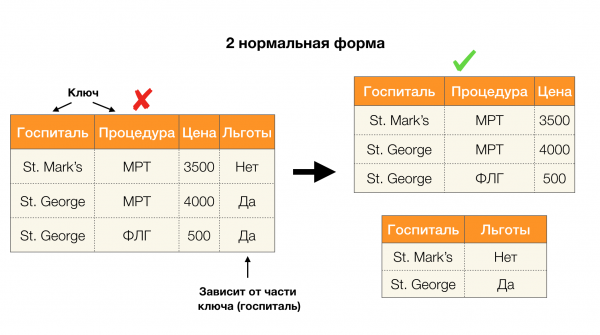
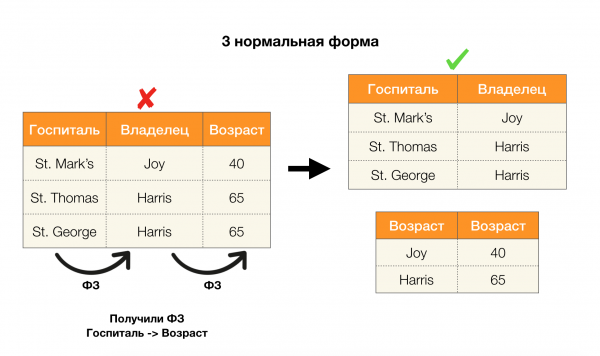
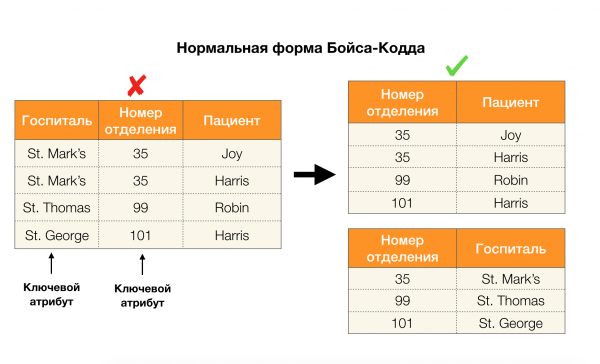
Een ander populair toepassingsgebied is databaseontwerp. Het is belangrijk om te herinneren aan normale vormen en normalisatie. Normalisatie is het proces waarbij een relatie in overeenstemming wordt gebracht met een bepaalde set eisen, waarbij elke eis op zijn eigen manier wordt gedefinieerd door een normale vorm. We zullen de eisen van verschillende normale vormen niet uitgebreid bespreken (dit wordt behandeld in elk boek over de basisprincipes van databases voor beginners), maar we merken op dat elke vorm op zijn manier gebruik maakt van het concept van functionele afhankelijkheden. Immers, functionele afhankelijkheden zijn in wezen integriteitsbeperkingen die in aanmerking worden genomen bij het ontwerpen van een database (in de context van deze taak worden functionele afhankelijkheden soms superkeys genoemd).
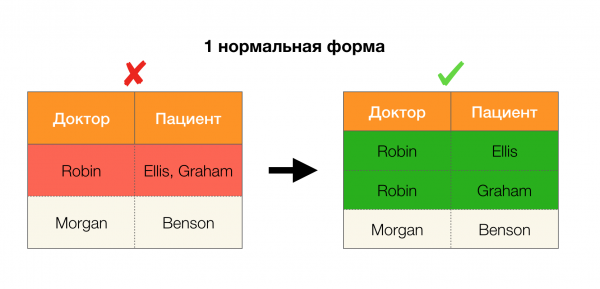
Laten we hun toepassing voor vier normale vormen beschouwen in de afbeelding hieronder. We herinneren eraan dat de Boyce-Codd normale vorm strikter is dan de derde vorm, maar minder streng dan de vierde. Deze laatste beschouwen we voorlopig niet, omdat het begrip van meerwaardige afhankelijkheden vereist is, wat niet relevant is voor dit artikel.
Een ander gebied waarin afhankelijkheden zijn toegepast, is het verlagen van de dimensionaliteit van kenmerken in taken zoals het bouwen van een naïeve Bayesiaanse classificeerder, het extraheren van significante kenmerken en het reparameriseren van een regressiemodel. In de originele artikelen wordt deze taak aangeduid als het definiëren van overbodige kenmerken (feature redundancy) en relevante kenmerken (feature relevancy) [5, 6], en het wordt opgelost met actief gebruik van databaseconcepten. Met de opkomst van dergelijke onderzoeken kunnen we zeggen dat er vandaag de dag vraag is naar oplossingen die een database, analytics en de implementatie van de bovengenoemde optimalisatieproblemen samenbrengen in één tool [7, 8, 9].
Er zijn veel algoritmen beschikbaar voor het zoeken naar functionele afhankelijkheden in een dataset (zowel moderne als minder moderne). Deze algoritmen kunnen in drie groepen worden ingedeeld:
- Algoritmen die gebruikmaken van het doorlopen van algebraïsche rasterstructuren (Lattice traversal algorithms)
- Algoritmen gebaseerd op het zoeken naar overeenkomende waarden (Difference- and agree-set algorithms)
- Algoritmen die gebaseerd zijn op paargewijze vergelijkingen (Dependency induction algorithms)
Een korte beschrijving van elk type algoritme is in de onderstaande tabel weergegeven:
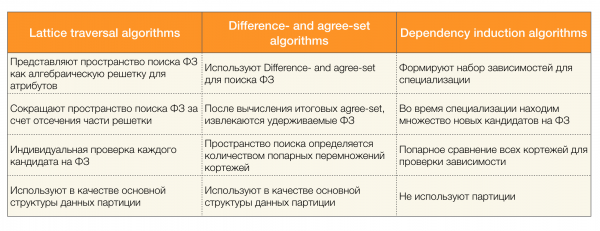
Meer informatie over deze classificatie is te vinden in [4]. Hieronder worden voorbeelden van algoritmen voor elk type gepresenteerd:
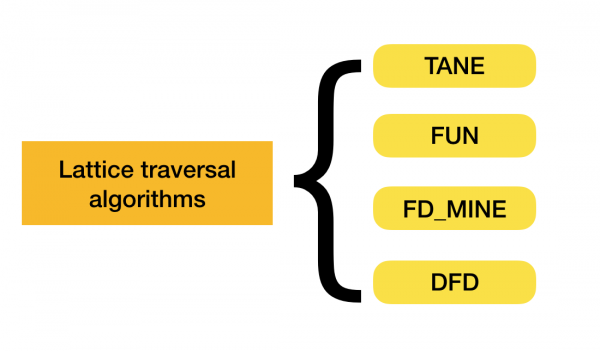
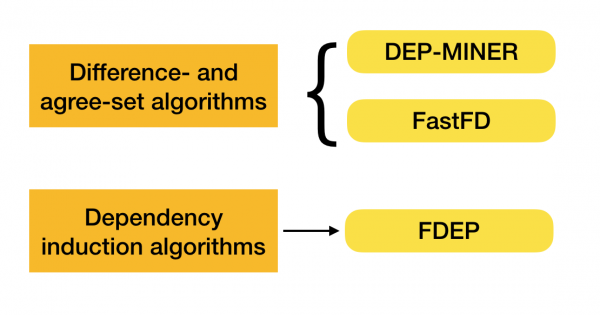
Momenteel verschijnen er nieuwe algoritmen die verschillende benaderingen voor het zoeken naar functionele afhankelijkheden combineren. Voorbeelden van dergelijke algoritmen zijn Pyro [2] en HyFD [3]. De analyse van hun werking zal in de volgende artikelen van deze serie worden besproken. In dit artikel behandelen we alleen de basisbegrippen en de stelling die nodig zijn om de technieken voor het ontdekken van afhankelijkheden te begrijpen.
Laten we beginnen met de eenvoudige – difference- en agree-set, die worden gebruikt in de tweede type algoritmen. De difference-set is een verzameling van tuples die niet overeenkomen in waarden, terwijl de agree-set, in tegenstelling tot deze, tuples zijn die wel overeenkomen in waarden. Het is belangrijk op te merken dat we in dit geval alleen de linkerzijde van de afhankelijkheid beschouwen.
Een belangrijk begrip dat hierboven is genoemd, is de algebraïsche lattice. Aangezien veel moderne algoritmen met dit begrip werken, moeten we een idee hebben van wat het inhoudt.
Om het begrip lattice in te voeren, is een definitie van een gedeeltelijk geordende verzameling (of partially ordered set, afgekort – poset) nodig.
Definitie 2. Een verzameling S wordt gedeeltelijk geordend door de binaire relatie ⩽, als voor elke a, b, c ∈ S de volgende eigenschappen gelden:
- Reflexiviteit, dat is a ⩽ a
- Antisymmetrie, dat wil zeggen, als a ⩽ b en b ⩽ a, dan a = b
- Transitiviteit, dat wil zeggen als a ⩽ b en b ⩽ c, dan volgt dat a ⩽ c
Een dergelijke relatie wordt een (niet-strikte) partiële orde genoemd, en de verzameling zelf een gedeeltelijk geordende verzameling. Formele notatie: ⟨S, ⩽⟩.
Als eenvoudig voorbeeld van een gedeeltelijk geordende verzameling kunnen we de verzameling van alle natuurlijke getallen N met de gebruikelijke orde ⩽ nemen. Het is niet moeilijk te verifiëren dat aan alle noodzakelijke axioma's wordt voldaan.
Een meer inhoudelijk voorbeeld. Laten we de verzameling van alle deelverzamelingen {1, 2, 3} overwegen, geordend volgens de inclusie relatie ⊆. Inderdaad, deze relatie voldoet aan alle voorwaarden van een partiële orde, daarom is ⟨P ({1, 2, 3}), ⊆⟩ – een gedeeltelijk geordende verzameling. In de onderstaande afbeelding is de structuur van deze verzameling afgebeeld: als je van het ene element naar het andere element kunt gaan via pijlen, dan zijn ze in een orde-relatie.
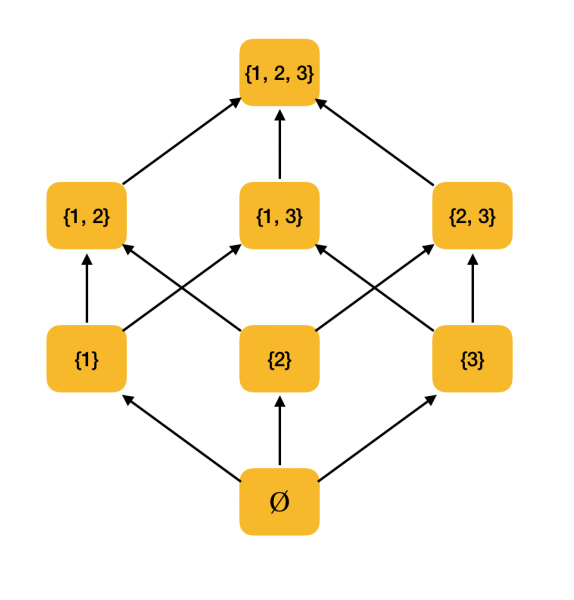
We hebben nog twee eenvoudige definities uit de wiskunde nodig — supremum en infimum.
Definitie 3. Laat ⟨S, ⩽⟩ een gedeeltelijk geordende verzameling zijn, A ⊆ S. De bovenste grens van A is een element u ∈ S, zodanig dat ∀x ∈ S: x ⩽ u. Laat U de verzameling zijn van alle bovenste grenzen van S. Als er in U een kleinste element bestaat, dan wordt dit het supremum genoemd en aangeduid als sup A.
Op een vergelijkbare wijze wordt het begrip exacte onderste grens ingevoerd.
Definitie 4. Laat ⟨S, ⩽⟩ een gedeeltelijk geordende verzameling zijn, A ⊆ S. De onderste grens van A is een element l ∈ S, zodanig dat ∀x ∈ S: l ⩽ x. Laat L de verzameling zijn van alle onderste grenzen van S. Als er in L een grootste element bestaat, dan wordt dit het infimum genoemd en aangeduid als inf A.
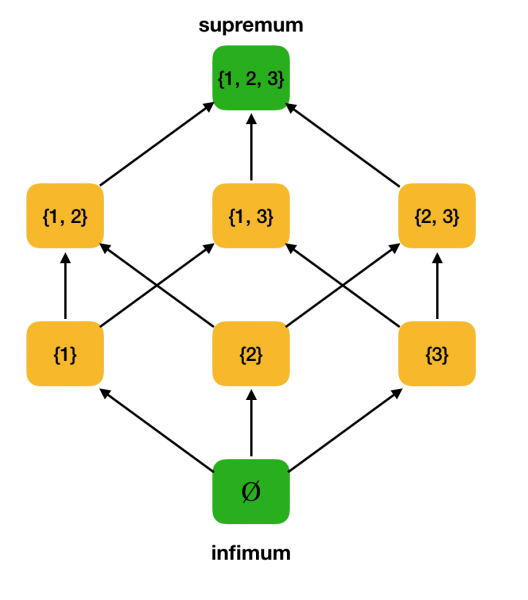
Laten we als voorbeeld de hierboven genoemde gedeeltelijk geordende verzameling ⟨P ({1, 2, 3}), ⊆⟩ nemen en de supremum en infimum daarin vinden:
Nu kunnen we de definitie van een algebraïsche rooster formuleren.
Definitie 5. Laat ⟨P, ⩽⟩ een gedeeltelijk geordende verzameling zijn, zodat elk twee-elementige deelverzameling exacte bovenste en onderste grenzen heeft. Dan wordt P een algebraïsch rooster genoemd. Hierbij wordt sup{x, y} genoteerd als x ∨ y, en inf {x, y} als x ∧ y.
Laten we controleren of ons werkvoorbeeld ⟨P ({1, 2, 3}), ⊆⟩ een rooster is. Inderdaad, voor elke a, b ∈ P ({1, 2, 3}), geldt a∨b = a∪b, en a∧b = a∩b. Bijvoorbeeld, neem de verzamelingen {1, 2} en {1, 3} en vind hun infimum en supremum. Als we ze kruisen, krijgen we de verzameling {1}, die het infimum is. Het supremum krijgen we door ze te verenigen — {1, 2, 3}.
In algoritmen voor het ontdekken van functionele afhankelijkheden wordt de zoekruimte vaak weergegeven in de vorm van een rooster, waar verzamelingen van één element (lees: het eerste niveau van het zoekrooster, waar de linkerzijde van de afhankelijkheden uit één attribuut bestaat) elk attribuut van de oorspronkelijke relatie vertegenwoordigen.
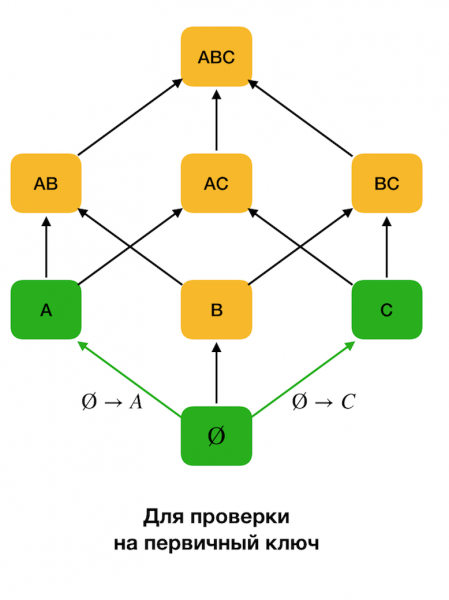
Aan het begin worden afhankelijkheden van de vorm ∅ → overwogen. Een enkel attribuut. Deze stap maakt het mogelijk om te bepalen welke attributen primaire sleutels zijn (voor dergelijke attributen zijn er geen determinanten, waardoor de linkerzijde leeg is). Vervolgens bewegen dergelijke algoritmen zich omhoog in het rooster. Het is daarbij vermeldenswaardig dat niet het hele rooster hoeft te worden doorlopen, dus als je een gewenste maximale grootte van de linkerzijde doorgeeft, dan zal het algoritme niet verder gaan dan dat niveau.
In de onderstaande afbeelding ziet u hoe u een algebraïsche rooster kunt gebruiken in de zoektocht naar FDs. Hier vertegenwoordigt elke rand (X, XY) een afhankelijkheid X → Y. Bijvoorbeeld, we hebben het eerste niveau doorlopen en weten dat de afhankelijkheid vastgehouden wordt A → B (we zullen dit weergeven met een groene verbinding tussen de knooppunten A en B). Dit betekent dat we bij het verder omhooggaan in het rooster de afhankelijkheid A, C → B, niet meer hoeven te controleren, omdat deze al niet minimaal zal zijn. Evenzo zouden we deze niet controleren als de afhankelijkheid C → B.
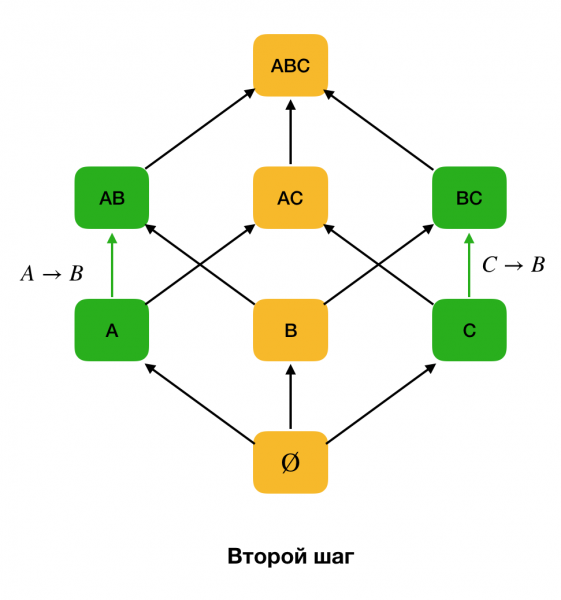
vastgehouden zou worden. Bovendien gebruiken alle moderne algoritmen voor het zoeken naar FDs doorgaans een datastructuur zoals een partitie (in de originele tekst – stripped partition [1]). De formele definitie van een partitie is als volgt:
Definitie 6. Laat X ⊆ R zijn de set van attributen voor de relatie r. Een cluster is een set van indexen van tuples uit r die dezelfde waarde hebben voor X, dat wil zeggen c(t) = {i|ti[X] = t[X]}. Een partitie is een verzameling van clusters, waarbij clusters van één enkele lengte zijn uitgesloten:

In eenvoudige bewoordingen vertegenwoordigt een partitie voor het attribuut X een set lijsten, waarbij elke lijst rij-nummers bevat met dezelfde waarden voor X. In de moderne literatuur wordt de structuur die partities vertegenwoordigt een position list index (PLI) genoemd. Clusters van één enkele lengte worden uitgesloten voor de compressie van de PLI, omdat dit clusters zijn die slechts het nummer van de record met een unieke waarde bevatten, wat altijd gemakkelijk te bepalen zal zijn.
Laten we een voorbeeld bekijken. Laten we terugkeren naar dezelfde tabel met patiënten en partities opbouwen voor de kolommen Patiënt en Geslacht (er is aan de linkerkant een nieuwe kolom verschenen waarin de rij-nummers van de tabel zijn gemarkeerd):
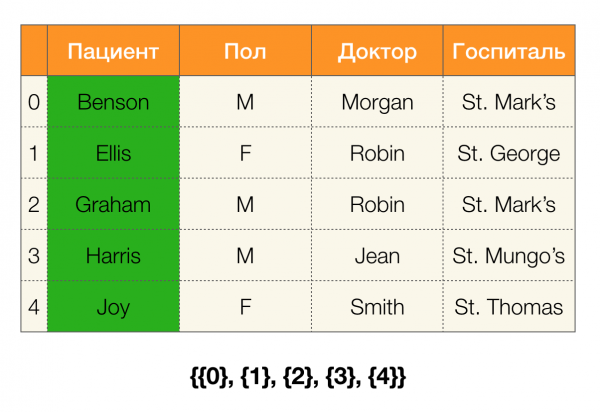
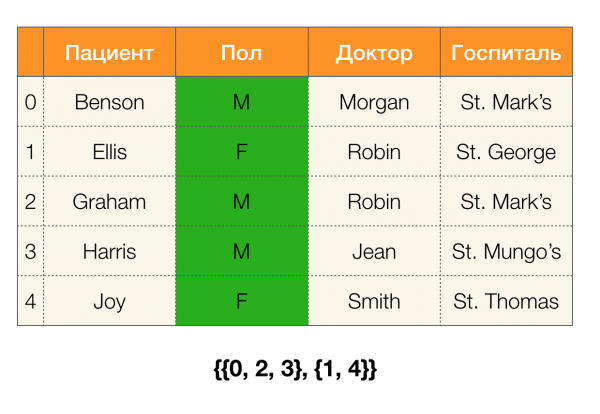
Hierbij, volgens de definitie, zal de partitie voor de kolom Patiënt in werkelijkheid leeg zijn, omdat een enkele cluster wordt uitgesloten uit de partitie.
Partities kunnen worden verkregen op basis van meerdere attributen. En hiervoor zijn er twee methoden: door door de tabel te lopen, een partitie in één keer op te bouwen voor alle benodigde attributen, of door deze te bouwen met behulp van de operatie van het kruisen van partities op een subset van attributen. Algoritmen voor het zoeken naar FDs gebruiken de tweede optie.
In eenvoudige bewoordingen, om bijvoorbeeld een partitie te krijgen op de kolommen ABC, kunnen we de partities voor AC en B (of een andere set niet-overlappende subverzamelingen) en deze met elkaar kruisen. De kruising van twee partities markeert de langste clusters die gemeenschappelijk zijn voor beide partities.
Laten we een voorbeeld bekijken:
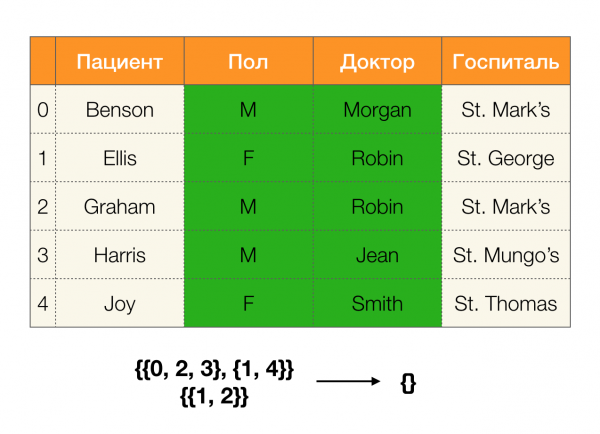
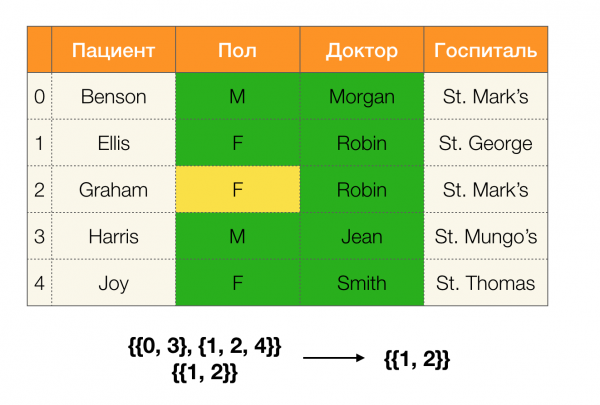
In het eerste geval kregen we een lege partitie. Als we naar de tabel kijken, zijn er inderdaad geen gelijke waarden in twee attributen. Als we de tabel echter een beetje aanpassen (rechts geval), krijgen we al een niet-lege kruising. In dit geval bevatten rij 1 en 2 inderdaad gelijke waarden voor de attributen. Geslacht en Dokter.
Vervolgens hebben we een begrip nodig, zoals de grootte van de partitie. Formeel:

Eenvoudiger gezegd, de grootte van de partitie vertegenwoordigt het aantal clusters in de partitie (onthoud dat individuele clusters niet in de partitie zitten!):
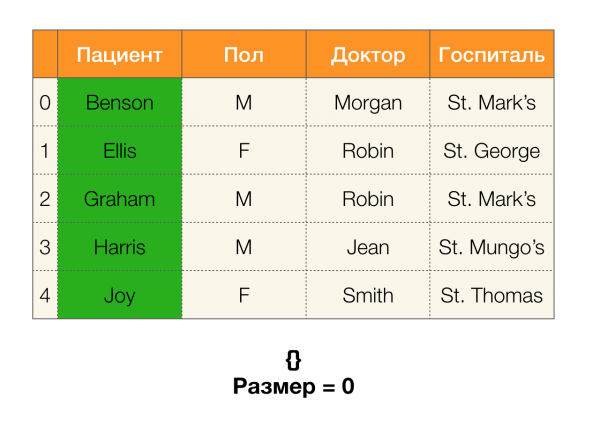
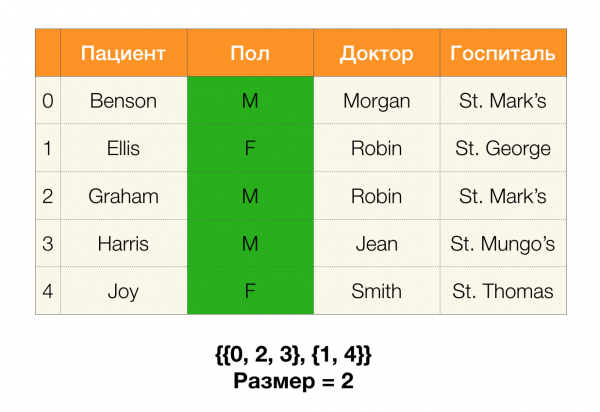
Nu kunnen we een van de belangrijke lemma's definiëren die, voor de gegeven partities, toestaat vast te stellen of de afhankelijkheid wordt gehandhaafd of niet:
Lemma 1. De afhankelijkheid A, B → C wordt gehandhaafd als en slechts als

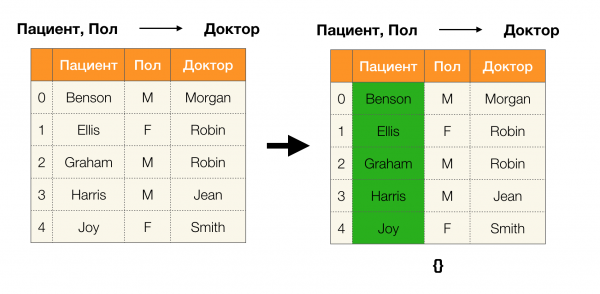
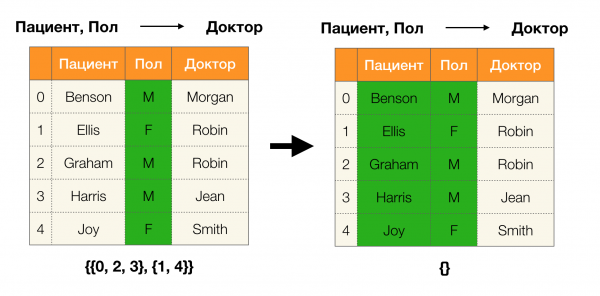
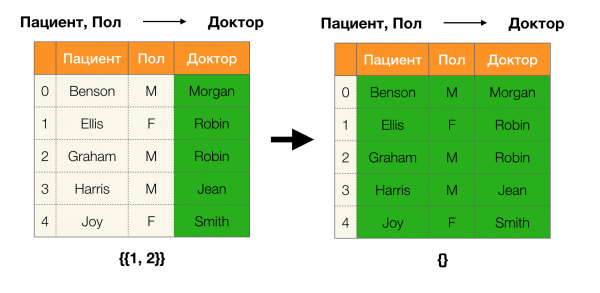
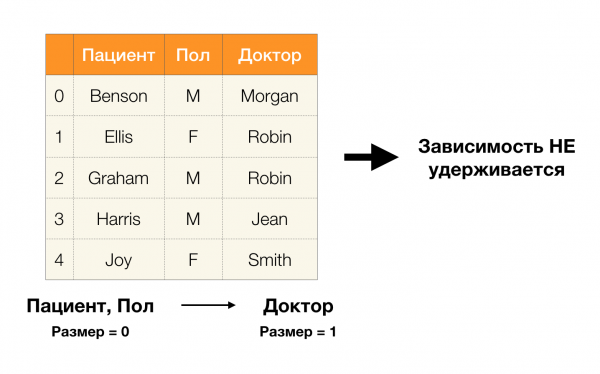
Volgens het lemma, om te bepalen of de afhankelijkheid wordt gehandhaafd, moeten vier stappen worden uitgevoerd:
- Bereken de partitie voor de linkerzijde van de afhankelijkheid
- Bereken de partitie voor de rechterzijde van de afhankelijkheid
- Bereken het product van de eerste en tweede stap
- Vergelijk de formaten van de partities die in de eerste en derde stap zijn verkregen
Hieronder staat een voorbeeld van het controleren of de afhankelijkheid volgens dit lemma wordt gehandhaafd:
In dit artikel hebben we concepten zoals functionele afhankelijkheid, benaderde functionele afhankelijkheid besproken, bekeken waar ze worden toegepast en welke algoritmen voor het zoeken naar FA bestaan. We hebben ook enkele basisconcepten, die in moderne algoritmen voor het zoeken naar FA actief worden gebruikt, uitgebreid behandeld.
Literatuurreferenties:
- Huhtala Y. et al. TANE: Een efficiënt algoritme voor het ontdekken van functionele en benaderde afhankelijkheden // The computer journal. – 1999. – Vol. 42. – Nr. 2. – Blz. 100-111.
- Kruse S., Naumann F. Efficiënte ontdekking van benaderde afhankelijkheden // Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – Nr. 7. – Blz. 759-772.
- Papenbrock T., Naumann F. Een hybride benadering voor het ontdekken van functionele afhankelijkheden // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – Blz. 821-833.
- Papenbrock T. et al. Ontdekking van functionele afhankelijkheden: Een experimentele evaluatie van zeven algoritmen // Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – Nr. 10. – Blz. 1082-1093.
- Kumar A. et al. Te verenigen of niet te verenigen?: Twijfel twee keer over verenigingen vóór functie selectie // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – Blz. 19-34.
- Abo Khamis M. et al. In-database learning with sparse tensors // Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – P. 325-340.
- Hellerstein J. M. et al. The MADlib analytics library: or MAD skills, the SQL // Proceedings of the VLDB Endowment. – 2012. – Vol. 5. – No. 12. – P. 1700-1711.
- Qin C., Rusu F. Speculative approximations for terascale distributed gradient descent optimization // Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib: Machine learning in apache spark // The Journal of Machine Learning Research. – 2016. – Vol. 17. – No. 1. – P. 1235-1241.
Auteurs van het artikel: , onderzoeker bij , en , onderzoeker bij
Bron: habr.com
