

In de eerste twee artikelen heb ik de kwestie van automatisering besproken en een raamwerk uiteengezet, in de tweede heb ik een zijspoor genomen naar netwerkvirtualisatie, als de eerste aanpak voor de automatisering van service-instellingen.
En nu is het tijd om een schema van het fysieke netwerk te tekenen.
Als je niet bekend bent met datacenter netwerkinfrastructuren, raad ik je ten zeerste aan te beginnen met .
Alle afleveringen:
De praktijken die in deze serie worden beschreven, moeten toepasbaar zijn op netwerken van elk type, elke schaal en met een verscheidenheid aan leveranciers (niet). Echter, er kan geen universeel voorbeeld worden gegeven voor de toepassing van deze aanpakken. Daarom richt ik me op de moderne architectuur van datacenter netwerken: .
De DCI zullen we doen op MPLS L3VPN.
Bovenop het fysieke netwerk draait er een Overlay-netwerk vanaf de host (dit kan VXLAN van OpenStack of Tungsten Fabric zijn of iets anders dat alleen basis IP-connectiviteit van het netwerk vereist).
In dit geval krijgen we een relatief eenvoudig scenario voor automatisering, omdat we veel apparatuur hebben die op dezelfde manier wordt ingesteld.
We kiezen voor een sferisch datacenter in een vacuüm:
- Eén ontwerpversie overal.
- Twee leveranciers die twee netvlaktes vormen.
- Het ene datacenter lijkt op het andere als twee druppels water.
Inhoud
- Fysieke topologie
- Routering
- IP-plan
- Lab
- Conclusie
- Nuttige links
Laten we onze Service-Provider LAN_DC laten, bijvoorbeeld, trainingsvideo's over overleven in vastgelopen liften hosten.
In megasteden is hier enorme vraag naar, dus er moeten veel fysieke machines zijn.
Eerst zal ik het netwerk beschrijven zoals ik het zou willen zien. En daarna vereenvoudigen voor het lab.
Fysieke topologie
Locaties
LAN_DC zal 6 datacenters hebben:
- Rusland (RU):
- Moskou (msk)
- Kazan (kzn)
- Spanje (SP):
- Barcelona (bcn)
- Málaga (mlg)
- Chinees (CN):
- Shanghai (sha)
- Xi'an (sia)

Intra-DC
In alle datacenters zijn identieke interne netwerken op basis van de Clos-topologie.
Wat zijn Clos-netwerken en waarom precies zij — in een apart artikel .
In elk datacenter zijn er 10 rekken met machines, ze worden genummerd als A, B, C En ga zo maar door.
In elk rek zijn er 30 machines. Die zijn niet van ons belang.
Bovendien heeft elk rek een switch, waaraan alle machines zijn aangesloten - dit is Top of the Rack switch — ToR of anders in de termen van de Clos-fabriek zullen we het zo noemen Leaf.

Algemene schema van de fabriek.
We zullen ze benoemen XXX-leafY, waar XXX — een drieletterige afkorting van DC, en Y — volgnummer. Bijvoorbeeld, kzn-leaf11.
In artikelen zal ik me vrijelijk bedienen van de termen Leaf en ToR als synoniemen. Het is echter belangrijk om te onthouden dat dit niet zo is.
ToR is een switch die in een rack is geïnstalleerd, waaraan machines worden aangesloten.
Leaf is de rol van een apparaat in het fysieke netwerk of een switch van het eerste niveau in de termen van de Clos-topologie.
Dus Leaf != ToR.
Dus een Leaf kan bijvoorbeeld een EndofRaw-switch zijn.
Toch zullen we in dit artikel ze nog steeds als synoniemen beschouwen.
Elke ToR-switch is op zijn beurt verbonden met vier bovenliggende aggregatieswitches — Spine. Voor Spine’s is één rack in de DC gereserveerd. We zullen het vergelijkbaar benoemen: XXX-spineY.
In hetzelfde rack zal netwerkapparatuur staan voor connectiviteit tussen DC's — 2 routers met MPLS aan boord. Maar in feite zijn dit dezelfde ToR’s. Dus vanuit het perspectief van de Spine-switches maakt het geen verschil of het een gewone ToR is met aangesloten machines of een router voor DCI — het is allemaal hetzelfde om te forwarden.
Dergelijke speciale ToR's worden genoemd Edge-leaf. We zullen ze benoemen XXX-edgeY.
Zo zal het eruit zien.
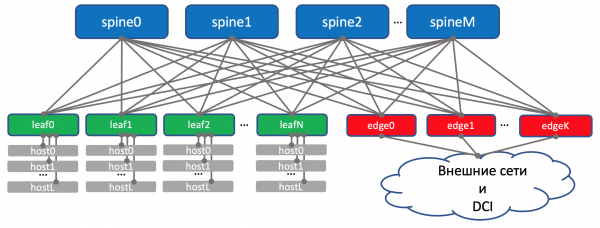
In het bovenstaande schema heb ik edge en leaf inderdaad op hetzelfde niveau geplaatst. hebben ons geleerd om uplinks (eigenlijk van hier de term) te beschouwen als links omhoog. Maar hier blijkt dat de ‘uplink’ DCI terug omlaag gaat, wat voor sommige mensen de gebruikelijke logica een beetje doorbreekt. In het geval van grote netwerken, wanneer datacenters ook weer in kleinere eenheden zijn verdeeld — POD‘s (Point Of Delivery), worden afzonderlijke Edge-POD‘s voor DCI en toegang tot externe netwerken uitgescheiden.
Voor het gemak van de perceptie zal ik toch Edge boven Spine tekenen, terwijl we in gedachten houden dat er geen intelligentie op de Spine is en geen verschillen zijn in de werking met gewone Leaf en Edge-leaf (ook al kunnen er nuances zijn, maar in het algemeen is dat zo).
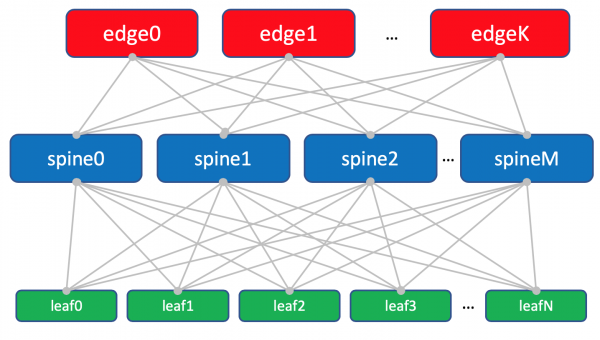
Schema van de fabriek met Edge-leafs.
De trio Leaf, Spine en Edge vormen het Underlay-netwerk of de fabriek.
De taak van de netwerkfabriek (lees Underlay), zoals we al hebben vastgesteld in , is heel eenvoudig — het waarborgen van IP-connectiviteit tussen machines zowel binnen een DC als er tussen.
Daarom wordt netwerk ook wel een fabriek genoemd, net als bijvoorbeeld de schakelfabriek binnen modulaire netwerkdozen, waarover je meer kunt lezen in .
In feite wordt zo'n topologie een fabriek genoemd omdat fabric in het Nederlands 'stof' betekent. En het is moeilijk om het er niet mee eens te zijn:
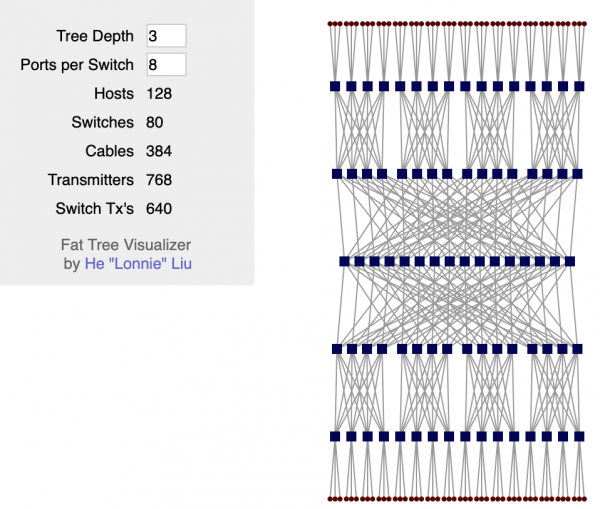
De fabriek is volledig L3. Geen VLAN's, geen Broadcast — zulke geweldige programmeurs hebben we in LAN_DC, zij kunnen applicaties schrijven die leven in de L3-paradigma, terwijl virtuele machines geen Live Migration met behoud van IP-adres vereisen.
En nogmaals: het antwoord op de vraag waarom fabriek en waarom L3 — in een apart .
DCI — Data Center Interconnect (Inter-DC)
DCI zal worden georganiseerd met behulp van Edge-Leaf, dat wil zeggen zij zijn ons toegangspunt tot de backbone.
Voor de eenvoud veronderstellen we dat de datacenters met directe links met elkaar zijn verbonden.
We houden externe connectiviteit buiten beschouwing.
Ik realiseer me dat telkens wanneer ik een component verwijder, ik het netwerk aanzienlijk vereenvoudig. En bij de automatisering van ons abstracte netwerk gaat alles goed, maar in de werkelijkheid zullen er hobbels optreden.
Dat klopt. En toch is de taak van deze serie om na te denken en te werken aan benaderingen, niet om heroïsch verzonnen problemen op te lossen.
Op de Edge-Leaf's wordt de onderlaag in VPN geplaatst en via MPLS-backbone verzonden (deze directe link).
Dit is het hoger niveau schema dat ontstaat.

Routering
Voor routering binnen het datacenter zullen we BGP gebruiken.
Op de MPLS-backbone OSPF+LDP.
Voor DCI, dat wil zeggen het organiseren van connectiviteit in de onderlaag — BGP L3VPN over MPLS.
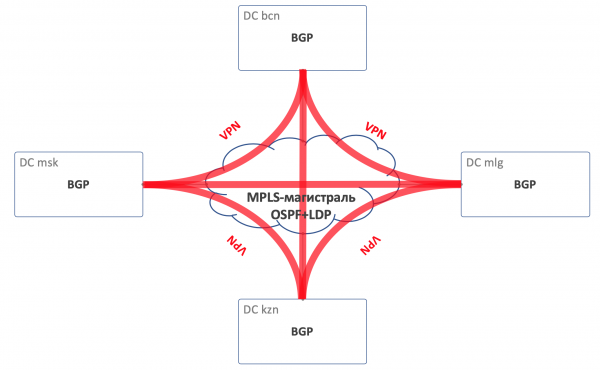
Algemeen routeringsschema
Op de fabriek zijn er geen OSPF en ISIS (verboden routeringsprotocol in de Russische Federatie).
En dat betekent dat er geen Auto-discovery en kortste padenberekening zal zijn — alleen handmatige (eigenlijk automatische — we hebben het hier over automatisering) configuratie van het protocol, buren en beleidsregels.
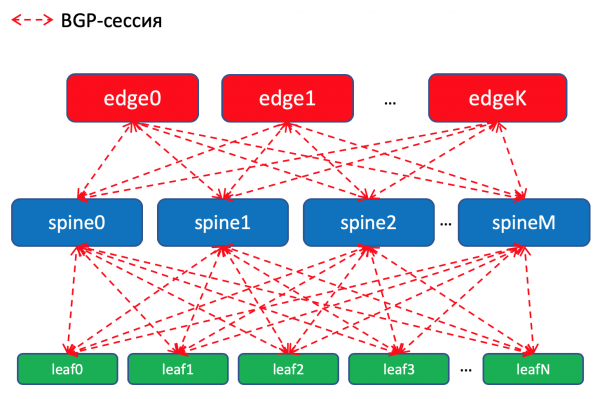
BGP-routeringsschema binnen het datacenter
Waarom BGP?
Over dit onderwerp zijn er van Facebook en Arista, waarin wordt uitgelegd hoe je zeer grote datacenter netwerken kunt bouwen met behulp van BGP. Het leest bijna als fictie, absoluut aan te raden voor een luie avond.
En er is ook een heel hoofdstuk in mijn artikel dat hieraan is gewijd. Waar ik je ook .
Maar als ik het kort zeg, dan zijn er geen IGP's geschikt voor netwerken van grote datacenters, waar het aantal netwerkapparaten in de duizenden loopt.
Bovendien zal het gebruik van BGP overal ons in staat stellen om ons niet te verspreiden over de ondersteuning van verschillende protocollen en synchronisatie daartussen.
Eerlijk gezegd zou zelfs bij onze fabriek, die waarschijnlijk niet snel zal groeien, OSPF ruim voldoende zijn. Dit zijn eigenlijk problemen van megascalers en cloud-titanen. Maar laten we alleen een paar afleveringen fantaseren dat we dit nodig hebben, en laten we BGP gebruiken, zoals Peter Lapukhov dat voorschreef.
Routeringspolitieken
Op Leaf-switches importeren we BGP-prefixen van Underlay-interfaces met netwerken.
We zullen een BGP-sessie hebben tussen elke paar Leaf-Spine, waarin deze Underlay-prefixen over het netwerk worden aangekondigd.
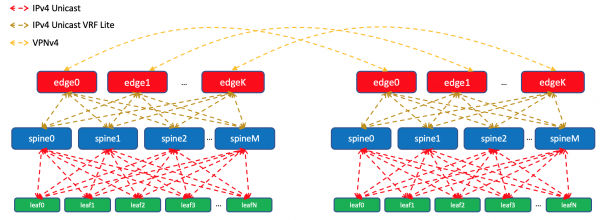
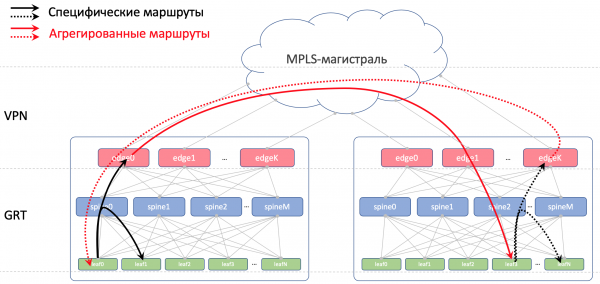
Binnen één datacenter zullen we specificaties verspreiden die we op de ToR hebben geïmporteerd. Op Edge-Leaves zullen we ze aggregeren en aankondigen in afgelegen datacentra en ze doorgeven aan de ToRs. Dat wil zeggen dat elke ToR precies zal weten hoe hij een andere ToR in hetzelfde datacenter kan bereiken en waar het toegangspunt is om bij de ToR in een ander datacenter te komen.
In DCI zullen de routes worden doorgegeven als VPNv4. Hiervoor zal de Edge-Leaf-interface in de richting van de fabriek in een VRF worden geplaatst, laten we het UNDERLAY noemen, en de nabijheid tot Spine op de Edge-Leaf zal binnen de VRF worden opgezet, terwijl het tussen Edge-Leaves in de VPNv4-family zal zijn.
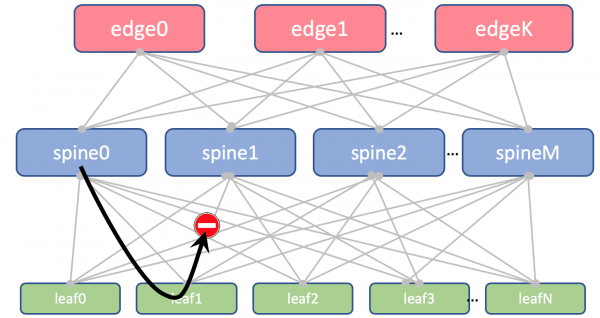
Bovendien zullen we het heraankondigen van routes die van de spines zijn ontvangen, terug naar hen verbieden.
Op Leaf en Spine zullen we geen Loopbacks importeren. We hebben ze alleen nodig om de Router ID te bepalen.
Op Edge-Leaves importeren we deze in Global BGP. Tussen de Loopback-adressen zullen Edge-Leaves een BGP-sessie in de IPv4 VPN-family met elkaar opzetten.
Tussen EDGE-apparaten hebben we een uitgestrekt backbone op OSPF+LDP. Alles in één zone. Een uiterst eenvoudige configuratie.
Dit is het beeld van de routering.
BGP ASN
Edge-Leaf ASN
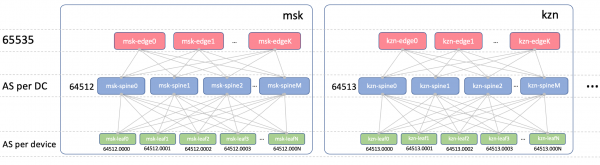
Op Edge-Leaves zal er één ASN in alle datacenters zijn. Dit is belangrijk zodat er iBGP tussen Edge-Leaves is, en we niet tegen de nuances van eBGP aanlopen. Laten we dit 65535 laten zijn. In werkelijkheid zou dit een nummer van een publieke AS kunnen zijn.
Spine ASN
Op de Spine hebben we één ASN per datacenter. We beginnen hier met het eerste nummer uit het bereik van privé AS - 64512, 64513 En zo verder.
Waarom ASN per datacenter?
Laten we deze vraag opsplitsen in twee:
- Waarom dezelfde ASN op alle spines van één datacenter?
- Waarom verschillend in verschillende datacentra?
Waarom dezelfde ASN op alle spines van één datacenter?
Zo zal de AS-Path van de onderliggende route op Edge-Leaf eruitzien:
[leafX_ASN, spine_ASN, edge_ASN]
Bij het proberen om het opnieuw te adverteren op Spine, zal deze het afwijzen omdat zijn AS (Spine_AS) al in de lijst staat.
Echter, binnen de datacenter zijn we heel tevreden dat de onderliggende routes die naar Edge zijn opgestegen, niet naar beneden kunnen gaan. Al het verkeer tussen hosts binnen het datacenter moet plaatsvinden op het niveau van de spine switches.
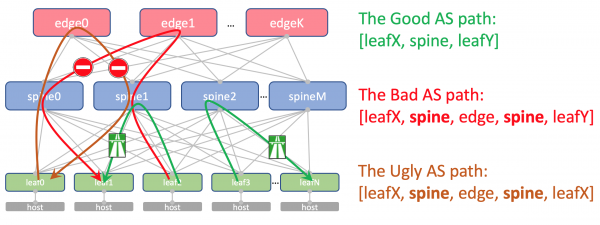
Geaggregeerde routes van andere datacenters zullen in elk geval zonder problemen de ToR bereiken — in hun AS-Path zal alleen ASN 65535 zijn — het nummer van de Edge-Leafs, omdat ze op hen zijn aangemaakt.
Waarom verschillen ze in verschillende datacenters?
Theoretisch kan het nodig zijn om Loopbacks van bepaalde service virtuele machines tussen datacenters te trekken.
Bijvoorbeeld, op onze host zal een Route Reflector draaien of (Virtual Network Gateway), die via BGP met de ToR zal verbinden en zijn loopback zal adverteren, wat toegankelijk moet zijn vanuit alle datacenters.
Zo zal zijn AS-Path eruitzien:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
En hier mogen geen herhaalde ASN's zijn.
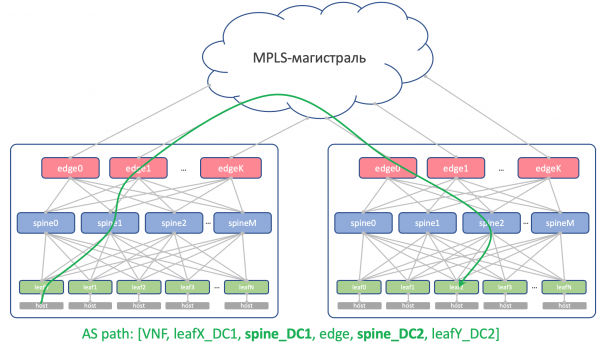
Dus Spine_DC1 en Spine_DC2 moeten verschillend zijn, net als leafX_DC1 en leafY_DC2, waar we naderbij komen.
Zoals u waarschijnlijk weet, bestaan er hacks die het mogelijk maken om routes met herhaalde ASN's te accepteren, ondanks het mechanisme dat loops voorkomt (allowas-in op Cisco). Dit heeft zelfs legitieme toepassingen. Maar het is een potentiële zwakheid in de robuustheid van het netwerk. En ik ben daar persoonlijk een paar keer in gesprongen.
En als we de kans hebben om geen gevaarlijke dingen te gebruiken, zullen we die benutten.
Leaf ASN
We zullen een unieke ASN hebben op elke Leaf-switch binnen het hele netwerk.
We doen dit om de bovengenoemde redenen: AS-Path zonder loops, BGP-configuratie zonder backdoors.
Om ervoor te zorgen dat routes tussen Leaf's soepel verlopen, moet de AS-Path er als volgt uitzien:
[leafX_ASN, spine_ASN, leafY_ASN]
waarbij leafX_ASN en leafY_ASN idealiter verschillend moeten zijn.
Dit is nodig voor de situatie waarin de loopback van de VNF tussen datacenters wordt geadverteerd:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
We zullen een 4-byte ASN gebruiken en deze genereren op basis van de ASN van de spine en het nummer van de Leaf-switch, namelijk als volgt: Spine_ASN.0000X.
Dit is hoe de situatie met ASN eruit ziet.
IP-plan
Fundamenteel moeten we adressen toewijzen voor de volgende verbindingen:
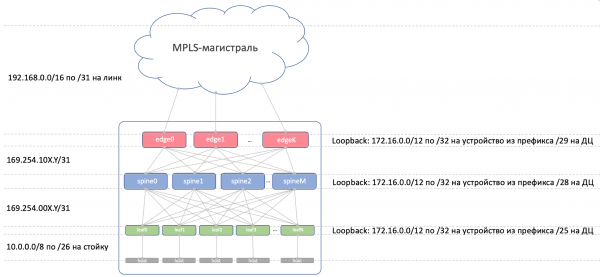
- De onderliggende netwerken tussen ToR en de machine. Ze moeten uniek zijn in het gehele netwerk, zodat elke machine met elke andere machine kan communiceren. Perfect geschikt 10/8. Voor elke rack /26 met marge. We zullen /19 voor het DC en /17 voor de regio toewijzen.
- Linkadressen tussen Leaf/Tor en Spine.
Ze zouden algoritmisch toegewezen moeten worden, dat wil zeggen berekend op basis van de namen van de apparaten die moeten worden aangesloten.
Laten we dat … 169.254.0.0/16 maken.
Namelijk 169.254.00X.Y/31, waar X — nummer van Spine, Y — P2P-netwerk /31.
Dit stelt ons in staat om tot 128 racks en tot 10 Spine in het DC te draaien. Linkadressen kunnen (en zullen) van DC naar DC herhaald worden. - De verbinding tussen Spine — Edge-Leaf organiseren we op subnets 169.254.10X.Y/31, waar precies zo X — nummer van Spine, Y — P2P-netwerk /31.
- Linkadressen van Edge-Leaf naar MPLS-ruggengraat. Hier is de situatie ietwat anders — de plaats waar alle stukken in één geheel samenkomen, dus het hergebruiken van dezelfde adressen is niet mogelijk — we moeten de volgende vrije subnet kiezen. Daarom nemen we als basis 192.168.0.0/16 en zullen we vrije adressen uit ophalen.
- Loopback-adressen. We zullen het hele bereik hiervoor gebruiken 172.16.0.0/12.
- Leaf — /25 voor het DC — diezelfde 128 racks. We wijzen /23 voor de regio toe.
- Spine — /28 voor het DC — tot 16 Spine. We wijzen /26 voor de regio toe.
- Edge-Leaf — /29 voor het DC — tot 8 dozen. We wijzen /27 voor de regio toe.
Als we in het DC niet genoeg toegewezen bereiken hebben (en dat zullen we niet hebben — we zetten in op hyperscale), wijzen we gewoon het volgende blok toe.
Dit is het plaatje met IP-adressering.
Loopbacks:
Prefix
Rol van het apparaat
Regio
DC
172.16.0.0/23
edge
172.16.0.0/27
ru
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
ru
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
ru
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Prefix
Regio
DC
10.0.0.0/17
ru
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Lab
Twee leveranciers. Eén netwerk. ADSM.
Juniper + Arista. Ubuntu. De goede oude Eva.
Het aantal middelen op onze virtual machine in Mirana is wel beperkt, dus voor de praktijk zullen we een tot het uiterste vereenvoudigd netwerk gebruiken.
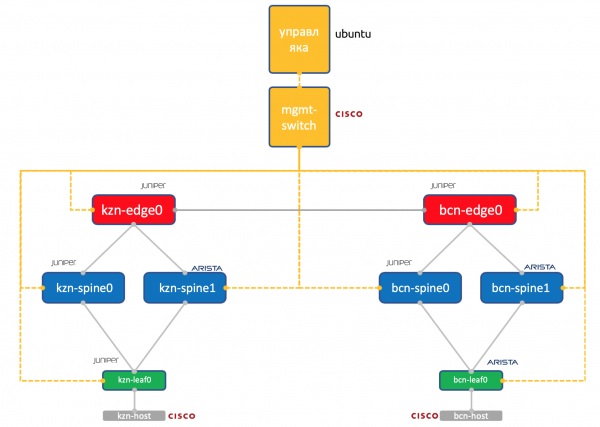
Twee datacentra: Kazan en Barcelona.
- Twee spines in elk: Juniper en Arista.
- Één tor (leaf) in elk — Juniper en Arista, met één aangesloten host (we nemen een lichtgewicht Cisco IOL hiervoor).
- Één node Edge-Leaf (momenteel alleen Juniper).
- One Cisco switch to rule them all.
- Naast de netwerkdozen draait er een virtuele machine-beheerder. Onder Ubuntu.
Ze heeft toegang tot alle apparaten, daarop draaien IPAM/DCIM-systemen, een bouquet van Python-scripts, Ansible en alles wat we ook maar kunnen nodig hebben.
van alle netwerkelementen, die we gaan proberen te reproduceren met behulp van automatisering.
Conclusie
Is dit ook gebruikelijk? Onder elk artikel een korte samenvatting maken?
Dus we hebben gekozen voor netwerk van Clos binnen het DC, aangezien we veel East-West verkeer verwachten en ECMP willen.
We hebben het netwerk verdeeld in een fysieke (underlay) en een virtuele (overlay) laag. De overlay begint echter met de host, waardoor de eisen aan de onderlay zijn vergemakkelijkt.
We hebben BGP gekozen als het routeringsprotocol voor underlay-netwerken vanwege de schaalbaarheid en flexibiliteit van de beleidsstrategieën.
We zullen aparte knooppunten hebben voor het opzetten van DCI — Edge-leaf.
Op de backbone zal OSPF+LDP zijn.
DCI zal worden geïmplementeerd op basis van MPLS L3VPN.
Voor P2P-links zullen we de IP-adressen algorithmisch berekenen op basis van de apparaatnamen.
Loopbacks zullen we toewijzen op basis van de rol van de apparaten en hun locaties in volgorde.
Underlay-prefixen — alleen op Leaf-switches in volgorde gebaseerd op hun positie.
Laten we aannemen dat we momenteel nog geen apparatuur hebben geïnstalleerd.
Daarom zullen onze volgende stappen zijn: ze in systemen (IPAM, inventaris) in te voeren, toegang te organiseren, configuratie te genereren en deze te implementeren.
In het volgende artikel zullen we het hebben over Netbox — een systeem voor inventarisatie en beheer van IP-ruimte in datacentra.
Bedankt
- Aan Andrej Glazkov aka @glazgoo voor het proeflezen en aanpassingen
- Aan Alexander Klimenko aka @v00lk voor het proeflezen en aanpassingen
- Aan Artem Chernobay voor KDPV
Bron: habr.com
