

We hebben een ontwerp ontwikkeld voor datacenter-netwerken dat het mogelijk maakt om compute-clusters te implementeren van meer dan 100.000 servers met een piek-bisectiebandbreedte van meer dan één petabyte per seconde.
In de presentatie van Dmitry Afanasyev leert u over de belangrijkste principes van het nieuwe ontwerp, de schaling van topologieën, de problemen die daarbij ontstaan, de mogelijke oplossingen, en de kenmerken van routering en schaling van forwarding-plane functies van moderne netwerkapparaten in 'dicht verbonden' topologieën met veel ECMP-routes. Daarnaast vertelde Dima kort over de organisatie van externe connectiviteit, het fysieke niveau, het kabelsysteem en manieren om de capaciteit verder uit te breiden.
— Goedemiddag iedereen! Mijn naam is Dmitry Afanasyev, ik ben netwerkarchitect bij Yandex en houd me voornamelijk bezig met het ontwerp van datacenters.
Mijn verhaal zal gaan over het vernieuwde datacenter-netwerk van Yandex. Dit is in grote mate een evolutie van het ontwerp dat we hadden, maar er zijn ook enkele nieuwe elementen. Het is een overzichtelijke presentatie, aangezien we veel informatie in een korte tijd moesten passen. We beginnen met de keuze van de logische topologie. Daarna volgt een overzicht van het control plane en de schaalbaarheidsproblemen van het data plane, de keuze van wat er op fysiek niveau zal gebeuren, en we kijken naar enkele kenmerken van de apparaten. We zullen ook kort ingaan op wat er in het datacenter gebeurt met MPLS, waarover we enige tijd geleden spraken.
Dus, wat is Yandex vanuit het perspectief van belastingen en diensten? Yandex is een typische hyperscaler. Als we naar de gebruikers kijken, verloopt onze verwerking van gebruikersverzoeken in de eerste plaats. Ook hebben we verschillende streamingdiensten en dataverwerking, omdat we ook storage-diensten hebben. Als we dichter bij de backend komen, ontstaan er infrastructurele belasting en diensten, zoals gedistribueerde objectopslag, gegevensreplicatie en natuurlijk persistent queues. Een van de belangrijkste typen belasting is MapReduce en soortgelijke systemen, streamingverwerking, machine learning, enz.
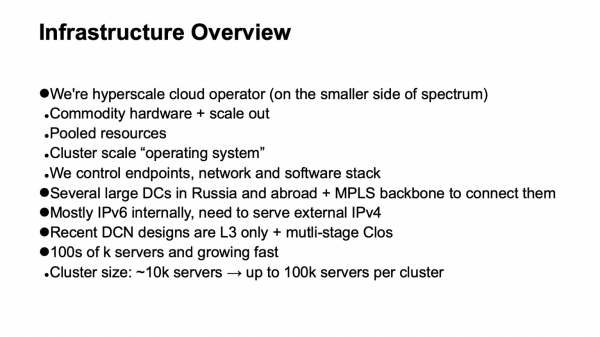
Hoe is de infrastructuur opgebouwd waarop dit allemaal plaatsvindt? We zijn opnieuw een vrij typische hyperscaler, hoewel we misschien iets dichter bij de kant van het spectrum staan waar de kleinere hyperscalers zich bevinden. Maar we hebben alle attributen. We gebruiken commodity hardware en horizontale schaalvergroting waar mogelijk. We hebben een volledige pooling van middelen: we werken niet met afzonderlijke machines of racks, maar combineren ze in een grote pool van vervangbare middelen met extra diensten voor planning en allocatie, en werken met deze pool.
Zo ontstaat er een volgend niveau — het besturingssysteem van het rekkencluster. Het is zeer belangrijk dat we de technologie-stack die we gebruiken volledig controleren. We controleren de eindpunten (hosts), het netwerk en de softwarestack.
We hebben verschillende grote datacenters in Rusland en in het buitenland. Ze zijn verbonden via een backbone die gebruikmaakt van MPLS-technologie. Onze interne infrastructuur is vrijwel volledig gebouwd op IPv6, maar aangezien we externe verkeer moeten afhandelen dat nog steeds voornamelijk via IPv4 binnenkomt, moeten we een manier vinden om verzoeken die via IPv4 binnenkomen naar de frontend te leveren,servers, en soms ook de externe IPv4-internet toegang, bijvoorbeeld voor indexering.
De laatste paar iteraties van het datacenter netwerkontwerp maken gebruik van meerlagige Clos-topologieën, en hierbij wordt alleen L3 toegepast. We zijn enige tijd geleden van L2 afgestapt en hebben opgelucht ademgehaald. Ten slotte omvat onze infrastructuur honderden duizenden computereenheden (serverinstellingen). De maximale grootte van een cluster was een tijdje geleden ongeveer 10.000 servers. Dit is in belangrijke mate te wijten aan hoe de cluster-besturingssystemen, planners en resource-allocatie kunnen functioneren. Aangezien er vooruitgang is geboekt aan de infrastructuurzijde van de software, is het huidige doel een grootte van ongeveer 100.000 servers in één rekkencluster, en we hebben de uitdaging om netwerkinfrastructuren te bouwen die effectief resource pooling in zo'n cluster mogelijk maken.
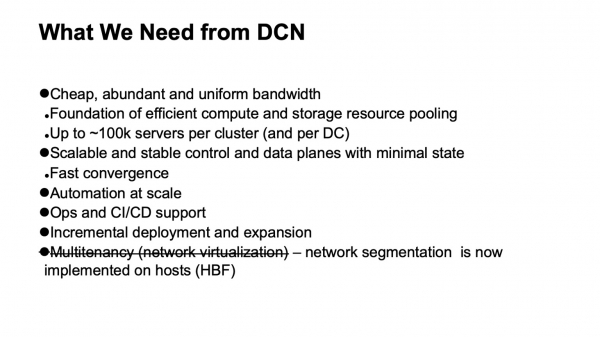
Wat willen we van het datacenter netwerk? Ten eerste veel goedkope en vrij gelijkmatig verdeelde bandbreedte. Want het netwerk is de basis waarmee we hulpbronnen kunnen pooling. De nieuwe doelgrootte is ongeveer 100.000 servers in één cluster.
Daarnaast willen we natuurlijk een schaalbare en stabiele control plane, omdat er bij zo'n grote infrastructuur al genoeg hoofdpijn ontstaat door zelfs gewoon willekeurige gebeurtenissen. We willen niet dat de control plane ook extra hoofdpijn veroorzaakt. Tegelijkertijd willen we de toestand erin minimaliseren. Hoe minder toestand, hoe beter en stabieler alles werkt en hoe eenvoudiger het te diagnosticeren is.
Natuurlijk hebben we automatisering nodig, omdat handmatig beheer van zo'n infrastructuur onmogelijk is en dat al enige tijd zo is. We hebben zo veel mogelijk ondersteuning nodig voor operationele activiteiten en voor CI/CD, voor zover dat mogelijk is.
Bij een dergelijke omvang van datacenters en clusters is de behoefte aan ondersteuning van incrementele uitrol en uitbreiding zonder serviceonderbreking al behoorlijk urgent geworden. Als het gaat om clusters van duizend machines of zo, misschien dicht bij tienduizend machines, kunnen ze nog worden uitgerold als één operatie — dat wil zeggen dat we de uitbreiding van de infrastructuur plannen en enkele duizenden machines als één operatie toevoegen. Maar een cluster van bijna honderdduizend machines ontstaat niet ineens; het wordt in de loop van enige tijd opgebouwd. En het is wenselijk dat gedurende die tijd de infrastructuur die al is uitgerold, beschikbaar is.
En er was één eis die we hadden en verdwenen is: dat is ondersteuning voor multitenancy, oftewel virtualisatie of netwerksegmentatie. Nu hoeven we dit niet op het niveau van de netwerkinfrastructuur te doen, omdat segmentatie naar de hosts is verschoven, wat ons het schalen enorm heeft vergemakkelijkt. Dankzij IPv6 en de grote adresruimte hoefden we in de interne infrastructuur geen dubbele adressen te gebruiken, de adressering was al uniek. En omdat we filtering en netwerksegmentatie naar de hosts hebben verplaatst, hoeven we geen virtuele netwerkentiteiten in datacenter netwerken te creëren.
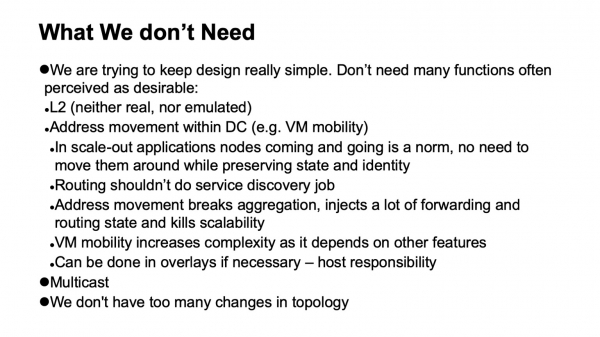
Een zeer belangrijke factor is dat we bepaalde dingen niet nodig hebben. Als bepaalde functies uit het netwerk kunnen worden verwijderd, maakt dit het leven veel makkelijker en vergroot het doorgaans de keuze van beschikbare hardware en software, wat de diagnose aanzienlijk vereenvoudigt.
Dus, van welke dingen kunnen we afzien, waarvan we niet altijd met veel plezier konden afkomen op het moment dat het gebeurde, maar waar we achteraf veel verlichting over voelden zodra het proces was afgerond?
Allereerst, de afschaffing van L2. We hebben L2 niet nodig, noch in de echte wereld, noch geïmiteerd. Het wordt aanzienlijk minder gebruikt, omdat we de applicatiestack controleren. Onze applicaties schalen horizontaal, ze werken met L3-adressering, en ze maken zich niet druk dat een afzonderlijke instantie is uitgevallen; ze brengen gewoon een nieuwe uit, deze hoeft niet op het oude adres te worden uitgerold, omdat er een apart niveau van service discovery en monitoring van machines in het cluster is. We leggen deze taak niet bij het netwerk neer. De taak van het netwerk is om pakketten van punt A naar punt B te verzenden.
Ook hebben we geen situaties waarin adressen binnen het netwerk verschuiven en gevolgd moeten worden. In veel ontwerpen is dit meestal nodig om VM-mobiliteit te ondersteunen. We gebruiken geen mobiliteit van virtuele machines in de interne infrastructuur van Yandex, en bovendien denken we dat, zelfs als dit gebeurt, het niet door het netwerk ondersteund moet worden. Als het echt noodzakelijk is, moet dit op hostniveau worden gedaan, en adressen die kunnen migreren moeten in overlays worden geplaatst om niet te veel dynamische wijzigingen in het routing-systeem van de eigenlijke underlay (transportnetwerk) aan te brengen.
Een andere technologie die we niet gebruiken, is multicast. Voor degenen die het willen weten, kan ik daar uitgebreid over vertellen. Dit maakt het leven veel eenvoudiger omdat, als iemand ermee te maken heeft gehad en heeft gekeken hoe het control plane van multicast eruitziet – in alle installaties, behalve de eenvoudigste, is dit een grote hoofdpijn. Bovendien is het moeilijk om een goed functionerende open implementatie te vinden, bijvoorbeeld.
En tot slot, we ontwerpen onze netwerken zo dat er niet te veel wijzigingen plaatsvinden. We kunnen erop rekenen dat de stroom van externe gebeurtenissen in het routeringssysteem klein is.
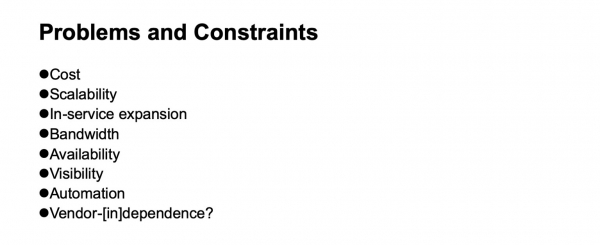
Welke problemen en beperkingen moeten we in overweging nemen bij het ontwikkelen van een datacenter netwerk? Kosten, uiteraard. Schaalbaarheid, tot welk niveau we willen groeien. De noodzaak om uit te breiden zonder de service te onderbreken. Bandbreedte, beschikbaarheid. Zichtbaarheid van wat er in het netwerk gebeurt, voor monitoring systemen, voor operationele teams. Ondersteuning voor automatisering — opnieuw, voor zover dat mogelijk is, aangezien verschillende taken op verschillende niveaus kunnen worden opgelost, inclusief het inbrengen van extra lagen. En niet-[afhankelijkheid]-van leveranciers. Hoewel deze onafhankelijkheid in verschillende historische periodes, afhankelijk van het perspectief, gemakkelijker of moeilijker te bereiken was. Als we kijken naar netwerkapparatuur chips, was het tot voor kort heel relatief om te spreken over onafhankelijkheid van leveranciers, vooral als we ook chips met hoge doorvoersnelheid wilden.
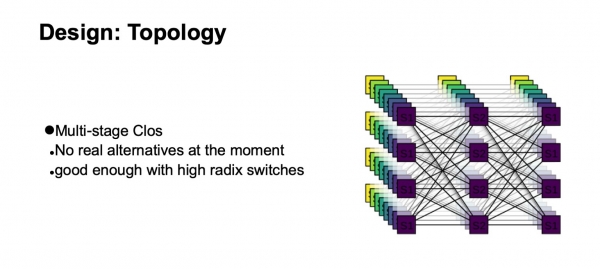
Volgens welke logische topologie gaan we ons netwerk bouwen? Het zal een meerlaagse Clos zijn. Eigenlijk zijn er op dit moment geen echte alternatieven. En de Clos-topologie is vrij goed, zelfs als we het vergelijken met verschillende geavanceerde topologieën, die zich nu meer in het domein van academische interesse bevinden, vooral als we switches met een hoge radix hebben.
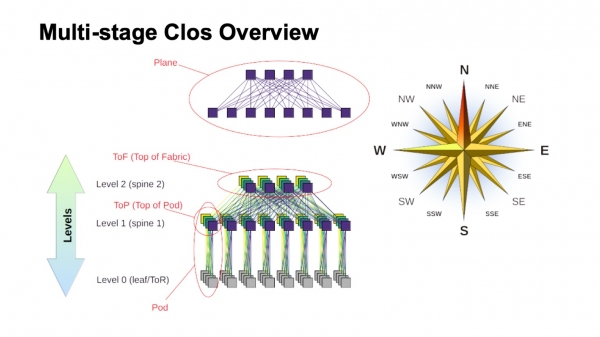
Hoe ziet een meerlaagse Clos-netwerk eruit en welke verschillende elementen heeft het? In de eerste plaats een windroos, om te oriënteren waar het noorden, zuiden, oosten en westen zijn. Dit soort netwerken wordt meestal gebouwd door degenen met een zeer hoog verkeer west-oost. Wat betreft de andere elementen, bovenaan is een virtuele switch afgebeeld, opgebouwd uit kleinere switches. Dit is het belangrijkste idee van het recursieve bouwen van Clos-netwerken. We nemen elementen met een bepaalde radix en verbinden ze zodanig dat wat er is ontstaan, kan worden beschouwd als een switch met een grotere radix. Als we nog meer nodig hebben, kan de procedure worden herhaald.
In gevallen zoals twee-niveau Clos-netwerken, waarbij we duidelijk componenten kunnen identificeren die in mijn schema verticaal zijn, worden ze vaak vlakken genoemd. Als we een Clos-netwerk met drie niveaus van spine switches zouden bouwen (alle switches die geen rand- of ToR-switches zijn en die alleen voor transit worden gebruikt), zouden de vlakken complexer lijken; de twee-niveau structuren zien er zo uit. De ToR- of leaf-switches en de daarbij behorende eerste-niveau spine switches noemen we een Pod. De spine-switches van level spine-1 bovenaan de Pod zijn de top of Pod, de top van de Pod. Switches die zich bovenaan de hele fabric bevinden, zijn de bovenste laag van de fabric, Top of fabric.
Natuurlijk rijst de vraag: Clos-netwerken worden al enige tijd gebouwd, het idee komt zelfs uit de tijd van klassieke telefonie, TDM-netwerken. Misschien is er iets beters verschenen, misschien kan het beter? Ja en nee. Theoretisch gezien wel, in de praktijk voorlopig zeker niet. Omdat er een aantal interessante topologieën zijn, waarvan sommige zelfs in productie worden gebruikt, bijvoorbeeld Dragonfly in HPC-toepassingen; er zijn ook interessante topologieën zoals Xpander, FatClique, Jellyfish. Als je presentaties op conferenties zoals SIGCOMM of NSDI van de laatste tijd bekijkt, kun je een behoorlijk aantal werken ontdekken die alternatieve topologieën behandelen met (bepaalde) betere eigenschappen dan Clos.
Maar al deze topologieën hebben één interessant kenmerk. Het hindert hun implementatie in datacenternetwerken die we proberen te bouwen op commodity hardware en die redelijk geprijsd zijn. In al deze alternatieve topologieën is het grootste deel van de bandbreedte helaas niet beschikbaar via de kortste paden. Daarom verliezen we meteen de mogelijkheid om de traditionele control plane te gebruiken.
Theoretisch is de oplossing voor het probleem bekend. Dit omvat bijvoorbeeld modificaties van link state met gebruik van k-kortste paden, maar nogmaals, er zijn geen protocollen die zijn geïmplementeerd in productie en massaal beschikbaar zijn op de apparatuur.
Bovendien, aangezien het grootste deel van de capaciteit niet via de kortste paden beschikbaar is, moeten we niet alleen het control plane aanpassen zodat het al deze paden kan selecteren (en trouwens, dat is een veel grotere toestand in het control plane). We moeten ook het forwarding plane aanpassen, en doorgaans zijn er minimaal twee extra functies nodig. Dit is de mogelijkheid om alle beslissingen over het forwarden van pakketten in één keer te nemen, bijvoorbeeld op de host. In feite is dit source routing, soms in de literatuur over interconnectienetwerken aangeduid als all-at-once forwarding decisions. En dan is er adaptive routing — dit is al een functie die we nodig hebben in netwerkapparatuur, wat bijvoorbeeld betekent dat we de volgende hop kiezen op basis van informatie over de kleinste belasting van de wachtrij. Bijvoorbeeld, andere opties zijn mogelijk.
Dus de richting is interessant, maar helaas kunnen we het op dit moment niet toepassen.
Oké, we hebben ons geconcentreerd op de logische topologie van Clos. Hoe gaan we deze schalen? Laten we kijken hoe het is opgebouwd en wat we kunnen doen.
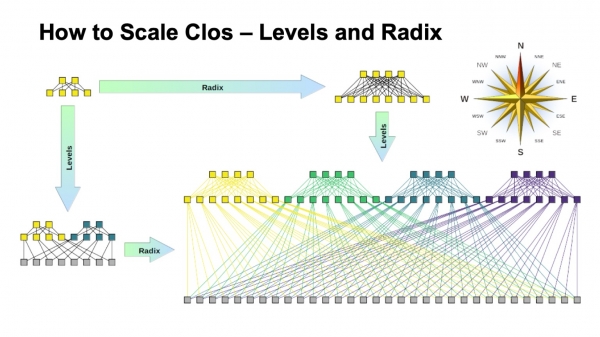
In een Clos-netwerk zijn er twee belangrijke parameters die we kunnen variëren om verschillende resultaten te behalen: de radix van de elementen en het aantal niveaus in het netwerk. Ik heb schematisch weergegeven hoe beide de grootte beïnvloeden. Idealiter combineren we beide.
Het is duidelijk dat de uiteindelijke breedte van het Clos-netwerk de vermenigvuldiging is over alle niveaus van spine-switches van de zuidelijke radix, dat wil zeggen, hoeveel links we naar beneden hebben, hoe het vertakt. Dit is hoe we de grootte van het netwerk opschalen.
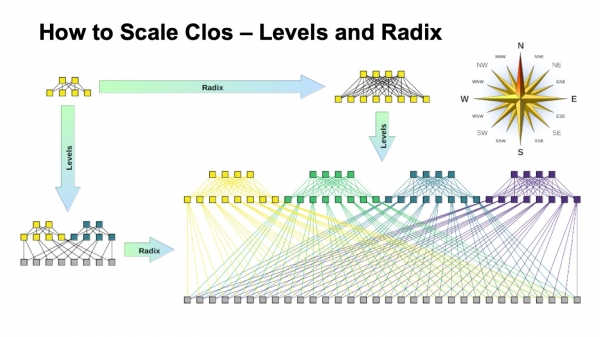
Wat betreft de capaciteit, vooral op ToR-switches, zijn er hier twee opschalingsopties. Of we kunnen, terwijl we de algemene topologie behouden, snellere links gebruiken, of we kunnen meer lagen toevoegen.
Als we kijken naar de uitgebreide versie van het Clos-netwerk (in de rechterbenedenhoek) en terugkeren naar deze afbeelding met het Clos-netwerk onderaan...
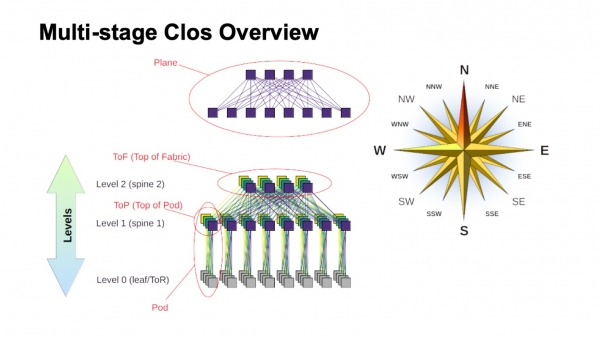
... dan is dit precies dezelfde topologie, maar op deze dia is deze compacter samengevoegd en zijn de fabriekslagen op elkaar gelegd. Dit is hetzelfde.
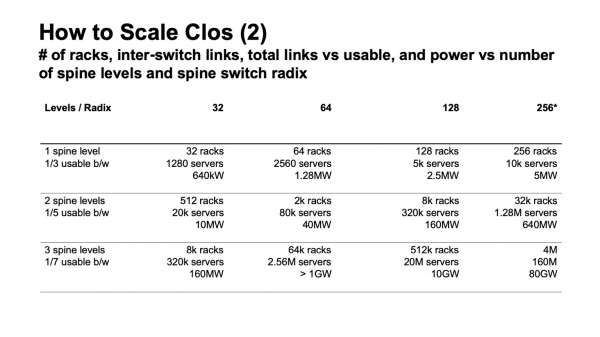
Hoe ziet de opschaling van het Clos-netwerk eruit in cijfers? Hier geef ik gegevens about de maximale breedte die we kunnen bereiken met het netwerk, het maximale aantal racks, ToR-switches of leaf-switches, als ze niet in racks staan, afhankelijk van de radix van de switches die worden gebruikt voor de spine-niveaus, en hoeveel niveaus we gebruiken.
Hier zie je hoeveel rekken we kunnen hebben, hoeveel servers en ongeveer hoeveel dit alles kan verbruiken, uitgaande van 20 kW per rek. Eerder noemde ik dat we mikken op een clusterformaat van ongeveer 100 duizend servers.
Het is duidelijk dat in deze constructie twee en een halve opties interessant zijn. Er is een optie met twee lagen spines en 64-poorts switches, die net niet voldoende is. Vervolgens zijn er uitstekende opties voor 128-poorts (met radix 128) spine-switches met twee niveaus, of switches met radix 32 met drie niveaus. En in alle gevallen, waar meer radix en meer niveaus zijn, kun je een zeer groot netwerk creëren, maar als je kijkt naar het verwachte verbruik, zijn dat meestal gigawatts. Kabels kunnen worden gelegd, maar zoveel elektriciteit op één locatie zullen we waarschijnlijk niet krijgen. Als je naar de statistieken kijkt, is er heel weinig te vinden over datacenters met een geschatte capaciteit van meer dan 150 MW. Wat meer is—zijn meestal datacentercampussen, verschillende grote datacenters die relatief dicht bij elkaar liggen.
Er is nog een belangrijk parameter. Als je naar de linker kolom kijkt, daar staat de bruikbare bandbreedte aangegeven. Het is niet moeilijk te zien dat in een Clos-netwerk een aanzienlijk deel van de poorten gebruikt wordt om switches met elkaar te verbinden. Bruikbare bandbreedte, datgene wat we extern naar de servers kunnen geven. Uiteraard heb ik het over hypothetische poorten en juist over de bandbreedte. Over het algemeen zijn de links binnen het netwerk sneller dan de links naar de servers, maar per eenheid bandbreedte, voor zover we deze extern naar onze serverhardware kunnen geven, valt er nog iets van bandbreedte binnen het netwerk zelf. En hoe meer niveaus we creëren, hoe groter de specifieke kosten zijn om deze bandbreedte extern beschikbaar te stellen.
Bovendien is zelfs deze extra bandbreedte niet helemaal gelijk. Zolang de afstanden kort zijn, kunnen we iets gebruiken als DAC (direct attach copper, dat wil zeggen twinax-kabels), of multimode-optica, die nog redelijk geprijsd zijn. Zodra we overstappen naar langere afstanden — meestal is dat single mode-optica, en de kosten van deze extra bandbreedte stijgen aanzienlijk.
En opnieuw, terugblikkend op de vorige dia, als we een Clos-netwerk maken zonder herondertekening, is het niet moeilijk om naar het schema te kijken en te zien hoe het netwerk wordt gebouwd - door elke laag spine-switches toe te voegen, herhalen we de hele strook die onderaan was. Plus de laag - plus dezelfde strook, nog zoveel als er op het vorige niveau waren, poorten op de switches, nog zoveel transceivers. Daarom is het zeer wenselijk om het aantal lagen spine-switches te minimaliseren.
Uit dit plaatje blijkt dat we heel graag willen bouwen op iets als switches met een radix van 128.
Hier is in principe alles hetzelfde als wat ik net heb verteld; deze dia is meer voor latere bespreking.
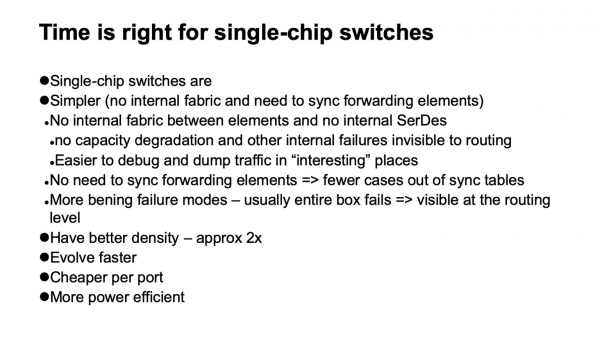
Wat zijn de opties die we kunnen kiezen als zulke switches? Een prettige mededeling voor ons is dat we nu eindelijk zulke netwerken kunnen bouwen op single-chip switches. En dat is geweldig, ze hebben veel fijne eigenschappen. Bijvoorbeeld, ze hebben bijna geen interne structuur. Dit betekent dat ze eenvoudiger kunnen falen. Ze falen wel, dat moet ook, maar gelukkig falen ze volledig. In modulaire apparaten zijn er veel storingen (zeer onaangenaam), waarbij het van de buren en de control plane lijkt te werken, maar bijvoorbeeld een deel van de fabric is weggevallen, en het werkt niet op volle capaciteit. Het verkeer wordt gebalanceerd op basis van het feit dat het volledig functioneel is, en we kunnen een overbelasting krijgen.
Of er ontstaan bijvoorbeeld problemen met de backplane, omdat er binnen het modulaire apparaat ook hoge snelheid SerDes zijn - het is daadwerkelijk complex van binnen. Of het synchroniseert wel of niet de tabellen tussen de forwarding-elementen. Kortom, elk hoogwaardig modulair apparaat, dat uit veel elementen bestaat, bevat in principe weer datzelfde Clos-netwerk, alleen is het heel moeilijk te diagnosticeren. Vaak is het zelfs voor de leverancier zelf moeilijk om te diagnosticeren.
En er zijn veel uitvalscenario's waarin het apparaat degradeert, maar niet volledig uit de topologie valt. Aangezien we een groot netwerk hebben, wordt er actief gebruikgemaakt van load balancing tussen identieke elementen en is het netwerk zeer regelmatig, dat wil zeggen dat één pad waarop alles in orde is, niet verschilt van een ander pad. Het is voordeliger om gewoon een deel van de apparaten uit de topologie te verliezen dan om in een situatie terecht te komen waarin sommige van hen schijnbaar werken, maar dat eigenlijk niet doen.
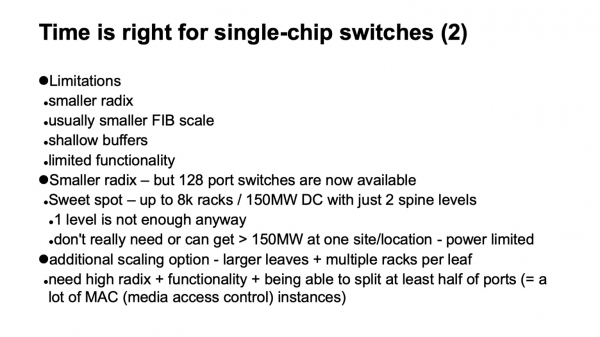
Een ander prettig kenmerk van single-chip apparaten is dat ze beter en sneller evolueren. Ook hebben ze doorgaans een betere capaciteit. Als we kijken naar de grote samenstellingen die we hebben, dan is de capaciteit per rack-eenheid bij dezelfde snelheid bijna twee keer beter dan bij modulaire apparaten. Apparaten die zijn gebouwd rond één chip zijn aanzienlijk goedkoper dan modulaire en verbruiken minder energie.
Maar het is natuurlijk niet allemaal rozengeur en maneschijn; er zijn ook nadelen. Ten eerste hebben ze vrijwel altijd een kleinere radix dan modulaire apparaten. Als we een apparaat dat rond één chip is gebouwd kunnen krijgen met 128 poorten, kunnen we een modulaire nu al met enkele honderden poorten krijgen zonder al te veel problemen.
Dit resulteert in duidelijk kleinere forwarding-tabellen en over het algemeen alles wat betreft de schaalbaarheid van het data plane. Ondiepere buffers. En over het algemeen een vrij beperkte functionaliteit. Maar het blijkt dat als je deze beperkingen kent en op tijd zorgen maakt om ze te omzeilen of gewoon in overweging te nemen, het niet zo eng is. Dat de radix kleiner is, vormt nu geen probleem meer bij de recent verschenen apparaten met een radix van 128; we kunnen ons in twee lagen spines bouwen. Met één laag krijgen we gewoon te kleine clusters. Zelfs onze vorige ontwerpen en eisen overtroffen deze nog steeds.
In feite, als de oplossing ergens op de rand ligt, is er nog een manier om te schalen. Aangezien het laatste (of eerste), de laagste niveau waar servers aan worden aangesloten - ToR-switches of leaf-switches, zijn we niet verplicht om slechts één rack aan hen te koppelen. Dus als de oplossing ergens niet helemaal voldoet, kan men overwegen om simpelweg een switch met een grotere radix op het onderste niveau te gebruiken en bijvoorbeeld twee of drie racks aan één switch aan te sluiten. Dit is ook een optie, het heeft zijn eigen kosten, maar het werkt prima en kan een goede oplossing blijken te zijn wanneer het nodig is om ergens de grootte te verdubbelen.
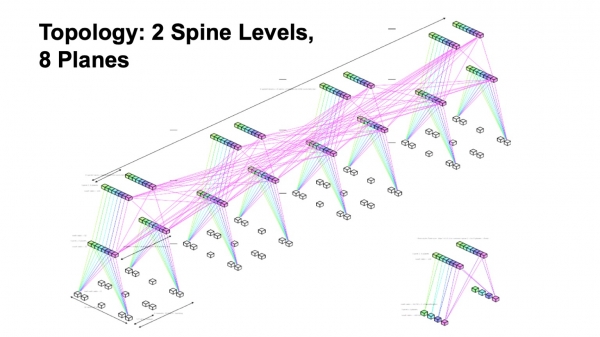
Samenvattend, we bouwen op een topologie met twee niveaus van spine switches, met acht lagen van de fabriek.
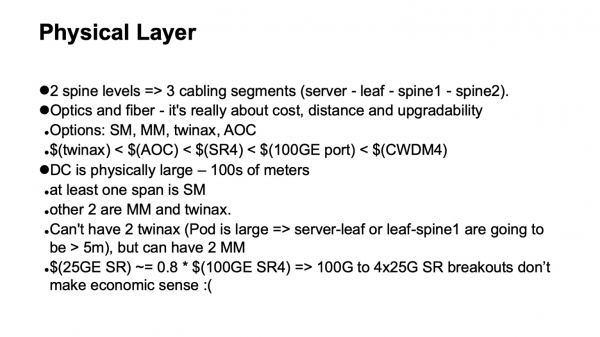
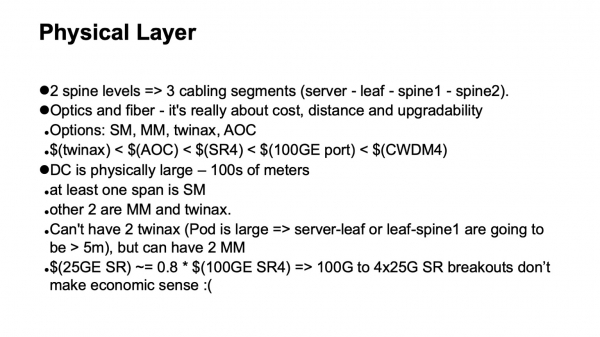
Wat gebeurt er met de fysica? Erg eenvoudige berekeningen. Als we twee niveaus van spine switches hebben, hebben we in totaal drie niveaus van switches, en we verwachten dat er in het netwerk drie kabelsegmenten zijn: van de servers naar de leaf switches, naar spine 1, naar spine 2. De opties die we kunnen gebruiken zijn twinax, multimode, single mode. En hier moet rekening worden gehouden met welke bandbreedte beschikbaar is, wat het zal kosten, wat de fysieke afmetingen zijn, welke overspanningen we kunnen doen, en hoe we zullen upgraden.
Wat de kosten betreft, kan alles lineair worden opgebouwd. Twinax is aanzienlijk goedkoper dan actieve optiek, goedkoper dan multimode transceivers als we kijken naar de overspanning vanaf het eind, iets goedkoper dan een 100-gigabit switchpoort. En let op, het is goedkoper dan single mode optiek, omdat in datacenters waar single mode vereist is, om verschillende redenen het logisch is om CWDM te gebruiken, het werken met parallelle single mode (PSM) is niet erg handig, er ontstaan zeer grote bundels vezels, en als we bij deze technologieën blijven, ontstaat er ongeveer zo'n hiërarchie in prijzen.
Nog een opmerking: helaas is het niet echt mogelijk om de ontlede 100 naar 4x25 multimode poorten te gebruiken. Vanwege de constructiekenmerken van SFP28 transceivers, is het niet veel goedkoper dan QSFP28 op 100 Gbit. En deze ontleding werkt niet echt voor multimode.
Een andere beperking is dat, vanwege de omvang van de rekenclusters en het aantal servers, onze datacenters fysiek groot zijn. Dit betekent dat ten minste één overspanning met singlemode moet worden gemaakt. Nogmaals, vanwege de fysieke grootte van de pods is het niet mogelijk om twee overspanningen van twinax (koperkabels) te maken.
Uiteindelijk, als we optimaliseren op prijs en rekening houden met de geometrie van deze constructie, komen we uit op één overspanning met twinax, één overspanning met multimode en één overspanning met singlemode met behulp van CWDM. Dit houdt rekening met mogelijke upgradepaden.
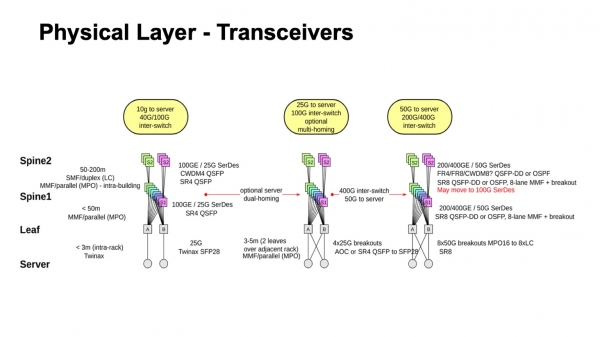
Zo ziet het eruit, wat er onlangs was, waar we naartoe gaan en wat mogelijk is. Het is in ieder geval duidelijk hoe we richting 50-gigabit SerDes gaan, zowel voor multimode als singlemode. Bovendien, als we kijken naar wat er momenteel beschikbaar is in singlemode transceivers en in de toekomst voor 400G, zien we vaak dat wanneer er 50G SerDes met elektrische kant komen, de optiek al 100 Gbps per lane kan geven. Daarom is het heel goed mogelijk dat in plaats van over te stappen op 50, we misschien wel overstappen op 100-gigabit SerDes en 100 Gbps per lane, omdat veel leveranciers hun beschikbaarheid vrij snel verwachten. De periode waarin 50G SerDes de snelsten waren, lijkt niet erg lang te zijn, omdat de eerste exemplaren van 100G SerDes bijna volgend jaar op de markt komen. En enige tijd daarna kunnen ze misschien voor een redelijke prijs verkrijgbaar zijn.
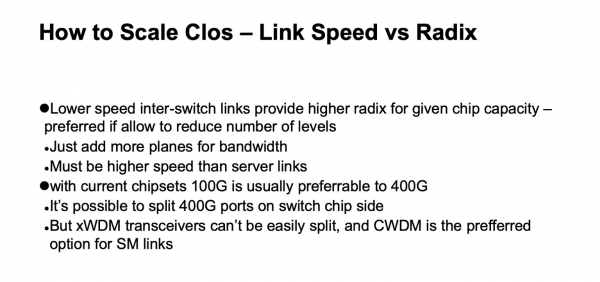
Een ander aspect betreft de keuze van de fysieke infrastructuur. In principe kunnen we nu al 400- of 200-gigabit poorten gebruiken met 50G SerDes. Maar het blijkt dat dit niet veel zin heeft, aangezien we, zoals ik eerder heb uitgelegd, een redelijk groot radix op de switches willen hebben. We willen 128. En als we de chipcapaciteit beperken en de link-snelheid verhogen, dan daalt de radix natuurlijk, er zijn geen wonderen.
En we kunnen de totale capaciteit verhogen door het aantal vlakken te verhogen, zonder speciale kosten te maken, we kunnen het aantal vlakken verhogen. Maar als we radix verliezen, moeten we een extra niveau invoeren, dus onder de huidige omstandigheden en de maximaal beschikbare capaciteit per chip, blijkt het efficiënter om 100-gigabit poorten te gebruiken, omdat ze een grotere radix mogelijk maken.
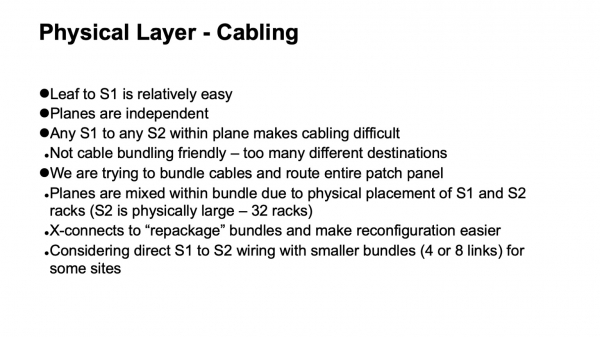
De volgende vraag is hoe de fysieke opzet is, maar dan vanuit het perspectief van de kabelinfrastructuur. Het blijkt dat deze behoorlijk grappig is georganiseerd. De bekabeling tussen de leaf-switches en de eerste niveau spine switches - daar zijn niet zo veel verbindingen, het is allemaal relatief eenvoudig opgebouwd. Maar als we één vlak nemen, dan moet alles binnenin met elkaar verbonden worden - we moeten alle eerste niveau spine switches met alle tweede niveau spine switches verbinden.
Bovendien zijn er meestal enkele wensen over hoe dit eruit moet zien binnen het datacenter. Bijvoorbeeld, we wilden heel graag de kabels in bundels samenvoegen en ze zo trekken dat één hoge dichtheid patchpanel geheel in een ander patchpanel verdwijnt, zodat er geen zooitje aan lengtes ontstaat. We zijn erin geslaagd om deze uitdaging aan te gaan. Als we naar de logische topologie kijken, zien we dat de vlakken onafhankelijk zijn; elk vlak kan voor zich worden opgebouwd. Maar wanneer we deze bundeling toevoegen en we willen een complete patchpanel in een andere patchpanel trekken, dan moeten we binnen één bundel verschillende vlakken mengen en een tussenconstructie in de vorm van optische cross-connects invoeren, om ze opnieuw te verpakken van hoe ze in één segment zijn opgebouwd naar hoe ze in een ander segment zullen worden opgebouwd. Hierdoor krijgen we een prettig kenmerk: al die complexe schakelingen blijven binnen de kasten. Wanneer we iets heel sterk verknopen moeten, 'vlakken uitrollen', zoals dat soms wordt genoemd in Clos-netwerken, is dit allemaal geconcentreerd binnen één kast. We hebben geen sterk gescheiden, tot individuele verbindingen, schakelingen tussen de kasten.
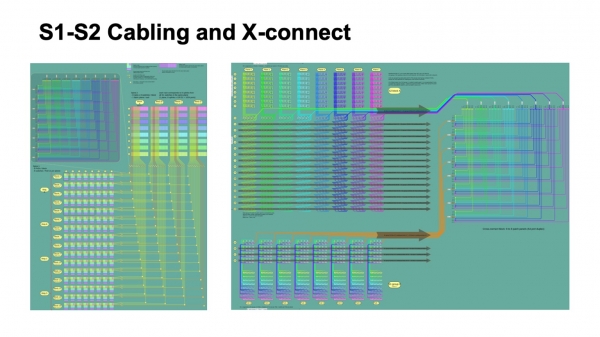
Dit is hoe het eruitziet vanuit het perspectief van de logische organisatie van de kabelinfrastructuur. Op de afbeelding links vertegenwoordigen de gekleurde blokken de blokken van de eerste niveau spine switches, acht in totaal, en de vier bundels kabels die van hen komen, welke gaan en kruisen met de bundels van de spine-2 switches.
De kleine vierkantjes geven de kruisingen aan. Bovenaan links is de uitsnede van elke kruising weergegeven; dit is eigenlijk een cross-connect module van 512 op 512 poorten, die de kabels herverpakt zodat ze volledig in één rack komen, waar slechts één vlak van spine-2 is. En rechts is een iets gedetailleerdere uitsnede van deze afbeelding met betrekking tot verschillende Pods op het niveau van spine-1, en hoe dit wordt verpakt in de cross-connect, en hoe dit op het niveau van spine-2 binnenkomt.
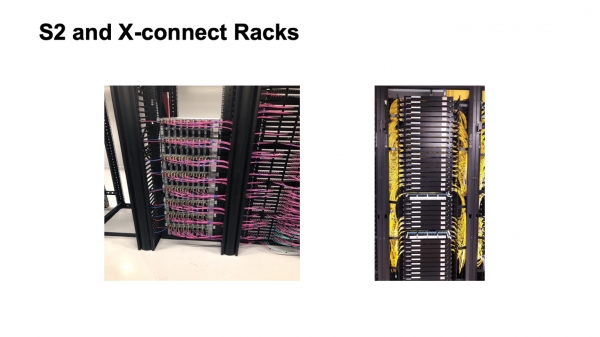
Zo ziet het eruit. Een nog niet volledig gebouwde spine-2 rack (links) en een cross-connect rack. Helaas is er niet veel zichtbaar. Deze constructie wordt momenteel uitgerold in een van onze grote datacenters dat aan het uitbreiden is. Dit is een werk in uitvoering en zal er mooier uitzien, beter gevuld zijn.
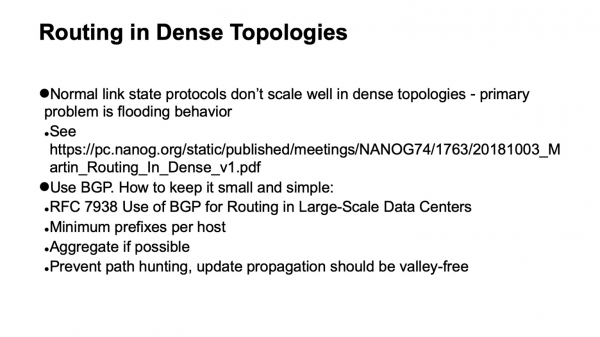
Een belangrijke vraag: we hebben een logische topologie gekozen en de fysieke structuur gebouwd. Wat gaat er gebeuren met de control plane? Uit operationele ervaring is het redelijk goed bekend dat er een aantal signalen zijn dat link state protocollen goed zijn, prettig om mee te werken, maar helaas, in een dicht verbonden topologie schalen ze niet goed. En er is één hoofd reden die dit belemmert — dit is hoe flooding werkt in link state protocollen. Als je gewoon het flooding algoritme neemt en kijkt naar hoe ons netwerk is opgebouwd, zie je dat er in elke stap een zeer grote fanout zal zijn, en dat zal gewoon de control plane overspoelen met updates. Dergelijke topologieën, specifiek met het traditionele flooding algoritme in link state protocollen, mengen zich zeer slecht.
De keuze is — gebruik BGP. Hoe je het goed voorbereidt, is beschreven in RFC 7938 over het gebruik van BGP in grote datacenters. De basisideeën zijn eenvoudig: het minimale aantal prefixen per host en überhaupt het minimale aantal prefixen in het netwerk, aggregatie gebruiken als dat mogelijk is, en path hunting onderdrukken. We willen een zeer voorzichtige, zeer gecontroleerde verspreiding van updates, wat valley free wordt genoemd. We willen dat updates, als ze door het netwerk gaan, precies één keer worden uitgerold. Als ze onderaan ontstaan, gaan ze omhoog en worden ze niet meer dan één keer uitgerold. Er mogen geen zigzags zijn. Zigzags zijn heel slecht.
Om dit te doen, gebruiken we een vrij eenvoudige opzet om de basismechanismen van BGP te gebruiken. Dat wil zeggen, we hebben eBGP dat op link local draait, en autonome systemen worden als volgt toegewezen: een autonoom systeem op de ToR, een autonoom systeem voor de hele groep spina-1-switches van een Pod, en een algemeen autonoom systeem voor de hele Top of Fabric. Het is niet moeilijk om te kijken en te bevestigen dat zelfs normaal BGP-gedrag ons de verspreiding van updates geeft die we willen.
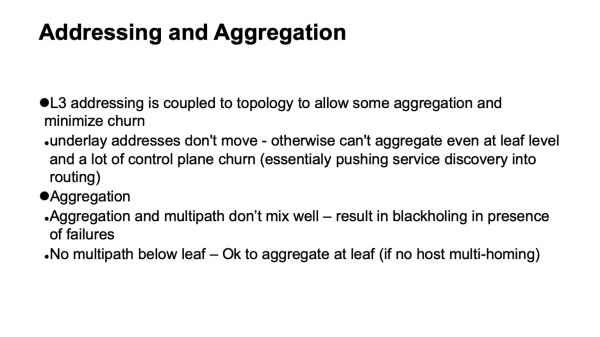
Natuurlijk moeten we de adressering en aggregatie zo ontwerpen dat deze compatibel is met hoe de routering is opgebouwd, zodat dit stabiliteit van het control plane biedt. L3-adressering in transport is gekoppeld aan de topologie, omdat zonder dit geen aggregatie kan worden bereikt; afzonderlijke adressen zullen het routersysteem binnendringen. En nog iets — aggregatie mengt helaas niet goed met multi-path, want wanneer we multi-path hebben en er is aggregatie, is alles goed zolang het hele netwerk operationeel is en er geen storingen zijn. Helaas, zodra er storingen in het netwerk optreden en de symmetrie van de topologie verloren gaat, kunnen we terechtkomen op een punt waar de aggregaat werd aangekondigd, waar we niet verder kunnen gaan naar waar we moeten zijn. Daarom is het het beste om te aggregeren waar verder geen multi-path is, in ons geval zijn dit de ToR-switches.
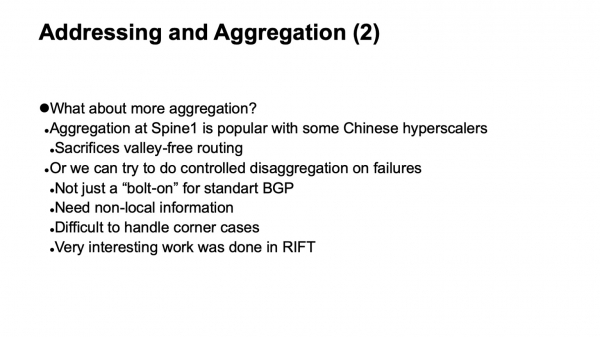
In feite kan aggregatie, maar je moet voorzichtig zijn. Als we een gecontroleerde de-agregatie kunnen doen bij netwerkstoringen. Maar dit is een vrij complexe taak; we hebben zelfs overwogen of het mogelijk is om extra automatisering te implementeren en eindige automaten die BGP op de juiste manier kunnen activeren voor het gewenste gedrag. Helaas is het verwerken van corner cases erg onduidelijk en complex, en door verbinding te maken met extern BGP-apparatuur wordt deze taak niet goed opgelost.
Er is heel interessant werk verricht op dit gebied binnen het RIFT-protocol, dat in de volgende presentatie zal worden besproken.
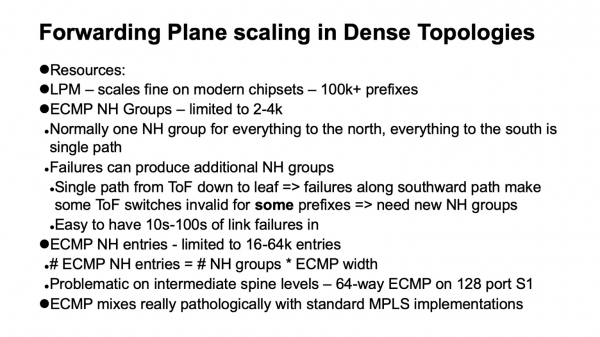
Een ander belangrijk punt is hoe de data planes schalen in dichte topologieën, waar we veel alternatieve paden hebben. Hierbij worden een paar extra datastructuren gebruikt: ECMP-groepen, die op hun beurt de Next Hop-groepen beschrijven.
In een normaal functionerend netwerk, zonder onderbrekingen, wanneer we omhoog gaan in een Clos-topologie, is het voldoende om slechts één groep te gebruiken, omdat alles wat niet lokaal is, wordt beschreven door de default, en we kunnen omhooggaan. Wanneer we van boven naar beneden naar het zuiden gaan, zijn alle paden geen ECMP, dit zijn single path-paden. Alles is goed. Het probleem is dat een kenmerk van de klassieke Clos-topologie is dat als we naar de Top of Fabric kijken, elk element slechts één pad heeft naar elk element daaronder. Als er langs dit pad storingen optreden, wordt dat specifieke element bovenaan de fabric ongeldig voor die prefixen die achter het defecte pad liggen. Maar voor de overige is het geldig, en we moeten de ECMP-groepen ontleden en een nieuwe status invoeren.
Hoe ziet de schaalbaarheid van de data plane eruit op moderne apparaten? Als we LPM (longest prefix match) doen, gaat alles behoorlijk goed, boven de 100k prefixen. Als we het hebben over Next Hop-groepen, is het een stuk minder, 2-4 duizend. Als we het hebben over de tabel die de beschrijving van Next Hops (of adjacencies) bevat, is dat ergens tussen de 16k en 64k. En dat kan een probleem worden. En hier komen we bij een interessante afleiding: wat er is gebeurd met MPLS in datacenters? In principe wilden we het implementeren.
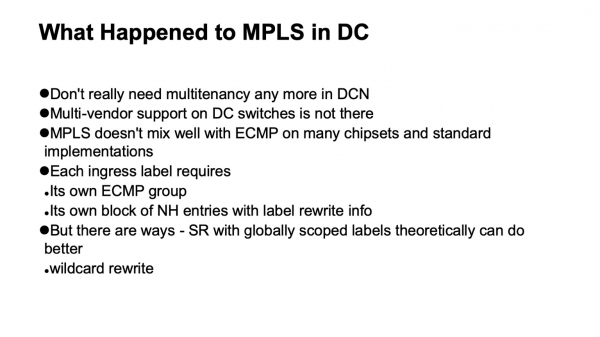
Er zijn twee dingen gebeurd. We hebben microsegmentatie op hosts gedaan, waardoor we het niet meer op het netwerk hoeven te doen. De ondersteuning van verschillende leveranciers was niet erg goed, vooral niet met open implementaties op white boxes met MPLS. En bovendien, MPLS, of in elk geval de traditionele implementaties, werken helaas niet goed samen met ECMP. En dat is waarom.
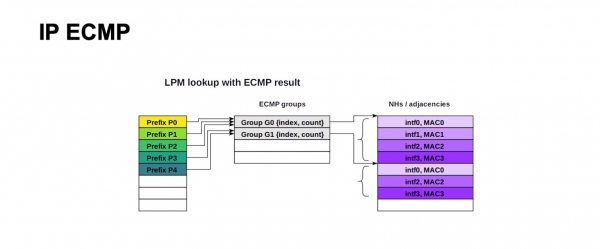
Dit is de structuur van ECMP-forwarding voor IP. Een groot aantal prefixen kan dezelfde groep en hetzelfde blok Next Hops (of adjacencies, in verschillende documentatie voor verschillende apparaten kan dit anders genoemd worden) gebruiken. Het idee is dat dit wordt beschreven als de uitgaande poort en waar het MAC-adres moet worden herschreven om bij de juiste Next Hop te komen. Voor IP lijkt het eenvoudig, je kunt een zeer groot aantal prefixen op dezelfde groep en hetzelfde blok Next Hops gebruiken.
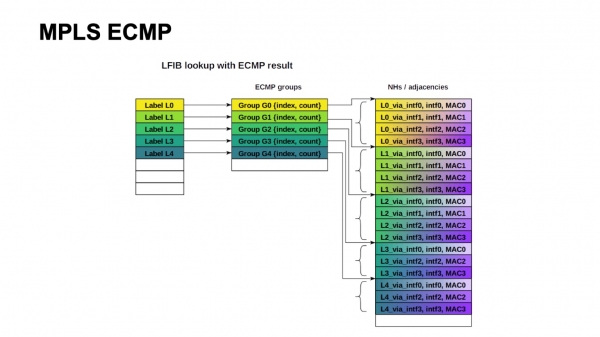
De klassieke MPLS-architectuur houdt in dat, afhankelijk van de uitgaande interface, de tag op verschillende waarden kan worden herschreven. Daarom moeten we voor elke inkomende tag een groep en een blok Next Hops behouden. En dat, helaas, schaalt niet.
Het is niet moeilijk te zien dat we ongeveer 4000 ToR-switches nodig hadden in onze constructie, met een maximale breedte van 64 ECMP-paden, als we van spine-1 naar spine-2 gaan. We slagen er met moeite in om binnen een ECMP-groepentabel te passen als er slechts één prefix van ToR gaat, en we passen helemaal niet in de Next Hops-tabel.
Niet alles is hopeloos, want architecturen zoals Segment Routing impliceren globale labels. Formeel zouden we al deze Next Hops-blokken opnieuw kunnen samenvoegen. Hiervoor is een operatie nodig zoals wild card: neem een label en schrijf het over naar hetzelfde label zonder specifieke waarde. Maar helaas komt dit in de beschikbare implementaties niet veel voor.
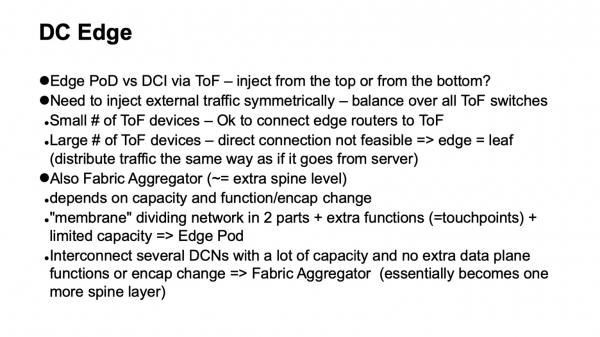
En tot slot moeten we extern verkeer naar het datacenter brengen. Hoe doen we dat? Eerder ging het verkeer de Clos-netwerken binnen vanaf de bovenkant. Dat wil zeggen, er waren grensrouters die met alle apparaten op de Top of fabric waren verbonden. Deze oplossing werkt behoorlijk goed op kleine en middelgrote schaal. Helaas, om verkeer op deze manier symmetrisch door het hele netwerk te brengen, moeten we tegelijkertijd op alle elementen van de Top of fabric komen, en wanneer dit er meer dan honderd worden, blijkt dat we een grote radix ook op de grensrouters nodig hebben. Dit kost überhaupt geld, omdat grensrouters functioneler zijn, de poorten daarop zijn duurder, en het lijkt niet erg mooi.
Een andere optie is om het verkeer van onderaf binnen te brengen. Het is niet moeilijk te zien dat de Clos-topologie zo is opgebouwd dat het verkeer, dat van onderen binnenkomt, dat wil zeggen vanaf de ToR, gelijkmatig over de niveaus van de hele Top of fabric wordt verdeeld in twee iteraties, waardoor het hele netwerk wordt belast. Daarom introduceren we een speciaal type Pod, de Edge Pod, die zorgt voor externe connectiviteit.
Er is nog een andere optie. Dit is bijvoorbeeld wat Facebook doet. Ze noemen het Fabric Aggregator of HGRID. Een extra spine-niveau wordt geïntroduceerd om meerdere datacenters met elkaar te verbinden. Deze opstelling is mogelijk als we geen extra functies of encapsulatie op de grenzen hebben. Als die er zijn, zijn dat extra touchpoints en dat wordt ingewikkeld. Meestal ontstaan er meer functies en een soort membraan die verschillende delen van het datacenter scheidt. Het is niet verstandig om deze membraan te groot te maken, maar als het echt nodig is, is het zinvol om te overwegen deze over te brengen, zo breed mogelijk te maken en naar de hosts te verplaatsen. Dit is bijvoorbeeld wat veel cloudproviders doen. Ze hebben overlays die beginnen bij de hosts.
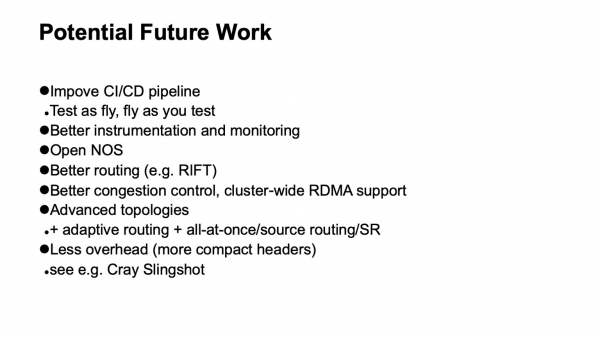
Welke ontwikkelingsmogelijkheden zien we? In de eerste plaats - verbeterde ondersteuning van de CI/CD-pijplijn. We willen vliegen zoals we testen en testen zoals we vliegen. Dit is niet erg goed haalbaar, omdat de infrastructuur groot is en het onmogelijk is deze voor tests te dupliceren. We moeten begrijpen hoe we test elementen kunnen integreren in de operationele infrastructuur zonder deze in gevaar te brengen.
Betere instrumentatie en betere monitoring zijn vrijwel nooit overbodig. De vraag is een balans tussen inspanning en rendement. Als het mogelijk is om dit op een redelijke manier toe te voegen - dan is dat zeer goed.
Open besturingssystemen voor netwerkapparaten. De beste protocollen en de beste routeringssystemen, zoals RIFT. Ook zijn er onderzoeken nodig naar het gebruik van de beste congestiecontrolesystemen en mogelijk, op zijn minst op bepaalde punten, de ondersteuning van RDMA binnen het cluster.
Als we naar de verder weg gelegen toekomst kijken, zijn er geavanceerde topologieën nodig en mogelijk netwerken die minder overhead gebruiken. Van recente zaken - er zijn recent publicaties geweest over de fabrictechnologie voor HPC Cray Slingshot, die is gebaseerd op commodity Ethernet, maar met de optie om veel kortere headers te gebruiken. Hierdoor wordt de overhead verminderd.
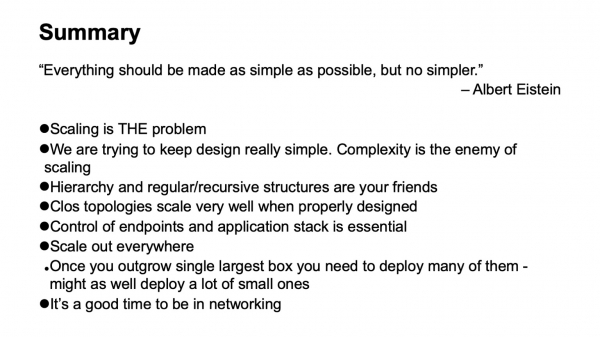
Alles moet zo eenvoudig mogelijk zijn, maar niet eenvoudiger. Complexiteit is de vijand van schaalbaarheid. Eenvoud en regelmatige structuren zijn onze vrienden. Als je ergens scalability kunt toepassen - doe dat. En over het algemeen is het nu geweldig om met netwerktechnologieën bezig te zijn. Er gebeurt zoveel interessants. Bedankt.
Bron: habr.com
