

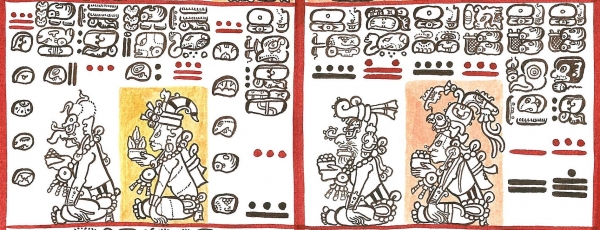
Het Maya-schrift was het enige volledige schrijfsysteem in Amerika, maar dankzij de inspanningen van dappere Spaanse conquistadores was het tegen de 17e eeuw volledig vergeten. Toch zijn duizenden van deze symbolen bewaard gebleven op bewerkte stenen, fresco's en keramiek, en in de 20e eeuw kwam een gewone Sovjet-postgraduaat met een idee dat de deciphering mogelijk maakte. Dit artikel laat zien hoe dit systeem is opgebouwd.
Het Maya-schrift is een logosyllabisch (woord- en lettergrepen) systeem, waarin het merendeel van de symbolen bestaat uit , die woorden of concepten aanduiden (bijvoorbeeld 'schild' of 'jaguaar'), terwijl een kleiner deel bestaat uit , die de geluiden van afzonderlijke lettergrepen voorstellen ('pa', 'ma') en het geluid van een woord bepalen.
Er zijn tot nu toe ongeveer 5000 teksten bewaard gebleven, waarvan epigrafisten meer dan duizend glyphen hebben geïdentificeerd. Veel van deze glyphen zijn variaties van dezelfde tekens (allografen) of hebben dezelfde uitspraak (homofonen). Zo kunnen we 'slechts' ongeveer 500 hiërogliefen onderscheiden, wat veel meer is dan bij de alfabetten die we gewend zijn, maar minder dan bij de Chinezen met hun 12.000 symbolen. De fonetische betekenis is bekend voor 80% van deze symbolen, terwijl de semantische betekenis slechts voor 60% bekend is, maar hun decryptie gaat door.
De vroegste bekende Maya-teksten dateren uit de 3e eeuw voor Christus, en de nieuwste uit de tijd van de Spaanse veroveringen in de 16e eeuw na Christus. Dit schrift verdween helemaal in de 17e eeuw, toen de laatste Maya-koninkrijken werden veroverd.
De konijn-scribe op
Hoe Maya-hieroglyphen te lezen
De eerste moeilijkheid bij het leren van Maya-hieroglyphen is dat hun ontwerp vrij flexibel was, waardoor er verschillende manieren zijn om hetzelfde woord te schrijven zonder de uitspraak of betekenis te veranderen. Ja, het was een creatieve taak en de Maya-scribes leken hiervan te genieten en maakten volop gebruik van hun creatieve vrijheid:
Een kleine uitleg# На иллюстрациях транслитерация иероглифов майя в латинский алфавит выделяется жирным шрифтом. При этом заглавными буквами указываются LOGOGRAMMEN, en in kleine letters — syllabogrammen. Transcriptie is cursief gedrukt, en de vertaling is tussen aanhalingstekens «».
Zoals in het Latijns schrift bestonden woorden bij de Maya uit meerdere verbonden symbolen, maar door de beeldende aard van het schrift zijn ze veel moeilijker waar te nemen voor een ongetraind oog dan de gebruikelijke alfabetische systemen.
Een groep symbolen die samen een woord vormen, wordt een blok of een glyph-complex genoemd. Het grootste symbool in het blok wordt de hoofdglyph genoemd, terwijl de kleinere, eraan vastgezette symbolen affixen worden genoemd.
Gewoonlijk worden de symbolen in een glyph-blok van links naar rechts en van boven naar beneden gelezen. Op dezelfde manier worden Maya-teksten van links naar rechts en van boven naar beneden in kolommen van twee blokken geschreven.

Logogrammen
Logogrammen zijn symbolen die de betekenis en uitspraak van een compleet woord vertegenwoordigen. Zelfs in ons op het Latijn gebaseerde alfabetisch-fonetische schrijfsysteem gebruiken we logogrammen:
- @ (commercial at): wordt gebruikt in e-mailadressen en op sociale netwerken, oorspronkelijk toegepast in betalingsdocumenten ter vervanging van het Engelse woord at in de betekenis van 'tegen [prijs]'
- £: het symbool voor het Britse pond
- & (ampersand): vervangt het woord 'en'
De meeste symbolen in het hiëroglifische schrift van de Maya zijn logogrammen:

Een systeem dat alleen uit logogrammen zou bestaan, zou te omslachtig zijn, omdat het een apart symbool voor elk ding, idee of emotie zou vereisen. Ter vergelijking, zelfs het Chinese schrift, dat meer dan 12.000 symbolen bevat, is geen puur logografisch systeem.
Syllabogrammen
Naast logogrammen gebruikten de Maya syllabogrammen, die het mogelijk maakten het alfabet niet uit te breiden en de flexibiliteit van het systeem te behouden.
Een syllabogram of fonogram is een fonetisch teken dat een lettergreep aanduidt. In de Maya-talen fungeert het als een CV (medeklinker - klinker) of als een C (medeklinker zonder bijbehorende klinker).
Over het algemeen volgt de Maya-taal het patroon medeklinker-klinker-medeklinker (CVC), en in overeenstemming met het principe wordt de klinker van de laatste lettergreep in een woord gewoonlijk onderdrukt:
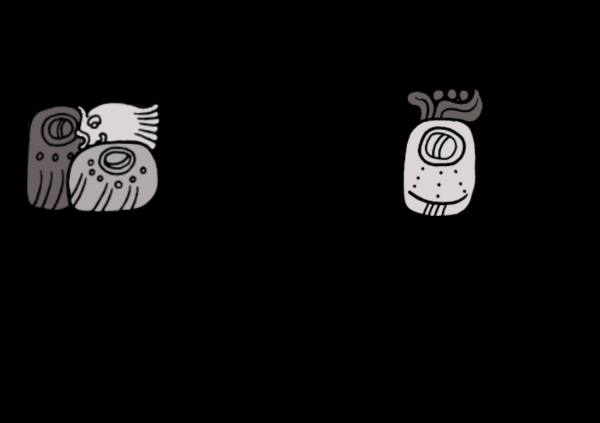
Het is interessant dat elk woord dat met een logogram is geschreven, volledig met syllabogrammen kan worden weergegeven. De oude Maya deden dit vaak, maar gaven logogrammen nooit volledig op.
Fonetische aanvullingen
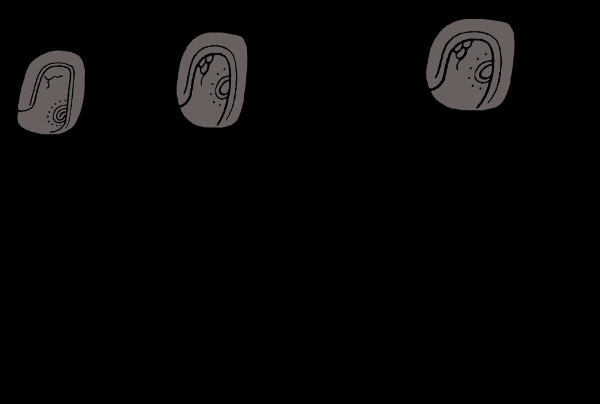
Fonetische toevoegingen behoren tot de meest voorkomende suffixen bij de Maya. Dit is een syllabogram dat helpt bij het lezen van logogrammen met meer dan één betekenis, of het geeft de uitspraak van de eerste lettergreep aan, wat het lezen vergemakkelijkt.
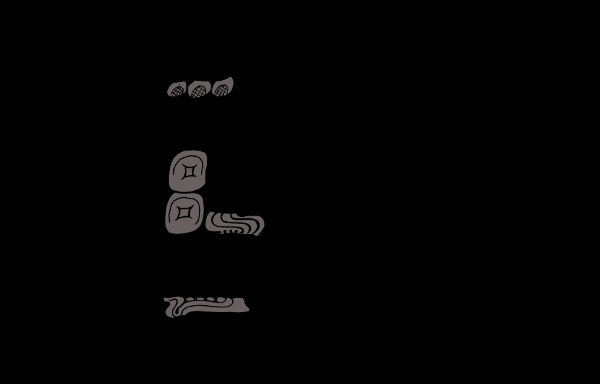
In het onderstaande voorbeeld is het symbool 'steen' (in grijs) ook een fonogram voor de klank 'ku', die wordt gebruikt in de woorden 'ahk' 'schildpad' of 'kutz' 'kalkoen' (de laatste klinker in beide gevallen wordt weggelaten). Maar wanneer het als een apart woord wordt geschreven, wordt de fonetische toevoeging 'ni' toegevoegd, die bevestigt dat dit inderdaad het woord 'steen' is:
Semantische determinanten en diakritische tekens
Semantische determinanten en diakritische markers helpen de lezer het geluid of de betekenis van het woord te begrijpen, maar worden, in tegenstelling tot fonetische toevoegingen, niet uitgesproken.
Een semantische determinant specificeert meer betekenende logogrammen. Een goed voorbeeld van een semantische determinant is een decoratieve rand rond een tekening of tekst. Deze wordt gebruikt om dagen in de :
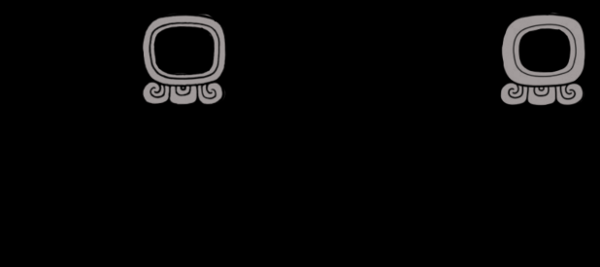
Diakritische markers bepalen de uitspraak van een glief. In Europese talen zijn er algemene markers, zoals
- de cedille: in het Frans geeft hij aan dat de letter c als s wordt uitgesproken en niet als k, bijvoorbeeld, façade.
- de diaeresis: in het Duits geeft het een verschuiving van de klinkers /a/, /o/ of /u/ naar voren aan, bijvoorbeeld, schön [ʃøːn] — "mooi", schon [ʃoːn] — "al".
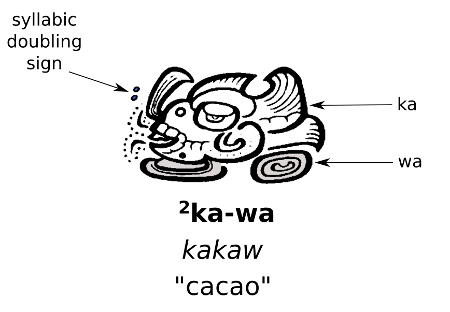
In de Maya-schriftstellerij is een veelvoorkomende diakritische marker een paar punten in de bovenste (of onderste) linkerhoek van de gliefblokken. Deze wijzen de lezer op de herhaling van de lettergreep. In het onderstaande voorbeeld wordt de lettergreep 'ka' gedupliceerd:
Polyfonie en homofonie
Polyfonie en homofonie compliceren de Maya-schriftstellerij verder. Bij polyfonie wordt hetzelfde teken op verschillende manieren uitgesproken en gelezen. In het hiëroglifische schrift van de Maya wordt bijvoorbeeld het woord tuun en de lettergreep ku aangeduid met hetzelfde symbool:
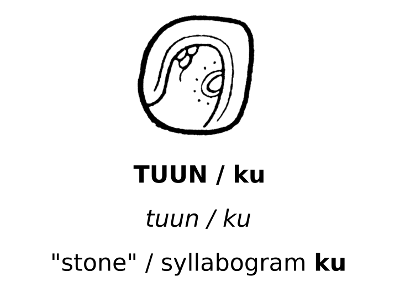
betekent dat dezelfde klank door verschillende tekens wordt vertegenwoordigd. In de Maya-schrift worden de woorden 'slang', 'vier' en 'hemel' op dezelfde manier uitgesproken, maar anders geschreven:
Woordenvolgorde
In tegenstelling tot het Engels, waar de structuur "onderwerp-werkwoord-voorwerp" (Subject-Verb-Object) wordt gebruikt, volgt de Maya-taal de volgorde "werkwoord-voorwerp-onderwerp" (Verb-Object-Subject). Omdat hiërogliefische teksten van de oude Maya's meestal met een datum beginnen en geen voorwerpen bevatten, zal de meest voorkomende structuur van zinnen "datum-werkwoord-onderwerp" (Date-Verb-Subject) zijn.
Het merendeel van de gevonden teksten is gegraveerd op monumentale structuren en beschrijft het leven van koningen en de geschiedenis van dynastieën. In dergelijke inscripties nemen datums tot 80% van de ruimte in. Werkwoorden worden meestal weergegeven door een of twee blokken glyphs, gevolgd door lange namen en titels.
Voornaamwoorden
De Maya's hadden twee sets voornaamwoorden. Set A werd gebruikt met transitive werkwoorden, terwijl set B met intransitieve werkwoorden werd gebruikt. Het meest voorkomende voorbeeld bij de Maya's was het gebruik van de derde persoon enkelvoud ("hij, zij, het", "zijn, haar, het") uit set A. Voornaamwoorden uit deze set worden zowel met zelfstandige naamwoorden als met werkwoorden gebruikt. De derde persoon enkelvoud wordt gevormd met de volgende prefixes:
- u- voor woorden of werkwoorden die beginnen met een medeklinker
- ya-, ye-, yi-, yo-, yu- voor woorden of werkwoorden die beginnen met de klinkers a, e, i, o, u respectievelijk.
In het eerste geval worden de volgende tekens gebruikt:
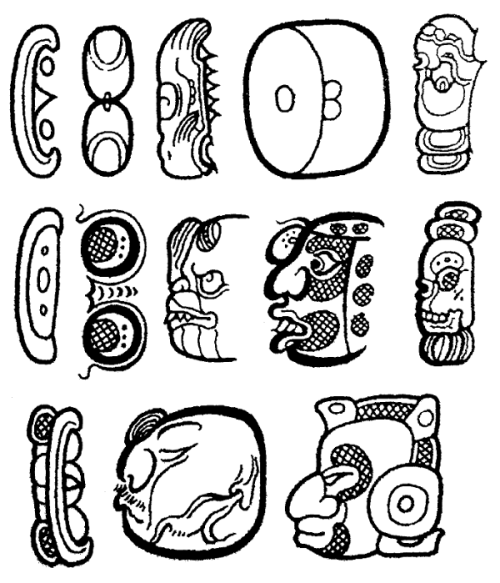
Elke van deze symbolen kan worden gebruikt om de derde persoon enkelvoud aan te duiden:
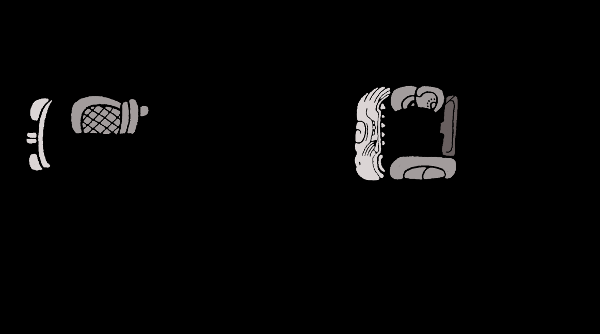
Let op het prefix /u/ in het eerste voorbeeld. Dit is een vereenvoudigde versie van het eerste teken in de derde rij van de vorige afbeelding.
Syllabograms voor het prefix -ya:
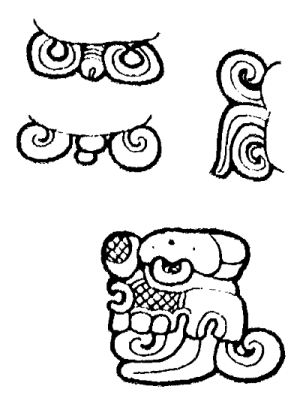
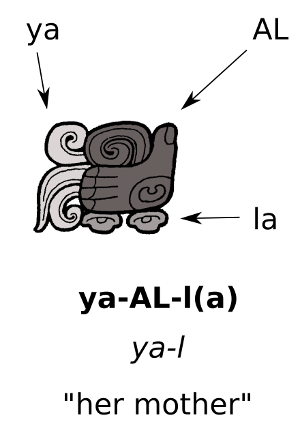
Voor ye-:
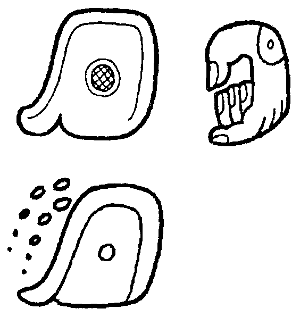
In het onderstaande voorbeeld is het teken ye- gestileerd als een hand:
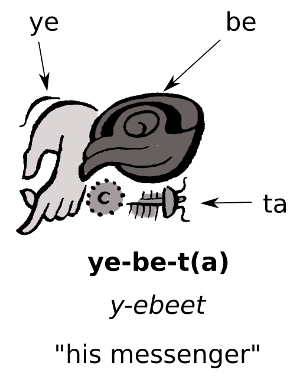
Voor yi:
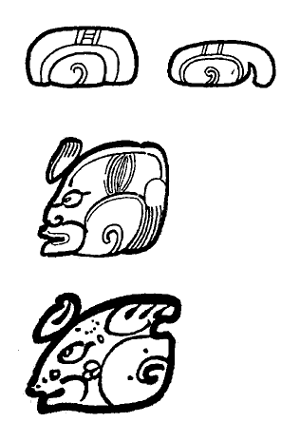
In dit voorbeeld draait yi met 90 ° tegen de klok in om esthetische redenen:

Voor yo-:
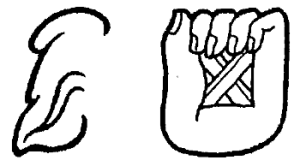
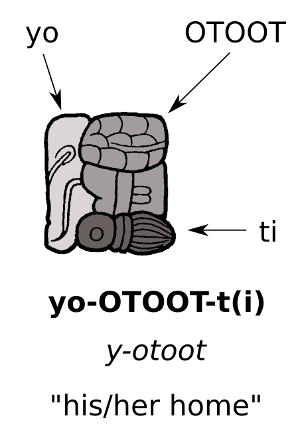
Voor yu-:
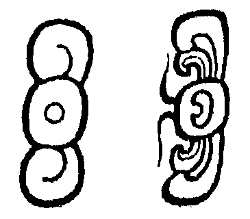
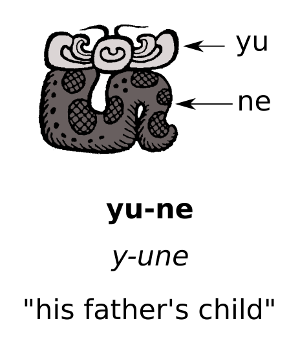
Zelfstandige naamwoorden
De Maya's hadden twee soorten zelfstandige naamwoorden: "bezittelijke" (possessed) en "absolute" (unpossessed).
Absolute zelfstandige naamwoorden hebben geen suffixen, met uitzondering van twee uitzonderingen:
- Het suffix -is duidt lichaamsdelen aan
- Het suffix -aj verwijst naar dingen die mensen dragen, zoals sieraden

Geslacht
In de Maya-taal is er geen geslacht, met uitzondering van zelfstandige naamwoorden die beroepen of functies beschrijven, zoals "schrijver", "koningin", "koning" enzovoorts. Voor dergelijke woorden wordt gebruikt:
- prefix Ix- voor vrouwen
- prefix Aj- voor mannen

Werkwoorden
De meeste oude Maya-teksten zijn bewaard gebleven op monumentale structuren en vertellen over de biografieën van heersers. Dit betekent dat bijna alle werkwoorden in de derde persoon zijn geschreven en onmiddellijk na de datums zijn geplaatst. In dergelijke inscripties komen vaak onovergankelijke werkwoorden voor, die geen aanvullingen kunnen verbinden.
Voor de verleden tijd (die nog steeds wordt besproken) wordt de suffix -iiy gebruikt, en voor de toekomst de suffix -oom:
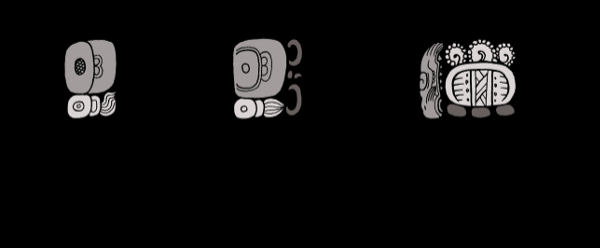
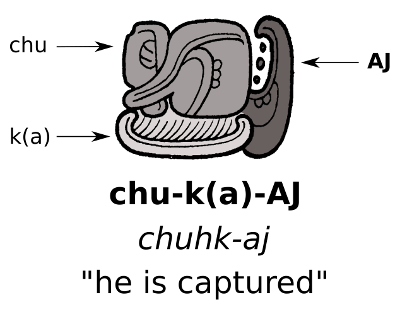
Vaak na het werkwoord is het teken -aj te zien, dat een transitief (in staat om een aanvulling te beheren) stam in een onovergankelijk werkwoord verandert, bijvoorbeeld, chuhk-aj (‘hij is gevangen’):
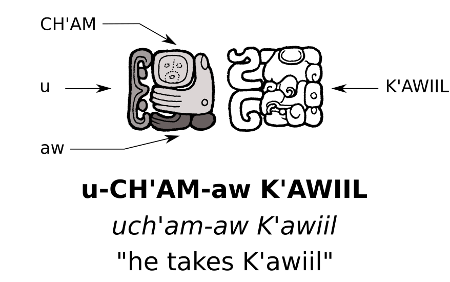
Een van de veelvoorkomende vormen van transitieve werkwoorden is gemakkelijk te herkennen aan het prefix u- (derde persoon voornaamwoorden) en de suffix -aw. Bijvoorbeeld, in teksten die over de heerschappij beginnen, wordt de frase uch’am-aw K’awiil gebruikt - ‘hij neemt K’awiil’ (Maya-heersers ontvingen geen troon, maar een scepter die de ):
Bijvoeglijke naamwoorden
In klassieke Maya-inscripties staan bijvoeglijke naamwoorden voor zelfstandige naamwoorden, en door het toevoegen van een syllabe (-al, -ul, -el, -il, -ol) aan het zelfstandig naamwoord, volgens de regels van singharmonie. Zo is het bijvoeglijke naamwoord ‘vuur’ k’ahk ‘ (‘vuur’) + -al = k’ahk’al:

De oorsprong van het Maya-schrift
Het Maya-schrift was niet het eerste schrijfsysteem in Meso-Amerika. Tot voor kort werd aangenomen dat het was voortgekomen uit (of epicholmeekse) schrift, maar in 2005 werden ontdekt , die de tijd van de creatie van het Maya-schrift verlegden.
Het wordt aangenomen dat de eerste schrijfsystemen in Meso-Amerika verschenen in de latere Olmeken-periodes (ongeveer 700-500 v.Chr.), en vervolgens splitsten ze zich in twee tradities:
- in het noorden in het Mexicaanse hoogland
- in het zuiden in de hooglanden en uitlopers van Guatemala en de Mexicaanse staat Chiapas.
Het Maya-schrift behoort tot de tweede traditie. De vroegste teksten zijn muurschilderingen in (Guatemala, 3e eeuw v.Chr.) en inscripties op stenen maskers van de ruïnes (Belize, 1e eeuw v.Chr.).
De tekst en afbeelding van de vroege Maya
De ontcijfering van het Maya-schrift
/Тут и далее я расширил исходную статью материалами из отечественных источников — прим. переводчика/
De ontcijfering van het Maya-schrift duurde anderhalve eeuw. Het wordt beschreven in verschillende boeken, het bekendste is - van Michael Co. Hieraan werd in 2008 een documentaire gewijd.
De eerste Maya-teksten werden gepubliceerd in de jaren 1810, toen er in Europese archieven wonderbaarlijk bewaarde Maya-boeken werden gevonden, die 'codices' werden genoemd, analoog aan de Europese. Ze trokken de aandacht en vanaf de jaren 1830 begon een grondige studie van de Maya-monumenten in Guatemala en Belize.
In 1862 ontdekte de Franse priester in de Real Academia de la Historia in Madrid het 'Verslag over de zaken in Yucatán' — een manuscript geschreven rond 1566 door de bisschop van Yucatán, Diego de Landa. De Landa probeerde in dit document ten onrechte de Maya-glyphen te vergelijken met het Spaanse alfabet:
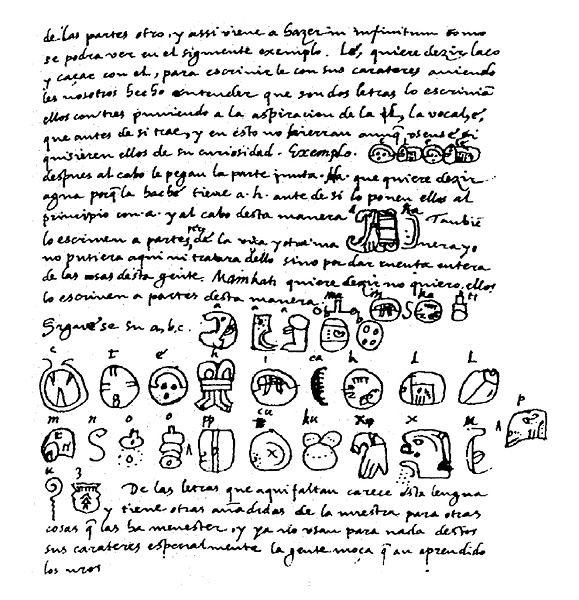
Ondanks deze foutieve benadering speelde het manuscript van De Landa een grote rol in het ontcijferen van het Maya-schrift. Het keerpunt vond plaats in de jaren 1950.
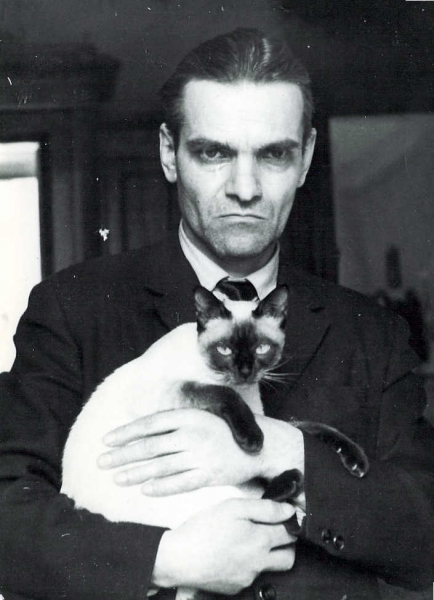
Yuri Knorozov, 19.11.1922 — 30.03.1999
Volgens een van de legendes vond het artillerie-corrector Yuri Knorozov in mei 1945 in de brandende ruïnes van Berlijn boeken die voorbereid waren voor evacuatie uit de Pruisische Staatsbibliotheek. Een van deze boeken bleek een zeldzame uitgave te zijn van drie bewaarde Maya-codices. Knorozov, die voor de oorlog geschiedenis had gestudeerd aan de faculteit geschiedenis van de universiteit van Charkov, raakte geïnteresseerd in deze manuscripten, voltooide na de oorlog de geschiedenisopleiding aan de MGU en begon met de ontcijfering van het Maya-schrift. Deze geschiedenis wordt beschreven door de Maya-expert Michael Coe, maar hoogstwaarschijnlijk heeft Knorozov, die het einde van de oorlog in een buitengebied van Moskou meemaakte, in een persoonlijk gesprek de feiten opgesmukt om zijn impressioneerde Amerikaanse collega te schokken.
Knorozov's belangrijkste interessegebied was de theorie van collectieven, en hij begon niet toevallig met het ontcijferen van het Maya-schrift, maar om zijn ideeën over de universele principes van informatie-uitwisseling in de praktijk te testen. 'Er is niets dat door één persoon is gedaan, dat niet door een ander begrepen kan worden.'
Hoe dan ook begreep Knorozov op basis van reprodukties van de drie Maya-codices en het manuscript van De Landa dat de tekens in het 'Verslag over de zaken in Yucatán' niet de letters maar de lettergrepen vertegenwoordigden.
De methode van Knorozov
Volgens de beschrijving van Knorozov's leerling, doctor in de geschiedenis G. Yershova, zag zijn methode eruit als volgt:
Eerste fase — het kiezen van een theoretische benadering: het vaststellen van de regels van overeenkomsten tussen de tekens en hun lezing in omstandigheden waarbij de taal ofwel onbekend ofwel sterk veranderd is.
Fase twee - een nauwkeurige fonetische lezing van de karakters, aangezien dit de enige manier is om onbekende woorden te lezen die bekende tekens bevatten.
Fase drie - het gebruik van de methodiek van positionele statistiek. Aan de hand van het aantal tekens en de frequentie van het gebruik van tekens kan het type schrift worden bepaald (ideografisch, morfemen, syllabisch, alfabetisch). Vervolgens wordt de frequentie van het gebruik en de posities waarin dit teken voorkomt geanalyseerd - zo worden de functies van de tekens bepaald. Deze gegevens worden vergeleken met materialen , wat het mogelijk maakt om afzonderlijke grammaticale, semantische referenten, wortel- en functionele morfemen te identificeren. Vervolgens wordt de lezing van de hoofdsamenstelling van de tekens vastgesteld.
Fase vier - het identificeren van de karakters die kunnen worden gelezen, met als sleutel de "Bericht over zaken in Yucatán". Knorosov merkte op dat het teken "cu" uit het manuscript van de Landa in de Maya-codices volgde na een ander teken en dat dit paar gerelateerd was aan de afbeelding van een kalkoen. "Kalkoen" in het Maya is "kutz" - en Knorosov redeneerde dat als "cu" het eerste teken was, het tweede "tzu" moest zijn (uitgaande van de aanname dat de laatste klinker wordt weggelaten). Om zijn model te testen, begon Knorosov in de codices naar een glif te zoeken die begon met het teken "tzu", en vond deze boven een afbeelding van een hond (tzul):
Details uit en codices
Fase vijf - kruisele reading op basis van bekende tekens.
Fase zes - bevestiging van de regel van singharmonie. Eén en hetzelfde teken kon zowel een lettergreep als een enkel geluid aanduiden. Het bleek dat de tekens voor afzonderlijke geluiden singharmonische morfemen moesten hebben.
Fase zeven - bewijs dat voor alle klinkerklanken in het Maya-schrift zelfstandige tekens bestonden, zoals weergegeven in het alfabet van de Landa.
Fase acht - formele analyse van de tekst. Knorosov stelde vast dat er in drie manuscripten 355 unieke tekens waren, maar door het gebruik van samengestelde grafemen en allografen werd dit aantal teruggebracht tot 287, terwijl feitelijk niet meer dan 255 leesbaar zijn - de overige zijn sterk vervormd of waren mogelijk variaties van bekende tekens.
Fase negen — frequentieanalyse van de tekst. Er werd de volgende regelmaat ontdekt: naarmate men verder gaat in de tekst, neemt het aantal nieuwe tekens af, maar het bereikt nooit nul. De tekens hadden verschillende absolute en relatieve frequenties: ongeveer een derde van alle tekens kwam voor in slechts één hiëroglief; ongeveer twee derde werd gebruikt in minder dan 50 hiërogliefen, maar enkele tekens kwamen zeer vaak voor.
Fase tien — vaststellen van de grammatische referenten, waarvoor het noodzakelijk was om de samenstelling van hiëroglieven te analyseren. J. Knorozov besteedde veel tijd aan het bepalen van de schrijvolgorde van afzonderlijke tekens in blokken. Op basis van hun positie in de regel verdeelde hij deze hiërogliefen in zes groepen. De analyse van hun combinaties met variabele tekens maakte het mogelijk om grammatische indicatoren vast te stellen — de belangrijkste en secundaire leden van de zin. Variabele tekens in de hiërogliefische blokken gaven affixen en functionele woorden aan. Daarna begon het werk met woordenboeken en de uitbreiding van het aantal leesbare tekens.
Erkenning van de methode van Knorozov
De syllabische benadering van Knorozov was in tegenspraak met de ideeën , die in de jaren '40 van de vorige eeuw een belangrijke bijdrage heeft geleverd aan de studie van Maya-teksten en als de meest gezaghebbende wetenschapper op dit gebied werd beschouwd. Thompson gebruikte de structurele methode: hij probeerde de volgorde en functie van Maya-gliefen te bepalen op basis van hun verspreiding in inscripties. Ondanks zijn successen ontkende Thompson categorisch de mogelijkheid dat het Maya-schrift fonetisch zou zijn en het gesproken taal zou kunnen vastleggen.
In de Sovjetunie in die jaren moest elk wetenschappelijk werk een onderbouwing bevatten vanuit het marxistisch-leninistisch perspectief, en op basis van deze nominale toevoeging beschuldigde Thompson Knorozov van het propaganderen van marxistische ideeën onder de Maya-wetenschappers. Een aanvullende aanleiding voor kritiek was de verklaring van programmeurs uit Novosibirsk, die aankondigden dat zij op basis van het werk van Knorozov een 'theorie van machine-decodering' van oude teksten hadden ontwikkeld en deze plechtig aan Chroesjtsjov presenteerden.
Ondanks de zware kritiek zijn ook westerse wetenschappers (Tatjana Proskurjakova, Floyd Lounsbery, Linda Schele, David Stewart) de fonetische theorie van Knorosov gaan bestuderen. Na de dood van Thomson in 1975 begon een massale ontcijfering van Maya-teksten.
Het schrift van de Maya's vandaag de dag
Net als elke schrijfsysteem werden de glyphen van de Maya's voor verschillende doeleinden gebruikt. Over het algemeen zijn het voornamelijk monumenten met de biografieën van heersers die tot ons zijn gekomen. Daarnaast zijn er vier : de 'Dresdense codex', de 'Parijse codex', de 'Madrid codex' en de 'Grolier codex', die pas in 1971 werd gevonden.
Ook vergaan boeken worden gevonden in Maya-graven, maar deze zijn tot nu toe niet ontcijferd, omdat de manuscripten aan elkaar zijn blijven plakken en door kalk zijn doordrenkt. Desondanks krijgen deze manuscripten met de ontwikkeling van scansystemen een . En als we in aanmerking nemen dat slechts 60% van de hiëroglyphen is ontcijferd, zal de Maya-studies ons zeker nog iets interessants schenken.
P.S. Nuttige materialen:
- Tabellen van syllabogrammen uit het boek van Harri Kettunen & Christophe Helmke (2014), Inleiding tot Maya-hiëroglyphen:


- Harri Kettunen & Christophe Helmke (2014), Inleiding tot Maya-hiëroglyphen, []
- Mark Pitts & Lynn Matson (2008), Schrijven in Maya-hiëroglyphen Namen, Plaatsen, & Eenvoudige Zinnen Een niet-technische inleiding, []

- – een database van Maya-hiëroglyphen in grafisch formaat
- met uitleg van de details van de scène, Peabody Museum of Archaeology and Ethnology, Harvard University.
Bron: habr.com
