

Met de Apache Cassandra-database en de noodzaak om deze te exploiteren binnen een infrastructuur gebaseerd op Kubernetes, komen we regelmatig in aanraking. In dit artikel delen we onze visie op de noodzakelijke stappen, criteria en bestaande oplossingen (inclusief een overzicht van operators) voor de migratie van Cassandra naar K8s.
«Wie een vrouw kan beheersen, kan ook met een staat omgaan»
Wie is Cassandra? Het is een gedistribueerd opslag systeem, ontworpen voor het beheren van grote hoeveelheden gegevens, terwijl het hoge beschikbaarheid biedt zonder een enkel punt van falen. Het project heeft waarschijnlijk niet veel introductie nodig, daarom geef ik alleen de belangrijkste functies van Cassandra die relevant zijn in het kader van dit artikel:
- Cassandra is geschreven in Java.
- De topologie van Cassandra omvat verschillende niveaus:
- Node — een enkele geïmplementeerde instantie van Cassandra;
- Rack — een groep Cassandra-instanties die op een bepaalde manier zijn gegroepeerd en zich in hetzelfde datacenter bevinden;
- Datacenter — de verzameling van alle groepen Cassandra-instanties binnen hetzelfde datacenter;
- Cluster — de verzameling van alle datacenters.
- Voor de identificatie van een Cassandra-knoop wordt het IP-adres gebruikt.
- Voor de snelheid van schrijf- en leesoperaties, slaat Cassandra een deel van de gegevens op in het werkgeheugen.
Laten we nu overgaan tot de mogelijke verhuizing naar Kubernetes.
Check-list voor de migratie
Bij de migratie van Cassandra naar Kubernetes hopen we dat het beheer na de verhuizing gemakkelijker zal worden. Wat is hiervoor nodig en wat kan hierbij helpen?
1. Opslag voor gegevens
Zoals al is aangegeven, slaat een deel van de gegevens van Cassandra op in het werkgeheugen — in de Memtable. Maar er is ook een ander deel van de gegevens dat op de schijf wordt opgeslagen, — in de vorm van SSTable. Bij deze gegevens voegt zich de entiteit Commit Log — registraties van alle transacties, die ook op de schijf worden opgeslagen.
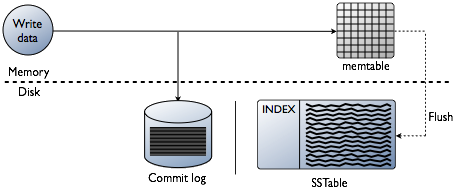
Schema van schrijftransacties in Cassandra
In Kubernetes kunnen we PersistentVolume gebruiken voor de opslag van gegevens. Dankzij de beproefde mechanismen wordt het werken met gegevens in Kubernetes elk jaar eenvoudiger.
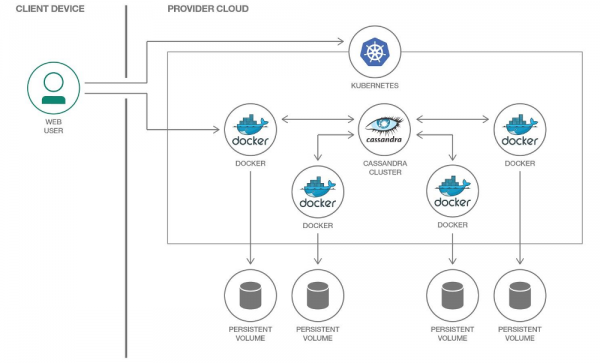
We zullen aan elke pod met Cassandra zijn eigen PersistentVolume toewijzen.
Het is belangrijk op te merken dat Cassandra op zichzelf gegevensreplicatie impliceert en hiervoor ingebouwde mechanismen biedt. Dus als je een Cassandra-cluster samenstelt uit een groot aantal knooppunten, is het niet nodig om gedistribueerde systemen zoals Ceph of GlusterFS voor gegevensopslag te gebruiken. In dit geval is het logisch om gegevens op de schijf van de knooppunt op te slaan met behulp van of mounten hostPath.
Een ander verhaal is als je voor elke feature-branch een aparte omgeving voor ontwikkelaars wilt creëren. In dat geval is de juiste aanpak om één Cassandra-knooppunt op te starten en de gegevens in een gedistribueerde opslag te bewaren, dat wil zeggen dat de eerder genoemde Ceph en GlusterFS jouw opties worden. Dan is de ontwikkelaar ervan verzekerd dat hij testgegevens niet verliest, zelfs niet bij het verlies van een knooppunt in het Kubernetes-cluster.
2. Monitoring
Bijna de enige keuze voor het implementeren van monitoring in Kubernetes is Prometheus (hierover hebben we uitgebreid gesproken in de ). Hoe staat Cassandra wat betreft metric exporters voor Prometheus? En wat nog belangrijker is, hoe zit het met geschikte dashboards voor Grafana?
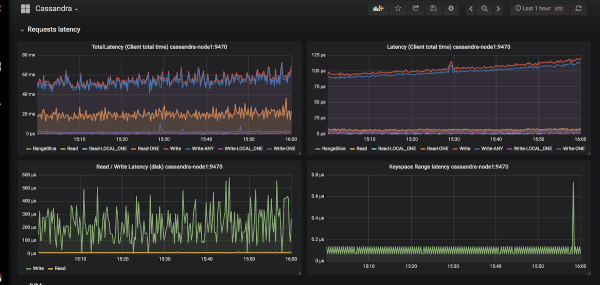
Voorbeeld van grafieken in Grafana voor Cassandra
Er zijn in totaal twee exporters: en .
Wij hebben voor de eerste gekozen omdat:
- JMX Exporter groeit en ontwikkelt zich, terwijl Cassandra Exporter niet de juiste steun van de gemeenschap heeft gekregen. Cassandra Exporter ondersteunt nog steeds niet de meeste versies van Cassandra.
- Je kunt het opstarten als javaagent door de vlag toe te voegen
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Er is een , dat niet compatibel is met Cassandra Exporter.
3. Keuze van Kubernetes-primitieven
Volgens de eerder beschreven structuur van het Cassandra-cluster, laten we proberen alles wat daar is beschreven om te zetten naar Kubernetes-terminologie:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → pool van StatefulSets
- Cassandra Cluster → ???
Het lijkt erop dat er een extra entiteit ontbreekt om het hele Cassandra-cluster tegelijkertijd te beheren. Maar als iets ontbreekt, kunnen we het creëren! In Kubernetes is er een mechanisme voor het definiëren van eigen resources — .
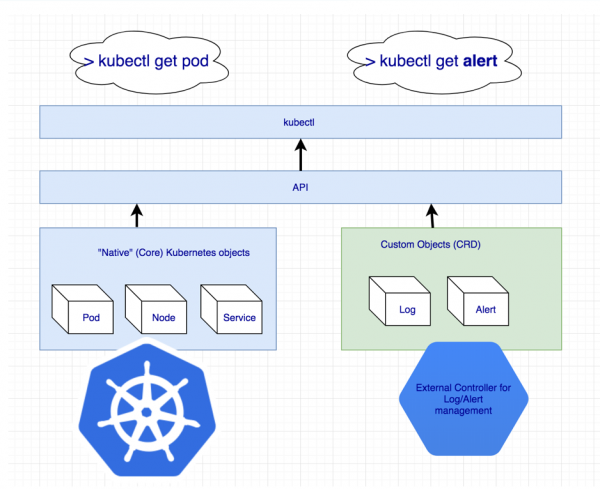
Declaratie van aanvullende resources voor logs en waarschuwingen
Maar een Custom Resource op zichzelf betekent niets: het heeft een controller. Je moet misschien de hulp inroepen van …
4. Identificatie van pods
In het bovenstaande punt hebben we afgesproken dat één Cassandra-knoop gelijkstaat aan één pod in Kubernetes. Maar de IP-adressen van pods zijn elke keer anders. Identificatie van een knoop in Cassandra gebeurt namelijk op basis van het IP-adres... Dit betekent dat na elke verwijdering van een pod het Cassandra-cluster een nieuwe knoop zal toevoegen.
Er is een oplossing, en zelfs meer dan één:
- We kunnen bijhouden op basis van host-ID's (UUID's, die de instanties van Cassandra uniek identificeren) of op basis van IP-adressen en dit alles opslaan in bepaalde structuren/tabellen. Het heeft twee belangrijke nadelen:
- Het risico van een raceconditie als twee knopen tegelijk uitvallen. Na herstart zullen de Cassandra-knopen tegelijkertijd een IP-adres uit de tabel aanvragen en concurreren voor dezelfde bron.
- Als een Cassandra-knoop zijn gegevens verliest, kunnen we deze niet langer identificeren.
- De tweede oplossing lijkt een kleine hack, maar desondanks: we kunnen een Service met ClusterIP voor elke Cassandra-knoop maken. Problemen met deze implementatie:
- Als er erg veel knopen in het Cassandra-cluster zijn, moeten we erg veel Services creëren.
- De ClusterIP-functionaliteit wordt gerealiseerd via iptables. Dit kan een probleem zijn als er veel (1000… of zelfs 100?) knopen in het Cassandra-cluster zijn. Echter, kan dit probleem oplossen.
- De derde oplossing is om het netwerkknooppuntstructuur voor Cassandra-knopen te gebruiken in plaats van een apart pod-netwerk, door de instelling in te schakelen
hostNetwork: true. Deze methode heeft bepaalde beperkingen:- Voor het vervangen van knopen. De nieuwe knoop moet verplicht hetzelfde IP-adres hebben als de vorige (dit is bijna onmogelijk in cloudomgevingen zoals AWS, GCP);
- Door het gebruik van het cluster-netwerk beginnen we te concurreren om netwerkbronnen. Daarom zal het problematisch zijn om meer dan één Cassandra-pod op een cluster-knoop te plaatsen.
5. Back-ups
We willen een complete versie van de gegevens van één Cassandra-knoop op een schema bewaren. Kubernetes biedt een handige mogelijkheid met behulp van , maar hier knelt het schoentje vanwege Cassandra zelf.
Ter herinnering, sommige gegevens in Cassandra worden in het geheugen opgeslagen. Om een volledige back-up te maken, moeten de gegevens uit het geheugen (Memtables) naar de schijf (SSTables) worden verplaatst. Op dat moment stopt de Cassandra-knoop met het accepteren van verbindingen, waardoor deze volledig uit het cluster wordt verwijderd.
Daarna wordt er een back-up gemaakt (snapshot) en wordt het schema opgeslagen (keyspace). En hier blijkt dat een eenvoudige backup ons niet helpt: we moeten de identiteiten van de gegevens behouden waarvoor de Cassandra-knooppunten verantwoordelijk zijn - dat zijn speciale tokens.
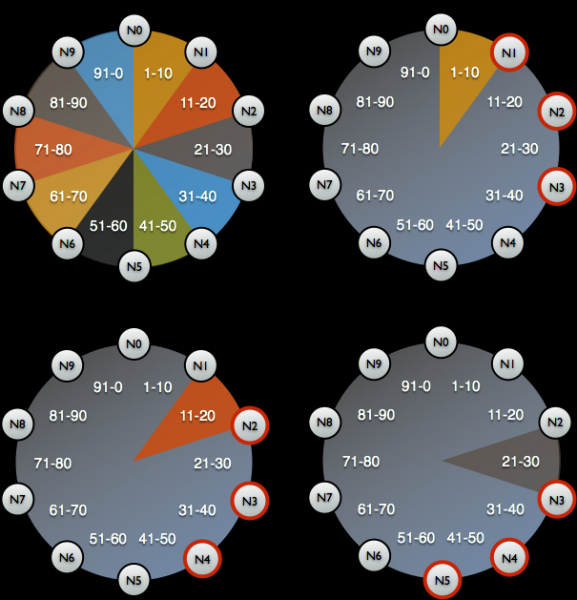
De verdeling van tokens om te identificeren voor welke gegevens de Cassandra-knooppunten verantwoordelijk zijn
Een voorbeeldscript voor het maken van een backup van Cassandra van Google in Kubernetes is te vinden op . Het enige punt dat het script niet in overweging neemt, is het resetten van de gegevens op de knoop voordat de snapshot wordt genomen. Dat betekent dat de backup niet wordt uitgevoerd voor de huidige toestand, maar voor een iets eerdere toestand. Maar dit helpt om de knoop niet uit de werking te halen, wat logisch lijkt.
set -eu

if [[ -z "$1" ]]; then
  info "Geef alstublieft een keyspace op"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Fout bij het maken van snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk 'snapshot directory: { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Voorbeeld van een bash-script voor het maken van een backup van één Cassandra-knoop
Kant-en-klare oplossingen voor Cassandra in Kubernetes
Wat gebruiken mensen momenteel voor het opzetten van Cassandra in Kubernetes en wat past het beste bij de opgegeven vereisten?
1. Oplossingen op basis van StatefulSets of Helm-charts
Het gebruik van de basisfunctionaliteiten van StatefulSets voor het starten van een Cassandra-cluster is een goede optie. Met behulp van een Helm-chart en Go-sjablonen kan een flexibele interface voor de gebruiker worden geboden voor het opzetten van Cassandra.
Over het algemeen werkt dit goed… totdat er iets onverwachts gebeurt - bijvoorbeeld het uitvallen van een knoop. De standaard Kubernetes-tools kunnen simpelweg niet alle bovengenoemde bijzonderheden in overweging nemen. Bovendien is deze benadering zeer beperkt in hoe ze kan worden uitgebreid voor complexer gebruik: vervanging van knopen, back-ups, herstel, monitoring, enz.
Leveranciers:
- ;
- .
Beide charts zijn even goed, maar ondervinden dezelfde problemen zoals hierboven beschreven.
2. Oplossingen op basis van Kubernetes Operator
Deze opties zijn interessanter omdat ze uitgebreide mogelijkheden voor clusterbeheer bieden. Voor het ontwerpen van een Cassandra-operator, zoals bij elke andere database, is een goed patroon als volgt: Sidecar Controller CRD:
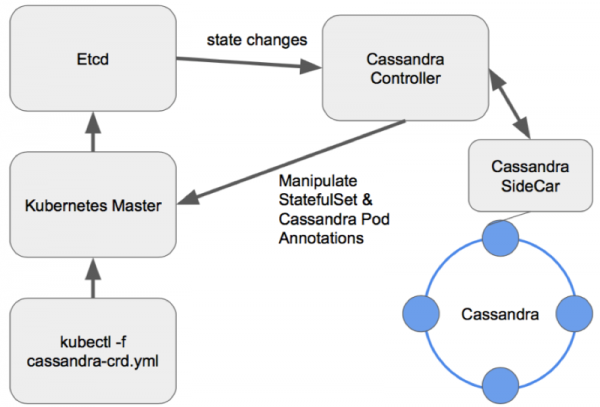
Schema voor het beheer van knopen in een goed ontworpen Cassandra-operator
Laten we bestaande operators bekijken.
1. Cassandra-operator van instaclustr
- Status: Alpha
- Licentie: Apache 2.0
- Gebouwd in: Java
Dit is echt een veelbelovend en actief ontwikkelend project van een bedrijf dat beheerde Cassandra-implementaties aanbiedt. Het maakt, zoals hierboven beschreven, gebruik van een sidecar-container die commando's via HTTP ontvangt. Het is geschreven in Java, dus het mist soms meer geavanceerde functies van de client-go bibliotheek. Ook ondersteunt de operator geen verschillende racks voor één datacenter.
Aan de andere kant heeft de operator voordelen zoals ondersteuning voor monitoring, hoog-niveau clusterbeheer via CRD en zelfs documentatie over het maken van back-ups.
2. Navigator van Jetstack
- Status: Alpha
- Licentie: Apache 2.0
- Gebouwd in: Golang
Een operator bedoeld voor de implementatie van DB-as-a-Service. Momenteel ondersteunt het twee databases: Elasticsearch en Cassandra. Het heeft interessante oplossingen, zoals toegangscontrole tot de database via RBAC (hiervoor wordt een aparte navigator-apiserver opgezet). Een interessant project dat het waard is om te bekijken, maar de laatste commit was anderhalf jaar geleden, wat zijn potentieel duidelijk vermindert.
3. Cassandra-operator van vgkowski
- Status: Alpha
- Licentie: Apache 2.0
- Gebouwd in: Golang
We hebben besloten het niet ‘serieus’ te nemen, aangezien de laatste commit in de repository meer dan een jaar geleden was. De ontwikkeling van de operator is verlaten: de laatste versie van Kubernetes die als ondersteund werd aangegeven, is 1.9.
4. Cassandra-operator van Rook
- Status: Alpha
- Licentie: Apache 2.0
- Gebouwd in: Golang
Een operator waarvan de ontwikkeling niet zo snel gaat als we zouden willen. Het heeft een doordachte CRD-structuur voor clusterbeheer, lost het probleem van knooppuntidentificatie op met behulp van een Service met ClusterIP (de ‘hack’)… maar dat is het tot nu toe. Monitoring en back-ups zijn momenteel niet ingebouwd (overigens, voor monitoring hebben we ). Een interessant punt is dat met deze operator ook ScyllaDB kan worden geïmplementeerd.
NB: We hebben deze operator met enkele aanpassingen gebruikt in een van onze projecten. Gedurende de hele exploitatieperiode (~4 maanden) zijn er geen problemen opgemerkt met de werking van de operator.
5. CassKop van Orange
- Status: Alpha
- Licentie: Apache 2.0
- Gebouwd in: Golang
De jongste operator op de lijst: de eerste commit werd gedaan op 23 mei 2019. Nu al heeft hij een groot aantal functies uit onze lijst in zijn arsenaal, waar je meer over kunt lezen in de projectrepository. De operator is gebouwd op de populaire operator-sdk. Ondersteunt monitoring "uit de doos". Het belangrijkste onderscheid met andere operators is het gebruik van , geïmplementeerd in Python en gebruikt voor communicatie tussen de Cassandra-nodes.
Conclusies
Het aantal benaderingen en mogelijke opties voor het migreren van Cassandra naar Kubernetes spreekt voor zich: het onderwerp is gewild.
Op dit moment kun je met de bovenstaande mogelijkheden experimenteren op eigen risico: geen enkele ontwikkelaar garandeert 100% werking van hun oplossing in een productieomgeving. Maar veel producten zien er al veelbelovend uit om te proberen ze te gebruiken in ontwikkelomgevingen.
Ik denk dat deze vrouw aan boord in de toekomst van pas zal komen!
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
