

Ik ben er zeker van dat de titel een gezonde reactie oproept - "oh, daar gaan we weer..." Maar laat me je aandacht pakken voor 5-10 minuten, en ik zal proberen je verwachtingen niet te bedriegen.
De structuur van het artikel zal als volgt zijn: een stereotype bewering wordt gepresenteerd en de "natuur" van deze stereotype wordt blootgelegd. Ik hoop dat dit helpt om de keuze voor de datatransmissieparadigma in jouw projecten vanuit een nieuw perspectief te bekijken.
Om duidelijkheid te krijgen over wat RPC is, stel ik voor om de standaard te beschouwen . Met REST is er geen duidelijkheid. En dat zou er ook niet moeten zijn. Alles wat je moet weten over REST - het is niet te onderscheiden van .
RPC-aanvragen zijn sneller en efficiënter, omdat ze batch-verzoeken mogelijk maken.
Het idee is dat je met RPC in één verzoek meerdere procedures tegelijk kunt aanroepen. Bijvoorbeeld, een gebruiker aanmaken, een avatar toevoegen en hem in hetzelfde verzoek op bepaalde onderwerpen abonneren. Slechts één verzoek, maar zo veel voordeel!
Inderdaad, als je slechts één backend-knooppunt hebt, lijkt het sneller te zijn met een batch-aanroep. Omdat drie REST-aanvragen drie keer zoveel middelen van één knooppunt vereisen voor het opzetten van verbindingen.
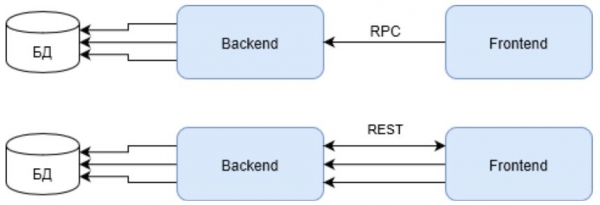
Let op dat de eerste aanvraag in het geval van REST een gebruikersidentificatie moet retourneren om de volgende aanvragen uit te kunnen voeren. Dit heeft ook een negatieve invloed op het algemene resultaat.
Maar zulke infrastructuren zijn hooguit te vinden in in-house oplossingen of Enterprise. In het slechtste geval in kleine WEB-projecten. Maar volledige WEB-oplossingen, die dan nog HighLoad worden genoemd, moeten niet zo worden opgebouwd. Hun infrastructuur moet voldoen aan de criteria van hoge beschikbaarheid en belasting. En het beeld verandert.
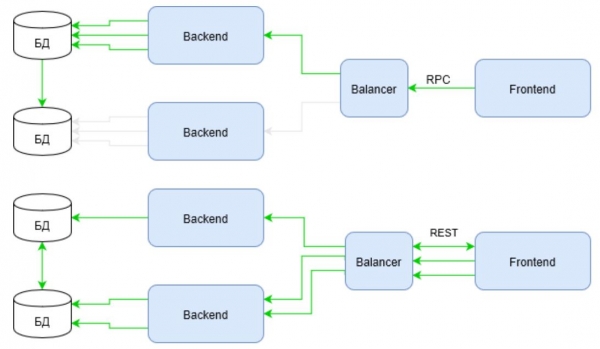
De groene kanalen zijn gemarkeerd, die de activiteit van de infrastructuur bij hetzelfde scenario aangeven. Let op hoe RPC zich nu gedraagt. Het verzoek maakt gebruik van de infrastructuur slechts op één schouder van de load balancer naar de backend. Terwijl REST nog steeds verliest bij het eerste verzoek, maar het gemis inhaalt door de hele infrastructuur te benutten.
Als we in het scenario niet twee verzoeken voor verrijking, maar laten we zeggen vijf of tien invoeren... dan wordt het antwoord op de vraag "wie wint er nu?" niet zo duidelijk.
Laten we het probleem nog breder bekijken. Op de diagram is te zien hoe de infrastructuurkanalen worden gebruikt, maar de infrastructuur beperkt zich niet tot kanalen. Een belangrijke component van een hoogbelaste infrastructuur zijn caches. Laten we nu een gebruikersartefact verkrijgen. Meerdere keren. Laten we zeggen 32 keer.
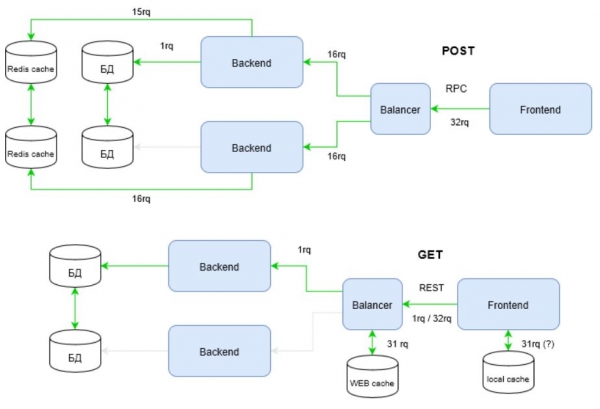
Kijk eens hoe de infrastructuur voor RPC aanzienlijk is verbeterd om te voldoen aan de eisen van hoge belasting. Het komt omdat REST de volledige kracht van het HTTP-protocol benut in tegenstelling tot RPC. In de gegeven diagram wordt deze kracht geïmplementeerd via de aanroepmethode — GET.
HTTP-methoden hebben, naast andere dingen, cachingstrategieën. U kunt zich daarmee bekendmaken in de documentatie op . Voor RPC worden POST-aanvragen gebruikt, die niet als idempotent worden beschouwd, dat wil zeggen, het herhaaldelijk versturen van dezelfde POST-aanvragen kan verschillende resultaten opleveren (bijvoorbeeld, na elke verzending van een commentaar zal er een nieuwe kopie van dat commentaar verschijnen) ().
Daarom kan RPC de infrastructuurcaches niet effectief benutten. Dit leidt ertoe dat 'softwarematige' caches moeten worden ingevoerd. In de diagram wordt Redis hiervoor geïntroduceerd. Een softwarematige cache vereist op zijn beurt extra code van de ontwikkelaar en aanzienlijke wijzigingen in de architectuur.
Laten we nu eens rekenen hoeveel aanvragen REST en RPC hebben 'gecreëerd' in de onderzochte infrastructuur?
Queries
Inbox
naar backend
naar de databaseserver
naar de softwarecache (Redis)
TOTAAL
REST
1/32*
1
1
0
3 / 35
RPC
32
32
1
31
96
[*] in het beste geval (als de lokale cache wordt gebruikt) 1 aanvraag (één!), in het slechtste geval 32 binnenkomende aanvragen.
In vergelijking met het eerste diagram is het verschil verbazingwekkend. Het wordt nu duidelijk wat de winst van REST is. Maar laten we niet stoppen bij wat we hebben bereikt. Een geavanceerde infrastructuur omvat een CDN. Vaak lost dit ook het probleem van DDoS- en DoS-aanvallen op. Laten we krijgen:
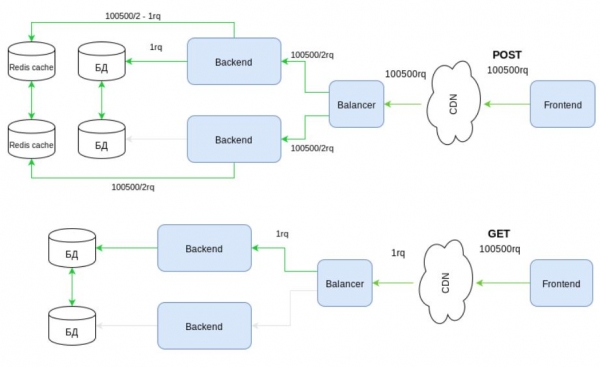
Voor RPC wordt het hier echt somber. RPC is gewoon niet in staat om het werk met de belasting van een CDN te delegeren. We kunnen alleen maar hopen op aanvallenbestrijdingssystemen.
Kunnen we hierop eindigen? En opnieuw, nee. De HTTP-methoden, zoals eerder vermeld, hebben hun eigen 'magie'. Het is geen toeval dat de GET-methode zo vaak wordt gebruikt op het internet. Let op dat deze methode in staat is om naar delen van content te verwijzen en voorwaarden kan stellen die infrastructuurelementen kunnen interpreteren nog voordat de controle aan jouw code wordt overgedragen, enzovoort. Dit alles maakt het mogelijk om flexibele, beheersbare infrastructuren te creëren die in staat zijn om echt grote hoeveelheden verzoeken te verwerken. En in RPC wordt deze methode... genegeerd.
Waarom bestaat de mythe dat batch-verzoeken (RPC) sneller zijn zo hardnekkig? Persoonlijk denk ik dat de meeste projecten nooit het ontwikkelingsniveau bereiken waarop REST zijn kracht kan tonen. Sterker nog, in kleine projecten toont het eerder zijn zwakte.
De keuze tussen REST of RPC is geen willekeurige beslissing van een individu binnen het project. Deze keuze moet voldoen aan de eisen van het project. Als het project in staat is om alles uit REST te halen wat het daadwerkelijk kan en dat nodig is, dan is REST een uitstekende keuze.
Maar als het nodig is om devops in het project in te huren om infrastructuur snel op te schalen, beheerders voor het beheer van de infrastructuur, en een architect voor het ontwerpen van alle lagen van de webservice... terwijl het project slechts drie pakken margarine per dag verkoopt... dan zou ik kiezen voor RPC, omdat dit protocol utilitairer is. Het vereist geen diepgaande kennis van cache-werking en infrastructuur, en concentreert de ontwikkelaar op eenvoudige en begrijpelijke aanroepen van de benodigde procedures. Het bedrijf zal tevreden zijn.
RPC-verzoeken zijn betrouwbaarder omdat ze batch-verzoeken binnen één transactie kunnen uitvoeren.
Deze eigenschap van RPC is een onmiskenbaar voordeel, omdat het gemakkelijk is om de database in een consistente staat te houden. Met REST is dit echter moeilijker. Verzoeken kunnen ongelijkmatig op verschillende backend-nodes binnenkomen.
Dit 'nadeel' van REST is de keerzijde van zijn hierboven beschreven voordeel — de mogelijkheid om efficiënt gebruik te maken van alle infrastructuurmiddelen. Als de infrastructuur slecht is ontworpen, en vooral als de architectuur van het project en de database in het bijzonder slecht is ontworpen, dan is dat echt een groot probleem.
Maar zijn batchverzoeken zo betrouwbaar als ze lijken? Laten we een case bekijken: we creëren een gebruiker, verrijken zijn profiel met een beschrijving en sturen hem een SMS met een geheim om de registratie te voltooien. Dit betekent drie aanroepen in één batchverzoek.
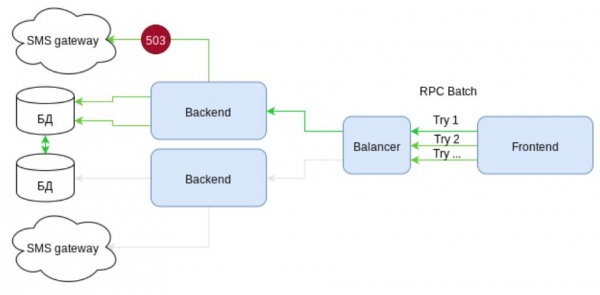
Laten we het schema bekijken. Hierop is de infrastructuur weergegeven met elementen van hoge beschikbaarheid. Er zijn twee onafhankelijke communicaties met SMS-gateways. Maar ... wat zien we? Bij het verzenden van een SMS treedt een fout 503 op - de service is tijdelijk niet beschikbaar. Aangezien het verzenden van SMS is verpakt in een batchverzoek, moet het hele verzoek worden teruggedraaid. Acties in de database worden ongeldig gemaakt. De klant krijgt een foutmelding.
De volgende poging is een loterij. Ofwel komt het verzoek opnieuw op dezelfde node terecht en geeft het opnieuw een foutmelding, of we hebben geluk en het wordt uitgevoerd. Maar het belangrijkste is dat onze infrastructuur in ieder geval al een keer zinloos heeft gewerkt. Er was belasting, maar geen winst.
Laten we aannemen dat we ons hebben ingespannen (!) en een optie hebben bedacht waarbij het verzoek gedeeltelijk succesvol kan worden uitgevoerd. En de rest proberen we opnieuw uit te voeren na een bepaald tijdsinterval (welk? Dat bepaalt de front-end). Maar de loterij blijft bestaan. Het verzoek om SMS te verzenden met een kans van 50/50 zal opnieuw mislukken.
Geeft u toe, vanuit het perspectief van de klant lijkt de service niet zo betrouwbaar als gewenst ... wat is er met REST?
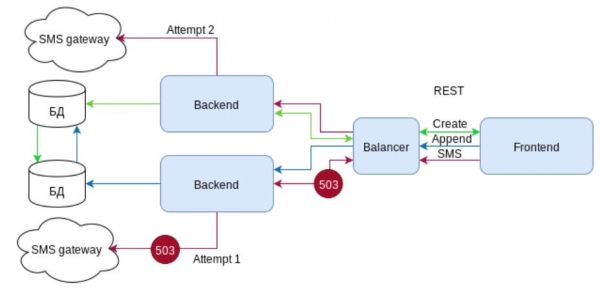
REST gebruikt opnieuw de "magie" van HTTP, maar nu met response-codes. Bij een fout 503 op de SMS-gateway vertaalt de backend deze fout naar de load-balancer. De load-balancer ontvangt deze fout en breekt de verbinding met de klant niet, en stuurt het verzoek naar een andere node die het verzoek succesvol verwerkt. Dit betekent dat de klant het verwachte resultaat krijgt en de infrastructuur zijn hoge status van "hoog beschikbare" bevestigt. De gebruiker is gelukkig.
En dat is nog niet alles. De load-balancer heeft niet alleen de response-code 503 ontvangen. Deze code moet volgens de standaard idealiter worden geleverd met de header "Retry-After". Deze header laat de load-balancer weten dat deze node niet moet worden belast via deze route gedurende een bepaalde tijd. En de volgende verzoeken om SMS te verzenden worden direct naar de node gestuurd die geen problemen heeft met de SMS-gateway.
Zoals we zien, is de betrouwbaarheid van JSON-RPC overschat. Inderdaad, het is gemakkelijker om consistentie in de database te organiseren. Maar in dat geval wordt de betrouwbaarheid van het systeem als geheel het slachtoffer.
De output is in veel opzichten vergelijkbaar met de vorige. Wanneer de infrastructuur eenvoudig is, is de duidelijkheid van JSON-RPC zeker een voordeel. Als een project hoge beschikbaarheid met een hoge belasting vereist, lijkt REST een betere, zij het complexere oplossing.
De instapdrempel voor REST is lager.
Ik denk dat de bovenstaande analyse, waarin gevestigde stereotypes over RPC worden ontkracht, duidelijk heeft aangetoond dat de instapdrempel voor REST zeker hoger is dan voor RPC. Dit heeft te maken met de noodzaak van een diepgaand begrip van hoe HTTP werkt, evenals met de noodzaak om voldoende kennis te hebben van de bestaande infrastructuurelementen die in webprojecten kunnen en moeten worden toegepast.
Maar waarom denken veel mensen dat REST gemakkelijker is? Persoonlijk vind ik dat deze schijnbare eenvoud voortkomt uit de manifesten van REST. Dat wil zeggen, REST is geen protocol, maar een concept… REST heeft geen standaard, er zijn enkele richtlijnen… REST is niet moeilijker dan HTTP. De schijnbare vrijheid en anarchie trekken 'vrije kunstenaars' aan.
Zeker, REST is niet moeilijker dan HTTP. Maar HTTP zelf is een goed doordacht protocol dat zijn waarde al tientallen jaren heeft bewezen. Als er geen diepgaand begrip van HTTP is, dan kan er ook niet over REST geoordeeld worden.
Maar over RPC kan dat wel. Het is voldoende om de specificatie ervan te bekijken. Heeft u dan ? Или все же хитрый REST? Решать вам.
Ik hoop van harte dat ik uw tijd niet tevergeefs heb verspild.
Bron: habr.com
