

Industrieel softwareontwikkeling vereist veel aandacht voor de foutbestendigheid van het eindproduct, evenals een snelle reactie op uitval en storingen, wanneer deze zich voordoen. Monitoring helpt uiteraard om sneller en efficiënter te reageren op uitval en storingen, maar is niet voldoende. Ten eerste is het zeer moeilijk om het overzicht te behouden over een groot aantal servers - er zijn veel mensen voor nodig. Ten tweede moet men goed begrijpen hoe de toepassing is opgebouwd om de toestand ervan te kunnen voorspellen. Dit betekent dat er veel mensen nodig zijn die de systemen die we ontwikkelen goed begrijpen, inclusief hun prestatie-indicatoren en kenmerken. Stel je voor dat, zelfs als je een voldoende aantal mensen vindt die hierin geïnteresseerd zijn, je ook nog veel tijd nodig hebt om ze op te leiden.
Wat te doen? Hier komt kunstmatige intelligentie ons te hulp. Dit artikel gaat over (predictive maintenance). Deze aanpak wint snel aan populariteit. Er zijn talloze artikelen over geschreven, ook op Habré. Grote bedrijven maken volop gebruik van deze aanpak om de werking van hun servers te ondersteunen. Na het bestuderen van een groot aantal artikelen hebben we besloten om deze benadering zelf te proberen. Wat hebben we hiervan geleerd?
Inleiding
Een ontwikkeld softwaresysteem komt vroeg of laat in gebruik. Het is belangrijk voor de gebruiker dat het systeem zonder storingen functioneert. Als er toch een uitzonderlijke situatie optreedt, moet deze worden opgelost met minimale vertraging.
Om de technische ondersteuning van een softwaresysteem te vereenvoudigen, vooral als er veel servers zijn, worden meestal monitoringprogramma's gebruikt die metrics verzamelen van het draaiende softwaresysteem, die de toestand ervan diagnosticeren en helpen bepalen wat precies de storing heeft veroorzaakt. Dit proces wordt monitoring van het softwaresysteem genoemd.
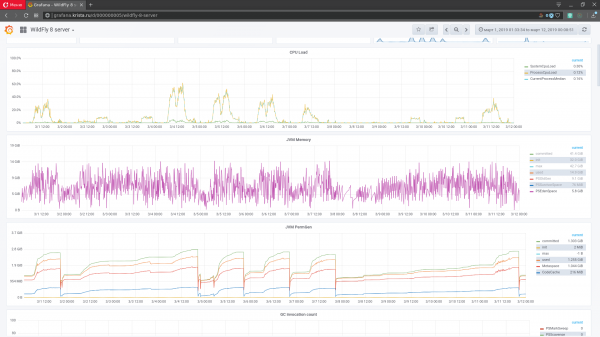
Figuur 1. Interface voor grafana-monitoring
Metingen zijn verschillende indicatoren van het softwaresysteem, de omgeving waarin het draait of de fysieke rekeneenheid waarop het systeem met een tijdstempel is gestart, het moment waarop de metingen zijn verkregen. In de statische analyse worden de gegevens van de metingen tijdreeksen genoemd. Voor het observeren van de toestand van het softwaresysteem worden de metingen weergegeven in de vorm van grafieken: op de X-as staat de tijd en op de Y-as staan de waarden (figuur 1). Van een operationeel softwaresysteem kunnen duizenden metingen worden gedaan (van elke node). Zij vormen de ruimte van metingen (multidimensionale tijdreeksen).
Aangezien er bij complexe softwaresystemen een groot aantal metingen wordt gedaan, wordt handmatige monitoring een complexe taak. Om de hoeveelheid gegevens die door de beheerder wordt geanalyseerd te verkleinen, bevatten de monitoringtools hulpmiddelen voor het automatisch identificeren van mogelijke problemen. Bijvoorbeeld, je kunt een trigger instellen die afgaat wanneer de beschikbare schijfruimte onder een bepaalde drempel daalt. Ook kan je automatisch een serverstop of een kritische vertraging van de service-snelheid diagnosticeren. In de praktijk slagen monitoringtools er redelijk goed in om reeds opgetreden storingen te detecteren of eenvoudige symptomen van toekomstige storingen te identificeren, maar over het algemeen blijft het voorspellen van mogelijke storingen een lastige uitdaging. Voorspelling door middel van handmatige analyse van metingen vereist de betrokkenheid van gekwalificeerde specialisten. Het is weinig productief. De meeste potentiële storingen blijven mogelijk onopgemerkt.
De laatste tijd wint onder grote IT-bedrijven die software ontwikkelen het zogenaamde voorspellende onderhoud van softwaresystemen steeds meer aan populariteit. De essentie van deze aanpak is het vroegtijdig opsporen van problemen die leiden tot systeemdegradatie, nog voordat het systeem uitvalt, met behulp van kunstmatige intelligentie. Deze aanpak sluit handmatige monitoring van het systeem niet volledig uit. Het dient als een aanvulling op het monitoringproces in het algemeen.
Het belangrijkste hulpmiddel voor het implementeren van voorspellend onderhoud is de taak van anomaliedetectie in tijdreeksen, omdat bij het optreden van een anomalie in de gegevens de kans groot is dat er na enige tijd er kan een fout of storing optreden. Een anomalie is een afwijking in de prestatie-indicatoren van een softwaresysteem, zoals het vaststellen van een verslechtering van de snelheid van verzoeken van een bepaald type of een daling van het gemiddelde aantal behandelde aanvragen bij een constant niveau van klantensessies.
De taak van het opsporen van anomalieën in software systemen heeft zijn eigen specifieke kenmerken. In feite is voor elke software systeem de ontwikkeling of aanpassing van bestaande methoden vereist, omdat het opsporen van anomalieën sterk afhankelijk is van de gegevens waarin het plaatsvindt, en de gegevens van softwaresystemen sterk variëren afhankelijk van de implementatietools, tot het punt dat het afhangt van welke computer het draait.
Methoden voor het opsporen van anomalieën bij het voorspellen van storingen in softwaresystemen
Allereerst moet worden opgemerkt dat het idee van het voorspellen van storingen geïnspireerd is door het artikel . Voor de beoordeling van de effectiviteit van de aanpak met automatische anomaliedetectie is de softwaresysteem "Web-Consolidatie" gekozen, dat een van de projecten is van het bedrijf NPO "Krista". Voor dit systeem werd eerder handmatige monitoring uitgevoerd op basis van de verkregen metrics. Aangezien het systeem vrij complex is, worden er veel metrics verzameld: JVM-indicatoren (belasting van de garbage collector), indicatoren van het besturingssysteem waaronder de code draait (virtueel geheugen, % belasting van de CPU), netwerkindicatoren (netwerkbelasting), serverindicatoren (CPU-belasting, geheugen), wildfly-metrics en eigen metrics van de applicatie over alle kritische subsysteem.
Alle metrics worden uit het systeem verzameld met behulp van graphite. Aanvankelijk werd de whisper database gebruikt als standaardoplossing voor grafana, maar met de groei van het klantenbestand kon graphite de belasting niet meer aan, waardoor de capaciteit van het opslagonderdeel in datacentra was uitgeput. Na dit werd besloten om een effectievere oplossing te zoeken. De keuze viel op , wat het mogelijk maakte om de belasting van het opslagonderdeel met een orde van grootte te verminderen en de benodigde schijfruimte met vijf tot zes keer te verkleinen. Hieronder wordt het schema van de verzameling van metrics gepresenteerd met behulp van graphite+clickhouse (afbeelding 2).
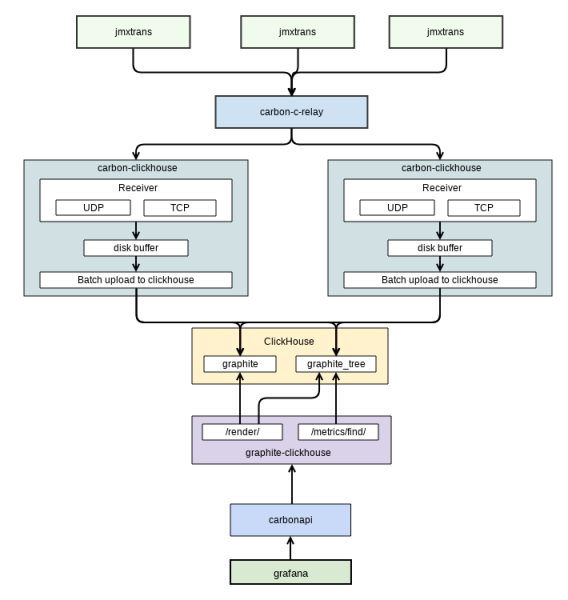
Afbeelding 2. Schema van metricverzameling
Het schema is afkomstig uit de interne documentatie. Hierop wordt de gegevensuitwisseling tussen grafana (de gebruikersinterface voor monitoring die we gebruiken) en graphite weergegeven. Het verzamelen van metrics van de applicatie gebeurt door aparte software – . Deze software slaat ze ook op in graphite.
Het systeem ‘Web-Consolidatie’ heeft een aantal kenmerken die problemen creëren bij het voorspellen van storingen:
- er vaak een trendwisseling plaatsvindt. Voor dit softwaresysteem komen er verschillende versies uit. Elke versie brengt wijzigingen in de softwarecomponent van het systeem. Hierdoor beïnvloeden de ontwikkelaars direct de metrics van dit systeem en kunnen ze een trendwisseling veroorzaken;
- het type implementatie, evenals de gebruiksdoelen van klanten met dit systeem, roepen vaak anomalieën op zonder voorafgaande degradatie;
- het percentage anomalieën ten opzichte van de volledige dataset is laag (< 5%);
- er kunnen onderbrekingen optreden bij het verkrijgen van gegevens van het systeem. In sommige korte tijdsintervallen lukt het het monitoringsysteem niet om metrics te verkrijgen. Bijvoorbeeld, als de server overbelast is. Voor de training van het neurale netwerk is dit cruciaal. Er ontstaat de noodzaak om gaten synthetisch op te vullen;
- Gevallen van anomalieën zijn vaak alleen relevant voor een specifieke datum/maand/tijd (seizoensgebondenheid). Dit systeem heeft duidelijke richtlijnen voor gebruik door zijn gebruikers. Daarom zijn de metrics alleen relevant voor specifieke tijdsperioden. Het systeem kan niet voortdurend worden gebruikt, maar alleen in bepaalde maanden: selectief afhankelijk van het jaar. Er zijn situaties waarin hetzelfde gedrag van metrics in het ene geval kan leiden tot de storing van het softwaresysteem, maar in het andere geval niet.
Allereerst werden de methoden voor het opsporen van anomalieën in de monitoringgegevens van softwaresystemen geanalyseerd. In artikelen over dit onderwerp wordt vaak aanbevolen om bij lage percentages anomalieën ten opzichte van de rest van de dataset gebruik te maken van neurale netwerken.
De belangrijkste logica voor het opsporen van anomalieën met behulp van gegevens van neurale netwerken is weergegeven in Figuur 3:
Figuur 3. Opsporing van anomalieën met behulp van een neurale netwerk
Bij het resultaat van de voorspelling of het herstelvenster van de huidige metrische stroom wordt de afwijking berekend ten opzichte van de waarden die zijn verkregen met het operationele software systeem. Bij een grote discrepantie tussen de verkregen metrics van het softwaresysteem en het neuraal netwerk kan men concluderen dat het huidige segment van de data anomalieën vertoont. Hieruit ontstaan een aantal problemen bij het gebruik van neurale netwerken:
- voor een correcte werking in streamingmodus moeten de data voor het trainen van neurale netwerken uitsluitend «normale» gegevens bevatten;
- er moet een actuele model zijn voor correcte detectie. Wijzigingen in trends en seizoenspatronen in de metrics kunnen een groot aantal valse positieven veroorzaken. Voor de update van het model moet duidelijk worden vastgesteld wanneer het model verouderd is. Als het model te laat of te vroeg wordt bijgewerkt, zullen er waarschijnlijk veel valse positieven volgen.
Daarnaast mag men niet vergeten te zoeken naar en te voorkomen dat valse positieven vaak optreden. Er wordt aangenomen dat ze vooral in uitzonderlijke situaties zullen optreden. Ze kunnen echter ook het gevolg zijn van een fout in het neuraal netwerk vanwege onvoldoende training. Het is noodzakelijk om het aantal valse positieven van het model te minimaliseren. Anders zullen valse voorspellingen veel tijd van de beheerder kosten die bedoeld is voor systeemcontrole. Op een gegeven moment zal de beheerder simpelweg stoppen met reageren op het 'paranoïde' monitoringsysteem.
Recurrent neuraal netwerk
Voor het detecteren van anomalieën in tijdreeksen kan men toepassen met LSTM-geheugen. Het probleem is alleen dat het alleen kan worden toegepast op voorspelbare tijdreeksen. In ons geval zijn niet alle metrics voorspelbaar. Een poging om RNN LSTM voor een tijdreeks toe te passen wordt weergegeven in figuur 4.
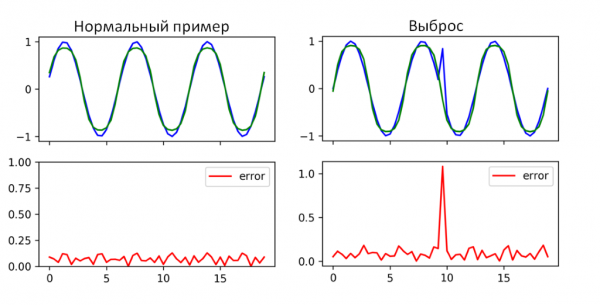
Figuur 4. Voorbeeld van de werking van een recurrent neuraal netwerk met LSTM-geheugencellen
Zoals te zien is in figuur 4, was het RNN LSTM in staat om anomalieën op dit tijdstip te detecteren. Op plaatsen waar de voorspelfout hoog is (gemiddelde fout), vond er inderdaad een anomalie in de meetgegevens plaats. Het gebruik van slechts één RNN LSTM zal duidelijk niet voldoende zijn, omdat het toepasbaar is op een beperkt aantal metrics. Het kan als een aanvullende methode voor het zoeken naar anomalieën worden gebruikt.
Auto-encoder voor het voorspellen van storingen
is in wezen een kunstmatig neuraal netwerk. De invoerlaag is de encoder, de uitvoerlaag is de decoder. Een nadeel van alle neurale netwerken van dit type is dat ze moeilijk anomalieën kunnen lokaliseren. De architectuur van de synchrone auto-encoder is gekozen.
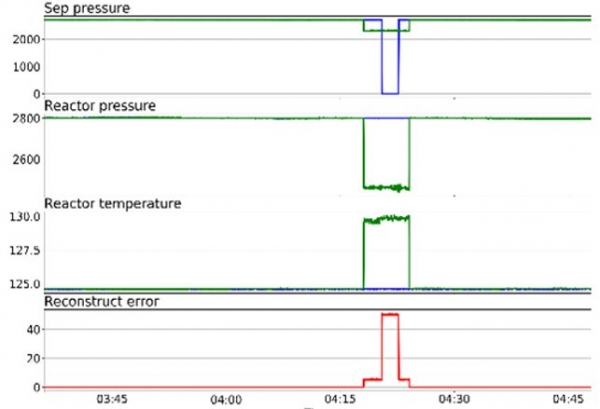
Figuur 5. Voorbeeld van de werking van een auto-encoder
Auto-encoders worden getraind op normale gegevens en vinden vervolgens iets anomaals in de gegevens die aan het model worden aangeboden. Dit is precies wat nodig is voor deze taak. Het enige dat resteert is om te kiezen welke auto-encoder geschikt is voor deze taak. De architectonisch eenvoudigste vorm van een auto-encoder is een directe, feedforward neurale netwerk, dat erg lijkt op (multilayer perceptron, MLP), met een invoerniveau, een uitvoerniveau en een of meerdere verborgen lagen die ze verbinden.
Het verschil tussen auto-encoders en MLP's is echter dat in een auto-encoder het uitvoerniveau hetzelfde aantal knooppunten heeft als de invoerlaag, en dat in plaats van te trainen op het voorspellen van de doelwaarde Y, gegeven invoer X, de auto-encoder leert om zijn eigen X te reconstrueren. Daarom zijn auto-encoders onbewaakte leermodellen.
De taak van de auto-encoder is het vinden van de tijdsindexen r0 … rn, die overeenkomen met anomale elementen in de invoervector X. Dit effect wordt bereikt door het zoeken naar de kwadratische fout.
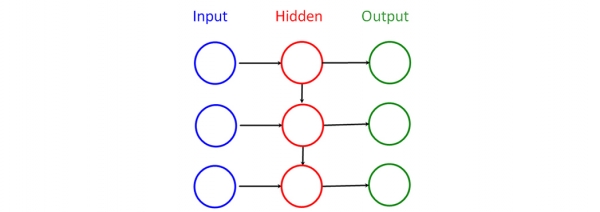
Figuur 6. Synchrone auto-encoder
Voor de auto-encoder is de keuze gevallen op de . De voordelen hiervan zijn: de mogelijkheid om streamverwerking te gebruiken en een relatief lager aantal parameters van het neuraal netwerk in vergelijking met andere architecturen.
Mechanisme om vals alarm te minimaliseren
Gezien het feit dat er verschillende uitzonderlijke situaties kunnen optreden en er mogelijk sprake is van onvoldoende training van het neurale netwerk, is besloten om een mechanisme voor het minimaliseren van valse positieven te ontwikkelen voor het model voor anomaliedetectie dat wordt ontwikkeld. Dit mechanisme is gebaseerd op een sjabloonbasis die door de beheerder wordt geclassificeerd.
(DTW-algoritme, van het Engels dynamic time warping) maakt het mogelijk om de optimale overeenkomst tussen tijdreeksen te vinden. Het werd voor het eerst toegepast in spraakherkenning: het werd gebruikt om te bepalen hoe twee spraakgeluiden dezelfde oorspronkelijke uitgesproken zin vertegenwoordigen. Later werd het ook toegepast in andere gebieden.
Het belangrijkste principe van het minimaliseren van valse positieven is het verzamelen van een database van referenties door een operator die verdachte gevallen klassificeert die door neurale netwerken zijn ontdekt. Vervolgens vindt er een vergelijking plaats van de geclassificeerde referentie met het geval dat door het systeem is gedetecteerd, en wordt er een conclusie getrokken over de classificatie van het geval als valse of als storingsveroorzakende. Het DTW-algoritme wordt specifiek gebruikt voor het vergelijken van twee tijdreeksen. De belangrijkste tool voor minimalisatie is echter classificatie. Het wordt verondersteld dat na het verzamelen van een groot aantal referentieve gevallen, het systeem minder vragen aan de operator zal stellen vanwege de overeenkomst in de meeste gevallen en het optreden van soortgelijke gevallen.
Als resultaat is op basis van de hierboven beschreven methoden van neurale netwerken een experimenteel programma opgezet voor het voorspellen van systeemfouten in de "Web-Consolidatie". Het doel van dit programma was om, met behulp van het bestaande archief van monitoringgegevens en informatie over reeds opgetreden storingen, de competentie van deze aanpak voor onze softwaresystemen te evalueren. Het schema van het programma is hieronder weergegeven in Figuur 7.
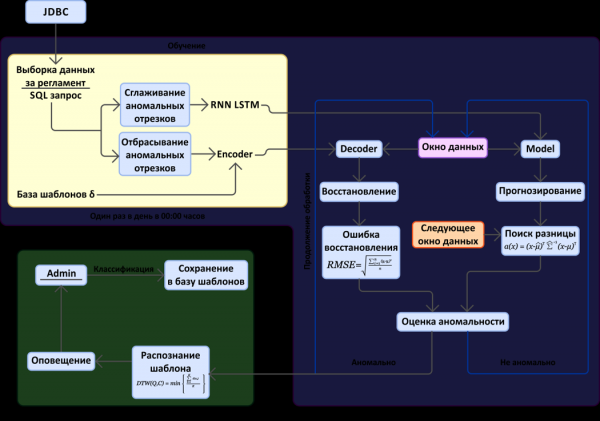
Figuur 7. Schema voor het voorspellen van systeemfouten op basis van analyse van de metrische ruimte
In het schema zijn er twee belangrijke blokken te onderscheiden: het zoeken naar anomale tijdssegmenten in de gegevensstroom van monitoring (metriek) en het mechanisme voor het minimaliseren van valse positieven. Opmerking: voor experimentele doeleinden worden de gegevens verkregen via een JDBC-verbinding vanuit de database waarin ze door graphite worden opgeslagen.
Hier is de interface van het ontwikkelde monitoringsysteem (figuur 8).
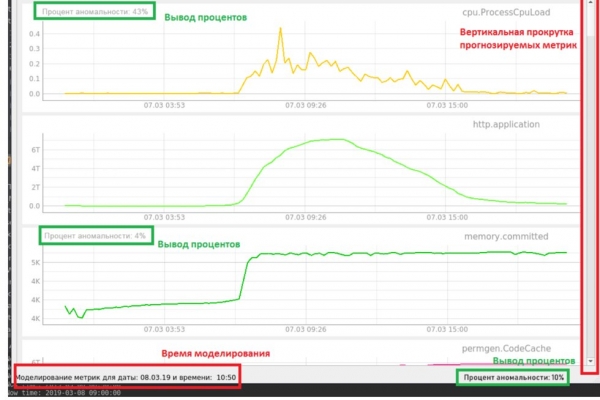
Figuur 8. Interface van het experimentele monitoringsysteem
Op de interface wordt het percentage anomalie weergegeven op basis van de ontvangen metrics. In ons geval wordt de verwerking gemodelleerd. We hebben al data verzameld over enkele weken en laden deze geleidelijk in om een geval van anomalie te controleren dat leidt tot een storing. In de onderste statusbalk wordt het totale percentage anomalie van de gegevens op dat moment weergegeven, dat wordt bepaald met behulp van een auto-encoder. Voor de voorspelde metrics wordt ook een apart percentage weergegeven, berekend door de RNN LSTM.
Voorbeeld van anomaliedetectie op basis van CPU-statistieken met behulp van een RNN LSTM-neuraal netwerk (figuur 9).
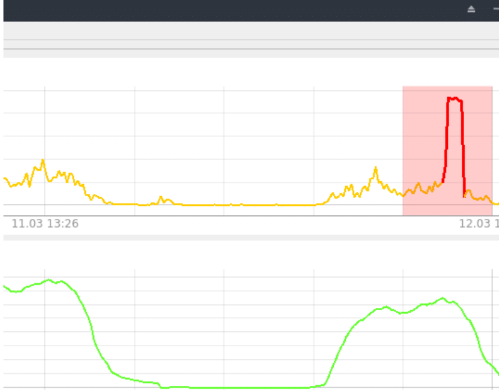
Figuur 9. Detectie met RNN LSTM
Een vrij eenvoudig geval, in wezen een gewone uitschieter, maar leidend tot een systeemstoring, werd met succes gedetecteerd met behulp van de RNN LSTM. Het anomaliepercentage in deze tijdsperiode bedraagt 85 – 95%, alles boven de 80% (de drempel is experimenteel vastgesteld) wordt als anomalie beschouwd.
Voorbeeld van anomaliedetectie wanneer het systeem niet kon opstarten na een update. Deze situatie wordt gedetecteerd door de auto-encoder (figuur 10).
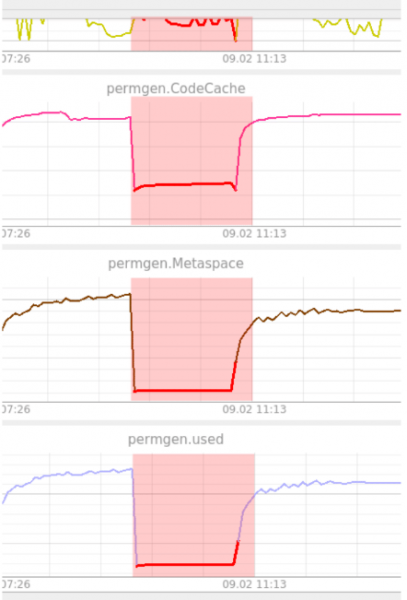
Figuur 10. Voorbeeld van detectie door de auto-encoder
Zoals te zien is in de afbeelding, bleef PermGen op een niveau hangen. De auto-encoder vond dit vreemd, omdat hij eerder niets dergelijks had gezien. Hier blijft de anomalie 100% tot het systeem weer operationeel is. Anomalie wordt weergegeven bij alle metrics. Zoals eerder vermeld, kan de auto-encoder anomalieën niet lokaliseren. De operator is verantwoordelijk voor het uitvoeren van deze functie in deze situaties.
Conclusie
De PC 'Web-Consolidatie' wordt al meerdere jaren ontwikkeld. Het systeem verkeert in een vrij stabiele staat, en het aantal geregistreerde incidenten is laag. Niettemin is het gelukt anomalieën te vinden die leiden tot een storing 5 – 10 minuten voordat de storing zich voordoet. In sommige gevallen zou tijdige waarschuwing over de storing helpen om het geplande tijdsbestek, dat gereserveerd is voor uit te voeren 'herstelwerkzaamheden', te besparen.
Op basis van de experimenten die zijn uitgevoerd, is het nog te vroeg om definitieve conclusies te trekken. Momenteel zijn de resultaten tegenstrijdig. Enerzijds is het duidelijk dat algoritmen op basis van neurale netwerken in staat zijn om 'nuttige' anomalieën te vinden. Aan de andere kant blijft er een groot percentage valse positieven, en niet alle anomalieën die door een gekwalificeerde specialist worden geïdentificeerd, kunnen door het neurale netwerk worden ontdekt. Een nadeel is dat het neurale netwerk momenteel training met een leraar vereist voor een normale werking.
Voor de verdere ontwikkeling van het foutvoorspellingssysteem en om het naar een acceptabel niveau te brengen, kunnen verschillende paden worden overwogen. Dit omvat een grondigere analyse van gevallen met anomalieën die leiden tot uitval, door de aanvulling van een lijst met belangrijke metrics die een grote invloed hebben op de staat van het systeem, en het uitsluiten van irrelevante metrics. Daarnaast, als we deze richting op gaan, kunnen pogingen worden ondernomen om de algoritmen specifiek te specialiseren voor onze gevallen met anomalieën die tot uitval leiden. Er is ook een andere weg. Dit is de verbetering van de architecturen van neurale netwerken en daardoor de verhoging van de detectietrouw terwijl de trainingstijd wordt verkort.
Ik wil mijn dank uitspreken aan de collega's die me hebben geholpen met het schrijven en het actueel houden van dit artikel: en Sergey Finogenov.
Bron: habr.com
