

Vermoedelijk heeft tegenwoordig niemand meer de vraag waarom het nodig is om metrics van services te verzamelen. De volgende logische stap is om alerting in te stellen op de verzamelde metrics, die je waarschuwt voor afwijkingen in de gegevens via de kanalen die jij het meest handig vindt (e-mail, Slack, Telegram). In de online boekingsservice voor hotels worden alle metrics van onze services doorgestuurd naar InfluxDB en weergegeven in Grafana, waar ook de basisalerting is ingesteld. Voor taken zoals 'we moeten iets berekenen en dit vergelijken' gebruiken we Kapacitor.
Kapacitor is een onderdeel van de TICK-stack, die metrics uit InfluxDB kan verwerken. Het kan meerdere metingen met elkaar verbinden (join), iets nuttigs berekenen uit de verkregen gegevens, het resultaat terugschrijven naar InfluxDB en een alert verzenden naar Slack/Twitter/e-mail.
De hele stack heeft een fantastische en gedetailleerde , maar er zijn altijd nuttige dingen die niet expliciet in de handleidingen worden vermeld. In dit artikel heb ik een aantal van zulke nuttige, niet voor de hand liggende tips verzameld (de basis syntax van TICKscript is beschreven ) en laten zien hoe je ze kunt toepassen aan de hand van een van onze taken.
Laten we beginnen!
float & int, rekenfouten
Een heel standaard probleem dat kan worden opgelost door te casten:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Gebruik van default()
Als de tag/het veld niet is ingevuld, zullen er rekenfouten optreden:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill in join (inner vs outer)
Standaard negeert join punten waar geen gegevens zijn (inner).
Bij fill('null') zal een outer join worden uitgevoerd, waarna default() moet worden uitgevoerd om lege waarden in te vullen:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Er is echter een nuance. Als in het bovenstaande voorbeeld een van de reeksen (res1 of res2) leeg is, zal de uiteindelijke reeks (data) ook leeg zijn. Over dit onderwerp zijn er verschillende tickets op GitHub (, , ) – we wachten op fixes en lijden een beetje.
Gebruik van voorwaarden in berekeningen (if in lambda)
|eval(lambda: if("value" > 0, true, false)
De laatste vijf minuten uit de pipeline over een periode
Bijvoorbeeld, je moet de waarden van de laatste vijf minuten vergelijken met die van de vorige week. Je kunt twee batches gegevens nemen met afzonderlijke batchverwerkingen of een deel van de gegevens uit een groter tijdsbestek halen:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Een alternatief voor de laatste vijf minuten kan het gebruik van de BarrierNode zijn, die de gegevens eerder afsnijdt dan de opgegeven tijd:
|barrier()
        .period(5m)
Voorbeelden van het gebruik van Go-sjablonen in berichten
De sjablonen komen overeen met het formaat van het pakket , hieronder enkele veelvoorkomende taken.
if-else
We houden het overzichtelijk en triggeren mensen niet onnodig met tekst:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Het is nu oké{{ else }}Hoofd, alles is kapot{{end}}'
    )
Twee decimalen na de komma in het bericht
We verbeteren de leesbaarheid van het bericht:
|alert()
    ...
    .message(
        'nu is de waarde {{ index .Fields "value" | printf "%0.2f" }}'
    )
Variabelen uitpakken in het bericht
We geven meer informatie in het bericht om de vraag 'Waarom schreeuwt hij?' te beantwoorden.
var warnAlert = 10
  |alert()
    ...
    .message(
       'Vandaag is de waarde minder dan '+string(warnAlert)+'%'
    )
Uniek identificatienummer van het alarm
Een handige eigenschap wanneer er meer dan één groep in de gegevens is, anders wordt er slechts één alarm gegenereerd:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Aangepaste handlers
In de lange lijst met handlers is er een exec, die het mogelijk maakt je eigen script met doorgegeven parameters (stdin) uit te voeren – puur creativiteit!
Een van onze custom scripts is een klein Python-script voor het verzenden van meldingen naar Slack.
Eerst wilden we een afbeelding van Grafana, beveiligd met autorisatie, in het bericht verzenden. Daarna - 'OK' schrijven in de thread van het vorige alarm uit dezelfde groep, in plaats van een apart bericht. Nog iets later - de meest voorkomende fout van de afgelopen X minuten in het bericht opnemen.
Een apart onderwerp is de verbinding met andere diensten en acties die door het alarm zijn geïnitieerd (alleen als je monitoring goed genoeg werkt).
Voorbeeld van de beschrijving van de handler, waar slack_handler.py ons zelfgemaakte script is:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Hoe te debuggen?
Optie met loguitvoer
|log()
      .level("error")
      .prefix("something")
Bekijk (cli): kapacitor -url :9092 logs lvl=error
Optie met httpOut
Toont gegevens in de huidige pipeline:
|httpOut('something')
Bekijk (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Schema van uitvoering
- Elke taak retourneert een uitvoeringsboom met nuttige cijfers in het formaat .
- We nemen een blok .
- Invoegen in de viewer, .
Waar anders kun je timestamp in influxdb krijgen bij terugschrijven?
timestamp in influxdb bij terugschrijven
Bijvoorbeeld, we configureren een alert op het aantal verzoeken per uur (groupBy(1h)) en willen de gegenereerde alert in influxdb vastleggen (om het probleem mooi weer te geven op een grafiek in grafana).
influxDBOut() schrijft de tijdwaarde van de alert naar timestamp, waardoor het punt op de grafiek eerder/later wordt vastgelegd dan wanneer de alert is ontvangen.
Wanneer nauwkeurigheid vereist is: we omzeilen dit probleem door een aangepaste handler aan te roepen die gegevens met de huidige timestamp in influxdb schrijft.
docker, build en deploy
Bij het opstarten kan kapacitor taken, sjablonen en handlers laden vanuit de directory die in de configuratie is opgegeven in het blok [load].
Voor het correct aanmaken van een taak zijn de volgende dingen nodig:
- Bestandsnaam – wordt omgezet in id/naam van het script
- Type – stream/batch
- dbrp – sleutelwoord voor het aangeven in welke database + beleid het script werkt (dbrp "supplier"."autogen")
Als er in een batch-taak geen regel met dbrp is, weigert de hele service te starten en meldt dit eerlijk in de log.
In chronograf daarentegen mag deze regel niet aanwezig zijn, omdat deze via de interface niet wordt geaccepteerd en een foutmelding geeft.
Hack bij het bouwen van de container: Dockerfile gaat naar -1 als er regels met //.+dbrp zijn, wat het meteen mogelijk maakt om de oorzaak van de buildfail te begrijpen.
join één-op-veel
Voorbeeldtaak: we moeten de 95e percentiel van de servicetijd van de week nemen en elke minuut van de laatste 10 vergeleken met deze waarde.
Het is niet mogelijk om één-op-veel te joinen, last/mean/median per groep punten verandert de node in stream, er zal een foutmelding verschijnen "cannot add child mismatched edges: batch -> stream".
Het resultaat van de batch, als variabele in de lambda-expressie, wordt ook niet ingevuld.
Er is een optie om de benodigde cijfers uit de eerste batch in een bestand via udf op te slaan en dit bestand via sideload te laden.
Wat hebben we hiermee opgelost?
We hebben ongeveer 100 hotel leveranciers, elk kan meerdere verbindingen hebben, laten we dit kanalen noemen. Er zijn ongeveer 300 van deze kanalen, waarvan elk kan afbreken. Van alle vastgelegde metrics zullen we de foutpercentage (requests en errors) monitoren.
Waarom geen grafana?
Alerts voor fouten die in grafana zijn ingesteld, hebben verschillende nadelen. Sommige zijn kritisch, terwijl andere wellicht genegeerd kunnen worden, afhankelijk van de situatie.
Grafana kan geen berekeningen tussen metingen uitvoeren + alerting, terwijl we de rate (requests-errors)/requests nodig hebben.
Fouten zien er boos uit:
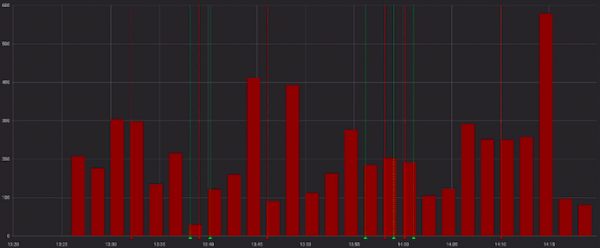
En minder boos, als je kijkt naar de succesvolle verzoeken:
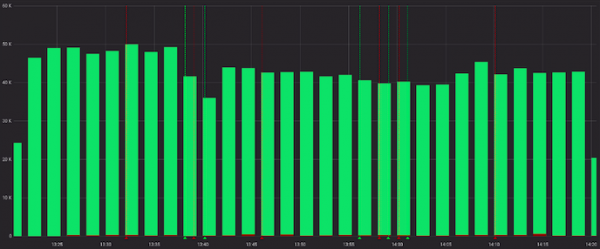
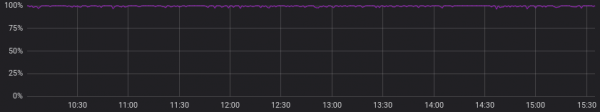
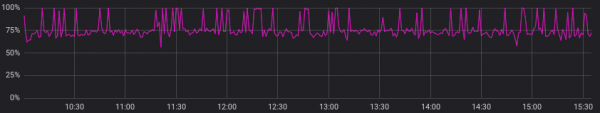
Oké, we kunnen de snelheid in de service tot Grafana vooraf berekenen, en in sommige gevallen kan dat passen. Maar niet bij ons, aangezien voor elk kanaal een eigen verhouding als 'normaal' wordt beschouwd, en de alerts werken op statische waarden (we zoeken met de ogen, veranderen als het vaak alert geeft).
Dit zijn voorbeelden van 'normaal' voor verschillende kanalen:
Neem de vorige punt niet in overweging en laten we aannemen dat bij alle leveranciers de 'normale' situatie vergelijkbaar is. Nu is alles goed, kunnen we ons redden met alerts in Grafana?
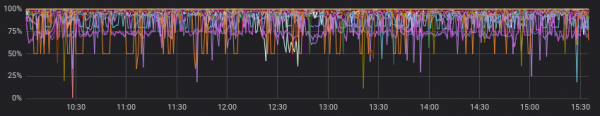
Ja, maar dat willen we heel graag vermijden, omdat we een van de opties moeten kiezen:
a) vele grafieken maken voor elk kanaal apart (en die moeizaam onderhouden)
b) één grafiek met alle kanalen laten staan (en verdwalen in kleurrijke lijnen en ingestelde alerts)
Hoe hebben we dit gedaan?
Wederom, de documentatie heeft een goed startvoorbeeld (), we kunnen daar een blik op werpen of het als basis gebruiken voor soortgelijke taken.
Wat hebben we uiteindelijk gedaan:
- twee reeksen samenvoegen in enkele uren, groeperen op kanalen;
- reeksen vullen per groepen, als er geen gegevens waren;
- we vergelijken de mediaan van de laatste 10 minuten met eerdere gegevens;
- we roepen het uit als we iets ontdekken;
- we schrijven de berekende snelheden en opgetreden alerts in InfluxDB;
- we sturen een nuttig bericht naar Slack.
Het lijkt mij dat we alles wat we op het resultaat wilden krijgen (en zelfs iets meer met de aangepaste handlers) zo mooi mogelijk hebben gerealiseerd.
Op github.com kun je kijken en van het verkregen script.
Voorbeeld van de uiteindelijke code:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8u
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // vul null waarden in als ze er niet zijn
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // als in lambda: bereken de rate, alleen als er fouten waren
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// schrijf de berekende waarden naar Influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// selecteer gegevens van de laatste 10 minuten, bereken de mediaan
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // verzamel in message de link naar het grafiekdashboard
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Het is nu oké{{ else }}
' + string(todayPeriod) + ' mediaan is {{ index .Fields "today.median" | printf "%0.2f" }}%, ten opzichte van de vorige ' + string(period) + ' is {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/' + string(grafana_dash) +
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId=' + string(grafana_panel) + '&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }} / {{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" dupliceren als "value", en schrijf ook de andere alert velden naar Influx
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
En wat is de output?
Kapacitor is uitstekend in staat om monitoring-alertering uit te voeren met talloze groeperingen, extra berekeningen te maken op reeds opgeslagen metrics, aangepaste acties uit te voeren en scripts (udf) te starten.
De instapdrempel is niet erg hoog - probeer het als Grafana of andere tools niet helemaal aan je wensen voldoen.
Bron: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish