

Opmerking vertaler.: Dit artikel, geschreven door Galo Navarro, die de functie van Principal Software Engineer vervult bij het Europese bedrijf Adevinta, is een boeiende en leerzame 'onderzoek' op het gebied van infrastructuurbeheer. De oorspronkelijke titel is in de vertaling iets aangepast om een reden die de auteur in het begin uitlegt.
Opmerking van de auteur: Het lijkt erop dat deze publicatie veel meer dan verwacht. Ik ontvang nog steeds woedende reacties over hoe de titel van het artikel misleidend is en dat sommige lezers teleurgesteld zijn. Ik begrijp de redenen voor wat er gaande is, en hoewel het risico bestaat de hele spanning te doorbreken, wil ik meteen vertellen waar dit artikel over gaat. Bij de overgang van teams naar Kubernetes zie ik een interessant fenomeen: telkens wanneer er een probleem optreedt (bijvoorbeeld een toename van latentie na migratie), wordt Kubernetes als eerste beschuldigd, maar later blijkt dat de orchestrator in feite niet de schuldige is. Dit artikel vertelt over zo'n geval. De titel herhaalt de uitroep van een van onze ontwikkelaars (je zult zien dat Kubernetes er helemaal niets mee te maken heeft). Je zult geen onverwachte onthullingen over Kubernetes vinden, maar je kunt rekenen op een paar goede lessen over complexe systemen.
Een paar weken geleden was mijn team bezig met het migreren van een microservice naar het hoofdsysteem, dat CI/CD, een op Kubernetes gebaseerde werkomgeving, metrics en andere nuttige tools omvatte. De verhuizing was van proefkarakter: we waren van plan deze als basis te nemen en de komende maanden nog ongeveer 150 services over te dragen. Al deze services zijn verantwoordelijk voor de werking van enkele van de grootste online platforms in Spanje (Infojobs, Fotocasa, enz.).
Nadat we de applicatie in Kubernetes hadden uitgerold en een deel van het verkeer naar hen hadden omgeleid, wachtte ons een verontrustende verrassing. De latentie (latency) van aanvragen in Kubernetes was 10 keer hoger dan in EC2. Over het geheel genomen moesten we ofwel een oplossing voor dit probleem vinden, ofwel de migratie van de microservice (en misschien wel het hele project) opgeven.
Waarom is de latentie in Kubernetes zoveel hoger dan in EC2?
Om de knelpunt te vinden, verzamelden we metrics langs de hele aanvraagroute. Onze architectuur is eenvoudig: de API-gateway (Zuul) proxy't aanvragen naar exemplaren van de microservice in EC2 of Kubernetes. In Kubernetes gebruiken we de NGINX Ingress Controller, en de backends zijn gewone objecten van het type met een JVM-applicatie op het Spring-platform.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Het leek erop dat het probleem samenhing met vertraging in de initiële fase van de backend (ik heb het probleemgebied op de grafiek gemarkeerd als «xx»). In EC2 bedroeg de respons van de applicatie ongeveer 20 ms. In Kubernetes steeg de vertraging tot 100—200 ms.
We hebben snel de mogelijke verdachten die verband houden met de verandering van het uitvoeringsmilieu uitgesloten. De JVM-versie bleef hetzelfde. Containerisatieproblemen waren ook niet de oorzaak: de applicatie werkte al succesvol in containers in EC2. Was het de belasting? Maar we zagen hoge vertragingen zelfs bij 1 verzoek per seconde. Pauzes voor het verzamelen van ongebruikte data konden ook worden genegeerd.
Een van onze Kubernetes-beheerders vroeg zich af of de applicatie externe afhankelijkheden had, aangezien eerdere keren verzoeken naar DNS soortgelijke problemen veroorzaakten.
Hypothese 1: naamresolutie DNS
Bij elk verzoek vraagt onze applicatie één tot drie keer naar een AWS Elasticsearch-instantie in een domein zoals elastic.spain.adevinta.com. Binnen de containers hebben we , dus we kunnen controleren of het zoeken naar het domein lang duurt.
DNS-verzoeken vanuit de container:
[root@be-851c76f696-alf8z "]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Vergelijkbare verzoeken vanuit een van de EC2-instanties waar de applicatie draait:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Gegeven dat het zoeken ongeveer 30 ms duurt, werd duidelijk dat de DNS-resolutie bij het aanroepen van Elasticsearch bijdraagt aan de toenemende vertraging.
Het was echter om twee redenen vreemd:
- We hebben al verschillende applicaties in Kubernetes die communiceren met AWS-resources, zonder grote vertragingen te ondervinden. Wat de reden ook is, het heeft specifiek te maken met deze situatie.
- We weten dat de JVM in-memory DNS-caching uitvoert. In onze afbeeldingen is de TTL-waarde vastgelegd in
$JAVA_HOME/jre/lib/security/java.securityen is ingesteld op 10 seconden:networkaddress.cache.ttl = 10. Met andere woorden, de JVM zou alle DNS-verzoeken 10 seconden moeten cachen.
Om de eerste hypothese te bevestigen, besloten we tijdelijk afstand te nemen van DNS-aanroepen en te bekijken of het probleem verdwenen zou zijn. Eerst hebben we de applicatie opnieuw ingesteld, zodat deze rechtstreeks met Elasticsearch communiceerde via het IP-adres, in plaats van via de domeinnaam. Dit zou codewijzigingen en opnieuw implementeren vereisen, dus we hebben eenvoudigweg het domein gekoppeld aan zijn IP-adres in /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comNu ontving de container het IP bijna onmiddellijk. Dit leidde tot enige verbetering, maar we kwamen slechts iets dichterbij het verwachte niveau van vertraging. Hoewel DNS-resolutie veel tijd kostte, ontsnapte de werkelijke oorzaak nog steeds aan ons.
Diagnostiek via het netwerk
We besloten het verkeer vanuit de container te analyseren met behulp van tcpdump, om te volgen wat er precies in het netwerk gebeurt:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Daarna hebben we een aantal verzoeken verzonden en ze gevangen (kubectl cp my-service:/capture.pcap capture.pcap) voor verdere analyse in .
In de DNS-verzoeken was niets verdachts (behalve één klein ding dat ik later zal bespreken). Maar er waren bepaalde vreemde zaken in de manier waarop onze service elk verzoek behandelde. Hieronder staat een screenshot van de capture, die het ontvangen verzoek laat zien voordat er een antwoord kwam:
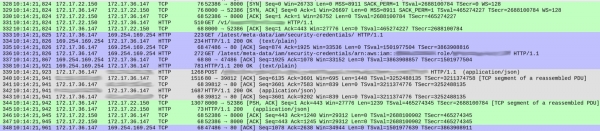
De pakketnummers staan in de eerste kolom. Voor de duidelijkheid heb ik verschillende TCP-stromen gekleurd.
De groene stroom, beginnend met pakket 328, laat zien hoe de client (172.17.22.150) een TCP-verbinding met de container (172.17.36.147) heeft opgezet. Na de initiële handdruk (328-330) bracht pakket 331 HTTP GET /v1/.. — het inkomende verzoek aan onze service. Dit proces duurde 1 ms.
De grijze stroom (vanaf pakket 339) toont aan dat onze service een HTTP-verzoek heeft verzonden naar de Elasticsearch-instantie (TCP-handdruk ontbreekt omdat er al een bestaande verbinding wordt gebruikt). Dit kostte 18 ms.
Tot nu toe is alles in orde en komen de tijden ongeveer overeen met de verwachte vertragingen (20-30 ms volgens metingen vanuit de client).
Echter, het blauwe gedeelte duurt 86 ms. Wat gebeurt daar? Met pakket 333 heeft onze service een HTTP GET-verzoek gestuurd naar /latest/meta-data/iam/security-credentials, en direct daarna, via dezelfde TCP-verbinding, nog een GET-verzoek naar /latest/meta-data/iam/security-credentials/arn:...
We hebben ontdekt dat dit zich herhaalt bij elk verzoek in de volledige tracering. Het DNS-resolutie is inderdaad iets langzamer in onze containers (de verklaring voor dit fenomeen is erg interessant, maar ik bewaar het voor een apart artikel). Het bleek dat de oorzaak van de grote vertragingen de oproepen naar de AWS Instance Metadata service bij elke aanvraag zijn.
Hypothese 2: onnodige oproepen naar AWS
Beide endpoints behoren tot . Onze microservice maakt gebruik van deze service tijdens het werken met Elasticsearch. Beide oproepen zijn onderdeel van het basisauthenticatieproces. Het endpoint dat wordt aangesproken bij de eerste aanvraag geeft de IAM-rol terug die aan de instantie is gekoppeld.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
De tweede aanvraag vraagt het tweede endpoint om tijdelijke machtigingen voor deze instantie:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Klanten kunnen deze gedurende een korte periode gebruiken en moeten periodiek nieuwe certificaten verkrijgen (tot hun Expiration). Het model is eenvoudig: AWS voert frequente rotaties van tijdelijke sleutels uit om veiligheidsredenen, maar klanten kunnen deze enkele minuten in cache opslaan om de prestatievermindering die gepaard gaat met het verkrijgen van nieuwe certificaten te compenseren.
AWS Java SDK zou verantwoordelijk moeten zijn voor het organiseren van dit proces, maar om de een of andere reden gebeurt dat niet.
Na het doorzoeken van issues op GitHub stuitten we op het probleem . Dit hielp ons de richting te bepalen waarin verder 'gegraven' moest worden.
AWS SDK werkt de certificaten bij bij een van de volgende voorwaarden:
- De vervaldatum (
Expiration) valt binnenEXPIRATION_THRESHOLD, hardcoded in de code op 15 minuten. - Er is meer tijd verstreken sinds de laatste poging om de certificaten bij te werken dan
REFRESH_THRESHOLD, hardcoded op 60 minuten.
Om de feitelijke vervaldatum van de certificaten die wij ontvingen te bekijken, hebben we de bovenstaande cURL-commando's uitgevoerd vanuit de container en vanuit de EC2-instantie. De geldigheid van het certificaat dat uit de container was verkregen, bleek veel korter te zijn: precies 15 minuten.
Nu is alles duidelijk: voor het eerste verzoek ontving onze service tijdelijke certificaten. Aangezien hun geldigheid niet langer dan 15 minuten was, besloot AWS SDK om deze bij elk volgend verzoek te vernieuwen. Dit gebeurde bij elk verzoek.
Waarom is de geldigheid van de certificaten korter geworden?
De AWS Instance Metadata-service is bedoeld voor gebruik met EC2-instanties en niet met Kubernetes. Aan de andere kant wilden we de applicatie-interfaces niet veranderen. Daarom maakten we gebruik van — een tool die met behulp van agents op elke Kubernetes-knoop gebruikers (ingenieurs die applicaties in de cluster implementeren) in staat stelt om IAM-rollen toe te wijzen aan containers in pods alsof ze EC2-instanties zijn. KIAM onderschept verzoeken aan de AWS Instance Metadata-service en verwerkt deze vanuit zijn cache, nadat hij deze van AWS heeft verkregen. Voor de applicatie verandert er niets.
KIAM levert kortlopende certificaten aan pods. Dit is logisch gezien het feit dat de gemiddelde levensduur van een pod korter is dan die van een EC2-instantie. Standaard is de geldigheid van de certificaten .
Als we dus beide standaardwaarden op elkaar leggen, ontstaat er een probleem. Elk certificaat dat aan de applicatie wordt verstrekt, verloopt na 15 minuten. Terwijl AWS Java SDK dwingend elk certificaat vernieuwt waarvan de vervaldatum minder dan 15 minuten bedraagt.
Als gevolg hiervan wordt het tijdelijke certificaat met elk verzoek gedwongen vernieuwd, wat leidt tot een paar oproepen naar de AWS API en resulteert in een aanzienlijke toename van de vertraging. In AWS Java SDK ontdekten we , waarin een soortgelijk probleem wordt genoemd.
De oplossing bleek eenvoudig. We hebben KIAM gewoon opnieuw geconfigureerd om certificaten met een langere geldigheidsduur op te vragen. Zodra dit gebeurde, verlopen de verzoeken zonder tussenkomst van de AWS Metadata-service en daalde de vertraging zelfs tot een lager niveau dan in EC2.
Conclusies
Op basis van onze ervaring met migraties kunnen we zeggen dat een van de meest voorkomende bronnen van problemen geen fouten in Kubernetes of andere platformelementen zijn. Het is ook niet gerelateerd aan fundamentele tekortkomingen in de microservices die we migreren. Problemen ontstaan vaak gewoon omdat we verschillende elementen met elkaar verbinden.
We mix complex systems that have never interacted with each other, hoping that together they will form a unified, larger system. Unfortunately, the more elements there are, the more room for errors, and the higher the entropy.
In our case, the high latency was not a result of errors or poor decisions in Kubernetes, KIAM, AWS Java SDK, or our microservice. It was the result of combining two independent parameters set by default: one in KIAM and the other in AWS Java SDK. Separately, both parameters make sense: the active certificate renewal policy in AWS Java SDK and the short certificate lifespan in KAIM. But when combined, the results become unpredictable. Two independent and logical decisions do not necessarily make sense when combined.
P.S. van de vertaler
To learn more about the architecture of the KIAM utility for integrating AWS IAM with Kubernetes, you can visit its creators.
And also read in our blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
