

Achtergrond
Er zijn handelsautomaten die we zelf hebben ontwikkeld. Binnenin zit een Raspberry Pi en een beetje extra hardware op een aparte printplaat. Aangesloten zijn een muntinvoerapparaat, bankbiljetinvoerapparaat, en een bankterminal... Alles wordt bestuurd door een zelfgeschreven programma. Alle werkverrichtingen worden in een logboek op een flashkaart (MicroSD) opgeslagen, dat vervolgens via internet (met behulp van een USB-modem) naar een server wordt verzonden, waar het in een database wordt opgeslagen. Informatie over verkopen wordt in 1C geladen; er is ook een eenvoudige webinterface voor monitoring, enzovoorts.
Dat betekent dat het logboek van vitaal belang is — voor administratie (opbrengst, verkopen, enzovoorts), monitoring (diverse storingen en andere overmachtsituaties); dit is, kan je zeggen, alle informatie die we over deze automaat hebben.
Probleem
Flashkaarten blijken zeer onbetrouwbare apparaten te zijn. Ze kunnen met vervelende regelmaat uitvallen. Dit leidt zowel tot uitval van de automaten als (als om de een of andere reden het logboek niet online kan worden verzonden) tot verlies van gegevens.
Dit is niet de eerste ervaring met flashkaarten. Voorheen was er een ander project met meer dan honderd apparaten waarin het logboek op USB-flashkaarten werd opgeslagen. Ook daar waren er problemen met de betrouwbaarheid, soms werden tientallen apparaten per maand onbruikbaar. We hebben verschillende flashkaarten geprobeerd, waaronder merkproducten met SLC-geheugen. Sommige modellen zijn betrouwbaarder dan andere, maar het vervangen van flashkaarten heeft het probleem niet echt opgelost.
Let op! Longread! Als je niet geïnteresseerd bent in 'waarom', maar alleen in 'hoe', kun je meteen naar het van het artikel gaan.
Oplossing
Het eerste wat in me opkomt: stop met MicroSD, gebruik bijvoorbeeld een SSD en boot daarvan. Theoretisch is het misschien mogelijk, maar relatief duur, en niet zo betrouwbaar (er komt een USB-SATA-adapter bij; de foutstatistieken voor goedkope SSD's zijn ook niet bemoedigend).
USB HDD's lijken ook niet echt een aantrekkelijk alternatief te zijn.
Daarom zijn we tot de volgende oplossing gekomen: blijf booten vanaf MicroSD, maar gebruik ze in read-only modus, en sla het logboek van de werking (en andere unieke informatie voor dit specifieke apparaat — serienummer, kalibraties van sensoren, enzovoorts) ergens anders op.
Het onderwerp van een read-only bestandssysteem voor de Raspberry Pi is al uitvoerig bestudeerd, ik zal in dit artikel niet op de details van de implementatie ingaan. (maar als er interesse is, schrijf ik misschien een mini-artikel over dit onderwerp). Een enkele opmerking die ik wil maken: zowel op basis van persoonlijke ervaring als op basis van getuigenissen van degenen die al hebben geïmplementeerd, is de winst in betrouwbaarheid er. Het is waar dat het onmogelijk is om volledig afscheid te nemen van storingen, maar het is heel goed mogelijk om hun frequentie aanzienlijk te verlagen. Bovendien worden de kaarten gestandaardiseerd, wat de vervanging voor het onderhoudspersoneel aanzienlijk vereenvoudigt.
Hardwaregedeelte
Met de keuze van het type geheugen waren er geen bijzondere twijfels - NOR Flash.
Argumenten:
- gemakkelijke aansluiting (meestal via SPI-bus, ervaring met het gebruik hiervan is al aanwezig, dus 'hardware'-problemen zijn niet te verwachten);
- lacherige prijs;
- standaardwerkprotocol (de implementatie is al in de kernel van Linux aanwezig, desgewenst kunnen externe versies worden genomen die ook beschikbaar zijn, of zelfs een eigen versie worden geschreven, wat gelukkig eenvoudig is);
- betrouwbaarheid en levensduur:
uit een typische datasheet: gegevens worden 20 jaar bewaard, 100.000 erasecycli voor elk blok;
uit externe bronnen: extreem lage BER, wordt gesteld dat er geen foutcorrectiecodes nodig zijn. (in sommige studies wordt ECC voor NOR overwogen, maar meestal bedoelen ze toch MLC NOR, dat komt ook voor).
Laten we de vereisten voor volume en levensduur inschatten.
Het is wenselijk dat gegevens gegarandeerd enkele dagen bewaard blijven. Dit is nodig zodat in geval van problemen met de communicatie de verkoopgeschiedenis niet verloren gaat. We zullen ons richten op 5 dagen, in deze periode (zelfs rekening houdend met weekenden en feestdagen) kan het probleem worden opgelost.
We verzamelen momenteel ongeveer 100 kB aan logboeken per dag (3-4 duizend records), maar geleidelijk groeit dit cijfer - er komt meer detail en er worden nieuwe gebeurtenissen toegevoegd. Daarnaast zijn er soms pieken (bijvoorbeeld wanneer een bepaalde sensor vals alarm slaat). We zullen rekenen op 10.000 records van 100 byte - een megabyte per dag.
Totaal komt dit neer op 5 MB aan 'schone' (goed te comprimeren) gegevens. Hierbij komen nog (ruwe schatting) 1 MB aan overheadgegevens.
Dat betekent dat we een chip van 8 MB nodig hebben als we compressie niet gebruiken, of 4 MB als we het wel doen. Dit zijn heel haalbare cijfers voor dit type geheugen.
Wat betreft de levensduur: als we ervan uitgaan dat het geheugen in zijn geheel niet vaker dan eens in de 5 dagen wordt overschreven, dan krijgen we over 10 jaar dienst minder dan duizend herschrijfcycli.
Ik herinner me dat de fabrikant honderdduizend belooft.
Een beetje over NOR vs NAND
Vandaag is NAND-geheugen natuurlijk veel populairder, maar voor dit project zou ik het niet gebruiken: NAND vereist, in tegenstelling tot NOR, absoluut het gebruik van foutcorrectiecodes, foutbloktabellen, enzovoort, en de pinnen van NAND-chips zijn meestal ook veel meer.
Als nadelen van NOR kunnen worden genoemd:
- kleine capaciteit (en daardoor een hoge prijs per megabyte);
- lage uitwisselsnelheid (grotendeels omdat er een seriële interface wordt gebruikt, meestal SPI of I2C);
- langzame wissen (afhankelijk van de blokgrootte, duurt het van een fractie van een seconde tot meerdere seconden).
Lijkt verder niets kritiek te zijn voor ons, dus we gaan door.
Als je geïnteresseerd bent in de details, is de chip gekozen: (hoewel dat niet relevant is, er zijn veel analogen op de markt die compatibel zijn qua pinout en instructiesysteem; zelfs als we willen overstappen naar een chip van een andere fabrikant en/of andere capaciteit, werkt alles gewoon zonder codewijzigingen.).
Ik gebruik de ingebouwde driver in de Linux-kernel; op de Raspberry is het dankzij de ondersteuning van device tree overlay heel eenvoudig — je moet de gecompileerde overlay in /boot/overlays plaatsen en een beetje de /boot/config.txt aanpassen.
Voorbeeld van een dts-bestand
Eerlijk gezegd ben ik niet zeker of het zonder fouten is geschreven, maar het werkt.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
En nog een regel in config.txt
dtoverlay=at25:spimaxfrequency=50000000Ik laat de beschrijving van de aansluiting van de chip op de Raspberry Pi achterwege. Aan de ene kant ben ik geen specialist in elektronica, aan de andere kant — het is zelfs voor mij vrij eenvoudig: de chip heeft slechts 8 pinnen, waarvan we aarde, voeding, SPI (CS, SI, SO, SCK) nodig hebben; de spanningsniveaus komen overeen met die van de Raspberry Pi, er is geen extra bedrading nodig — gewoon de genoemde 6 verbindingen aansluiten.
Taakstelling
Zoals gebruikelijk, gaat de probleemstelling door verschillende iteraties, en ik denk dat het tijd is voor een volgende. Dus laten we stoppen, verzamelen wat al is geschreven, en de resterende onduidelijkheden ophelderen.
Dus hebben we besloten dat het logboek wordt opgeslagen in SPI NOR Flash.
Wat is NOR Flash voor degenen die het niet weten?
Dit is niet-vluchtig geheugen waarop drie operaties kunnen worden uitgevoerd:
- Lezen:
Het meest gewone lezen: we geven een adres door en lezen zoveel bytes als we nodig hebben; - Schrijven:
Schrijven in NOR-flash lijkt normaal, maar heeft één bijzonder kenmerk: je kunt alleen 1 naar 0 veranderen, maar niet omgekeerd. Bijvoorbeeld, als er in ons geheugencel 0x55 stond, dan zal na het schrijven van 0x0f er al 0x05 zijn opgeslagen. (zie tabel iets lager); - Wissen:
Natuurlijk moeten we ook de omgekeerde operatie kunnen uitvoeren - een 0 naar een 1 veranderen; daarvoor bestaat de wisoperatie. In tegenstelling tot de eerste twee, werkt deze niet met bytes, maar met blokken (het minimale erase-blok in de gekozen chip is 4kb). Wissen vernietigt het gehele blok en is de enige manier om een 0 naar een 1 te veranderen. Daarom moet je bij het werken met flash-geheugen vaak de datastucturen uitlijnen op de grens van het erase-blok.
Schrijven in NOR Flash:
Binaire gegevens
Was
01010101
Geschreven
00001111
Is
00000101
Het logboek zelf is een reeks records van variabele lengte. De typische lengte van een record is ongeveer 30 bytes (hoewel er soms ook records van enkele kilobytes voorkomen). In dit geval behandelen we ze gewoon als een set bytes, maar als je geïnteresseerd bent, wordt binnen de records CBOR gebruikt.
Naast het logboek moeten we ook bepaalde 'instellingsinformatie' opslaan, zowel wat kan worden bijgewerkt als wat niet: een bepaalde apparaat-ID, kalibraties van sensoren, een vlag 'apparaat tijdelijk uitgeschakeld', enz.
Deze informatie bestaat uit een set key-value records, die ook in CBOR worden opgeslagen. We hebben niet veel van deze informatie (maximaal enkele kilobytes), en deze wordt niet vaak bijgewerkt.
Hierna zullen we het de context noemen.
Als we terugdenken aan het begin van dit artikel, is het zeer belangrijk om de betrouwbaarheid van gegevensopslag te waarborgen en, indien mogelijk, ononderbroken werking te garanderen, zelfs in het geval van hardwarestoringen/datacorruptie.
Welke probleembronnen kunnen we overwegen?
- Stroomuitval op het moment van write/erase-operaties. Dit valt in de categorie van 'er zijn geen middelen tegen een breekijzer'.
Informatie uit op stackexchange: bij stroomuitval tijdens het werken met flash, zowel erase (instelling op 1) als write (instelling op 0) leiden tot ongedefinieerd gedrag: de gegevens kunnen worden geschreven, gedeeltelijk worden geschreven (bijvoorbeeld, we hebben 10 bytes/80 bits overgedragen, maar slechts 45 bits zijn succesvol geschreven), en het is ook mogelijk dat sommige bits zich in een 'tussen' toestand bevinden (lezen kan zowel 0 als 1 opleveren); - Fouten in het flash-geheugen zelf.
Hoewel de BER zeer laag is, kan deze niet gelijk aan nul zijn; - Fouten op de bus
De gegevens die via SPI worden verzonden zijn op geen enkele manier beveiligd, en er kunnen zowel enkele bitfouten als synchronisatiefouten optreden - verlies of invoeging van bits (wat leidt tot zware vervormingen van gegevens); - Andere fouten/storingen
Fouten in de code, 'glitches' van de Raspberry, inmenging van buitenaardse wezens…
Ik heb de vereisten geformuleerd waarvan ik denk dat ze noodzakelijk zijn voor de betrouwbaarheid:
- opnames moeten onmiddellijk naar flashgeheugen worden geschreven; uitgestelde opname wordt niet overwogen; - als er een fout optreedt, moet deze zo vroeg mogelijk worden gedetecteerd en verwerkt; - het systeem moet in staat zijn om na fouten weer te herstellen waar mogelijk.
(voorbeeld uit de praktijk van 'hoe het niet moet', waarmee iedereen denk ik wel eens is geconfronteerd: na een noodrestart is het bestandssysteem ‘vervallen’ en start het besturingssysteem niet op)
Ideeën, benaderingen, overpeinzing
Toen ik begon na te denken over deze taak, schoten er allerlei ideeën door mijn hoofd, bijvoorbeeld:
- gegevenscompressie gebruiken;
- slimme datastructuren gebruiken, bijvoorbeeld de headers van de opnames apart opslaan van de opnames zelf, zodat bij een fout in een opname de anderen zonder problemen kunnen worden gelezen;
- bitvelden gebruiken om de voltooiing van opnames te controleren bij een stroomonderbreking;
- controlegetallen opslaan voor alles en nog wat;
- een of andere vorm van foutccorrectie codering gebruiken.
Deel van deze ideeën is gebruikt, een deel is weggelaten. Laten we dit stap voor stap doornemen.
Gegevenscompressie
De gebeurtenissen die we in het logboek vastleggen zijn vrij uniform en herhaaldelijk ('we gooiden een muntje van 5 roebel', 'we drukten op de knop voor teruggave', …). Daarom zou compressie behoorlijk effectief moeten zijn.
De overhead van compressie is marginaal (de processor is krachtig genoeg, zelfs op de eerste Pi had je één kern met een frequentie van 700MHz, op de actuele modellen zijn er meerdere kernen met een frequentie van meer dan een gigahertz), de snelheid van de opslag is niet hoog (enkele megabytes per seconde), de grootte van de opnames is beperkt. Kortom, als compressie invloed heeft op de prestatie, zal dit alleen positief zijn. (absoluut niet kritiek, ik constateer gewoon). Plus, we don't actually have a genuine embedded system, but rather a regular Linux, so the implementation shouldn't require much effort (just linking the library and using a few of its functions).
A segment of the log from the operational device (1.7MB, 70,000 entries) was taken and initially checked for compressibility using the available tools on the computer: gzip, lz4, lzop, bzip2, xz, zstd.
- gzip, xz, and zstd showed similar results (40KB).
It was surprising that the trendy xz performed at the same level as gzip or zstd; - lzip with default settings yielded slightly worse results;
- lz4 and lzop showed not very good results (150KB);
- bzip2 surprisingly provided a good result (18KB).
So, the data compresses very well.
Therefore, (if we do not find any fatal flaws) compression is a go! Simply because more data can fit on the same flash drive.
Let's think about the drawbacks.
The first problem: we already agreed that each entry must be immediately written to the flash. Typically, a compressor accumulates data from the input stream until it decides it's time to write to the output. We, however, need to immediately obtain a compressed block of data and store it in non-volatile memory.
I see three ways:
- Compress each entry using dictionary compression instead of the algorithms discussed above.
It's a workable option, but I don't like it. To ensure a fairly decent compression level, the dictionary should be 'sharpened' for specific data; any change will lead to a catastrophic drop in the compression level. Yes, this problem can be solved by creating a new version of the dictionary, but it's a headache - we will need to store all versions of the dictionary; each entry will need to indicate which version of the dictionary it was compressed with... - Compress each entry using 'classic' algorithms, but independently of others.
The discussed compression algorithms are not designed to work with entries of this size (tens of bytes), the compression ratio will clearly be less than 1 (that is, an increase in data volume instead of compression); - Perform a FLUSH after each entry.
Many compression libraries support FLUSH. This is a command (or parameter to the compression procedure) that, when received, instructs the compressor to generate a compressed stream so that it can be restored based on it. all ongecomprimeerde gegevens die al zijn verkregen. Een dergelijke analogiesyncin bestandssystemen ofcommitin sql.
Wat belangrijk is, is dat latere compressieoperaties de opgebouwde woordenlijst kunnen gebruiken en de compressiegraad niet zo veel zal lijden als in de vorige variant.
Ik denk dat het duidelijk is dat ik voor de derde optie heb gekozen, laten we daar dieper op ingaan.
Vond over FLUSH in zlib.
Ik heb een op de artikel gebaseerde test gedaan, ik nam 70.000 logrecords van een echt apparaat, met een paginagrootte van 60KB (over de paginagrootte komen we nog terug) kreeg:
Brongegevens
gzip compressie -9 (zonder FLUSH)
zlib met Z_PARTIAL_FLUSH
zlib met Z_SYNC_FLUSH
Grootte, KB
1692
40
352
604
Op het eerste gezicht lijkt de prijs die FLUSH met zich meebrengt overdreven hoog, maar eigenlijk hebben we niet veel keus — of helemaal niet comprimeren, of comprimeren (en zeer effectief) met FLUSH. Vergeet niet dat we 70.000 records hebben, de overbodigheid die Z_PARTIAL_FLUSH toevoegt bedraagt slechts 4-5 bytes per record. En de compressieverhouding bleek bijna 5:1 te zijn, wat een uitstekende uitkomst is.
Het kan verrassend lijken, maar in werkelijkheid is Z_SYNC_FLUSH een effectievere manier om FLUSH uit te voeren
Bij gebruik van Z_SYNC_FLUSH zijn de laatste 4 bytes van elke record altijd 0x00, 0x00, 0xff, 0xff. En als we die kunnen kennen — dan hoeven we ze niet op te slaan, waardoor de uiteindelijke grootte slechts 324KB bedraagt.
In het artikel waar ik naar verwijs, is er een uitleg:
Een nieuw type 0-blok met lege inhoud wordt toegevoegd.
Een type 0-blok met lege inhoud bestaat uit:
- de drie-bits blokheader;
- 0 tot 7 bits gelijk aan nul, om byte-alignment te bereiken;
- de vier-byte reeks 00 00 FF FF.
Zoals gemakkelijk te zien is, gaat er in het laatste blok voor deze 4 bytes tussen de 3 en 10 nullen. Echter, de praktijk heeft aangetoond dat er daadwerkelijk minimaal 10 nullen zijn.
Het blijkt dat zulke korte datablocks meestal (altijd?) gecodeerd worden met behulp van een blok type 1 (fixed block), dat altijd eindigt met 7 nullen, wat in totaal 10-17 gegarandeerde nullen oplevert (en de overige zullen met ongeveer 50% waarschijnlijkheid nul zijn).
Dus, op de testgegevens gaat bij 100% van de gevallen voor 0x00, 0x00, 0xff, 0xff een nullenbyte vooraf, en in meer dan een derde geval - twee nullenbytes (misschien komt het omdat ik binair CBOR gebruik, en bij het gebruik van tekst-JSON zouden blokken van type 2 — dynamisch blok waarschijnlijk vaker voorkomen, en zouden er blokken zonder extra nullen voor 0x00, 0x00, 0xff, 0xff zijn).
In totaal kunnen we met de beschikbare testgegevens minder dan 250 KB aan gecomprimeerde gegevens halen.
We kunnen nog wat besparen door met bits te jongleren: momenteel negeren we de aanwezigheid van meerdere nulbits aan het einde van een blok; ook veranderen een paar bits aan het begin van een blok niet...
Maar hier nam ik de beslissing om te stoppen, anders zouden we met deze snelheid zelf een archiveringsprogramma gaan ontwikkelen.
Al met al heb ik uit mijn testgegevens 3-4 bytes per schrijven gehaald, met een compressieverhouding van meer dan 6:1. Eerlijk gezegd verwachtte ik niet zo'n resultaat; naar mijn mening is alles beter dan 2:1 al een resultaat dat het gebruik van compressie rechtvaardigt.
Alles is geweldig, maar zlib (deflate) is toch een verouderd en enigszins ouderwets compressie-algoritme. Het feit dat de laatste 32 KB van de ongecomprimeerde gegevensstroom als woordenboek worden gebruikt, voelt tegenwoordig vreemd aan (dit betekent dat als een datablock erg lijkt op dat wat 40 KB geleden in de invoerstroom was, het opnieuw wordt gecomprimeerd in plaats van te verwijzen naar de vorige inzet). In moderne archiveringsprogramma's wordt de grootte van het woordenboek vaak in megabytes gemeten in plaats van kilobytes.
Dus we gaan door met ons mini-onderzoek naar archiveringsprogramma's.
De volgende die we testten was bzip2 (ter herinnering, zonder FLUSH toonde het een fantastische compressieverhouding van bijna 100:1). Helaas, met FLUSH presteerde het heel slecht, de grootte van de gecomprimeerde gegevens was groter dan die van de ongecomprimeerde.
Mijn vermoedens over de redenen voor het falen
Libbz2 biedt slechts één optie voor flush, die schijnbaar het woordenboek leegt (vergelijkbaar met Z_FULL_FLUSH in zlib), waardoor efficiënt comprimeren na dit punt niet mogelijk is.
En als laatste werd zstd getest. Afhankelijk van de parameters compresseert het of op het niveau van gzip, maar veel sneller, of beter dan gzip.
Helaas, met FLUSH liet ook hij niet zo'n goede indruk achter: de grootte van de gecomprimeerde gegevens kwam uit op ongeveer 700 KB.
Ik op de projectpagina op github, kreeg het antwoord dat je rekening moet houden met tot 10 bytes aan overheadgegevens per blok van gecomprimeerde gegevens, wat dicht bij de verkregen resultaten ligt; deflate zal je niet kunnen inhalen.
Hierop besloot ik mijn experimenten met archiveringsprogramma's te beëindigen (ter herinnering, xz, lzip, lzo, lz4 hebben zich nog niet bewezen in de testfase zonder FLUSH, en ik wilde niet meer exotische compressie-algoritmen overwegen).
Laten we terugkeren naar de problemen van archivering.
Het tweede probleem (zoals we het in volgorde zeggen, en niet op betekenis) is dat de gecomprimeerde gegevens een enkele stroom vormen, waarin voortdurend verwijzingen naar eerdere delen voorkomen. Bij beschadiging van een deel van de gecomprimeerde gegevens verliezen we niet alleen het gerelateerde onbewerkte gegevensblok, maar ook alle daaropvolgende.
Er zijn verschillende benaderingen om dit probleem op te lossen:
- Voorkom het ontstaan van het probleem - voeg redundantie toe aan de gecomprimeerde gegevens, zodat fouten kunnen worden gedetecteerd en gecorrigeerd; hierover zullen we later spreken;
- Minimaliseer de gevolgen in geval van een probleem.
We hebben eerder besproken dat we elk gegevensblok onafhankelijk kunnen comprimeren, wat het probleem van zichzelf zou wegnemen (de schade aan de gegevens van één blok leidt alleen tot verlies van die gegevens). Dit is echter een uiterste oplossing, waarbij compressie van gegevens niet effectief zal zijn. De tegenovergestelde extreem: gebruik de hele 4 MB van onze chip als één enkel archief, wat ons geweldige compressie zal geven, maar catastrofale gevolgen zal hebben in geval van gegevensbeschadiging.
Ja, er moet een compromis zijn vanuit het oogpunt van betrouwbaarheid. Maar we moeten ons ervan bewust zijn dat we een gegevensopslagformaat ontwikkelen voor niet-vluchtig geheugen met een extreem lage BER en een geclaimde levensduur van gegevens van 20 jaar.
Tijdens experimenten merkte ik dat merkbare verliezen in compressieniveau beginnen bij gecomprimeerde gegevensblokken van minder dan 10 KB.
Eerder werd vermeld dat het gebruikte geheugen een paginagestructuur heeft; ik zie geen reden waarom we niet de overeenkomst 'één pagina - één gecomprimeerd gegevensblok' moeten gebruiken.
Dus de minimale redelijke paginagrootte is 16 KB (met ruimte voor beheergegevens). Een dergelijke kleine paginagrootte legt echter aanzienlijke beperkingen op aan de maximale grootte van een record.
Hoewel ik momenteel geen records van meer dan enkele kilobytes in gecomprimeerde vorm verwacht, heb ik besloten om pagina's van 32 KB te gebruiken (in totaal 128 pagina's op de chip).
Samenvatting:
- We slaan de gegevens gecomprimeerd op met zlib (deflate);
- Voor elk record stellen we Z_SYNC_FLUSH in;
- We snijden de eindbytes van elke gecomprimeerde opname af, (bijvoorbeeld, 0x00, 0x00, 0xff, 0xff); in de header geven we aan hoeveel bytes we hebben afgesneden;
- We store data in pages of 32KB; inside each page, there is a continuous stream of compressed data; we start compression anew on each page.
And before finishing with the compression, I would like to point out that we only get a few bytes of compressed data per record, so it is crucial not to inflate the overhead information; every byte counts here.
Storage of data headers
Since we have variable-length records, we need a way to determine the placement/boundaries of the records.
I know three approaches:
- All records are stored in a continuous stream, starting with a record header that contains the length, followed by the record itself.
In this variant, both the headers and the data can have variable length.
Essentially, we end up with a singly linked list, which is used quite often; - Headers and records themselves are stored in separate streams.
By using fixed-length headers, we ensure that the corruption of one header does not affect the others.
This approach is used, for example, in many file systems; - Records are stored in a continuous stream, with the boundary of the record defined by some marker (symbol/sequence of symbols that are prohibited within data blocks). If a marker is found inside a record, we replace it with a certain sequence (escape it).
This approach is used, for example, in the PPP protocol.
Let me illustrate.
Option 1:
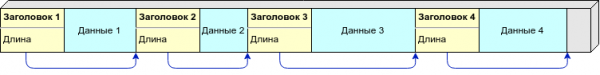
Here everything is very simple: knowing the length of the record, we can calculate the address of the next header. This way, we move through the headers until we encounter an area filled with 0xff (free space) or the end of the page.
Option 2:
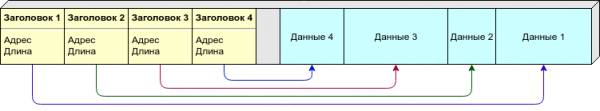
Due to the variable length of the records, we cannot predict how many records (and thus headers) will be needed on a page. We could spread the headers and the actual data across different pages, but I prefer another approach: we place both headers (of fixed size) and data (of variable length) on the same page, starting the headers from the beginning of the page, while the data comes from the end. As soon as they 'meet' (not enough free space for a new record) — we consider this page filled.
Option 3:

Het is niet nodig om de lengte of andere informatie over de locatie van gegevens in de header op te slaan; markers die de grenzen van records aangeven zijn voldoende. Echter, de gegevens moeten worden verwerkt bij het schrijven/lezen.
Als marker zou ik 0xff gebruiken (waarmee de pagina na het wissen is gevuld), zodat het vrije gebied zeker niet als gegevens wordt geïnterpreteerd.
Vergelijkingstabel:
Optie 1
Optie 2
Optie 3
Fouttolerantie
—
+
+
Compactheid
+
—
+
Complexiteit van implementatie
*
**
**
Optie 1 heeft een fatale tekortkoming: als een van de headers beschadigd is, vervalt de gehele daaropvolgende keten. De andere opties stellen ons in staat om een deel van de gegevens te herstellen, zelfs bij massale beschadigingen.
Maar het is op zijn plaats om te herinneren aan het feit dat we besloten hebben om gegevens gecomprimeerd op te slaan; we verliezen sowieso alle gegevens op de pagina na een 'beschadigde' opname, dus ook al staat er een min in de tabel, we houden daar geen rekening mee.
Compactheid:
- in de eerste optie hoeven we alleen de lengte in de header op te slaan; als we hele variabelen van variabele lengte gebruiken, kunnen we in de meeste gevallen volstaan met één byte;
- in de tweede optie moeten we het startadres en de lengte opslaan; de opname moet een constante grootte hebben, ik schat 4 bytes per opname (twee bytes voor offset en twee bytes voor lengte);
- de derde optie heeft slechts één symbool nodig om het begin van de opname aan te duiden, plus de opname zelf zal door escaping met 1-2% toenemen. Over het geheel genomen is er een vergelijkbare verhouding met de eerste optie.
In eerste instantie beschouwde ik de tweede optie als de primaire (en ik had zelfs een implementatie geschreven). Ik heb deze pas verworpen toen ik definitief besloot om compressie te gebruiken.
Misschien zal ik ooit een dergelijke optie gebruiken. Bijvoorbeeld als ik verantwoordelijk moet zijn voor het opslaan van gegevens voor een schip dat tussen de aarde en Mars vaart - heel andere eisen aan betrouwbaarheid, kosmische straling, ...
Wat de derde optie betreft: ik heb deze twee sterren gegeven voor de complexiteit van implementatie, gewoon omdat ik niet hou van het rommelen met escaping, het wijzigen van de lengte in het proces, enzovoort. Ja, misschien ben ik bevooroordeeld, maar ik moet de code schrijven - waarom zou ik mezelf dwingen om te doen wat ik niet leuk vind.
Samenvatting: We kiezen de opslageenheid in de vorm van chains "header met lengte - data van variabele lengte" vanwege de efficiëntie en eenvoud van implementatie.
Het gebruik van bitvelden voor het controleren van het succes van schrijfoperaties.
Ik herinner me nu al niet meer waar ik het idee heb opgepikt, maar het ziet er ongeveer zo uit:
Voor elke invoer toewijzen we een paar bits om vlaggen op te slaan.
Zoals eerder vermeld, zijn na het wissen alle bits gevuld met 1, en we kunnen 1 naar 0 veranderen, maar niet andersom. Dus voor 'vlag niet ingesteld' gebruiken we 1, voor 'vlag ingesteld' - 0.
Zo kan de invoer van variabele lengte in flash eruitzien:
- We stellen de vlag "lengte schrijfproces begonnen" in;
- We schrijven de lengte;
- We stellen de vlag "data schrijfproces begonnen" in;
- We schrijven de data;
- We stellen de vlag "schrijven is voltooid" in.
Daarnaast hebben we de vlag "er is een fout opgetreden", in totaal 4 bit-vlaggen.
In dit geval hebben we twee stabiele toestanden "1111" - schrijven is niet begonnen en "1000" - schrijven is succesvol verlopen; in het geval van een onverwachte onderbreking van het schrijfproces krijgen we tussenliggende toestanden, die we dan kunnen detecteren en verwerken.
Een interessante benadering, maar het beschermt alleen tegen onverwachte uitschakelingen van de voeding en soortgelijke storingen, wat zeker belangrijk is, maar het is verre van de enige (en zelfs niet de belangrijkste) reden voor mogelijke fouten.
Samenvatting: Laten we verder gaan in de zoektocht naar een goede oplossing.
Controlegetallen.
Controlegetallen bieden ook de mogelijkheid om te verifiëren (met een hoge waarschijnlijkheid) dat we precies lezen wat er zou moeten zijn geschreven. En in tegenstelling tot de eerder besproken bitvelden werken ze altijd.
Als we de lijst van potentiële bronnen van problemen die we eerder hebben besproken bekijken, kan een controlegetal een fout herkennen, ongeacht de oorsprong ervan. (behalve, misschien, kwaadaardige buitenaardse wezens - die kunnen ook een controlegetal vervalsen).
Dus als ons doel is om te controleren of de gegevens intact zijn, zijn controlegetallen een geweldig idee.
De keuze van het algoritme voor het berekenen van het controlegetal was geen vraag - CRC. Enerzijds maken de wiskundige eigenschappen het mogelijk om 100% van bepaalde types fouten te detecteren, anderzijds toont dit algoritme bij willekeurige gegevens meestal een kans op botsingen die niet veel hoger is dan de theoretische limiet.  Ook al is dit misschien niet het snelste algoritme of het minimals qua aantal botsingen, het heeft een zeer belangrijke eigenschap: in de tests die ik heb uitgevoerd, kwam ik geen patronen tegen waar het duidelijk falen vertoonde. Stabiliteit is in dit geval de belangrijkste kwaliteit.
Voorbeeld van een omvangrijk onderzoek: , (links naar narod.ru, sorry).
Echter, de taak van het kiezen van een checksum is nog niet voltooid; CRC is een hele familie van checksums. We moeten beslissen over de lengte, en daarna een polynoom kiezen.
De keuze van de lengte van de checksum is niet zo'n eenvoudige kwestie als het op het eerste gezicht lijkt.
Ik zal het illustreren:
Laten we zeggen dat de kans op een fout in elke byte  en de ideale checksum is, laten we het gemiddelde aantal fouten per miljoen records berekenen:
Gegevens, byte
Checksum, byte
Niet-ontdekte fouten
Valse positieven voor fouten
Totaal aantal onjuiste detecties
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Het lijkt eenvoudig — kies de lengte van de checksum afhankelijk van de lengte van de beschermde gegevens met een minimum aan onjuiste detecties — en het is opgelost.
Echter, bij korte checksums ontstaat er een probleem: hoewel ze goed zijn in het detecteren van enkele bitfouten, kunnen ze met een behoorlijke kans volledig willekeurige gegevens als geldig beschouwen. Er was al een artikel op Habr dat het beschreef. .
Dus, om een willekeurige checksum-overeenstemming praktisch onmogelijk te maken, moet je checksums gebruiken van 32 bits of meer. (voor lengtes van meer dan 64 bits worden meestal cryptografische hashfuncties gebruikt).
Hoewel ik eerder schreef dat we zoveel mogelijk ruimte moeten besparen, zullen we toch een 32-bits checksum gebruiken (16 bits is te weinig, de kans op een botsing is meer dan 0,01%; en 24 bits, zoals ze zeggen, is een tussenoplossing).
Hier kan een bezwaar ontstaan: was dat wel de reden waarom we elke byte bij het kiezen van compressie hebben bespaard, om nu meteen 4 bytes te geven? Was het niet beter om niet te comprimeren en geen checksum toe te voegen? Natuurlijk niet, het ontbreken van compressie betekent niet, dat we geen integriteitscontrole nodig hebben.
Wat betreft de keuze van de polynoom zullen we niet de fiets opnieuw uitvinden, maar zullen we de momenteel populaire CRC-32C gebruiken.
Deze code detecteert 6 bitfouten in pakketten tot 22 byte (misschien de meest voorkomende situatie voor ons), 4 bitfouten in pakketten tot 655 byte (ook een vaak voorkomende situatie voor ons), 2 of een oneven aantal bitfouten in pakketten van elke redelijke lengte.
Als iemand geïnteresseerd is in de details
over CRC.
en een werkende opdracht krijgen. — waarschijnlijk de grootste specialist in CRC op de planeet.
In bestaande , die iets betere parameters biedt voor de voor ons relevante pakketlengtes, maar ik vond het verschil niet significant genoeg en mezelf bekwaam genoeg om een aangepaste code boven de standaard en goed onderzochte te kiezen.
Bovendien, aangezien onze gegevens gecomprimeerd zijn, rijst de vraag: moeten we de checksum berekenen over gecomprimeerde of ongecomprimeerde gegevens?
Argumenten "voor" het berekenen van de checksum van ongecomprimeerde gegevens:
- we moeten uiteindelijk de integriteit van de gegevensopslag controleren — dat is wat we hier rechtstreeks doen (bij deze controle worden ook mogelijke fouten in de compressie-/decompressie-implementatie en beschadigingen door defecte geheugen gecontroleerd);
- het deflate-algoritme in zlib heeft een voldoende volwassen implementatie en mag niet falen bij "rare" invoergegevens, bovendien is het vaak in staat om fouten in de invoerstream zelfstandig te detecteren, waardoor de algehele kans op het niet detecteren van een fout wordt verminderd (ik heb een test gedaan met het in omgekeerde zin beïnvloeden van één bit in een korte opname, zlib detecteerde de fout in ongeveer een derde van de gevallen).
Argumenten "tegen" het berekenen van de checksum van ongecomprimeerde gegevens:
- CRC is specifiek afgestemd op de weinige bitfouten die typisch zijn voor flash-geheugen (een bitfout in een gecomprimeerde stream kan een massale verandering in de uitvoerstream veroorzaken, waarbij we theoretisch een botsing kunnen "vangen");
- ik ben niet echt blij met het idee om potentieel defecte gegevens naar de decompressiemodule te sturen, , hoe deze zal reageren.
In dit project heb ik besloten om af te wijken van de gangbare praktijk van het opslaan van de checksum van ongecomprimeerde gegevens.
Samenvatting: we gebruiken CRC-32C, de checksum berekenen we over de gegevens in de vorm waarin ze in de flash worden opgeslagen (na compressie).
Redundantie
Het gebruik van redundant coderen elimineert natuurlijk niet het verlies van gegevens, maar kan de kans op onherstelbaar gegevensverlies aanzienlijk (vaak met vele ordes) verlagen.
We kunnen verschillende soorten redundanties gebruiken om fouten te corrigeren.
Hamming-codes kunnen enkele bitfouten corrigeren, Reed-Solomon-codes zijn symbolisch, verschillende kopieën van gegevens samen met checksums of codering zoals RAID-6 kunnen helpen gegevens te herstellen, zelfs in geval van massale beschadigingen.
Oorspronkelijk was ik voorstander van breed gebruik van foutcorrigerende codering, maar later besefte ik dat we eerst moeten begrijpen tegen welke fouten we ons willen beschermen, en vervolgens de codering moeten kiezen.
We hebben eerder besproken dat fouten zo snel mogelijk moeten worden gedetecteerd. Wanneer kunnen we met fouten geconfronteerd worden?
- Onvoltooide opname (om welke reden dan ook viel de stroom uit op het moment van opname, Raspberry hangt, ...)
Helaas, in het geval van een dergelijke fout blijven we alleen over om ongeldige vermeldingen te negeren en de gegevens als verloren te beschouwen; - Schrijffouten (om welke reden dan ook is niet wat geschreven zou worden in flash-geheugen geschreven)
Dergelijke fouten kunnen we onmiddellijk detecteren als we direct na opname een controlelezen uitvoeren; - Vervorming van gegevens in het geheugen tijdens opslag;
- Leesfouten
Voor correctie is het voldoende om bij een mismatch van de checksum een aantal keren te herlezen.
Dat wil zeggen, alleen fouten van het derde type (spontane gegevenscorruptie bij opslag) kunnen niet worden gecorrigeerd zonder foutcorrigerende codering. Dergelijke fouten lijken me uiterst onwaarschijnlijk.
Samenvatting: Het werd besloten af te zien van redundante codering, maar als de praktijk aantoont dat deze beslissing fout is, dan zal de kwestie opnieuw worden bekeken (met reeds verzamelde statistieken over storingen, die ons in staat zal stellen de optimale codering te kiezen).
Overige
Het format van het artikel laat natuurlijk niet toe om elk bit in het formaat te rechtvaardigen (en ik ben inmiddels ook uitgeput), daarom zal ik kort langs enkele punten gaan die eerder niet zijn aangestipt.
- Besloten is om alle pagina's "gelijkwaardig" te maken.
Er zijn geen speciale pagina's met metadata, afzonderlijke stromen, enzovoorts; in plaats daarvan is er één stroom die alle pagina's achtereenvolgens herschrijft.
Dit zorgt voor gelijkmatige slijtage van pagina's, het ontbreken van een enkel stevigere punt en gewoon omdat het leuk is. - Versiebeheer van het formaat moet absoluut worden voorzien.
Een formaat zonder versienummer in de header is slecht!
Het is genoeg om een veld met een bepaalde Magic Number (handtekening) toe te voegen aan de header van de pagina, dat de gebruikte versie van het formaat aangeeft. (ik denk niet dat er in de praktijk zelfs een tiental zullen zijn); - Gebruik voor records (waarvan er heel veel zijn) een header van variabele lengte, en probeer voor de meeste gevallen de lengte op 1 byte te houden.
- Gebruik binaire codes van variabele lengte om de lengte van de header en de lengte van het afgesneden deel van de gecomprimeerde opname te coderen.
Het hielp enorm van Huffman-codes. In slechts enkele minuten lukte het om de juiste variabele lengtecodes te vinden.
Beschrijving van het gegevensopslagformaat
Byte volgorde
Velden groter dan één byte worden opgeslagen in big-endian formaat (netwerk byte volgorde), dat wil zeggen dat 0x1234 wordt opgeslagen als 0x12, 0x34.
Verdeling in pagina's
Het hele flashgeheugen is verdeeld in pagina's van gelijke grootte.
De standaard pagina-grootte is 32 KB, maar niet meer dan 1/4 van de totale grootte van de geheugenchip (voor een chip van 4 MB resulteren 128 pagina's).
Elke pagina slaat gegevens onafhankelijk van de andere op (dat wil zeggen, de gegevens van de ene pagina verwijzen niet naar de gegevens van een andere pagina).
Alle pagina's zijn genummerd in natuurlijke volgorde (op oplopende adressen), beginnend met nummer 0 (de nulpagina begint bij adres 0, de eerste bij 32 KB, de tweede bij 64 KB, enzovoorts).
De geheugenchip wordt gebruikt als een ringbuffer, dat wil zeggen dat de opname eerst naar de pagina met nummer 0 gaat, vervolgens naar de pagina met nummer 1, ... wanneer we de laatste pagina vullen, begint de nieuwe cyclus en gaat de opname verder met pagina nul.
Binnen de pagina
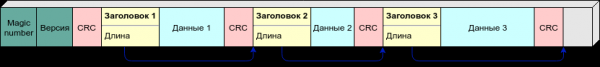
Aan het begin van de pagina staat een header van 4 bytes, gevolgd door een checksum van de header (CRC-32C), daarna worden de records opgeslagen in het formaat "header, gegevens, checksum".
De header van de pagina (in de schets vuilgroen) bestaat uit:
- een twee-byte veld van de Magic Number (de indicator van de versie van het formaat)
voor de huidige versie van het formaat wordt het beschouwd als0xed00 ⊕ paginanummer; - tweebit tellertje 'Versie van de pagina' (herinneringscyclus nummer).
Op de pagina worden de records gecomprimeerd opgeslagen (de compressie-algoritme deflate wordt gebruikt). Alle records op één pagina worden in één stroom gecomprimeerd (met behulp van een gemeenschappelijk woordenboek), bij elke nieuwe pagina begint de compressie opnieuw. Dit betekent dat voor de decompressie van elk record alle voorgaande records van deze pagina nodig zijn (en alleen van deze).
Elk record wordt gecomprimeerd met de vlag Z_SYNC_FLUSH, waarbij aan het einde van de gecomprimeerde stroom 4 bytes 0x00, 0x00, 0xff, 0xff komen, mogelijk voorafgegaan door nog één of twee nullen.
Deze reeks (van 4, 5 of 6 bytes) wordt weggelaten bij het opschrijven naar flash-geheugen.
De header van het record bestaat uit 1, 2 of 3 bytes, die het volgende bevatten:
- een bit (T), dat het type record aangeeft: 0 — context, 1 — log;
- een veld variabele lengte (S) van 1 tot 7 bits, dat de lengte van de header en 'staart' die aan het record moet worden toegevoegd voor decompressie definieert;
- de lengte van het record (L).
Waarden tabel S:
S
Lengte van de header, bytes
Wordt weggelaten bij het opschrijven, bytes
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Ik heb geprobeerd het te illustreren, ik weet niet hoe duidelijk het is geworden:
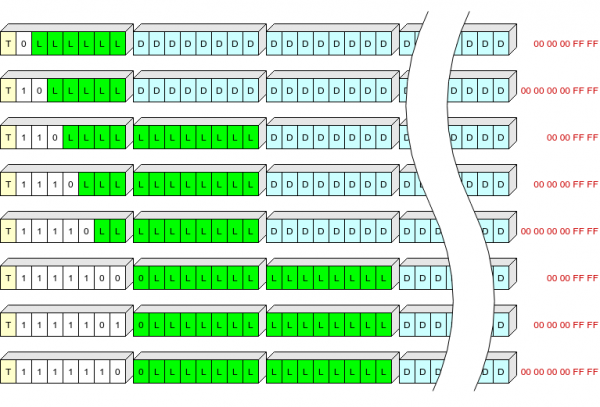
Geel hier geeft veld T aan, wit - veld S, groen - L (lengte van gecomprimeerde gegevens in bytes), lichtblauw - gecomprimeerde gegevens, rood - eindbytes van gecomprimeerde gegevens die niet in flash-geheugen worden geschreven.
Op deze manier kunnen we headers van de meest voorkomende lengte (tot 63+5 bytes in gecomprimeerde vorm) met één byte opschrijven.
Na elk record staat een controlesom CRC-32C, waarbij het initiële waarde (init) de omgekeerde waarde van de vorige controlesom is.
CRC heeft de eigenschap van 'continuïteit', dit werkt (plus-minus inversie van bits in het proces) volgens deze formule:  .
Dat wil zeggen, we berekenen feitelijk de CRC van alle voorgaande bytes van headers en gegevens op deze pagina.
Direct achter de controlesom ligt de header van het volgende record.
De header is op zo'n manier geconstrueerd dat de eerste byte altijd verschillend is van 0x00 en 0xff (als we in plaats van de eerste byte van de header 0xff tegenkomen, betekent dit dat dit een onbeheerd gebied is; 0x00 geeft een fout aan).
Voorlopige algoritmen
Lezen uit flash-geheugen
Elke lezing gaat gepaard met een controlesom verificatie.
Als de checksum niet overeenkomt, wordt het lezen meerdere keren herhaald in de hoop de juiste gegevens te lezen.
(dit is logisch, Linux cache leest niet uit NOR Flash, dit is bevestigd)
Schrijven naar flash-geheugen
We schrijven gegevens.
We lezen ze.
Als de gelezen gegevens niet overeenkomen met de geschreven gegevens, vullen we het gebied met nullen en signaleren we een fout.
De nieuwe chip voorbereiden voor gebruik
Voor initialisatie wordt in de eerste (eigenlijk nulde) pagina een header met versie 1 geschreven.
Daarna wordt de begincontext in deze pagina geschreven (bevat UUID van de machine en standaardinstellingen).
Klaar, het flash-geheugen is gereed voor gebruik.
Laden van de machine
Bij het laden worden de eerste 8 bytes van elke pagina (header + CRC) gelezen; pagina's met een onbekend magic number of onjuiste CRC worden genegeerd.
Van de 'goede' pagina's worden die met de hoogste versie geselecteerd, waarbij de pagina met het hoogste nummer wordt genomen.
De eerste record wordt gelezen, de geldigheid van de CRC en de aanwezigheid van de 'context' vlag worden gecontroleerd. Als alles in orde is, wordt deze pagina als huidige beschouwd. Zo niet, dan keren we terug naar de vorige totdat we een 'levende' pagina vinden.
Van de gevonden pagina lezen we alle records, degenen met de 'context' vlag passen we toe.
We slaan de zlib dictionary op (dit zal nodig zijn voor het opnieuw schrijven naar deze pagina).
Klaar, de laadsessie is voltooid, de context is hersteld, en we kunnen werken.
Een record aan het logboek toevoegen
We comprimeren het record met de juiste dictionary, waarbij we Z_SYNC_FLUSH opgeven. We kijken of het gecomprimeerde record op de huidige pagina past.
Als het niet past (of er waren CRC-fouten op de pagina) - beginnen we een nieuwe pagina (zie hieronder).
We schrijven het record en de CRC. Als er een fout optreedt - beginnen we een nieuwe pagina.
Nieuwe pagina
We kiezen een vrije pagina met het laagste nummer (we beschouwen een pagina als vrij als deze een onjuiste checksum in de header heeft of een versie die lager is dan de huidige). Als er geen dergelijke pagina's zijn - kiezen we de pagina met het laagste nummer met een versie die gelijk is aan de huidige.
We maken de gekozen pagina leeg. We vergelijken de inhoud met 0xff. Als er iets niet klopt - nemen we de volgende vrije pagina, enzovoort.
Op de geleegde pagina schrijven we de header, de eerste record is de huidige staat van de context, de volgende is het ongeschreven record van het logboek (als die er is).
Toepasselijkheid van het formaat
Naar mijn mening is dit een behoorlijk goede indeling voor het opslaan van elke soort samendrukbare informatie (gewone tekst, JSON, MessagePack, CBOR, mogelijk protobuf) in NOR Flash.
Natuurlijk is het formaat 'op maat gemaakt' voor SLC NOR Flash.
Het moet niet gebruikt worden met media met een hoge BER, bijvoorbeeld NAND of MLC NOR. (Bestaat die soort geheugen überhaupt te koop? Ik heb alleen vermeldingen gezien in werken over foutencorrectie)..
Bovendien moet het niet gebruikt worden met apparaten die hun eigen FTL hebben: USB flash, SD, MicroSD, etc. (Voor dat soort geheugen heb ik een formaat gemaakt met een paginagrootte van 512 bytes, een handtekening aan het begin van elke pagina en unieke recordnummers — soms kon ik met eenvoudig sequentieel lezen alle gegevens van een 'glitchy' flash-station herstellen)..
Afhankelijk van de taken kan het formaat zonder wijzigingen gebruikt worden op flash stations van 128Kbit (16Kb) tot 1Gbit (128Mb). Als je wilt, kan het ook op chips van grotere capaciteit gebruikt worden, maar dan moet de paginagrootte waarschijnlijk aangepast worden. (Maar hier rijst de vraag naar economische haalbaarheid, de prijs voor grote NOR Flash is niet bemoedigend)..
Als iemand het formaat interessant vindt en het wil gebruiken in een open project — laat het me weten, ik zal proberen tijd te vinden om de code op te schonen en op GitHub te publiceren.
Conclusie
Zoals we zien, blijkt het formaat uiteindelijk eenvoudig te zijn. en zelfs saai..
In het artikel is het moeilijk om de evolutie van mijn mening weer te geven, maar geloof me: aanvankelijk wilde ik iets geavanceerds, onoverwinnelijks creëren dat zou kunnen overleven, zelfs na een nucleaire explosie in de buurt. Echter, de rede (hoop ik) heeft uiteindelijk triomfantelijk gewonnen en geleidelijk zijn de prioriteiten verschoven naar eenvoud en compactheid.
Kan het zo zijn dat ik me vergis? Ja, natuurlijk. Het is heel goed mogelijk dat we bijvoorbeeld een partij niet-kwaliteit chips hebben ingekocht. Of om een andere reden voldoet de apparatuur niet aan de verwachtingen qua betrouwbaarheid.
Heb ik een plan voor dit geval? Ik denk dat je na het lezen van het artikel geen twijfels hebt dat er een plan is. En zelfs meerdere.
Serieuzer beschouwd, het formaat is tegelijkertijd ontwikkeld als een werkbare optie en als een 'proefballon'.
Op dit moment werkt alles goed op tafel, letterlijk binnen een paar dagen zal de oplossing uitgerold worden. (ongeveer) op honderden apparaten, laten we kijken wat het in 'echte' omstandigheden zal doen (tenzij, hopelijk, het formaat betrouwbaar fouten kan detecteren; zodat we volledige statistieken kunnen verzamelen). Over een paar maanden kunnen we conclusies trekken (en als we pech hebben - dan eerder).
Als er na gebruik ernstige problemen worden ontdekt en er aanpassingen nodig zijn, zal ik daar zeker over schrijven.
Literatuur
Ik wilde geen lange saaie lijst van gebruikte bronnen opstellen, tenslotte heeft iedereen Google.
Hier besloot ik een lijst van ontdekkingen achter te laten die mij bijzonder interessant leken, maar geleidelijk zijn ze in de tekst van het artikel terechtgekomen, en is er nog maar één punt in de lijst overgebleven:
- Hulpprogramma van de auteur zlib. Kan de inhoud van deflate/zlib/gzip archieven op een begrijpelijke manier weergeven. Als je moet snappen hoe het deflate (of gzip) formaat intern werkt, raad ik het ten zeerste aan.
Bron: habr.com
