

In dit artikel worden verschillende methoden besproken voor het bepalen van de wiskundige vergelijking van een eenvoudige (bivariate) regressielijn.
Alle hier besproken methoden voor het oplossen van de vergelijking zijn gebaseerd op de methode van de kleinste kwadraten. We zullen de methoden als volgt aanduiden:
- Analytische oplossing
- Gradiëntafdalingsmethode
- Stochastische gradient descent
Voor elke methode van het oplossen van de rechte vergelijking worden in het artikel verschillende functies gepresenteerd, die voornamelijk zijn verdeeld in diegenen die zijn geschreven zonder gebruik te maken van de bibliotheek NumPy en diegene die voor de berekeningen gebruikmaken van NumPy. Het wordt aangenomen dat een bekwaam gebruik van NumPy de kosten van de berekeningen zal verminderen.
De gehele code die in het artikel wordt gepresenteerd, is geschreven in de taal python 2.7 met behulp van Jupyter Notebook. De oorspronkelijke code en het bestand met de gegevens van de steekproef zijn geüpload naar
Het artikel is vooral gericht op zowel beginners als degenen die al een beetje de zeer uitgebreide sectie in kunstmatige intelligentie - machine learning - hebben begonnen te bestuderen.
Voor de illustratie van het materiaal gebruiken we een heel eenvoudig voorbeeld.
Voorwaarden van het voorbeeld
We hebben vijf waarden die de afhankelijkheid karakteriseren Y van X (Tabel nr. 1):
Tabel nr. 1 "Voorwaarden van het voorbeeld"
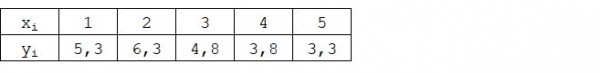
Laten we aannemen dat de waarden  de maand van het jaar zijn, en
 de omzet in die maand. Met andere woorden, de omzet hangt af van de maand van het jaar, en
 is de enige eigenschap waar de omzet van afhankelijk is.
Het voorbeeld is niet zo geweldig, zowel vanuit het perspectief van de hypothetische afhankelijkheid van de omzet van de maand van het jaar, als vanuit het perspectief van het aantal waarden - het is erg klein. Echter, deze vereenvoudiging maakt het mogelijk om, in eenvoudige bewoordingen, te verklaren, dat het materiaal niet altijd gemakkelijk te begrijpen is voor beginners. Bovendien zal de eenvoud van de cijfers het mogelijk maken voor degenen die willen om het voorbeeld op 'papier' op te lossen zonder aanzienlijke inspanning.
Laten we aannemen dat de in het voorbeeld genoemde afhankelijkheid redelijk goed kan worden benaderd door een wiskundige vergelijking van een eenvoudige (bivariate) regressielijn van de vorm:

waar  - dat is de maand waarin de omzet werd behaald,
 - de omzet die overeenkomt met de maand,
 en
 - de regressiecoëfficiënten van de geschatte lijn.
Opmerking: de coëfficiënt  wordt vaak de helling of gradient van de geschatte lijn genoemd; het is de waarde waarmee
 verandert bij een verandering van
 .
Het is duidelijk dat onze taak in het voorbeeld is om in de vergelijking zulke coëfficiënten te selecteren.  en
 , waarbij de afwijkingen van onze berekende omzetwaarden per maand ten opzichte van de werkelijke antwoorden, dat wil zeggen de waarden die in de steekproef zijn gepresenteerd, minimaal zullen zijn.
De methode van de kleinste kwadraten
Volgens de methode van de kleinste kwadraten moet de afwijking worden berekend door deze in het kwadraat te verheffen. Deze techniek voorkomt dat afwijkingen elkaar opheffen wanneer ze tegengestelde tekens hebben. Bijvoorbeeld, als in het ene geval de afwijking bedraagt +5 (plus vijf), en in het andere -5 (min vijf), dan zal de som van de afwijkingen elkaar opheffen en gelijk zijn aan 0 (nul). Het is ook mogelijk om de afwijking niet in het kwadraat te verheffen, maar gebruik te maken van de eigenschap van de modulus, waardoor alle afwijkingen positief zijn en zich ophopen. We zullen hier niet verder op ingaan, maar geven gewoon aan dat het voor de berekeningen gebruikelijk is om de afwijking in het kwadraat te verheffen.
Zo ziet de formule eruit die we gebruiken om de kleinste som van de kwadraten van de afwijkingen (fouten) te bepalen:

waar  — dit is de functie die de ware antwoorden benadert (dat wil zeggen, de door ons berekende omzet),
 — dit zijn de werkelijke antwoorden (de in de steekproef verstrekte omzet),
 — dit is de steekproefindex (het maandnummer waarop de afwijking wordt bepaald)
Laten we de functie differentiëren, de vergelijkingen van de partiële afgeleiden bepalen en klaar zijn om over te schakelen naar de analytische oplossing. Maar laten we eerst een kleine excursie maken naar wat differentiëren precies is en de geometrische betekenis van de afgeleide in herinnering roepen.
Differentiëren
Differentiëren is de operatie waarbij de afgeleide van een functie wordt gevonden.
Waarvoor is de afgeleide nodig? De afgeleide van een functie geeft de snelheid van de verandering van de functie aan en wijst ons de richting aan. Als de afgeleide op een bepaald punt positief is, dan groeit de functie, anders neemt de functie af. Hoe groter de waarde van de afgeleide in absolute termen, hoe hoger de snelheid van de verandering van de functiewaarden en hoe steiler de helling van de grafiek van de functie.
Bijvoorbeeld, in een cartesisch coördinatensysteem geeft de waarde van de afgeleide op punt M(0,0) die gelijk is aan +25 aan dat, in het gegeven punt, bij een verschuiving van de waarde  naar rechts met één eenheid, de waarde
 met 25 eenheden toeneemt. Op de grafiek ziet dit eruit als een vrij steile stijging van de waarden
 vanaf het gegeven punt.
Een ander voorbeeld. De waarde van de afgeleide is gelijk aan -0,1 wat betekent dat bij een verschuiving  van één eenheidswaarde, de waarde
 slechts met 0,1 eenheidswaarde afneemt. Op de grafiek van de functie kunnen we een nauwelijks merkbare helling naar beneden waarnemen. Vergelijkend met een berg, dalen we erg langzaam af over een zachte helling van de berg, in tegenstelling tot het vorige voorbeeld waar we steile toppen moesten beklimmen :)
Dus, door de functie te differentiëren  voor de coëfficiënten
 en
 , bepalen we de vergelijkingen van de partiële afgeleiden van de 1e orde. Na het vaststellen van deze vergelijkingen, krijgen we een systeem van twee vergelijkingen, dat, wanneer we het oplossen, ons in staat stelt om waarden van coëfficiënten te vinden
 en
 , waarbij de waarden van de bijbehorende afgeleiden op de gegeven punten veranderen met een zeer klein bedrag, en in het geval van analytische oplossingen helemaal niet veranderen. Met andere woorden, de foutfunctie bij de gevonden coëfficiënten zal een minimum bereiken, omdat de waarden van de partiële afgeleiden op deze punten gelijk zullen zijn aan nul.
Dus, volgens de regels van differentiatie is de vergelijking van de partiële afgeleide van de 1e orde met betrekking tot de coëfficiënt  zal de volgende vorm aannemen:

de vergelijking van de partiële afgeleide van de 1e orde met betrekking tot  zal de volgende vorm aannemen:

Uiteindelijk hebben we een systeem van vergelijkingen gekregen dat een vrij eenvoudige analytische oplossing heeft:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
eind{cases}
eind{equation*}
Voordat we de vergelijking oplossen, laden we eerst de gegevens, controleren we de juistheid van de laadt en formatteren we de gegevens.
Gegevens laden en formatteren
Het is belangrijk op te merken dat, aangezien we voor de analytische oplossing, en later voor gradient- en stochastische gradientafdalingen, code in twee varianten zullen toepassen: met en zonder gebruik van de bibliotheek NumPy en zonder deze bibliotheek, we de juiste formattering van de gegevens nodig hebben (zie code).
Code voor het laden en verwerken van gegevens
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Visualisatie
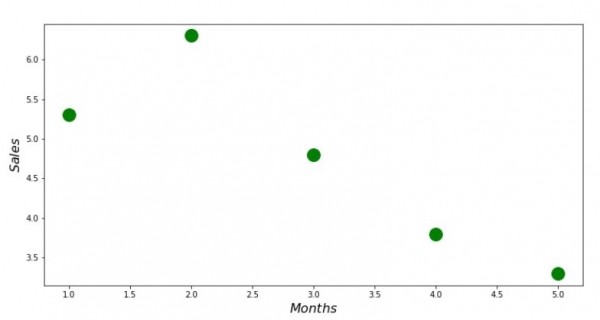
Nu, nadat we, ten eerste, de gegevens hebben geladen, ten tweede, de juistheid van de laadt hebben gecontroleerd en ten slotte de gegevens hebben geformatteerd, zullen we de eerste visualisatie uitvoeren. Vaak wordt hiervoor de methode pairplot bibliotheek Seaborn. In ons voorbeeld, gezien het beperkte aantal cijfers, is het niet zinvol om de bibliotheek te gebruiken Seaborn. We zullen de reguliere bibliotheek gebruiken Matplotlib en alleen naar de spreidingsdiagram kijken.
Code voor de spreidingsdiagram
print 'Grafiek №1 "Afhankelijkheid van de omzet per maand van het jaar"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Maanden$', size=16)
plt.ylabel('$Verkopen$', size=16)
plt.show()
Grafiek №1 «Afhankelijkheid van de omzet per maand van het jaar»
Analytische oplossing
Laten we de meest gebruikelijke hulpmiddelen gebruiken in python en we lossen het systeem van vergelijkingen op:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
eind{cases}
eind{equation*}
Volgens de regel van Cramer vinden we de algemene determinant, evenals de determinanten van  en van
 , waarna we de determinant van
 delen door de algemene determinant — we vinden de coëfficiënt
 , op dezelfde manier vinden we de coëfficiënt
 .
De code voor de analytische oplossing
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Dit hebben we gekregen:
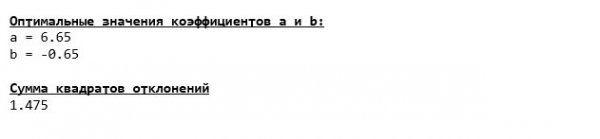
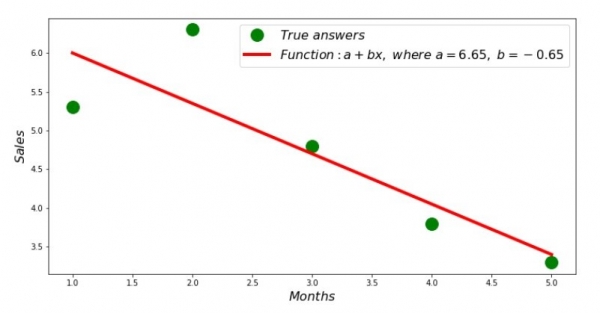
Dus, de waarden van de coëfficiënten zijn gevonden, de som van de kwadraten van de afwijkingen is vastgesteld. Laten we een rechte lijn tekenen in de spreidingshistogram in overeenstemming met de gevonden coëfficiënten.
De code voor de regressielijn
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Grafiek №2 «Juist en berekende antwoorden»
We kunnen de grafiek van afwijkingen voor elke maand bekijken. In ons geval halen we hier geen significante praktische waarde uit, maar we zullen onze nieuwsgierigheid bevredigen over hoe goed de vergelijking van eenvoudige lineaire regressie de afhankelijkheid van de omzet per maand van het jaar beschrijft.
De code voor de grafiek van afwijkingen
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Grafiek №3 «Afwijkingen, %»
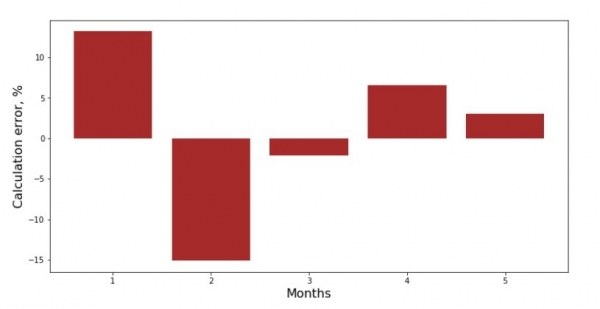
Niet perfect, maar we hebben onze taak volbracht.
Laten we een functie schrijven die de coëfficiënten bepaalt  en
 gebruik de bibliotheek NumPy, specifieker — we schrijven twee functies: één met gebruik van de pseudo-inverse matrix (niet aanbevolen in de praktijk, omdat het rekenkundig complex en onstabiel is), de andere met gebruik van de matrixvergelijking.
De code voor de analytische oplossing (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Laten we de tijd vergelijken die is besteed aan het bepalen van de coëfficiënten  en
 , volgens de 3 gepresenteerde methoden.
De code voor het berekenen van de rekentijd
print ' 33[1m' + ' 33[4m' + "Tijd nodig voor het berekenen van de coëfficiënten zonder gebruik van de NumPy bibliotheek:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tijd nodig voor het berekenen van de coëfficiënten met gebruik van de pseudo-inverse matrix:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tijd nodig voor het berekenen van de coëfficiënten met gebruik van de matrixvergelijking:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)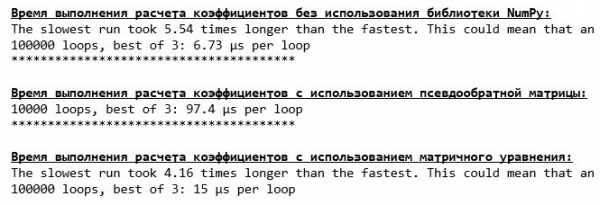
Bij een klein aantal gegevens, komt de ‘zelfgeschreven’ functie die de coëfficiënten met de methode van Cramer vindt, als beste uit de bus.
Nu kunnen we overgaan naar andere manieren om de coëfficiënten te vinden.  en
 .
Gradiëntafdalingsmethode
Laten we eerst definiëren wat een gradient is. Simpel gezegd is een gradient een segment dat de richting van de maximale stijging van een functie aangeeft. Vergeleken met een berg betekent het dat waar de gradient naar wijst, de steilste klim naar de top van de berg is. Als we het voorbeeld van de berg verder uitwerken, realiseren we ons dat we eigenlijk de steilste afdaling nodig hebben om zo snel mogelijk naar beneden te komen, dat wil zeggen het minimum — de plek waar de functie niet stijgt en niet daalt. Op dit punt is de afgeleide gelijk aan nul. Daarom hebben we geen gradient nodig, maar een antigradient. Om de antigradient te vinden, hoeven we de gradient alleen maar te vermenigvuldigen met -1 (min één).
Laten we opmerken dat een functie meerdere minima kan hebben, en als we volgens het hierna voorgestelde algoritme in een van deze minima afdalen, we mogelijk een ander minimum niet kunnen vinden dat lager ligt dan het gevonden minimum. Maak je geen zorgen, dat is ons niet overkomen! In ons geval hebben we te maken met een enkel minimum, omdat onze functie  op de grafiek een gewone parabol is. En zoals we allemaal goed weten uit de wiskundelessen op school — heeft een parabool slechts één minimum.
Nadat we hebben vastgesteld waarvoor we de gradient nodig hebben, en dat de gradient een segment is, dat wil zeggen een vector met gegeven coördinaten, die precies de genoemde coëfficiënten zijn,  en
 kunnen we gradient descent implementeren.
Voordat we beginnen, laten we enkele zinnen over het descent-algoritme lezen:
- We bepalen op pseudo-willekeurige wijze de coördinaten van de coëfficiënten
 en . In ons voorbeeld gaan we de coëfficiënten rondom nul bepalen. Dit is een veelgebruikte praktijk, maar voor elke situatie kan een eigen praktijk worden overwogen.
- Van de coördinaat trekken we de waarde van de eerste-orde partiële afgeleide op het punt . Dus, als de afgeleide positief is, dan stijgt de functie. Door de waarde van de afgeleide af te trekken, bewegen we ons in de tegenovergestelde richting van de groei, dat wil zeggen in de richting van de afdaling. Als de afgeleide negatief is, dan daalt de functie op dat punt en door de waarde van de afgeleide af te trekken, bewegen we ons in de richting van de afdaling.
- We voeren een soortgelijke operatie uit met de coördinaat : we trekken de waarde van de partiële afgeleide op het punt af. .
- Om te voorkomen dat we de minimumwaarde overslaan en in de verre ruimte terechtkomen, moet de stapgrootte in de afdaalrichting worden vastgesteld. Over het algemeen zou men een compleet artikel kunnen schrijven over hoe je de stapgrootte het beste kunt instellen en deze kunt aanpassen tijdens de afdaling om de rekenkosten te verlagen. Maar nu hebben we een iets andere taak voor ons, en door middel van de wetenschappelijke methode van 'prikken' of zoals men in de volksmond zegt, op empirische wijze, gaan we de stapgrootte vaststellen.
- Nadat we de gegeven coördinaten en de waarden van de afgeleiden hebben afgetrokken, krijgen we nieuwe coördinaten en . We maken de volgende stap (aftrekken), uit de reeds berekende coördinaten. En zo begint de cyclus weer, totdat de vereiste convergentie is bereikt.
 en
 . In ons voorbeeld gaan we de coëfficiënten rondom nul bepalen. Dit is een veelgebruikte praktijk, maar voor elke situatie kan een eigen praktijk worden overwogen.
 trekken we de waarde van de eerste-orde partiële afgeleide op het punt
 . Dus, als de afgeleide positief is, dan stijgt de functie. Door de waarde van de afgeleide af te trekken, bewegen we ons in de tegenovergestelde richting van de groei, dat wil zeggen in de richting van de afdaling. Als de afgeleide negatief is, dan daalt de functie op dat punt en door de waarde van de afgeleide af te trekken, bewegen we ons in de richting van de afdaling.
 : we trekken de waarde van de partiële afgeleide op het punt af.
 .
 en
 de waarden van de afgeleiden hebben afgetrokken, krijgen we nieuwe coördinaten
 en
 . We maken de volgende stap (aftrekken), uit de reeds berekende coördinaten. En zo begint de cyclus weer, totdat de vereiste convergentie is bereikt.
Dat is het! Nu zijn we klaar om op zoek te gaan naar de diepste kloof van de Marianentrog. Laten we beginnen.
Code voor gradient descent
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print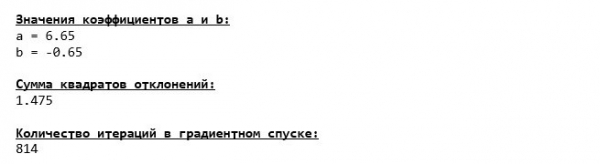
We zijn op de bodem van de Marianentrog afgedaald en hebben daar dezelfde waarden van de coëfficiënten vastgesteld  en
 , zoals eigenlijk was te verwachten.
Laten we nog een duik nemen, maar deze keer zullen de technologieën in onze diepzeeverkenner anders zijn, met name de bibliotheek NumPy.
Code voor gradient descent (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print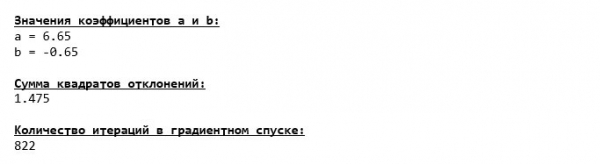
Waarden van de coëfficiënten  en
 blijven onveranderd.
Laten we kijken naar hoe de fout veranderde tijdens de gradient descent, dat wil zeggen hoe de som van de kwadraten van de afwijkingen met elke stap veranderde.
Code voor de grafiek van de som van de kwadraten van de afwijkingen
print 'Grafiek№4 "Som van de kwadraten van de afwijkingen per stap"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Stappen (Iteratie)', size=16)
plt.ylabel('Som van de kwadraten van de afwijkingen', size=16)
plt.show()
Grafiek №4 'Som van de kwadraten van de afwijkingen tijdens gradient descent'
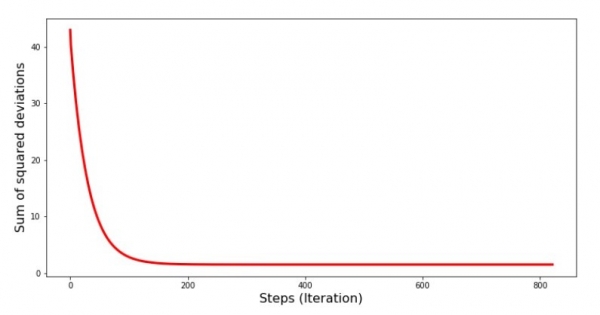
Op de grafiek zien we dat de fout met elke stap afneemt, en na een aantal iteraties zien we een bijna horizontale lijn.
Laten we ten slotte het verschil in de uitvoeringstijd van de code beoordelen:
Code voor het bepalen van de rekentijd van de gradient descent
print ' 33[1m' + ' 33[4m' + "Tijd voor de uitvoering van gradient descent zonder gebruik van de NumPy-bibliotheek:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Tijd voor de uitvoering van gradient descent met gebruik van de NumPy-bibliotheek:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)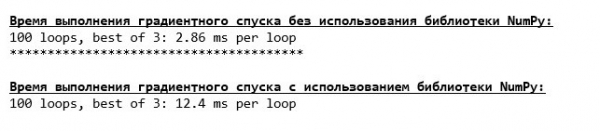
Misschien doen we iets verkeerd, maar opnieuw overtreft een eenvoudige "zelfgeschreven" functie die geen bibliotheek gebruikt de functie die een bibliotheek gebruikt in uitvoeringstijd. NumPy Maar we staan niet stil en bewegen in de richting van het bestuderen van nog een fascinerende manier om de vergelijking van een eenvoudige lineaire regressie op te lossen. Maak kennis! NumPy.
Om het principe van stochastic gradient descent beter te begrijpen, is het beter om de verschillen met gewone gradient descent te definiëren. In het geval van gradient descent hebben we in de afgeleide vergelijkingen
Stochastische gradient descent
de sommen van de waarden van alle kenmerken en de werkelijke antwoorden in de dataset gebruikt (dat wil zeggen, de sommen van al die waarden).  en
 Bij stochastic gradient descent zullen we niet alle waarden in de dataset gebruiken, maar in plaats daarvan zullen we pseudo-willekeurig een zogenaamde sample-index kiezen en diens waarden gebruiken.
 en
 Bijvoorbeeld, als de index is gedefinieerd als nummer 3 (drie), dan nemen we de waarden
, vervolgens plaatsen we de waarden in de afgeleide vergelijkingen en bepalen we nieuwe coördinaten. Vervolgens, nadat we de coördinaten hebben bepaald, bepalen we opnieuw pseudo-willekeurig de sample-index, plaatsen we de waarden die bij die index horen in de vergelijkingen van de partiele afgeleiden, en bepalen we opnieuw de coördinaten  en
 enzovoorts tot we convergence bereiken. Op het eerste gezicht lijkt het misschien onmogelijk hoe dit überhaupt kan werken, maar het werkt. Het is wel belangrijk op te merken dat de fout niet bij elke stap afneemt, maar er is zeker een trend.
 en
 Wat zijn de voordelen van stochastic gradient descent ten opzichte van gewone? In het geval dat onze dataset erg groot is en uit tienduizenden waarden bestaat, is het aanzienlijk eenvoudiger om bijvoorbeeld een willekeurige duizend daarvan te verwerken dan de hele dataset. In dat geval wordt stochastic gradient descent opgestart. In ons geval zullen we natuurlijk niet veel verschil merken.
Laten we de code bekijken.
Code voor stochastic gradient descent.
Laten we goed kijken naar de coëfficiënten en onszelf de vraag stellen: "Hoe kan dit?". We hebben andere waarden voor de coëfficiënten gekregen.
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])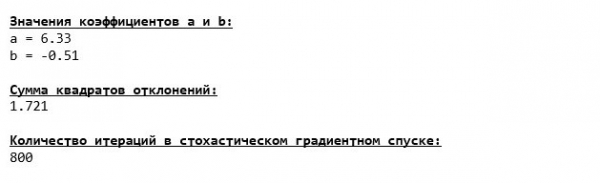
We kijken aandachtig naar de coëfficiënten en vragen ons af: "Hoe kan dat?". We hebben andere waarden voor de coëfficiënten gekregen.  en
 Heeft de stochastische gradient descent misschien optimalere parameters voor de vergelijking gevonden? Helaas niet. Het is genoeg om naar de som van de kwadraten van de afwijkingen te kijken en te zien dat de fout bij de nieuwe waarde van de coëfficiënten groter is. We moeten niet wanhopen. Laten we de fout in de loop van de tijd in een grafiek weergeven.
Code voor de grafiek van de som van de kwadraten van de afwijkingen bij stochastische gradient descent
print 'Grafiek №5 "Som van de kwadraten van de afwijkingen stap voor stap"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Stappen (Iteratie)', size=16)
plt.ylabel('Som van de kwadraten van de afwijkingen', size=16)
plt.show()
Grafiek №5 «Som van de kwadraten van de afwijkingen bij stochastische gradient descent»
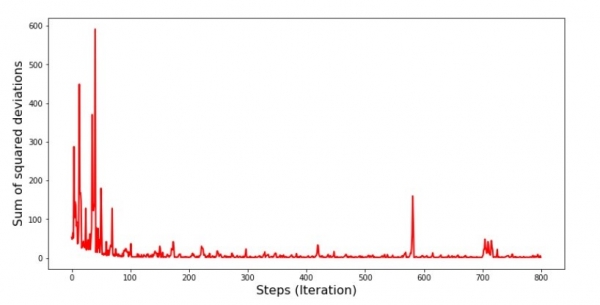
Wanneer we naar de grafiek kijken, wordt alles duidelijk en nu zullen we het corrigeren.
Wat is er gebeurd? Het volgende is gebeurd. Wanneer we willekeurig een maand kiezen, probeert ons algoritme de fout in de berekening van de omzet voor die specifieke maand te verminderen. Vervolgens kiezen we een andere maand en herhalen we de berekening, maar we verminderen de fout nu voor de tweede gekozen maand. En laten we niet vergeten dat de eerste twee maanden aanzienlijk afwijken van de lijn van de eenvoudige lineaire regressievergelijking. Dit betekent dat wanneer een van deze twee maanden werd gekozen, het algoritme de fout van elke maand vermindert, maar tegelijkertijd de fout in de gehele steekproef aanzienlijk vergroot. Wat moeten we doen? Het antwoord is eenvoudig: we moeten de afdaalstap verkleinen. Door de afdaalstap te verkleinen, zal de fout ook stoppen met 'huppelen' naar boven en naar beneden. Natuurlijk zal de fout blijven 'huppelen', maar het zal niet zo snel gebeuren:) Laten we het controleren.
Code om SGD met een kleinere stap in te stellen
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()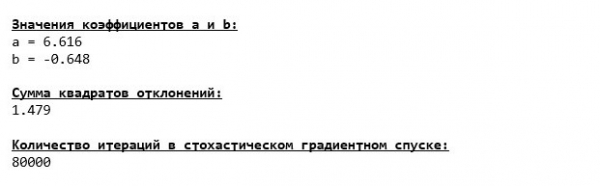
Grafiek №6 «Som van de kwadraten van de afwijkingen bij stochastische gradient descent (80.000 stappen)»
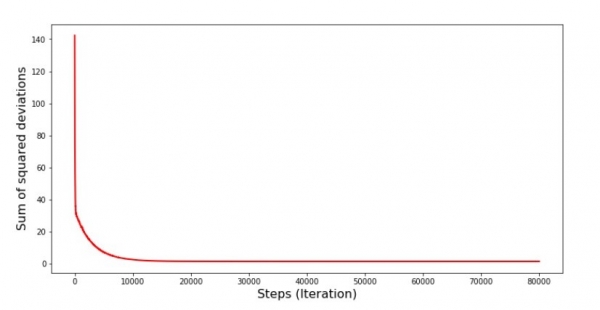
De waarden van de coëfficiënten zijn verbeterd, maar zijn nog steeds niet perfect. Hypothetisch gezien kunnen we dit als volgt corrigeren. We kiezen bijvoorbeeld de waarden van de coëfficiënten uit de laatste 1000 iteraties waarbij de minst gemaakte fout was. Echter, hiervoor moeten we ook de waarden van de coëfficiënten registreren. We zullen dit niet doen, maar zullen beter naar de grafiek kijken. Deze ziet er glad uit, en de fout lijkt gelijkmatig af te nemen. In werkelijkheid is dit niet waar. Laten we de eerste 1000 iteraties bekijken en ze vergelijken met de laatste.
Code voor de grafiek van SGD (eerste 1000 stappen)
print 'Grafiek №7 "Som van kwadraten van afwijkingen stap voor stap. Eerste 1000 iteraties"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Stappen (Iteratie)', size=16)
plt.ylabel('Som van kwadraten van afwijkingen', size=16)
plt.show()

print 'Grafiek №7 "Som van kwadraten van afwijkingen stap voor stap. Laatste 1000 iteraties"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Stappen (Iteratie)', size=16)
plt.ylabel('Som van kwadraten van afwijkingen', size=16)
plt.show()
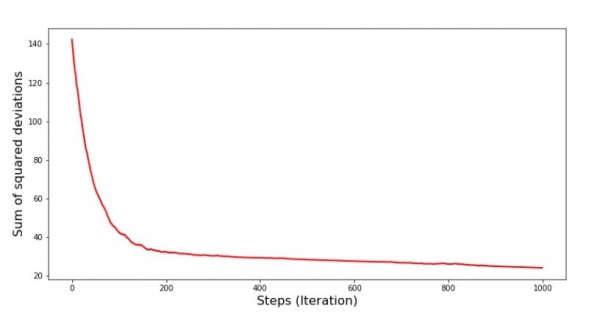
Grafiek №7 «Som van kwadraten van afwijkingen SGD (eerste 1000 stappen)»
Grafiek №8 «Som van kwadraten van afwijkingen SGD (laatste 1000 stappen)»
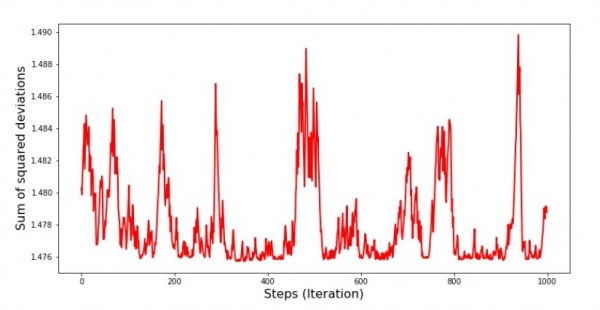
In het begin van de afdaling zien we een vrij uniforme en steile afname van de fout. In de laatste iteraties zien we dat de fout rond het waarde van 1,475 schommelt en op bepaalde momenten zelfs dit optimale waarde bereikt, maar daarna weer omhoog gaat… Ik herhaal, we kunnen de waarden van de coëfficiënten opschrijven,  en
 , en dan degene selecteren waarbij de fout minimaal is. Echter, we hebben een serieuzer probleem: we moesten 80 duizend stappen doen (zie code) om waarden te krijgen die dicht bij optimaal zijn. En dat staat al haaks op het idee van tijdsbesparing bij berekeningen met stochastische gradient afdaling vergeleken met de gradient afdaling. Wat kunnen we verbeteren? Het is niet moeilijk op te merken dat we in de eerste iteraties zeker naar beneden gaan en dus zouden we grote stappen aan het begin moeten houden en deze in de loop van de tijd moeten verkleinen. We gaan dit niet in dit artikel doen - het is al lang genoeg. Geïnteresseerden kunnen zelf nadenken over hoe dit te doen, het is niet moeilijk 🙂
Laten we nu de stochastische gradient afdaling uitvoeren met behulp van de bibliotheek NumPy (en we zullen niet struikelen over de stenen die we eerder hebben ontdekt)
Code voor stochastische gradient afdaling (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print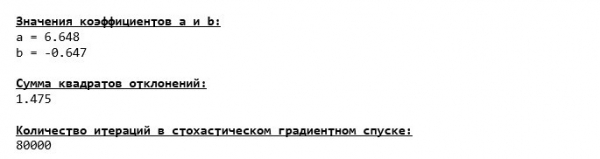
De waarden bleken vrijwel dezelfde te zijn als bij de afdaling zonder gebruik te maken van NumPy. Logisch overigens.
Laten we uitzoeken hoe lang de stochastische gradient afdaling heeft geduurd.
Code voor het bepalen van de rekentijd van SGD (80 duizend stappen)
print ' 33[1m' + ' 33[4m' +
"De uitvoeringstijd van stochastische gradient descent zonder gebruik van de NumPy-bibliotheek:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"De uitvoeringstijd van stochastische gradient descent met gebruik van de NumPy-bibliotheek:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)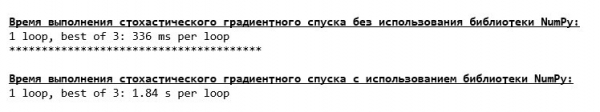
Hoe dieper in het bos, hoe donkerder de wolken: opnieuw toont de 'zelfgeschreven' formule het beste resultaat. Dit doet ons nadenken over de mogelijkheid dat er nog fijnere manieren zijn om de bibliotheek te gebruiken. NumPy, die daadwerkelijk de rekenoperaties versnellen. In dit artikel zullen we daar echter niet achter komen. Dat vormt voer voor gedachten in onze vrije tijd :)
Samenvatting
Voor we samenvatten, zou ik graag de vraag willen beantwoorden die waarschijnlijk is opgekomen bij onze gewaardeerde lezer. Waarom al deze 'kwellingen' met dalingen, waarom moeten we de berg op en af (voornamelijk af), om de felbegeerde laagte te vinden, terwijl we zo'n krachtig en eenvoudig instrument hebben in de vorm van een analytische oplossing, die ons onmiddellijk naar de juiste plaats teleporteert?
Het antwoord op deze vraag ligt voor de hand. Op dit moment hebben we een zeer eenvoudig voorbeeld besproken, waarin het echte antwoord  afhangt van één kenmerk
 . In het leven kom je dit niet vaak tegen, dus laten we ons voorstellen dat we 2, 30, 50 of meer kenmerken hebben. Daarbij voegen we duizenden, zo niet tienduizenden waarden voor elk kenmerk toe. In dit geval kan de analytische oplossing niet voldoen en falen. Aan de andere kant zal gradient descent en zijn varianten ons langzaam maar zeker dichter bij het doel brengen — het minimum van de functie. Maak je geen zorgen over de snelheid — we zullen zeker nog methoden onderzoeken die ons in staat stellen de stapgrootte (dwz snelheid) in te stellen en te regelen.
En nu, de korte samenvatting.
Ten eerste hoop ik dat het materiaal in het artikel beginnende 'data scientists' helpt om te begrijpen hoe ze vergelijkingen van eenvoudige (en niet alleen) lineaire regressie kunnen oplossen.
Ten tweede hebben we verschillende manieren besproken om de vergelijking op te lossen. Nu kunnen we, afhankelijk van de situatie, degene kiezen die het meest geschikt is voor de gesteld taak.
Ten derde hebben we de kracht van aanvullende instellingen gezien, met name de stapgrootte van de gradient descent. Deze parameter mag niet worden verwaarloosd. Zoals eerder opgemerkt, is het verstandiger om de stapgrootte tijdens de afdaling aan te passen om de rekentijd te verminderen.
Ten vierde hebben in ons geval de 'handgeschreven' functies de beste rekentijdresultaten laten zien. Dit komt waarschijnlijk doordat de mogelijkheden van de bibliotheek niet optimaal zijn benut. NumPy. Hoe dan ook, de conclusie dringt zich op. Enerzijds is het soms goed om gevestigde meningen ter discussie te stellen, maar anderzijds hoeft niet alles complex te zijn - soms blijkt een eenvoudigere aanpak efficiënter te zijn. Aangezien ons doel was om drie benaderingen voor de oplossing van de lineaire regressievergelijking te bespreken, was het gebruik van 'handgeschreven' functies voor ons voldoende.
Literatuur (of iets dergelijks)
1. Lineaire regressie
2. Methode van de kleinste kwadraten
3. Afgeleide
4. Gradient
5. Gradient descent
6. NumPy-bibliotheek
Bron: habr.com
