

In de uitoefening van zijn werk komt een ontwikkelaar vaak situaties tegen waarin hij een query schrijft en denkt: "de database is slim, die lost alles zelf op!"«
In sommige gevallen (deels door onwetendheid over de mogelijkheden van de database, deels door voortijdige optimalisaties) leidt deze aanpak tot de creatie van "frankensteins".
Laat me eerst een voorbeeld van zo'n query geven:
-- voor elk sleutelpaar zoeken we de bijbehorende veldwaarden
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- vinden min/max waarden voor elke eerste sleutel
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- koppelen op de eerste sleutel van sleutelparen en min/max-waarden
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Om de kwaliteit van de query concreet te beoordelen, laten we een willekeurige dataset aanmaken:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
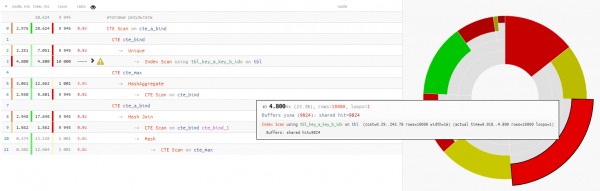
Blijkbaar heeft het zelf lezen van gegevens minder dan een kwart van de totale verwerkingstijd in beslag genomen voor het uitvoeren van de query:
Laten we het stap voor stap analyseren
Laten we nader naar de query kijken en ons afvragen:
- Waarom hier WITH RECURSIVE, wanneer er geen recursieve CTE is?
- Waarom min/max-waarden in een aparte CTE groeperen, als ze later toch aan de originele selectie worden gekoppeld?
+25% tijd - Waarom aan het eind een herhaalde selectie uit de vorige CTE gebruiken via een onvoorwaardelijke ‘SELECT * FROM’?
+14% tijd
In dit geval hadden we nog veel geluk dat er een Hash Join werd gekozen voor de verbinding, in plaats van een Nested Loop, want dan zouden we niet één enkele doorloop van de CTE Scan hebben gekregen, maar 10K!
even over CTE ScanHet is belangrijk te herinneren dat CTE Scan het equivalent is van Seq Scan dat wil zeggen, zonder enige indexering, alleen een volledige doorloop, wat zou vereisen 10K x 0.3ms = 3000ms bij doorlopen van cte_max of 1K x 1.5ms = 1500ms bij doorlopen van cte_bind!
Eigenlijk, wat wilden we in het resultaat bereiken? Ah, meestal is dat precies de vraag die opkomt rond de 5de minuut van het analyseren van "drie-laags" queries.
We wilden voor elk uniek sleutelpaar min/max uit de groep per key_a.
Dus laten we hiervoor :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 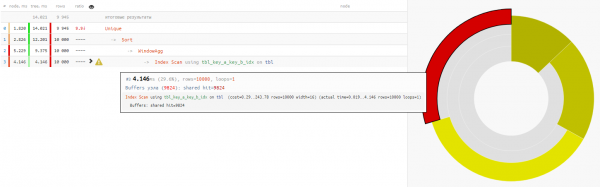
Aangezien het lezen van gegevens in beide gevallen ongeveer 4-5 ms duurt, is onze tijdwinst -32% — dit is puur de belasting die van de CPU van de database is gehaald, als zo'n verzoek vaak genoeg wordt uitgevoerd.
Over het algemeen moet je de database niet dwingen om "ronde te dragen, vierkante rollen".
Bron: habr.com
