

Opmerking vertaler.: Service mesh — een fenomeen dat nog geen vaste vertaling in het Nederlands heeft (meer dan 2 jaar geleden stelden we de term 'service netwerk' voor, en enige tijd later begonnen sommige collega's actief de combinatie 'service zeef' te promoten). Voortdurende gesprekken over deze technologie hebben geleid tot een situatie waarin de marketing- en technische onderdelen te intens met elkaar zijn verstrengeld. Dit geweldige materiaal van een van de auteurs van de originele term is bedoeld om duidelijkheid te scheppen voor ingenieurs en anderen.
Stripverhaal van
Inleiding
Als je een software-engineer bent die ergens in de buurt van backendsystemen werkt, is de term 'service mesh' waarschijnlijk al geruime tijd goed in je bewustzijn verankerd. Door een vreemde speling van het lot, grijpt deze uitdrukking de sector steeds meer, terwijl de hype en de bijbehorende reclame-aanbiedingen zich ophopen als een sneeuwbal die een helling afrolt en geen tekenen van vertraging vertoont.
Service mesh is ontstaan in de troebele, tendentieuze wateren van het cloud native-ecosysteem. Helaas betekent dit dat een aanzienlijk deel van de bijbehorende discussie varieert van 'laagcalorische prietpraat' tot — als we een technische term gebruiken — openlijke onzin. Maar als we al het lawaai eruit filteren, ontdekken we dat service mesh een heel reële, specifieke en belangrijke functie heeft.
In deze publicatie zal ik precies dat proberen te doen: een eerlijk, diepgaand, ingenieurgericht overzicht van service mesh presenteren. Ik ga niet alleen de vraag beantwoorden: ‘Wat is het?’, — maar ook ‘Waarom?’, evenals ‘Waarom nu?’. Tot slot zal ik proberen te schetsen waarom (naar mijn mening) deze specifieke technologie zo'n waanzinnige hype heeft veroorzaakt, wat op zichzelf al een interessant verhaal is.
Wie ben ik?
Hallo allemaal! Mijn naam is . Ik ben een van de oprichters van — het allereerste service mesh-project en het project dat verantwoordelijk is voor de komst van de term service mesh in de eerste plaats (sorry, jongens!). (Bijvoorbeeld.: Trouwens, aan het begin van deze term, meer dan 2,5 jaar geleden, vertaalden we al eerder materiaal van dezelfde auteur met de titel '».) Ik leid ook — een startup die zulke geweldige service mesh-dingen maakt als Linkerd en .
Je kunt je waarschijnlijk voorstellen dat ik een tamelijk partijdig en subjectief oordeel over deze kwestie heb. Toch zal ik proberen de tendentieusheid tot een minimum te beperken (met uitzondering van één sectie: „Waarom is er zoveel te doen over service mesh?”, — waarin ik toch mijn bevooroordeelde ideeën zal delen). Ook zal ik mijn best doen om deze gids zo objectief mogelijk te maken. Bij specifieke voorbeelden zal ik voornamelijk vertrouwen op de ervaring met Linkerd, terwijl ik bekende verschillen (indien aanwezig) in de implementatie van andere soorten service mesh zal aangeven.
Oké, het is tijd om naar de leuke dingen te gaan.
Wat is een service mesh?
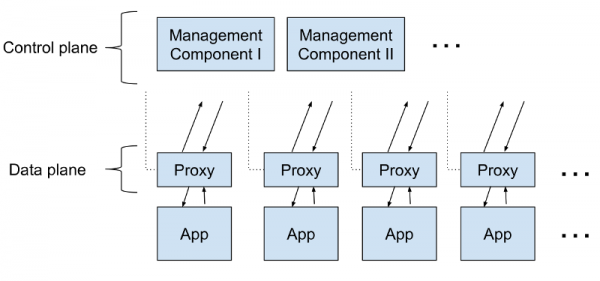
Ondanks al de hype is een service mesh structureel vrij eenvoudig. Het is gewoon een hoop userspace-proxy's, die „naast” de services staan (daar komen we later nog op terug wat „naast” betekent), plus een set van beheersprocessen. Samen worden deze proxies de data planegenoemd, terwijl de beheersprocessen worden aangeduid als control plane. De data plane onderschept oproepen tussen services en doet er „van alles mee”; de control plane coördineert dus het gedrag van de proxies en biedt jou, d.w.z. de operator, toegang tot de API, zodat je het netwerk kunt manipuleren en als een geheel kunt meten.
Wat voor proxies zijn dit? Dit zijn TCP-proxy's van de „Layer 7-aware” categorie (d.w.z. „rekening houdend met” de 7e laag van het OSI-model) zoals HAProxy en NGINX. Je kunt een proxy kiezen die je bevalt; Linkerd gebruikt een proxy geschreven in Rust, eenvoudigweg genaamd . We hebben het speciaal voor service mesh ontwikkeld. Andere mesh'en geven de voorkeur aan andere proxies (Envoy is een veel voorkomende keuze). Maar de keuze van de proxy is slechts een kwestie van implementatie.
Wat doen deze proxyservers? Het is duidelijk dat ze oproepen naar services en van services proxeren (strikt genomen vervullen ze de functie van zowel proxy als reverse proxy, door zowel binnenkomende als uitgaande oproepen te verwerken). En ze implementeren een set functies die zich richt op oproepen tussen services. Deze focus op verkeer tussen services maakt service mesh-proxy's anders dan bijvoorbeeld API-gateways of ingress-proxy's (laatstgenoemden richten zich op oproepen die vanuit de externe wereld naar de cluster komen). (Opmerking vertaler.: voor een vergelijking van bestaande Ingress-controllers voor Kubernetes, waarvan er veel de eerder genoemde Envoy gebruiken, zie .)
Dus, we hebben het data plane begrepen. Het control plane is eenvoudiger: het is een set componenten die alle mechanica waarborgen die nodig is voor het data plane om gecoördineerd te functioneren, inclusief service discovery, TLS-certificaatuitgifte, aggregatie van metrics, enzovoort. Het data plane informeert het control plane over zijn gedrag; op zijn beurt biedt het control plane een API waarmee het gedrag van het data plane als een geheel kan worden gewijzigd en gevolgd.
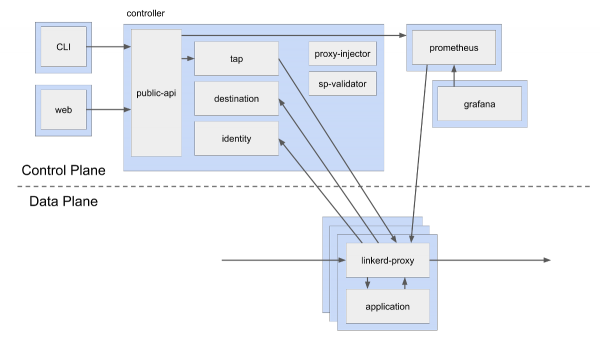
Hieronder staat een diagram van het control plane en het data plane in Linkerd. Zoals te zien is, omvat het control plane verschillende componenten, waaronder een Prometheus-instantie die metrics verzamelt van de proxyservers, evenals andere componenten zoals destination (service discovery), identity (certificatacentrum, CA) en public-api (endpoints voor web en CLI). In tegenstelling tot dit, is het data plane een eenvoudige linkerd-proxy naast de applicatie-instantie. Dit is slechts een logische weergave; in de praktijk kan je bij implementatie drie replica's van elke component van het control plane en honderden of duizenden proxies in het data plane hebben.
(De blauwe rechthoeken in dit diagram symboliseren de grenzen van Kubernetes pods. Het is duidelijk dat de containers met linkerd-proxy zich in dezelfde pod bevinden als de applicatiecontainers. Dit soort opstelling staat bekend als sidecar-container.)
De architectuur van service mesh heeft verschillende belangrijke implicaties. Ten eerste, aangezien de taak van de proxy is om oproepen tussen services te onderscheppen, heeft het service mesh alleen zin als je toepassing is gebouwd op een bepaalde set services. Mesh kan kan gebruikt worden met monolieten, maar dat is duidelijk overbodig voor slechts één enkele proxy, en de functionaliteit zal waarschijnlijk niet nodig zijn.
Een andere belangrijke implicatie is dat service mesh een enorm aantal proxies vereist. In feite koppelt Linkerd de linkerd-proxy aan elke instantie van elke service (andere implementaties voegen proxies toe aan elke node/host/virtuele machine. Hoe dan ook, dat is niet gering). Dit actieve gebruik van proxies brengt op zich al verschillende complicaties met zich mee:
- Proxies in het data plane moeten snel zijn, aangezien elke oproep gepaard gaat met twee proxy-aanroepen: één aan de klantzijde, één aan de serverzijde.
- Ook moeten proxies klein en lichtgewicht zijn. Elke zal middelen zoals geheugen en CPU verbruiken, en dit verbruik zal lineair stijgen met de applicatie.
- U heeft een mechanisme nodig voor de implementatie en updates van een groot aantal proxies. Dit handmatig doen is geen optie.
In het algemeen ziet een service mesh er als volgt uit (tenminste, vanuit vogelperspectief): u implementeert een heleboel userspace-proxies die "iets doen" met het interne, inter-service verkeer, en u gebruikt een control plane voor monitoring en beheer.
Het is tijd voor de vraag "Waarom?"
Wat is het nut van een service mesh?
Voor degenen die voor het eerst met het idee van een service mesh worden geconfronteerd, is het begrijpelijk om een lichte vreugde te ervaren. De constructie van een service mesh betekent dat het niet alleen de latentie in de applicatie verhoogt, maar ook middelen zal verbruiken en toevoegen een heleboel nieuwe mechanismen aan de infrastructuur. Eerst installeert u de service mesh en dan ontdekt u ineens dat u honderden (zo niet duizenden) proxies moet onderhouden. De vraag is: wie biedt zich vrijwillig aan om dit te doen? Het antwoord op deze vraag bestaat uit twee delen. Ten eerste kunnen de operationele kosten die gepaard gaan met het implementeren van deze proxies aanzienlijk worden verlaagd door enkele veranderingen die plaatsvinden in het ecosysteem (meer daarover later).
Ten tweede, zo'n apparaat is eigenlijk een uitstekende manier om extra logica in het systeem in te voeren. Niet alleen omdat met behulp van een service mesh veel nieuwe functionaliteiten kunnen worden toegevoegd, maar ook omdat dit kan gebeuren zonder inmenging in het ecosysteem. In feite is het hele model van een service mesh gebaseerd op deze postulaten: in een multi-service systeem, ongeacht wat
de afzonderlijke services doen, is het verkeer tussen hen de ideale plaats om functionaliteit toe te voegen. Bijvoorbeeld, in Linkerd (net als in de meeste mesh'en) is de functionaliteit voornamelijk gefocust op HTTP-aanroepen, inclusief HTTP/2 en gRPC*. De functionaliteit is behoorlijk uitgebreid—ze kan worden onderverdeeld in drie klassen: Functies gerelateerd aan
. Herhalingsverzoeken, time-outs, een canary-benadering (traffic splitting/redirecting) enzovoort.
- monitoring betrouwbaarheid. Aggregatie van prestatie-indicatoren, latenties en aanvraagvolumes voor elke service of afzonderlijke richtingen; het opbouwen van topologische kaarten van services enzovoort.
- monitoring . Mutual TLS, toegangscontrole, enzovoort..
- monitoring veiligheid.
* Vanuit het perspectief van Linkerd verschilt gRPC praktisch niet van HTTP/2: het enige verschil is dat er protobuf in de payload wordt gebruikt. Voor de ontwikkelaar zijn deze twee zaken natuurlijk verschillend.
Veel van deze mechanismen werken op aanvraagniveau (vandaar de term 'L7-proxy'). Bijvoorbeeld, als de service Foo een HTTP-aanroep doet naar de service Bar, kan de linkerd-proxy aan de kant van Foo intelligente belastingverdeling uitvoeren en aanroepen van Foo naar instanties van Bar sturen, afhankelijk van de waargenomen vertraging; het kan de aanvraag indien nodig herhalen (en als deze idempotent is); het kan de responscode en wachttijd vastleggen, enzovoorts. Op dezelfde manier kan de linkerd-proxy aan de kant van Bar verzoeken afwijzen als deze niet zijn toegestaan of de limiet voor aanvragen is overschreden; het kan de vertraging aan zijn kant vastleggen, enzovoorts.
Proxys kunnen 'iets doen' op verbindingsniveau. Bijvoorbeeld, de linkerd-proxy aan de kant van Foo kan een TLS-verbinding initiëren, terwijl de linkerd-proxy aan de kant van Bar deze kan verbreken, en beide partijen kunnen elkaars TLS-certificaten controleren. Dit biedt niet alleen encryptie tussen services, maar ook een cryptografisch veilige manier om services te identificeren: Foo en Bar kunnen 'bewijzen' dat ze zijn wie ze beweren te zijn.
* 'Elkaar' betekent dat het clientcertificaat ook wordt gecontroleerd (mutual TLS). In 'klassieke' TLS, bijvoorbeeld tussen een browser en een server, wordt meestal alleen het certificaat van één partij (de server) gecontroleerd.
Ongeacht of ze werken op aanvraag- of verbindingsniveau, is het belangrijk te benadrukken dat alle functies van service mesh een operationeel karakter hebben. Linkerd kan de semantiek van de payload niet transformeren — bijvoorbeeld, geen velden aan een JSON-fragment toevoegen of wijzigingen aanbrengen in protobuf. We zullen later in deze belangrijke eigenschap ingaan wanneer we het hebben over ESB en middleware.
Dit is de set functies die service mesh biedt. De vraag rijst: waarom niet deze functies direct in de applicatie implementeren? En waarom zou je überhaupt met een proxy werken?
Waarom service mesh een goed idee is
Hoewel de mogelijkheden van service mesh de verbeelding prikkelen, ligt de werkelijke waarde ervan niet in de functies. Uiteindelijk zijn we kunnen directly implement them in the application (later we will see that this was the origin of the service mesh). If we try to express this thought in one sentence, the value of the service mesh is as follows: it provides functionalities that are critically important for the operation of modern server software, uniformly across the entire stack and independent of the application code..
Let's analyze this sentence.
«Functionalities that are critically important for the operation of modern server softwareIf you are creating a transactional server application related to the public internet, handling requests from the outside world and responding to them within a short period — for example, a web application, an API server, or indeed the vast majority of other modern applications — and if you implement it as a set of services that synchronously interact with each other, and if you are continually upgrading this software by adding new features, and if you must maintain this system in a working condition during the modification process — then congratulations, you are engaged in creating modern server software. And all these wonderful features listed above turn out to be critically important for you. The application must be reliable, secure, and you should be able to observe what it is doing. These are precisely the questions that the service mesh helps to solve.
(Okay, my belief that this approach is the modern way to create server software slipped into the previous paragraph. Others prefer to develop monoliths, 'reactive microservices', and other things that do not fit the definition given above. These individuals surely have their own opinions, which differ from mine. For my part, I believe that they are 'wrong' — although in any case the service mesh is not very useful for them).
«Uniformly across the entire stackThe functionalities provided by the service mesh are not just critically important. They apply to all services in the application regardless of the language they are written in, which framework they use, who wrote them, how they were deployed, and all other nuances of their development and deployment.
«Independent of the application codeService mesh biedt niet alleen uniforme functionaliteit voor de gehele stack, het doet dit ook op een manier die geen aanpassingen aan de applicatie vereist. De fundamenten van de functionaliteit van service mesh, inclusief taken zoals configuratie, updates, operatie, onderhoud, enzovoort, zijn volledig op platformniveau en onafhankelijk van de applicatie. De applicatie kan veranderen zonder invloed op de service mesh. Op zijn beurt kan de service mesh ook veranderen zonder enige betrokkenheid van de applicatie.
Kortom, service mesh biedt niet alleen essentiële functies, maar doet dit op een globale, uniforme en applicatie-onafhankelijke manier. Daarom, hoewel de functionaliteit van service mesh gerealiseerd kan worden in de servicecode (bijvoorbeeld als een bibliotheek die in elke service is opgenomen), zorgt deze aanpak niet voor de consistentie en onafhankelijkheid die zo waardevol zijn voor service mesh.
En alles wat hiervoor nodig is, is een hoop proxy's toevoegen! Ik beloof dat we binnenkort de operationele kosten die gepaard gaan met het toevoegen van deze proxy's zullen bekijken. Maar laten we eerst even stilstaan en deze onafhankelijkheidsidee vanuit verschillende perspectieven bekijken. mensen.
Wie profiteert van service mesh?
Hoe ongemakkelijk het ook is, voor een technologie om een belangrijk onderdeel van het ecosysteem te worden, moet deze door mensen worden aangenomen. Dus wie is geïnteresseerd in service mesh? Wie profiteert van het gebruik ervan?
Als je moderne serversoftware ontwikkelt, kun je je team ongeveer voorstellen als een groep service-eigenaren, die samen de bedrijfslogica ontwikkelen en implementeren, en platform-eigenaren, die zich bezighouden met de ontwikkeling van het interne platform waarop deze services draaien. In kleine organisaties kunnen dit dezelfde mensen zijn, maar naarmate het bedrijf groeit, worden deze rollen meestal duidelijker en worden ze zelfs opgesplitst in subrollen... (Hier valt veel te zeggen over de veranderende aard van DevOps, de organisatorische impact van microservices, enzovoort. Maar laten we deze beschrijvingen voorlopig als gegeven aanvaarden).
Vanuit dit perspectief zijn de duidelijke begunstigden van een service mesh de platformeigenaren. Uiteindelijk is het doel van het platformteam om een interne platform te creëren waarop de service-eigenaren hun zakelijke logica kunnen implementeren en dit op een manier doen die hun maximale onafhankelijkheid van de sombere details van het operationele beheer garandeert. De service mesh biedt niet alleen mogelijkheden die cruciaal zijn voor het bereiken van dit doel: het doet dit op een manier die op zijn beurt geen afhankelijkheden voor de service-eigenaren oplegt.
Service-eigenaren profiteren ook, zij het op een meer indirecte manier. Het doel van een service-eigenaar is om zo productief mogelijk te zijn in het implementeren van de businessproceslogica, en hoe minder zij zich zorgen hoeven te maken over operationele kwesties, hoe beter. In plaats van zich te bemoeien met het implementeren van bijvoorbeeld retry-beleid of TLS, kunnen ze zich uitsluitend concentreren op zakelijke taken en hopen dat het platform voor de rest zorgt. Dit is een groot voordeel voor hen.
De organisatorische waarde van deze scheiding tussen platformeigenaren en service-eigenaren is moeilijk te overschatten. Ik denk dat het bijdraagt de hoofdsite aan de waarde van de service mesh.
We hebben deze les geleerd toen een van de eerste fans van Linkerd ons vertelde waarom ze voor de service mesh kozen: omdat het hen "de blabla tot een minimum kon beperken". Hier wat details: de jongens van een groot bedrijf migreerden hun platform naar Kubernetes. Aangezien de applicatie met gevoelige informatie werkte, wilden ze al het verkeer binnen de clusters versleutelen. De situatie werd echter gecompliceerd door het bestaan van honderden services en honderden ontwikkelteams. Het vooruitzicht om met iedereen contact op te nemen en hen te overtuigen om TLS in hun plannen op te nemen, maakte hen zeker niet blij. Door Linkerd te installeren, verlegden ze de verantwoordelijkheid van de ontwikkelaars (van wie dit extra gedoe was) naar de platformbeheerders, voor wie dit een topprioriteit was. Met andere woorden, Linkerd loste voor hen niet alleen een technische, maar ook een organisatorische kwestie op.
Kortom, de service mesh is eerder een oplossing voor een niet-technische, maar sociaal-technische problemen. (Dank aan voor het introduceren van deze term.)
Zal de service mesh al mijn problemen oplossen?
Ja. Ik bedoel, nee!
Als we naar de drie hierboven genoemde functiecategorieën kijken: betrouwbaarheid, veiligheid en observabiliteit, wordt het duidelijk dat een service mesh geen volledige oplossing biedt voor een van deze problemen. Hoewel Linkerd opnieuw aanvragen kan versturen (als het weet dat ze idempotent zijn), kan het geen beslissingen nemen over wat aan de gebruiker moet worden teruggegeven als de service definitief is uitgevallen - dergelijke beslissingen moeten door de applicatie worden genomen. Linkerd kan statistieken bijhouden van succesvolle aanvragen, maar het is niet in staat om in de service te kijken en zijn interne metrics te bieden - dergelijke tools moeten door de applicatie worden geleverd. En hoewel Linkerd in staat is om mTLS te organiseren, vereisen volledige oplossingen voor veiligheid veel meer.
Een subset van functies in deze gebieden die door service mesh worden aangeboden, heeft betrekking op de functies van het platform. Daaronder versta ik functies die:
- Onafhankelijk zijn van de bedrijfslogica. De manier waarop de histogrammen van de oproepen tussen Foo en Bar worden opgebouwd, hangt helemaal niet af van of waarom Foo Bar aanroept.
- Het is moeilijk omjuist te implementeren. Bij Linkerd worden de opnieuw te proberen aanvragen geparametriseerd met allerlei ingewikkelde dingen zoals herprobeerbudgets (retry budgets), omdat een rechttoe rechtaan aanpak bij de implementatie van dergelijke dingen ongetwijfeld zal leiden tot wat bekend staat als een 'herprobeerstorm' (retry storm) en andere problemen die typisch zijn voor gedistribueerde systemen.
- Het meest effectief wanneer ze consistent worden toegepast. Een TLS-mechanisme heeft alleen zin als het overal wordt toegepast.
Aangezien deze functies op het proxyniveau zijn geïmplementeerd (en niet op applicatieniveau), biedt de service mesh ze op niveau het platform, en niet op applicatieniveau. Het maakt dus niet uit in welke programmeertaal de services zijn geschreven, welk framework ze gebruiken, wie ze heeft geschreven en waarom. Proxies werken buiten al deze details, en de fundamentele basis van deze functionaliteit, inclusief configuratie-, update-, onderhouds- en exploitatie-taken, ligt volledig op het niveau van het platform.
Voorbeelden van mogelijkheden van service mesh
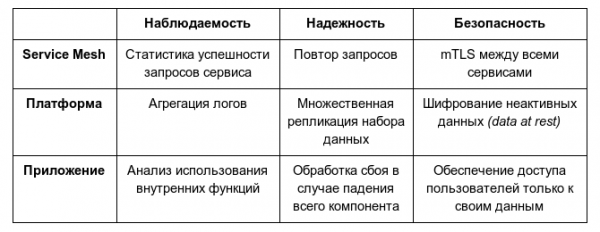
Samenvattend wil ik zeggen dat service mesh geen volledige oplossing is voor betrouwbaarheid, observatie of beveiliging. De reikwijdte van deze gebieden vereist de verplichte betrokkenheid van service-eigenaren, Ops/SRE-teams en andere belanghebbenden binnen het bedrijf. Service mesh biedt alleen een "snede" op platformniveau voor elk van deze gebieden.
Waarom is service mesh precies nu populair geworden?
Waarschijnlijk vraag je je op dit moment af: oké, als service mesh zo goed is, waarom hebben we dan niet tien jaar geleden miljoenen proxies in de stack uitgerold?
Er is een voor de hand liggend antwoord op deze vraag: tien jaar geleden bouwden we allemaal monolithen, en service mesh was voor niemand nodig. Dat is waar, maar naar mijn mening gaat de essentie in zo'n antwoord verloren. Zelfs tien jaar geleden werd het concept van microservices als een veelbelovende manier om grootschalige systemen te creëren breed besproken en toegepast in bedrijven zoals Twitter, Facebook, Google en Netflix. Het algemene idee - althans in de delen van de industrie waarmee ik contact had - was dat microservices de "juiste manier" waren om grote systemen te bouwen, ook al was het verre van eenvoudig.
Zeker, hoewel er tien jaar geleden bedrijven waren die microservices exploiteerden, stopten ze beslist geen proxies overal waar dat maar kon in om een service mesh te vormen. Maar als je goed kijkt, deden ze iets soortgelijks: in veel van deze bedrijven was het verplicht om een speciale interne bibliotheek voor netwerkcommunicatie te gebruiken (soms een 'fat client library' genoemd, fat client library).
Netflix had Hysterix, Google had Stubby, Twitter had de Finagle-bibliotheek. Finagle, bijvoorbeeld, was verplicht voor elke nieuwe service op Twitter. Het behandelde zowel de klant- als serverzijde van verbindingen, ondersteunde herhaalde verzoeken, zorgde voor verzoekrouting, load balancing en monitoring. Het bood een consistente laag van betrouwbaarheid en observatie voor de hele stack van Twitter, ongeacht waar de service precies mee bezig was. Natuurlijk werkte het alleen voor JVM-talen en was het gebaseerd op het programmeermodel dat voor de hele applicatie moest worden gebruikt. Maar de functionaliteiten waren bijna identiek aan die van een service mesh. (De eerste versie van Linkerd was in feite gewoon Finagle, verpakt in de vorm van een proxy.)
Tien jaar geleden bestonden er dus niet alleen microservices, maar ook speciale proto-service-mesh bibliotheken die dezelfde problemen oplosten als service mesh dat vandaag de dag doet. Echter, er was toen nog geen service mesh. Er moest nog een verschuiving plaatsvinden voordat het verscheen.
En hier ligt het diepere antwoord, verborgen in een andere verandering die in de afgelopen 10 jaar heeft plaatsgevonden: de kosten van het implementeren van microservices zijn drastisch gedaald. De eerder genoemde bedrijven die tien jaar geleden microservices gebruikten: Twitter, Netflix, Facebook, Google, waren bedrijven van enorme schaal en middelen. Ze hadden niet alleen de behoefte, maar ook de mogelijkheid om grote applicaties op basis van microservices te maken, te implementeren en te exploiteren. De energie en inspanningen die de ingenieurs van Twitter hebben geleverd bij de overstap van een monolithische naar een microservices benadering zijn gewoonweg indrukwekkend. (Eerlijk gezegd, net zoals het feit dat ze het hebben gehaald.) Soortgelijke infrastructurele manoeuvres waren toen onmogelijk voor kleinere bedrijven.
Laten we naar het heden gaan. Vandaag de dag zijn er startups waar de verhouding tussen microservices en ontwikkelaars 5:1 is (of zelfs ), en bovendien slagen ze daar ook nog eens met gemak in! Als een startup van 5 mensen in staat is om zonder veel moeite 50 microservices te exploiteren, betekent dat dat er duidelijk iets is dat de kosten van implementatie heeft verlaagd.
1500 microservices bij Monzo; elke regel is een voorgeschreven netwerkregel die verkeer toestaat
De drastische daling van de kosten voor het opereren van microservices is het resultaat van één proces: de groeiende populariteit van containers en orchestrators. Dit is waar het diepe antwoord ligt op de vraag wat heeft bijgedragen aan de opkomst van service mesh. Het is dezelfde technologie die zowel service mesh als microservices aantrekkelijk heeft gemaakt: Kubernetes en Docker.
Waarom? Nou, Docker lost één groot probleem op - het verpakkingsprobleem. Door een applicatie en zijn (niet-netwerk) runtime afhankelijkheden in een container te verpakken, maakt Docker de applicatie een uitwisselbare eenheid die overal kan worden geplaatst en uitgevoerd. Tegelijkertijd vereenvoudigt het de exploitatie aanzienlijk. meertalig Stack: since a container is an atomic unit of execution, it does not matter what is inside for deployment and operation purposes, whether it's an application on JVM, Node, Go, Python, or Ruby. You just run it, and that's it.
Kubernetes takes everything to the next level. Now that there are tons of "executables" and many machines to run them on, the need arises for a tool that can match them to each other. Broadly speaking, you give Kubernetes many containers and many machines, and it matches them to each other (of course, this is a dynamic and constantly changing process: new containers move through the system, machines start and stop, etc. However, Kubernetes accounts for all of this).
After setting up Kubernetes, the time spent on deploying and operating a single service is hardly different from the time spent on deploying and operating ten services (in fact, they are practically the same for 100 services as well). Add to this containers as a packaging mechanism encouraging multilingual implementation, and you have a multitude of new applications implemented as microservices written in various languages — just the environment that service mesh is well suited for.
So, we arrive at the answer to the question of why the idea of service mesh has become popular right now: the uniformity that Kubernetes provides for services directly applies to the operational tasks facing service mesh. You pack proxies into containers, give Kubernetes the task of sticking them wherever possible, and voilà! You get a service mesh, while Kubernetes manages all the mechanics of its deployment. (At least from a bird's eye view. Of course, there are many nuances in this process.)
In summary: the reason service mesh has become popular right now, rather than ten years ago, is that Kubernetes and Docker have not only significantly increased the demand for it, simplifying the implementation of applications as sets of multilingual microservices, but also substantially reduced the costs of its operation, providing mechanisms for deploying and supporting sidecar proxy parks.
Why is there so much talk about service mesh?
Waarschuwing: in this section, I resort to all sorts of assumptions, guesses, speculations, and insider information.
Als je zoekt naar de term 'service mesh', kom je een overvloed aan herwerkt, laagwaardig materiaal tegen, vreemde projecten en een caleidoscoop van vervormingen tegen die typerend zijn voor echo kamers. Dit gebeurt met elke nieuwe trendy technologie, maar in het geval van service mesh is het probleem bijzonder acuut. Waarom?
Nou, gedeeltelijk is dit mijn schuld. Ik heb al mijn kracht gestoken in het promoten van Linkerd en service mesh wanneer dat maar kon, door ontelbare blogposts en artikelen zoals deze. Maar ik ben niet zo machtig. Om deze vraag echt te beantwoorden, moeten we het even hebben over de algemene situatie. En daarvoor kunnen we niet om één project heen: — een open-source service mesh, gezamenlijk ontwikkeld door Google, IBM en Lyft.
(Deze drie bedrijven hebben totaal verschillende rollen: Lyft’s betrokkenheid lijkt beperkt tot enkel de naam; ze zijn de makers van Envoy, maar gebruiken Istio niet of dragen niet bij aan de ontwikkeling ervan. IBM is betrokken bij de ontwikkeling van Istio en gebruikt het. Google heeft een actieve rol in de ontwikkeling van Istio, maar voor zover ik kan zien, gebruiken ze het eigenlijk niet.)
Het Istio-project valt op door twee kenmerken. Ten eerste zijn er de enorme marketinginspanningen die Google, in het bijzonder, levert om het te promoten. Naar schatting heeft de meerderheid van de mensen die momenteel bekend zijn met het concept van service mesh daar voor het eerst over gehoord dankzij Istio. Het tweede kenmerk is hoe slecht Istio werd ontvangen. In deze kwestie ben ik uiteraard bevooroordeeld, maar terwijl ik probeer zo objectief mogelijk te blijven, kan ik niet anders dan , niet echt typerend (hoewel niet uniek: ik denk aan systemd, …) voor een open-source project.
(In de praktijk lijkt Istio problemen te hebben, niet alleen met complexiteit en gebruikerservaring, maar ook met prestaties. Bijvoorbeeld, tijdens de , uitgevoerd door een derde partij, ontdekten experts situaties waarin de tail latency van Istio 100 keer hoger was dan die van Linkerd, evenals situaties van schaarste aan middelen, waarbij Linkerd succesvol bleef functioneren terwijl Istio volledig stopte.)
Terzijde latend mijn theorieën over waarom dit is gebeurd, geloof ik dat de enorme hype rondom service mesh juist te maken heeft met de betrokkenheid van Google. Namelijk, een combinatie van de volgende drie factoren:
- de opdringerige promotie van Istio door Google;
- de bijbehorende afkeurende, kritische houding tegenover het project;
- de recente snelle toename van de populariteit van Kubernetes, waarvan de herinneringen nog vers zijn.
Samen vormen deze factoren een soort bedwelmende, zuurstofloze omgeving, waarin het vermogen tot rationeel oordelen verzwakt, en alleen een wonderlijke variant van .
Vanuit Linkerd gezien zou ik dit beschrijven als een dubbelzinnig goed. Ik bedoel, het is geweldig dat service mesh mainstream is geworden - iets wat in 2016 niet het geval was, toen Linkerd net was verschenen en het echt moeilijk was om de aandacht van anderen te trekken voor het project. Nu is dat probleem er niet meer! Maar het slechte nieuws is dat de situatie met service mesh vandaag de dag zo verwarrend is dat het bijna onmogelijk is om te begrijpen welke projecten daadwerkelijk onder de categorie service mesh vallen (laat staan dat je kunt begrijpen welke het beste past bij een specifiek gebruiksdoel). Dit hindert iedereen, en zeker in sommige gevallen past Istio of een ander project wellicht beter dan Linkerd, aangezien deze laatste toch niet de universele oplossing is.
Vanuit Linkerd was onze strategie om de ruis te negeren, ons te blijven concentreren op het oplossen van echte problemen voor de gemeenschap en in feite te wachten tot de hype is afgekoeld. Uiteindelijk zal de hype afnemen en kunnen we rustig doorwerken.
Voorlopig moeten we allemaal een beetje geduld hebben.
Zal service mesh nuttig zijn voor mij, een bescheiden software engineer?
Met het beantwoorden van deze vraag kan de volgende vragenlijst helpen:
U houdt zich alleen bezig met de implementatie van bedrijfslogica? In dat geval is service mesh niet nuttig voor u. Natuurlijk kunt u er interesse in hebben, maar idealiter zou service mesh geen directe invloed moeten hebben op iets in uw omgeving. Blijf werken aan wat u betaald wordt.
Ondersteunt u een platform in een bedrijf dat Kubernetes gebruikt? Ja, in dit geval heb je service mesh nodig (tenzij je K8s alleen gebruikt voor het draaien van een monoliet of batchverwerking — maar dan wil ik vragen waarom je K8s gebruikt). Waarschijnlijk bevind je je in een situatie met meerdere microservices, geschreven door verschillende mensen. Ze communiceren met elkaar en zijn verweven in een web van runtime-afhankelijkheden, en je moet een manier vinden om hiermee om te gaan. Het toepassen van Kubernetes maakt het mogelijk om een service mesh te kiezen die bij je past. Neem hiervoor kennis van hun mogelijkheden en functies en beantwoord de vraag of een van de beschikbare projecten je überhaupt aanspreekt (ik raad aan om te beginnen met Linkerd).
Beheer je een platform in een bedrijf dat GEEN gebruik maakt van Kubernetes, maar wel microservices? In dit geval zal service mesh nuttig zijn, maar het gebruik zal niet triviaal zijn. Natuurlijk kun je simuleren hoe service mesh werkt door een hoop proxy's te plaatsen, maar een belangrijk voordeel van Kubernetes is juist het implementatiemodel: het handmatig onderhouden van deze proxy's kost veel meer tijd, moeite en kosten.
Ben jij verantwoordelijk voor een platform in een bedrijf dat werkt met monolieten? In dit geval heb je waarschijnlijk geen service mesh nodig. Als je werkt met monolieten (of zelfs sets van monolieten) met duidelijk gedefinieerde en zelden veranderende interactiepatronen, dan kan service mesh weinig voor je betekenen. Dus je kunt het gewoon negeren en hopen dat het als een nachtmerrie verdwijnt…
Conclusie
Misschien is service mesh toch niet de "meest gehypte technologie ter wereld" — deze twijfelachtige eer behoort waarschijnlijk toe aan bitcoin of AI. Misschien staat het in de top vijf. Maar als je door de lagen van ruis en gedoe heen prikt, wordt het duidelijk dat service mesh echte voordelen biedt voor degenen die applicaties in Kubernetes ontwikkelen.
Ik zou je willen vragen Linkerd uit te proberen — de installatie in een Kubernetes-cluster (of zelfs in Minikube op een laptop) , en zo kun je zelf zien waar ik het over heb.
FAQ
— Als ik service mesh negeer, verdwijnt het dan?
— Ik moet je teleurstellen: service mesh is hier om te blijven.
— Maar ik WIL geen service mesh gebruiken!
— Nou, dat hoeft niet! Lees gewoon mijn enquête hierboven om te begrijpen of je minstens de basis ervan moet leren kennen.
— Is dit niet gewoon de oude vertrouwde ESB/middleware in een nieuw jasje?
— Service mesh behandelt operationele logica, niet inhoudelijke. van de enterprise service bus (). Het behouden van deze scheiding helpt service mesh om hetzelfde lot te vermijden.
— Hoe verschilt service mesh van API-gateways?
— Er zijn miljoenen artikelen over dit onderwerp. Zoek het gewoon op.
— Is Envoy een service mesh?
— Nee, Envoy is geen service mesh, het is een proxyserver. Het kan worden gebruikt om een service mesh op te zetten (en nog veel meer - het is een general-purpose proxy). Maar op zich is het geen service mesh.
— Is Network Service Mesh een service mesh?
— Nee. Ondanks de naam is dit geen service mesh (wie heeft marketingwonderen bedacht?).
— Helpt service mesh met mijn reactieve asynchrone systeem gebaseerd op een berichtenwachtrij?
— Nee, service mesh zal je niet helpen.
— Welke service mesh moet ik gebruiken?
— , dat is voor de hand liggend.
— Het artikel is waardeloos! / De auteur naar de prullenbak!
— Deel alsjeblieft de link naar dit artikel met al je vrienden, zodat zij het ook kunnen bevestigen!
Waardering
Zoals je kunt raden uit de titel, werd dit artikel geïnspireerd door de fantastische traktatie van Jay Kreps “”. Ik ontmoette Jay tien jaar geleden toen ik een interview deed bij LinkedIn, en sindsdien is hij een bron van inspiratie voor mij.
Hoewel ik graag zeg dat ik een 'Linkerd-ontwikkelaar' ben, is de werkelijkheid dat ik eerder de maintainer van het README.md-bestand ben in het project. Vandaag werken er , , mensen aan Linkerd, en dit project zou niet hebben bestaan zonder de bijdrage van een geweldig gemeenschaps van bijdragers en gebruikers.
En tot slot een speciale dank aan de maker van Linkerd, (primus inter pares), die samen met mij jaren geleden in deze hele drukte rondom service mesh is gedoken.
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «»;
- «».
Bron: habr.com
