

Periodiek komt het voor dat de ontwikkelaar de behoefte heeft om een set parameters of zelfs een hele selectie door te geven. Soms komen er erg vreemde oplossingen voor deze taak voorbij.
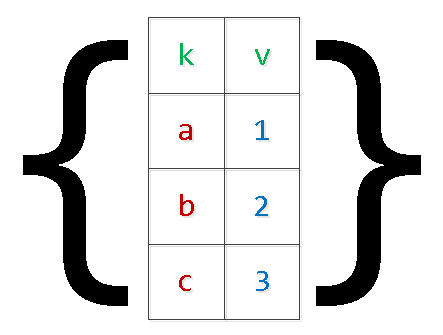
Laten we 'van het andere eind' beginnen en bekijken hoe het niet moet, waarom, en hoe het beter kan.
Rechstreeks 'invoegen' van waarden in de query
Ziet er meestal ongeveer zo uit:
query = "SELECT * FROM tbl WHERE id = " + waarde… of zo:
query = "SELECT * FROM tbl WHERE id = :param".format(param=waarde)Voor deze manier is er genoeg geschreven, gezegd en :
Bijna altijd leidt dit tot rechtstreeks SQL-injecties en onnodige belasting van de bedrijfslogica, die genoodzaakt is om de regel van uw query te 'plakken'.
Deze aanpak is gedeeltelijk gerechtvaardigd alleen bij de noodzaak van partitionering in PostgreSQL 10 en oudere versies om een efficiënter plan te verkrijgen. In deze versies wordt de lijst van doorzochte secties nog vastgesteld zonder rekening te houden met de doorgegeven parameters, alleen op basis van de body van de query.
$n-argumenten
Gebruik van parameters — dat is goed, het maakt gebruik van , wat de belasting op zowel de bedrijfslogica (de queryregel wordt slechts één keer gevormd en doorgegeven) als de database-server verlicht (er zijn geen herhaalde parsingen en planning voor elke instantie van de query nodig).
Variabel aantal argumenten
Problemen zullen ons opwachten wanneer we een vooraf onbekend aantal argumenten willen doorgeven:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Als we de query in deze vorm laten, zal dit ons weliswaar beschermen tegen potentiële injecties, maar leidt nog steeds tot de noodzaak om de query samen te voegen/parsen voor elke variant van het aantal argumenten.Dit is al beter dan het elke keer doen, maar het kan ook zonder.
Het is voldoende om slechts één parameter door te geven die de serialisatie van een array bevat.:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Het enige verschil is de noodzaak om de argumenten expliciet om te zetten naar het juiste array-type. Maar dit vormt geen probleem, aangezien we van tevoren weten waar we op richten.
Doorgeven van een selectie (matrix)
Dit zijn doorgaans allerlei manieren om datasets door te geven voor invoegingen in de database 'met één query':
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Naast de eerder beschreven problemen met "het vervangen" van de aanvraag, kan dit ons ook leiden tot geheugenvol en serveruitval. De reden is eenvoudig — PG reserveert extra geheugen voor argumenten, en het aantal records in de set wordt alleen beperkt door de applicatiewensen van de bedrijfslogica. In bijzonder klinische gevallen hebben we gezien "numeraire" argumenten boven $9000 — doe dat niet.
Laten we de aanvraag herschrijven, waarbij we al "tweedimensionale" serialisatie toepassen:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Ja, in het geval van "complexe" waarden binnen de array moeten deze tussen aanhalingstekens worden geplaatst.
Het is duidelijk dat je op deze manier een selectie kunt "uitbreiden" met een willekeurig aantal velden.
unnest, unnest, …
Af en toe komen er varianten voor waarbij in plaats van een "array van arrays" verschillende "arrays van kolommen" worden doorgegeven, waarover ik al eerder sprak :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Bij deze methode is het heel eenvoudig om fouten te maken bij het genereren van waarde-lijsten voor verschillende kolommen, wat kan leiden tot heel onverwachte resultaten, die ook afhankelijk zijn van de versie van de server:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
of een ander formaat.
Sinds versie 9.3 beschikt PostgreSQL over volledige functies voor het werken met json-typen. Dus, als de invoerparameters in uw browser worden gedefinieerd, kunt u daar direct een json-object voor de SQL-aanroep vormen:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Voor eerdere versies kan dezelfde methode worden gebruikt voor each(hstore), maar een correcte "samenvatting" met escaping van complexe objecten in hstore kan problemen veroorzaken.
json_populate_recordset
Als u van tevoren weet dat de gegevens uit de "invoer" json-array voor het vullen van een bepaalde tabel zullen worden gebruikt, kunt u veel besparen op "derefereren" van velden en conversie naar de juiste types door gebruik te maken van de functie json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
En deze functie "haalt simpelweg" de doorgegeven array van objecten in een selectie, zonder rekening te houden met het tabelformaat:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
Tijdelijke TABEL
Maar als de hoeveelheid gegevens in de verzonden steekproef erg groot is, is het moeilijk, en soms zelfs onmogelijk, om het in één geserialiseerde parameter te plaatsen, omdat dit veel geheugen vereist. toewijzing van een groot geheugen.Bijvoorbeeld, je moet langdurig een grote dataset van gebeurtenissen uit een extern systeem verzamelen en deze dan in één keer aan de database verwerken.
In dit geval is het beste alternatief het gebruik van :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- herhaal dit heel vaak
...
-- hier doen we iets nuttigs met de hele tabel.
Deze methode is met name goed voor sporadische overdracht van grote hoeveelheden gegevens.
Wat de beschrijving van de structuur van de gegevens betreft, verschilt een tijdelijke tabel van een 'gewone' tabel alleen door één kenmerk. in de systeemtabel pg_class., en in pg_type, pg_depend, pg_attribute, pg_attrdef, ... — anders helemaal niet.
Daarom zal in websystemen met een groot aantal kortdurende verbindingen een dergelijke tabel elke keer nieuwe systeemrecords genereren, die worden verwijderd bij het sluiten van de databaseverbinding. Dit leidt tot ongecontroleerd gebruik van TEMP TABLE, wat resulteert in ‘opblazen’ van tabellen in pg_catalog en het vertragen van vele bewerkingen die deze gebruiken.
Natuurlijk kan dit worden bestreden met behulp van periodieke VACUUM FULL door de tabellen van de systeemcatalogus.
Sessievariabelen
Stel dat de gegevensverwerking uit het vorige geval complex genoeg is voor één SQL-query, maar dat we dit vrij vaak willen doen. Dat wil zeggen, we willen procedurele verwerking gebruiken in maar het gebruik van tijdelijke tabellen voor gegevensoverdracht zou te kostbaar zijn.
We kunnen ook geen $n-parameters gebruiken voor overdracht naar een anonieme blok. We kunnen onze weg hieruit vinden met sessievariabelen en de functie current_setting..
Tot versie 9.2 moest je vooraf een custom_variable_classes configureren voor ‘jouw’ sessievariabelen. In de actuele versies kan dit ongeveer als volgt worden geschreven:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3.
In andere ondersteunde procedurele talen zijn er ook andere oplossingen te vinden.
Ken je nog andere manieren? Deel ze in de reacties!
Bron: habr.com
