

Hallo, Habr-leden. Vandaag beginnen de lessen in de eerste groep van de cursus . In dit verband willen we jullie vertellen over het open webinar dat we hebben gehouden over deze cursus.
In bespraken we de uitdagingen waarmee SQL-databases worden geconfronteerd in het tijdperk van cloud en Kubernetes. Daarnaast keken we hoe SQL-databases zich aanpassen en evolueren door deze uitdagingen.
Het webinar werd geleid door , Google Cloud Practice Delivery Manager bij EPAM Systems.
Toen de bomen nog klein waren…
Laten we beginnen met het terugblikken op hoe de selectie van databasesystemen aan het einde van de vorige eeuw begon. Dat is geen moeite, want de keuze van databasesystemen was toen nogal beperkt. Oracle.
Aan het einde van de jaren '90 en het begin van de jaren '00 was er eigenlijk niet veel keuze als het ging om industriële schaalbare databases. Ja, er waren IBM DB2, Sybase en een paar andere databases die opkwamen en weer verdwenen, maar over het algemeen waren ze niet zo op de voorgrond vergeleken met Oracle. De vaardigheden van ingenieurs in die tijd waren hoe dan ook verbonden aan die ene keuze die er was.
Een Oracle DBA moest kunnen:
- Oracle Server installeren vanuit de distributie;
- Oracle Server configureren:
- init.ora;
- listener.ora;
— creëren:
- tabellenruimtes;
- schema's;
- gebruikers;
— back-ups maken en herstellen;
— monitoring uitvoeren;
— omgaan met suboptimale queries.
Daarbij werd van de Oracle DBA niet veel vereist:
- de optimale database of een andere technologie voor opslag en verwerking van data kiezen;
- hoge beschikbaarheid en horizontale schaalbaarheid waarborgen (dat was niet altijd de verantwoordelijkheid van de DBA);
- de materie, infrastructuur, applicatiearchitectuur en OS goed kennen;
- data-import en -export uitvoeren, data migreren tussen verschillende databasesystemen.
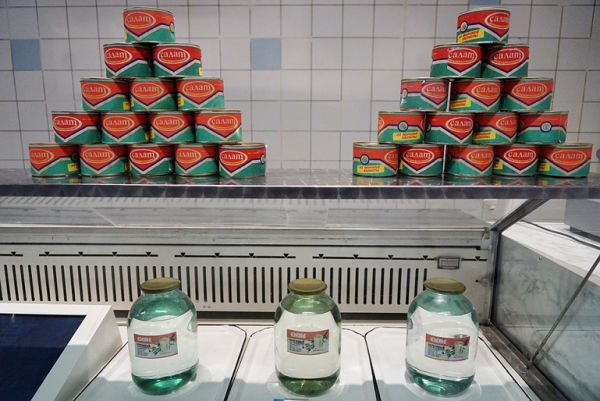
Over het algemeen lijkt de keuze in die tijd op de keuze in een Sovjetwinkel aan het eind van de jaren '80:
Onze tijd
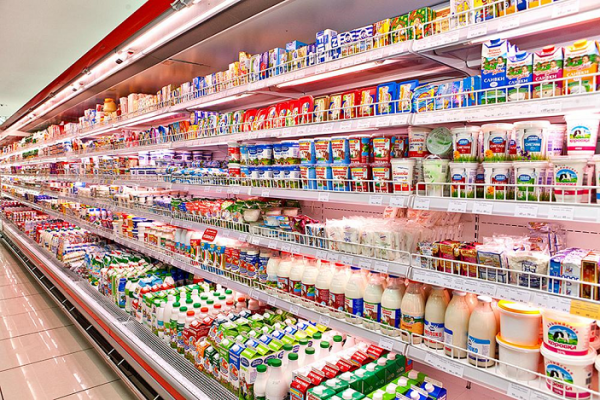
Sindsdien zijn de bomen natuurlijk gegroeid, de wereld is veranderd, en is het zo gegaan:
De database-markt is veranderd, zoals blijkt uit het recente rapport van Gartner:
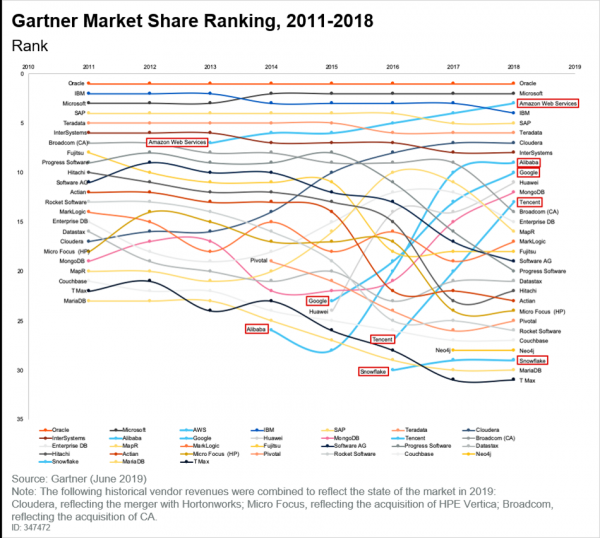
En het is belangrijk op te merken dat de cloud zijn plek heeft veroverd, waarvan de populariteit toeneemt. Als we hetzelfde rapport van Gartner lezen, zullen we de volgende conclusies zien:
- Veel klanten zijn bezig met de overgang van applicaties naar de cloud.
- Nieuwe technologieën verschijnen eerst in de cloud en het is niet zeker dat ze ooit naar een niet-cloud infrastructuur zullen verhuizen.
- Het principe van pay-as-you-go is gebruikelijk geworden in prijsstelling. Iedereen wil alleen betalen voor wat ze gebruiken, en dit is al lang geen trend meer, maar gewoon een feit.
Wat is de situatie nu?
Vandaag de dag bevinden we ons allemaal in de cloud. De vragen die we hebben, zijn keuzevragen. En die zijn enorm, zelfs als we alleen praten over de keuze van database technologieën in On-premises format. En we hebben ook managed services en SaaS. Hierdoor wordt de keuze elk jaar alleen maar ingewikkelder.
Naast keuzevragen spelen ook beperkende factoren:
- price. Veel technologieën kosten nog steeds geld;
- vaardigheden. Als we het hebben over open source software, rijst de vraag naar vaardigheden, want gratis software vereist voldoende competentie van de mensen die het implementeren en onderhouden;
- functionaliteit. Niet alle services die beschikbaar zijn in de cloud en gebouwd zijn op bijvoorbeeld dezelfde Postgres, beschikken over dezelfde functies als Postgres On-premises. Dit is een cruciale factor die men moet kennen en begrijpen. Sterker nog, deze factor wordt belangrijker dan kennis van verborgen mogelijkheden van een specifieke database.
Wat verwacht men momenteel van DA/DE:
- goede kennis van het vakgebied en toegepaste architectuur;
- in staat zijn om de juiste database technologie te kiezen rekening houdend met de gestelde taak;
- in staat zijn om de optimale implementatiemethode van de gekozen technologie te selecteren binnen de bestaande beperkingen;
- in staat zijn om gegevensoverdracht en migratie uit te voeren;
- in staat zijn om de gekozen oplossingen te implementeren en te onderhouden.
Het onderstaande voorbeeld op basis van GCP demonstrateert hoe de keuze van een bepaalde technologie voor gegevensverwerking afhankelijk is van hun structuur:
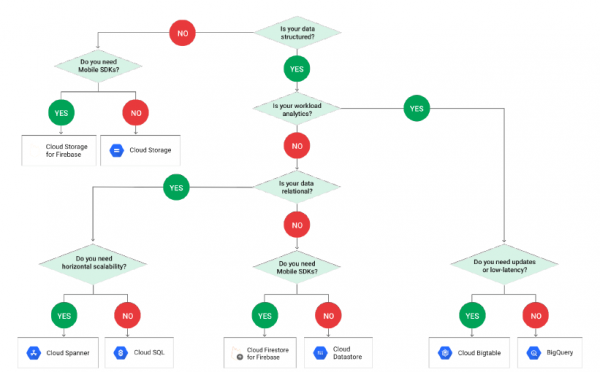
Let op dat PostgreSQL niet in het schema voorkomt, omdat het verborgen is onder de terminologie van Cloud SQL. En wanneer we in Cloud SQL komen, moeten we opnieuw een keuze maken:
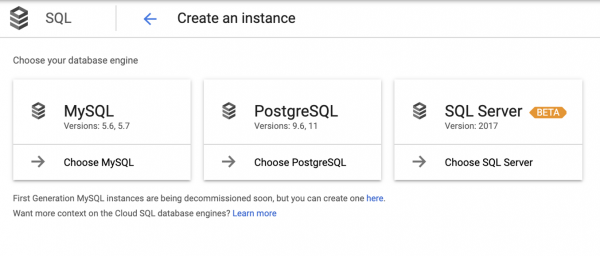
Het is belangrijk op te merken dat deze keuze niet altijd duidelijk is, daarom laten ontwikkelaars van applicaties zich vaak leiden door hun intuïtie.
Kortom:
- Naarmate de tijd verstrijkt, wordt de keuzevraag steeds relevanter. En zelfs als we alleen naar GCP, managed services en SaaS kijken, komt er pas in stap 4 enige vermelding van RDBMS (en daar staat Spanner naast). Bovendien verschijnt de keuze voor PostgreSQL pas in stap 5, met daarnaast ook MySQL en SQL Server, wat betekent er is veel keuze, maar er moet gekozen worden.
- Je moet ook de beperkingen niet vergeten, ondanks de verleiding. Over het algemeen wil iedereen Spanner, maar het is duur. Uiteindelijk ziet een typische aanvraag er ongeveer zo uit: „Maak alsjeblieft Spanner voor ons, maar dan tegen de prijs van Cloud SQL, jullie zijn toch professionals!”
En wat moeten we doen?
Zonder de waarheid in laatste instantie te claimen, laten we het volgende zeggen:
De aanpak van het leren moet veranderen:
- op de oude manier zoals DBA’s leren heeft geen zin;
- kennis van één product is tegenwoordig niet genoeg;
- en om tientallen producten op hetzelfde niveau te kennen, is onmogelijk.
Je moet niet alleen het product kennen, maar ook:
- de use case voor toepassing;
- verschillende implementatiemethoden;
- de voor- en nadelen van elke methode;
- vergelijkbare en alternatieve producten, om weloverwogen en optimale keuzes te maken en niet altijd voor het bekende product te kiezen.
En je moet ook in staat zijn om gegevens te migreren en de basisprincipes van integratie met ETL te begrijpen.
Een echte casus
In het recente verleden moest ik een backend maken voor een mobiele applicatie. Tegen de tijd dat ik eraan begon, was de backend al ontwikkeld en klaar voor implementatie, en het ontwikkelingsteam had ongeveer twee jaar aan dit project gewerkt. Hierbij waren de volgende taken gesteld:
- CI/CD opzetten;
- architectuur review uitvoeren;
- alles in gebruik nemen.
De applicatie zelf was microservices-gebaseerd, en de code in Python/Django was vanaf nul ontwikkeld en direct in GCP. Wat de doelgroep betreft, ging men ervan uit dat er twee regio’s zouden zijn — de VS en de EU, en het verkeer werd verdeeld via een Global Load Balancer. Alle workloads en rekenkracht werkten in Google Kubernetes Engine.
Wat de gegevens betreft, waren er 3 structuren:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
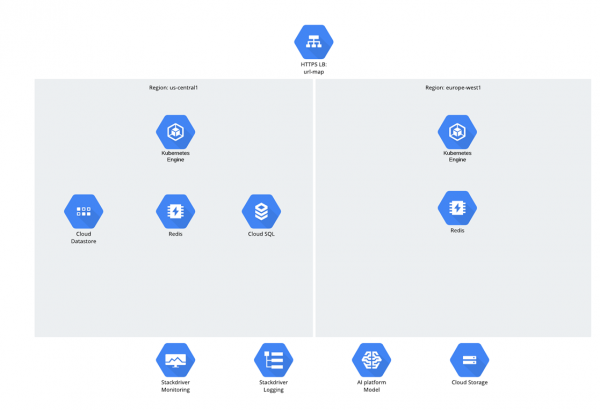
Er zou de vraag kunnen ontstaan waarom Cloud SQL is gekozen? Eerlijk gezegd geeft deze vraag in de afgelopen jaren een ongemakkelijke pauze — het lijkt alsof mensen verlegen zijn om met relationele databases te werken, maar desondanks blijven ze ze actief gebruiken ;-).
Wat ons geval betreft, werd Cloud SQL om de volgende redenen gekozen:
- Zoals eerder vermeld, werd de applicatie ontwikkeld met Django, en het bevat een model dat permanente gegevens uit de SQL-database omzet in Python-objecten (Django ORM).
- Het framework ondersteunde een redelijk eindige lijst van databasebeheersystemen:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Bijgevolg werd PostgreSQL intuïtief uit deze lijst gekozen (we kiezen toch geen Oracle, toch?).
Wat ontbrak:
- de applicatie was alleen in twee regio's uitgerold, en er waren plannen voor een derde (Azië);
- de database bevond zich in de Noord-Amerikaanse regio (Iowa);
- van de kant van de klant waren er zorgen over mogelijke vertragingen in de toegang uit Europa en Azië en onderbrekingen in de dienstverlening in het geval van een uitval van de database.
Hoewel Django zelf met meerdere databases tegelijkertijd kan werken en deze kan splitsen naar lezen en schrijven, waren er in de applicatie niet veel schrijfbewerkingen (meer dan 90% was lezen). In het algemeen, als het mogelijk was om een read-replica van de hoofd-database in Europa en Azië te maken, zou dat een compromisoplossing zijn geweest. Wat was daar zo moeilijk aan?
De moeilijkheid lag in het feit dat de klant niet wilde afzien van het gebruik van managed services en Cloud SQL. En de mogelijkheden van Cloud SQL zijn momenteel beperkt. Cloud SQL ondersteunt hoge beschikbaarheid (HA) en Read Replica (RR), maar die laatste wordt alleen in één regio ondersteund. Door een database in de Amerikaanse regio te creëren, kan je met Cloud SQL geen read-replica in de Europese regio maken, hoewel PostgreSQL dat zelf wel toelaat. Correspondentie met werknemers van Google leidde tot niets en eindigde met beloftes in de trant van 'we zijn ons bewust van het probleem en werken eraan, het zal ooit opgelost worden'.
Als we de mogelijkheden van Cloud SQL puntsgewijs zouden opsommen, zou het er ongeveer als volgt uitzien:
1. Hoge beschikbaarheid (HA):
- binnen één regio;
- via schijfreplicatie;
- de mechanismen van PostgreSQL worden niet gebruikt;
- automatisch en handmatig beheer is mogelijk — failover/failback;
- tijdens de switch is de database enkele minuten niet beschikbaar.
2. Read Replica (RR):
- binnen één regio;
- hot standby;
- PostgreSQL streaming replicatie.
Bovendien, zoals gebruikelijk, kom je bij het kiezen van een technologie altijd beperkingen tegen. de klant wilde geen entiteiten vermenigvuldigen en IaaS gebruiken, behalve via GKE;:
- de klant wilde geen self-service PostgreSQL/MySQL uitrollen;
- de klant wilde geen self-service PostgreSQL/MySQL implementeren;
- Trouwens, Google Spanner zou prima zijn, ware het niet de prijs. Maar Django ORM kan er niet mee werken, anders is het een prima product.
Gelet op de situatie, ontvang ik een wervende vraag van de opdrachtgever: «Kunnen jullie iets soortgelijks maken dat lijkt op Google Spanner, maar ook werkt met Django ORM?»
Oplossing optie № 0
Als eerste kwam het volgende in me op:
- vast te houden aan CloudSQL;
- er zal in geen enkele vorm ingebouwde replicatie tussen regio's zijn;
- te proberen een replica aan de bestaande Cloud SQL by PostgreSQL te koppelen;
- ergens en op een bepaalde manier een PostgreSQL-instantie draaien, maar tenminste de master niet aanraken.
Helaas bleek dat zo niet mogelijk was, omdat er geen toegang tot de host is (die is helemaal in een ander project) — pg_hba en dergelijke, en ook geen toegang onder superuser.
Oplossing optie № 1
Na opnieuw te hebben nagedacht en met inachtneming van de eerdere omstandigheden, wijzigde de gedachtegang enigszins:
- Proberen nog steeds binnen CloudSQL te blijven, maar over te stappen naar MySQL, omdat Cloud SQL by MySQL een externe master heeft, die:
— fungeert als proxy voor externe MySQL;
— eruitziet als een MySQL-instantie;
— uitgevonden is voor het migreren van gegevens vanuit andere cloud-omgevingen of On-premises.
Aangezien de configuratie van MySQL-replicatie geen toegang tot de host vereist, werkte alles in principe, maar heel onstabiel en ongemakkelijk. En toen we verder gingen, werd het echt beangstigend, omdat we de hele structuur met terraform uitrolden, en ineens bleek dat externe master niet door terraform ondersteund werd. Ja, Google heeft CLI, maar om de een of andere reden werkte het ook hier sporadisch — soms werd het aangemaakt, soms niet. Mogelijk omdat CLI bedacht is voor het migreren van gegevens van buitenaf, en niet voor replicaties.
Eigenlijk werd het duidelijk dat Cloud SQL totaal niet geschikt is. Zoals ze zeggen, we hebben alles geprobeerd wat we konden.
Oplossing optie № 2
Aangezien het niet lukte om binnen Cloud SQL te blijven, probeerden we de eisen voor een compromisoplossing te formuleren. De eisen waren als volgt:
- werken in Kubernetes, maximaal gebruik van de bronnen en mogelijkheden van Kubernetes (DCS, …) en GCP (LB, …);
- geen ballast van een hoop onnodige cloud-dingen zoals HA proxy;
- mogelijk om HA PostgreSQL of MySQL in de belangrijkste regio te draaien; in andere regio's - HA van de primaire regio plus een kopie daarvan (voor betrouwbaarheid);
- multi master (verbinden was niet echt de bedoeling, maar het was niet heel principieel)
.
Als resultaat van deze eisen kwam er eindelijk iets op de horizon.geschikte opties voor database en middleware:
- MySQL Galera;
- CockroachDB;
- PostgreSQL-hulpmiddelen
:
— pgpool-II;
— Patroni.
MySQL Galera
De MySQL Galera-technologie is ontwikkeld door Codership en is een plugin voor InnoDB. Kenmerken:
- multi-master;
- synchrone replicatie;
- lezen vanaf elke node;
- schrijven naar elke node;
- ingebouwd HA-mechanisme;
- er is een Helm-chart van Bitnami.
CockroachDB
Volgens de beschrijving is het een geweldig project en is het een open source-project geschreven in Go. De belangrijkste speler is Cockroach Labs (opgericht door voormalige Google-medewerkers). Deze relationele database is oorspronkelijk ontworpen om gedistribueerd (met horizontale schaalbaarheid ‘out of the box’) en failover-veilig te zijn. De auteurs hebben als doel gesteld ‘de rijkdom van SQL-functionaliteit te combineren met de horizontale beschikbaarheid, die gebruikelijk is voor NoSQL-oplossingen’.
Als aangename bonus — ondersteuning voor het PostgreSQL-connectieprotocol.
Pgpool
Dit is een laag bovenop PostgreSQL; eigenlijk een nieuwe entiteit die alle verbindingen beheert. Het heeft zijn eigen load balancer en parser, en is gelicenseerd onder de BSD-licentie. Het biedt uitgebreide mogelijkheden, maar ziet er enigszins intimiderend uit, omdat het bestaan van een nieuwe entiteit potentieel extra problemen kan opleveren.
Patroni
Dit is het laatste waar ik op viel, en zoals het bleek, niet zonder reden. Patroni is een open source-tool die in wezen een daemon in Python is, die automatisch PostgreSQL-clusters met verschillende replicatietypen en automatische roloverschakeling beheert. Het ding bleek erg interessant omdat het goed integreert met Kubernetes en geen nieuwe entiteiten met zich meebrengt.
Wat uiteindelijk werd gekozen
De keuze was niet eenvoudig:
- CockroachDB — geweldig, maar eng;
- MySQL Galera — ook niet slecht, wordt op veel plaatsen gebruikt, maar MySQL;
- Pgpool — te veel overbodige entiteiten, matige integratie met de cloud en K8s;
- Patroni — uitstekende integratie met K8s, geen overbodige entiteiten, goed geïntegreerd met GCP LB.
Dus de keuze viel op Patroni.
Conclusies
Het is tijd om een kort overzicht te geven. Ja, de wereld van IT-infrastructuur is aanzienlijk veranderd, en dit is nog maar het begin. En als cloud vroeger slechts een ander type infrastructuur was, is het nu anders. Bovendien verschijnen innovaties in de cloud constant, en zullen mogelijk alleen in de cloud verschijnen en later, door middel van start-ups, naar On-premises worden overgebracht.
Wat betreft SQL, SQL zal blijven bestaan. Dit betekent dat je PostgreSQL en MySQL moet kennen en ermee moet kunnen werken, maar nog belangrijker is het om ze op de juiste manier toe te passen.
Bron: habr.com
