

Hoe complexer het systeem, des te meer het wordt overladen met allerlei waarschuwingen. En er ontstaat de behoefte om op deze waarschuwingen te reageren, ze te aggregeren en te visualiseren. Ik denk dat dit een situatie is die velen tot een zenuwtrekje bekend voorkomt.
De oplossing waar we het over gaan hebben is niet de meest verrassende, maar een volledige artikel over dit onderwerp kan ik niet vinden.
Daarom besloot ik de ervaring van FunCorp te delen en te vertellen hoe het proces van de diensten is georganiseerd, wie er belt, waarom en hoe dit allemaal kan worden bekeken.
Wat is PagerDuty?
Dus, om al deze taken op te lossen, begonnen we naar een handige tool te zoeken. Na korte zoektocht hebben we onze keuze laten vallen op PagerDuty. PD leek ons een behoorlijk complete en beknopte oplossing met veel integraties en instellingen. Wat is het precies?
Kort gezegd, PagerDuty is een platform voor het verwerken van incidenten, dat binnenkomende incidenten kan behandelen via verschillende integraties, het dienstrooster kan inrichten en vervolgens alerts naar de dienstdoende engineer kan sturen, afhankelijk van het niveau van het incident (bij een hoog niveau — een telefoontje, bij een laag niveau — een push van de applicatie/sms).
Wie is de dienstdoende?
Dat is waarschijnlijk het eerste waar we met de configuratie van PD moeten beginnen.
Bij FunCorp, zoals in andere bedrijven, is er een eervolle functie van de dienstdoende. Deze wordt elke dag van ingenieur op ingenieur doorgegeven. Er is een zogenaamde eerste en tweede lijn van reactie op een alert van PagerDuty. Stel dat er een alert binnenkomt met hoge prioriteit, en als er binnen 10 minuten na het telefoontje naar de dienstdoende uit de eerste lijn geen reactie is (dat wil zeggen, het is niet in status acknowledged of resolved omgezet), dan gaat het telefoontje naar de tweede dienstdoende engineer. Dit wordt in PagerDuty ingesteld via Escalation Policies.
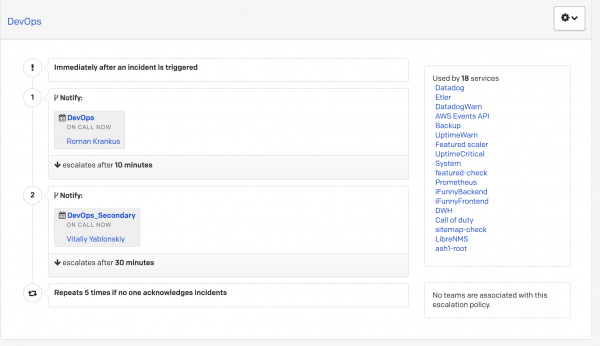
Als ook de tweede dienstdoende niet reageert, dan keert de melding terug naar de hoofd dienstdoende.
Op deze manier kan geen enkele binnenkomende alert met hoge prioriteit onbehandeld blijven.
Laten we nu eens kijken waar incidenten vandaan kunnen komen.
Welke integraties gebruiken we?
In PD stromen veel verschillende incidenten binnen van verschillende diensten. We hebben momenteel ongeveer 25 van zulke diensten, en voor hun verwerking maken we gebruik van enkele kant-en-klare integraties.
- Prometheus
Het belangrijkste systeem voor het verzamelen van metrics is Prometheus. Hierover is al veel geschreven op Habr, ik zal alleen zeggen dat we er meerdere hebben voor verschillende omgevingen: één verzamelt metrics van virtuele machines en Docker, de andere van Amazon-diensten, de derde van 'echte machines'. Over het algemeen wordt Telegraf gebruikt als metrics-exporteur.
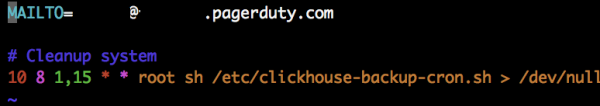
Hier is het, geloof ik, ook duidelijk uit de naam. Deze integratie wordt gebruikt om meldingen te versturen van bepaalde scripts die via cron worden uitgevoerd. PD geeft je een adres dat je kunt gebruiken om e-mails te verzenden. Bij het aanmaken van een service met zo'n integratie kun je prioriteiten instellen in welke volgorde binnenkomende incidenten worden verwerkt, en hoe precies een alert moet worden aangemaakt (voor elke binnenkomende e-mail, voor een binnenkomende e-mail + een bepaalde regel, enzovoort).
- Slack
Naar mijn mening is dit een zeer interessante integratie. Er zijn gevallen waarin er iets gebeurt, maar het niet wordt gedekt door incidenten. Daarom hebben we een integratie uit Slack toegevoegd om een incident te creëren. Dat wil zeggen, in de bedrijfs-Slack kun je schrijven /callofduty все тормозит и скоро сломается en PD zal dit verwerken en een incident naar de wachtende engineer sturen.
We doen:
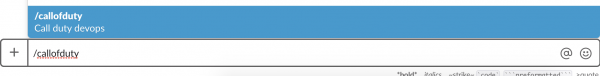
We zien:
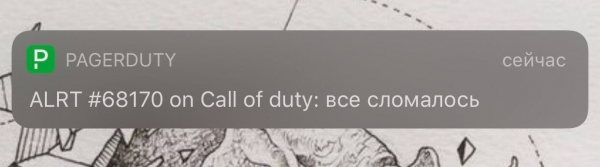
- API
Integratie via HTTP. Hier is eigenlijk niets bijzonder, gewoon een POST-verzoek met een body in JSON-formaat. Bijvoorbeeld, interessant: we gebruiken het voor externe monitoring met . Deze service controleert de beschikbaarheid van onze websites vanuit verschillende delen van de wereld. In het geval dat we een onacceptabele responscode ontvangen (bijvoorbeeld, 502), wordt er een incident aangemaakt en gaat alles verder volgens de hierboven beschreven keten. In StatusCake is er ook de mogelijkheid om interne URL's, de vervaldatum van SSL-certificaten of domeinen te monitoren.
- LibreNMS
Dit is nog een ander monitoringsysteem, meer informatie hierover is te lezen op hun website . Hiermee monitoren we netwerkinterfaces en iDRAC van servers.
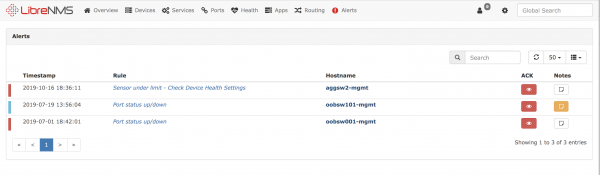
Er waren ook integraties zoals Datadog, CloudWatch. Meer informatie over wat er met hen is gebeurd, kan worden bekeken .
Visualisatie
Het belangrijkste systeem voor het informeren over incidenten is Slack. In een speciale chat worden alle binnenkomende incidenten in PD geschreven, en als hun status verandert, wordt dat ook in de chat weergegeven.
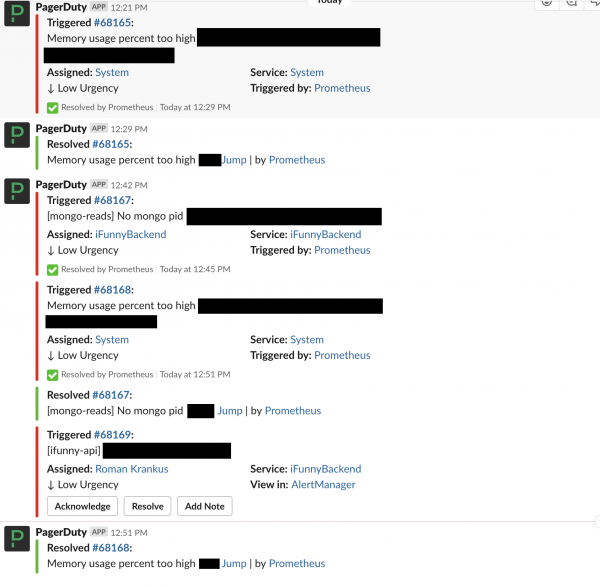
Toen de mogelijkheid ontstond om nuttige gegevens op de aan het plafond hangende monitoren weer te geven, realiseerden we ons plotseling dat wij (in de devops-afdeling) niets te tonen hadden. Er is geweldige Grafana, maar die kan niet alles dekken en medewerkers reageren op meldingen, niet op grafieken.
Na een grondige, maar vruchteloze zoektocht op GitHub naar een beknopt en informatief 'board' voor PD, hebben we besloten om onze eigen versie te maken — slechts met de zaken die wij nodig hebben. Hoewel het aanvankelijk het idee was om de interface van PD zelf op het scherm weer te geven, zag dat er nog onhandiger uit.
Om het te schrijven, is het voldoende om een sleutel van PD met alleen-lezen rechten te verkrijgen.
En dit is wat we hebben gemaakt:
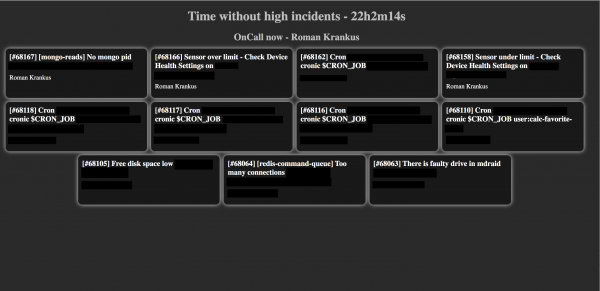
Op het scherm worden actuele open incidenten weergegeven, de naam van de huidige dienstdoende engineer uit het gekozen rooster en de tijd zonder hoog-prioriteitsincident (het paneel met het hoge-prioriteitsincident wordt rood gemarkeerd).
.
Uiteindelijk hebben we een gebruiksvriendelijk dashboard gekregen om al onze incidenten in te zien. Ik ben blij als iemand van jullie onze ervaring kan gebruiken.
Bron: habr.com
