

Hallo, Habr!
Ik werk in het team van Tinkoff dat zich bezighoudt met de ontwikkeling van ons eigen notificatiecentrum. Voor het grootste deel ontwikkel ik in Java met Spring Boot en los ik verschillende technische problemen op die zich in het project voordoen.
De meeste van onze microservices communiceren asynchroon met elkaar via een berichtenbroker. Voorheen gebruikten we IBM MQ als broker, maar die kon de belasting niet meer aan, hoewel hij een hoge leveringsgarantie had.
Als vervanging werd Apache Kafka voorgesteld, dat een hoge schaalbaarheid biedt, maar helaas vereist het praktisch een individuele benadering van configuratie voor verschillende scenario's. Bovendien bood het mechanisme voor at least once delivery, dat standaard in Kafka werkt, niet de noodzakelijke consistentie uit de doos. Verder deel ik onze ervaring met de configuratie van Kafka en zal ik vertellen hoe je exactly once delivery kunt instellen en ermee kunt leven.
Gegarandeerde levering en meer
De parameters die verder aan bod komen, helpen een aantal problemen met standaard verbindingsinstellingen te voorkomen. Maar eerst wil ik aandacht besteden aan één parameter die het mogelijke debuggen vergemakkelijkt.
Dat helpt hierbij client.id voor Producer en Consumer. Op het eerste gezicht kan de naam van de applicatie als waarde worden gebruikt, en in de meeste gevallen zal dit werken. Echter, de situatie waarin een applicatie meerdere Consumer's gebruikt en je ze dezelfde client.id geeft, leidt tot de volgende waarschuwing:
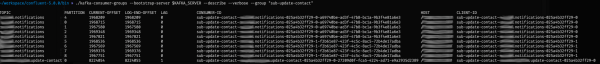
org.apache.kafka.common.utils.AppInfoParser — Error registering AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Als je JMX wilt gebruiken in een applicatie met Kafka, kan dit een probleem zijn. Voor dit geval is het het beste om voor de waarde van client.id een combinatie van de naam van de applicatie en bijvoorbeeld de naam van de topic te gebruiken. Het resultaat van onze configuratie is te zien in de uitvoer van de opdracht kafka-consumer-groups uit de tools van Confluent:
Laten we nu het scenario van gegarandeerde berichtlevering bekijken. Een Kafka Producer heeft een parameter acks, waarmee je kunt instellen na hoeveel acknowledges de clusterleider een bericht als succesvol geschreven beschouwt. Deze parameter kan de volgende waarden aannemen:
- 0 — acknowledges worden niet geteld.
- 1 — standaard parameter, acknowledge is alleen nodig van 1 replica.
- −1 — bevestiging vereist van alle gesynchroniseerde replica's (clusterconfiguratie) min.insync.replicas).
Uit de opgesomde waarden blijkt dat een acks van −1 de sterkste garanties biedt dat een bericht niet verloren gaat.
Zoals we allemaal weten, zijn gedistribueerde systemen onbetrouwbaar. Om jezelf te beschermen tegen tijdelijk falen, biedt de Kafka Producer de parameter retries, waarmee het aantal pogingen voor opnieuw verzenden in te stellen is binnen delivery.timeout.ms. Aangezien de parameter retries standaard de waarde Integer.MAX_VALUE (2147483647) heeft, kan het aantal herhaalde verzendpogingen worden geregeld door alleen delivery.timeout.ms te wijzigen.
Laten we overgaan naar exactly once delivery
De genoemde instellingen stellen onze Producer in staat om berichten met een hoge garantie af te leveren. Laten we nu bespreken hoe we kunnen garanderen dat slechts één kopie van een bericht in een Kafka-topic wordt geschreven? In de eenvoudigste geval moet de parameter enable.idempotence op true worden ingesteld. Idempotentie garandeert dat slechts één bericht in een specifieke partitie van één topic wordt geschreven. Een voorwaarde voor het inschakelen van idempotentie zijn de waarden acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Als deze parameters niet door de ontwikkelaar zijn opgegeven, worden automatisch de hierboven aangegeven waarden ingesteld.
Wanneer idempotentie is ingesteld, moet ervoor gezorgd worden dat dezelfde berichten elke keer in dezelfde partities terechtkomen. Dit kan worden bereikt door de sleutel en de parameter partitioner.class in de Producer in te stellen. Laten we beginnen met de sleutel. Deze moet elk keer hetzelfde zijn bij verzenden. Dit is eenvoudig te bereiken door een zakelijke identificator uit het oorspronkelijke bericht te gebruiken. De parameter partitioner.class heeft als standaardwaarde — . Bij deze standaard partitioneringsstrategie handelen we als volgt:
- Als de partitie expliciet is opgegeven bij het verzenden van het bericht, gebruiken we deze.
- Als er geen partitie is opgegeven, maar er een sleutel is opgegeven — kiezen we de partitie op basis van de hash van de sleutel.
- Als er geen partitie en geen sleutel zijn opgegeven — kiezen we de partities op volgorde (round-robin).
Bovendien, het gebruik van een sleutel en idempotente verzending met de parameter max.in.flight.requests.per.connection = 1 geeft je gestructureerde berichtverwerking op de Consumer. Vergeet niet dat als er toegangsbeheer op je cluster is ingesteld, je rechten nodig hebt voor idempotente records in het onderwerp.
Als je niet genoeg mogelijkheden hebt voor idempotent verzenden op basis van een sleutel of als de logica aan de Producer kant vereist dat de gegevensconsistentie tussen verschillende partities wordt behouden, dan zullen transacties nuttig zijn. Bovendien kun je met een ketentransactie een record in Kafka bij benadering synchroniseren met een record in de database. Voor het inschakelen van transactioneel verzenden moet de Producer idempotent zijn, en moet je ook transactional.id. Als op je Kafka-cluster toegangsbeheer is ingesteld, heb je voor transactionele records, net zoals voor idempotente, schrijfrechten nodig die kunnen worden verleend via een masker dat gebruikmaakt van de waarde die is opgeslagen in transactional.id.
Formeel kan als transactiekenmerk elke tekenreeks worden gebruikt, bijvoorbeeld de naam van de applicatie. Maar als je meerdere instanties van dezelfde applicatie met dezelfde transactional.id uitvoert, zal de eerste opgestarte instantie met een fout worden beëindigd, omdat Kafka het beschouwt als een zombieproces.
org.apache.kafka.common.errors.ProducerFencedException: Producer heeft een bewerking geprobeerd met een oude epoch. Of er is een nieuwe producer met dezelfde transactionalId, of de transactie van de producer is door de broker verlopen.Om dit probleem op te lossen, voegen we een suffix toe aan de naam van de applicatie in de vorm van de hostnaam, die we uit omgevingsvariabelen halen.
Producer is ingesteld, maar transacties in Kafka beheren alleen de zichtbaarheid van het bericht. Ongeacht de status van de transactie komt het bericht onmiddellijk in het onderwerp terecht, maar heeft het extra systeemeigenschappen.
Om ervoor te zorgen dat dergelijke berichten niet te vroeg door de Consumer worden gelezen, moet deze de parameter isolation.level instellen op read_committed. Een dergelijke Consumer kan niet-transactie berichten zoals voorheen lezen, en transactie berichten alleen na de commit.
Als je alle eerder genoemde instellingen hebt geconfigureerd, heb je exact één keer afleveren ingesteld. Gefeliciteerd!
Maar er is nog een nuance. De Transactional.id, die we eerder hebben ingesteld, is in feite een prefix voor de transactie. Aan de transactiebeheerder wordt een volgnummer toegevoegd. De verkregen identifier wordt uitgegeven op transactional.id.expiration.ms, dat geconfigureerd is op een Kafka-cluster en standaard de waarde «7 dagen» heeft. Als de applicatie in deze periode geen berichten heeft ontvangen, krijgt u bij de volgende transactie een foutmelding. InvalidPidMappingException. Daarna zal de transactionele coördinator een nieuw volgnummer toekennen voor de volgende transactie. Daarbij kan het bericht verloren gaan als de InvalidPidMappingException niet correct wordt afgehandeld.
In plaats van de resultaten
Zoals je kunt zien, is het niet genoeg om simpelweg berichten naar Kafka te sturen. Je moet een combinatie van parameters kiezen en bereid zijn snel wijzigingen aan te brengen. In dit artikel heb ik geprobeerd de configuratie van exactly once delivery in detail uit te leggen en heb ik verschillende problemen met de configuraties client.id en transactional.id beschreven waarmee we te maken hebben gehad. Hieronder zijn beknopt de instellingen voor de Producer en Consumer weergegeven.
Producer:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — voor geordende verzending)
- transactional.id = ${application-name}-${hostname}
Consumer:
- isolation.level = read_committed
Om fouten in toekomstige applicaties te minimaliseren, hebben we onze eigen wrapper bovenop de spring-configuratie gemaakt, waarin al waarden voor enkele van de genoemde parameters zijn ingesteld.
Hier is een paar materialen voor zelfstudie:
Bron: habr.com
