

Het was 2019, en we hadden nog steeds geen standaardoplossing voor logaggregatie in Kubernetes. In dit artikel willen we, aan de hand van voorbeelden uit de praktijk, onze zoektocht, de problemen die we tegenkwamen en hun oplossingen delen.
Echter, laat ik vooropstellen dat verschillende klanten heel verschillende betekenissen toekennen aan logverzameling:
- sommigen willen security- en auditlogs zien;
- anderen verlangden centrale logging van de hele infrastructuur;
- en weer anderen zijn tevreden met alleen de logs van de applicatie, waarbij bijvoorbeeld de load balancers worden uitgesloten.
Hoe we verschillende wensen realiseerden en met welke moeilijkheden we te maken kregen, dat lees je verderop.
Theorie: over tools voor logs
Achtergrond over de componenten van het logging systeem
Logging heeft een lange weg afgelegd, waardoor methoden voor het verzamelen en analyseren van logs zijn ontwikkeld, die we nu toepassen. Al in de jaren '50 verscheen in Fortran een analogie van standaard in- en uitvoerstromen, die de programmeur hielpen bij het debuggen van zijn programma. Dit waren de eerste computerlogs die het leven van de programmeurs van die tijd vergemakkelijkten. Tegenwoordig zien we hierin de eerste component van het logging systeem — de bron of 'producent' (producer) van logs.
De informatica heeft niet stilgestaan: er verschenen computernetwerken, de eerste clusters… Complexe systemen die uit meerdere computers bestonden begonnen te functioneren. Nu moesten systeembeheerders logs van verschillende machines verzamelen, en in speciale gevallen konden ze ook kernberichten van het besturingssysteem toevoegen voor het geval een systeemfout moest worden onderzocht. Om systemen voor gecentraliseerde logverzameling te beschrijven, werd begin jaren 2000 , dat remote_syslog standaardiseerde, gepubliceerd. Zo ontstond er weer een belangrijke component: de logcollector en hun opslag.
Met de toename van het volume aan logs en de wijdverspreide invoering van webtechnologieën kwam de vraag naar voren hoe logs gebruikers op een handige manier konden worden gepresenteerd. Eenvoudige console-tools (awk/sed/grep) maakten plaats voor meer geavanceerde logviewers — de derde component.
Met de toename van het logvolume werd ook duidelijk dat logs nodig zijn, maar niet allemaal. En bovendien vereisen verschillende logs verschillende niveaus van behoud: sommige kunnen na een dag verloren gaan, terwijl andere vijf jaar moeten worden bewaard. Zo is er een component voor filtering en routering van gegevensstromen aan het logging-systeem toegevoegd — laten we het noemen filter.
De opslagplaatsen hebben ook een serieuze sprong gemaakt: van gewone bestanden zijn ze overgestapt op relationele databases en daarna op documentgeoriënteerde opslagplaatsen (bijvoorbeeld Elasticsearch). Zo is de opslag gescheiden van de verzamelaar.
Uiteindelijk is het begrip log uitgebreid tot een soort abstracte stroom van evenementen die we willen bewaren voor de geschiedenis. En meer specifiek — voor dat geval wanneer er onderzoek moet worden gedaan of een analytisch rapport moet worden opgesteld…
Als gevolg daarvan is logging in een relatief korte tijd een belangrijke subsysteem geworden, dat terecht kan worden aangeduid als een van de onderdeel van Big Data.
Als ooit gewone print-outs voldoende zouden kunnen zijn voor een 'logging-systeem', dan is de situatie nu sterk veranderd.
Kubernetes en logs
Toen Kubernetes de infrastructuur binnentrok, opende de al bestaande logging-probleem ook deze kant. In zekere zin werd het zelfs pijnlijker: het beheer van het infrastructuurplatform werd niet alleen vereenvoudigd, maar ook tegelijkertijd gecompliceerd. Veel oude diensten begonnen met de migratie naar microservices. In de context van logs kwam dit tot uiting in het toenemende aantal logbronnen, hun speciale levenscyclus, en de noodzaak om de onderlinge relaties van alle systeemcomponenten via logs te volgen…
Als vooruitblik kan ik vaststellen dat er op dit moment helaas geen gestandaardiseerde logging-optie voor Kubernetes is die zich gunstig onderscheidt van alle anderen. De meest populaire schema's in de gemeenschap komen neer op de volgende:
- iemand zet een stack op EFK (Elasticsearch, Fluentd, Kibana);
- iemand probeert de onlangs vrijgegeven of gebruikt ;
- wij (en mogelijk ook niet alleen wij?..) zijn grotendeels tevreden met een eigen ontwikkeling — …
Doorgaans gebruiken we zulke koppelingen in K8s-clusters (voor self-hosted oplossingen):
- ;
- .
Echter, ik zal niet stilstaan bij de instructies voor hun installatie en configuratie. In plaats daarvan richt ik me op hun tekortkomingen en de bredere conclusies over de situatie met logs in het algemeen.
Praktijk met logs in K8s
«Dagelijkse logs», hoeveel van jullie zijn er?..
Gecentraliseerde logverzameling van een behoorlijk grote infrastructuur vereist aanzienlijke middelen, die besteed worden aan het verzamelen, opslaan en verwerken van logs. Tijdens de exploitatie van verschillende projecten zijn we verschillende eisen tegengekomen en de problemen die daaruit voortkwamen.
Laten we ClickHouse proberen
Laten we een gecentraliseerde opslag bekijken in een project met een applicatie die aanzienlijk logs genereert: meer dan 5000 regels per seconde. We beginnen met het werken met zijn logs, door ze in ClickHouse op te slaan.
Zodra maximale realtime vereist is, zal een 4-core server met ClickHouse al overbelast zijn qua schijfsysteem:
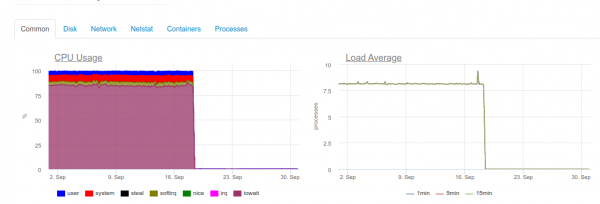
Dit soort belasting is gerelateerd aan het feit dat we proberen zo snel mogelijk in ClickHouse te schrijven. En hierop reageert de database met een verhoogde schijfbelasting, waardoor het dergelijke fouten kan genereren:
DB::Exception: Te veel onderdelen (300). Samensmeltingen worden aanzienlijk langzamer verwerkt dan invoer
Het punt is dat in ClickHouse (waar de loggegevens zijn opgeslagen) hun eigen complicaties hebben bij schrijfoperaties. De ingevoerde gegevens genereren een tijdelijke partition die later samengevoegd wordt met de hoofdtafel. Hierdoor is de invoer zeer veeleisend voor de schijf, en is er een limiet op van toepassing, waarvan we hierboven een melding hebben gekregen: er kunnen niet meer dan 300 subpartities in 1 seconde samensmelten (feitelijk zijn dit 300 invoeren per seconde).
Om dit soort gedrag te voorkomen, in zo groot mogelijke brokken en niet vaker dan 1 keer in de 2 seconden. Echter, het schrijven in grote batches impliceert dat we minder vaak in ClickHouse moeten schrijven. Dit kan op zijn beurt leiden tot buffer overloop en verlies van logs. De oplossing is om de Fluentd-buffer te vergroten, maar dat zal ook het geheugengebruik verhogen.
Opmerking: Een andere problematische kant van onze oplossing met ClickHouse was dat de partitionering in ons geval (loghouse) werd uitgevoerd via externe tabellen die verbonden zijn . Dit leidt ertoe dat bij het ophalen van grote tijdsintervallen teveel werkgeheugen nodig is, omdat de metatabel alle partities doorloopt - zelfs diegene waarvan duidelijk is dat ze de benodigde gegevens niet bevatten. Echter, deze aanpak kan gerust als verouderd worden beschouwd voor de huidige versies van ClickHouse (c ).
Uiteindelijk wordt het duidelijk dat niet elk project over voldoende middelen beschikt voor realtime logverzameling in ClickHouse (met name dat de verdeling ervan niet zinvol zal zijn). Bovendien zal het nodig zijn om een buffer, waar we later nog op terugkomen. De hierboven beschreven situatie is echt. En op dat moment konden we geen betrouwbare en stabiele oplossing aanbieden die de klant tevreden zou stellen en het verzamelen van logs met minimale vertraging mogelijk zou maken...
En Elasticsearch?
Het is bekend dat Elasticsearch grote belasting aankan. Laten we het in hetzelfde project proberen. De belasting ziet er nu als volgt uit:
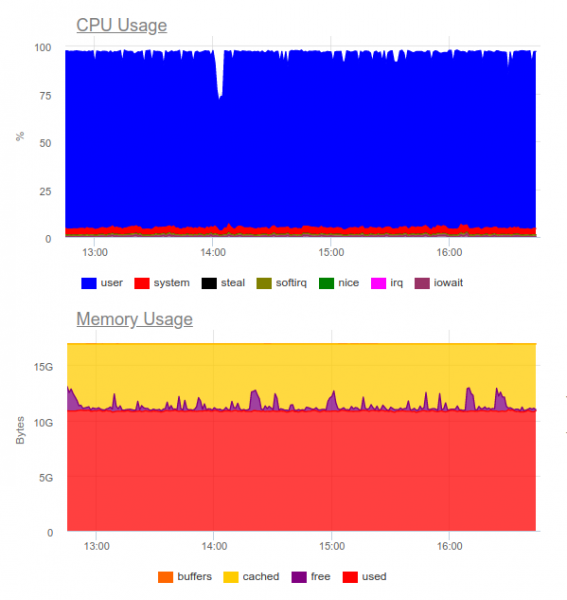
Elasticsearch kon de datastroom verwerken, maar het schrijven van zulke volumes benut de CPU aanzienlijk. Dit wordt opgelost door het opzetten van een cluster. Technisch gezien is dit geen probleem, maar het betekent dat we al ongeveer 8 cores gebruiken voor het werken van het logverzamelsysteem en een extra hoogbelaste component in het systeem hebben...
Conclusie: deze optie kan gerechtvaardigd zijn, maar alleen als het project groot is en het management bereid is aanzienlijke middelen aan het gecentraliseerde loggingsysteem te besteden.
Dan rijst de vanzelfsprekende vraag:
Welke logs zijn echt nodig?
 Laten we proberen de benadering te veranderen: logs moeten tegelijkertijd informatief zijn en niet elk evenement in het systeem dekken. Stel dat we een succesvol e-commercebedrijf hebben. Welke logs zijn belangrijk? Maximale informatie verzamelen, bijvoorbeeld van de betaalgateway - een uitstekend idee. Maar van de service voor het snijden van afbeeldingen in de productcatalogus zijn niet alle logs kritiek voor ons: alleen de fouten en uitgebreide monitoring zijn voldoende (bijvoorbeeld, naar het percentage 500-fouten die deze component genereert).
Zo komen we tot de conclusie dat
gecentraliseerde logging lang niet altijd gerechtvaardigd is . Vaak wil de klant alle logs op één plek verzamelen, terwijl in werkelijkheid slechts ongeveer 5% van de berichten die kritisch zijn voor de business vereist zijn:Heel vaak wil de klant alle logs op één plek verzamelen, terwijl in werkelijkheid slechts ongeveer 5% van de berichten in de logs cruciaal zijn voor het bedrijf.
- Soms is het voldoende om alleen de grootte van de containerlog en de foutmelder (bijvoorbeeld Sentry) in te stellen.
- Voor het onderzoeken van incidenten is vaak een foutmelding en een grote lokale log al voldoende.
- We hebben projecten gehad die alleen functionele tests en foutmeldingssystemen gebruikten. De ontwikkelaar had geen logs nodig — ze zagen alles in de fouttraces.
Illustratie uit de praktijk
Een goed voorbeeld kan een ander verhaal zijn. We kregen een verzoek van het beveiligingsteam van een van onze klanten, die al een commerciële oplossing gebruikte die lang vóór de implementatie van Kubernetes was ontwikkeld.
Het was nodig om het systeem voor gecentraliseerde logverzameling te koppelen aan de bedrijfsensor voor probleemdetectie — QRadar. Dit systeem kan logs ontvangen via het syslog-protocol en ophalen via FTP. Maar het integreren met de remote_syslog-plugin voor fluentd lukte niet meteen. (zoals het bleek, ). De configuratieproblemen met QRadar lagen aan de kant van het beveiligingsteam van de klant.
Als resultaat werden sommige logs, die kritisch waren voor het bedrijf, naar de FTP van QRadar geüpload, terwijl andere direct van de knooppunten via remote syslog werden doorgestuurd. Hiervoor hebben we zelfs een — misschien helpt hij iemand een soortgelijke taak op te lossen… Dankzij het gegenereerde schema kon de klant de kritische logs ontvangen en analyseren (met hun favoriete hulpmiddelen), terwijl wij de kosten voor het loggingsysteem konden verlagen door alleen de logs van de afgelopen maand te bewaren.
Een ander voorbeeld is zeer illustratief voor hoe het niet moet. Een van onze klanten produceerde voor de verwerking van van elke gebeurtenissen van gebruikers een meerregelige ongestructureerde uitvoer van informatie naar de log. Zoals gemakkelijk te raden is, was het extreem onhandig om dergelijke logs te lezen en op te slaan.
Criteria voor logs
Dergelijke voorbeelden leiden tot de conclusie dat naast het kiezen van een logsysteem ook zelf de logs moeten worden ontworpen! Wat zijn de vereisten hier?Logs moeten in een machineleesbaar formaat zijn (bijvoorbeeld JSON).
- Logs moeten compact zijn en de mogelijkheid hebben om het logniveau te wijzigen, zodat mogelijke problemen kunnen worden opgelost. In productieomgevingen moeten systemen met een logniveau zoals worden uitgevoerd.
- Logs moeten compact zijn en moeten de mogelijkheid hebben om het logniveau te wijzigen, zodat eventuele problemen gedebugd kunnen worden. In productieomgevingen moeten systemen echter draaien met een logniveau zoals Waarschuwing of Fout.
- Logs moeten genormaliseerd zijn, dat wil zeggen dat in het logobject alle regels hetzelfde type veld moeten hebben.
Ongeorganiseerde logs kunnen leiden tot problemen bij het laden van logs in de opslag en tot een volledige stopzetting van hun verwerking. Ter illustratie: een voorbeeld van een foutmelding 400, waarmee velen zeker te maken hebben gehad in de logs van fluentd:
2019-10-29 13:10:43 +0000 [waarschuwing]: dump een foutmelding: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Weiger door Elasticsearch"
De fout geeft aan dat je een veld met een stabiele mapping naar de index probeert te verzenden, waarvan het type onbetrouwbaar is. Een eenvoudig voorbeeld is een veld in de nginx-log met een variabele $upstream_status. Dit kan zowel een nummer als een string zijn. Bijvoorbeeld:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
In de logs is te zien dat de server 10.100.0.10 reageerde met een 404-fout en het verzoek ging naar een andere contentopslag. Als resultaat, in de logs, werd de waarde als volgt:
"upstream_response_time": "0.001, 0.007"
Deze situatie is zo gebruikelijk dat het zelfs een aparte .
En hoe zit het met de betrouwbaarheid?
Er zijn gevallen waarin het absoluut noodzakelijk is om alle logs zonder uitzondering te hebben. En met de standaard logverzamelschema's voor K8s, die hierboven zijn voorgesteld/besproken, zijn er problemen.
Bijvoorbeeld, fluentd kan geen logs verzamelen van kortlevende containers. In een van onze projecten leefde de container met database-migratie minder dan 4 seconden voordat deze werd verwijderd, volgens de bijbehorende annotatie:
"helm.sh/hook-delete-policy": hook-succeeded
Hierdoor kwam de log van de migratie niet in de opslag terecht. Het kan helpen om in dit geval het beleid before-hook-creation.
Een ander voorbeeld is de rotatie van Docker-logs. Stel dat er een applicatie is die actief in logs schrijft. Onder normale omstandigheden kunnen we alle logs verwerken, maar zodra er een probleem optreedt — zoals hierboven beschreven met een verkeerd formaat — stopt de verwerking en roteert Docker het bestand. Het resultaat is dat cruciale logs voor het bedrijf verloren kunnen gaan.
Precies daarom Het is belangrijk om logstromen te scheiden, door het verzenden van de meest waardevolle gegevens direct in de applicatie in te bouwen, om hun behoud te waarborgen. Bovendien kan het geen kwaad om een soort ‘logaccumulator’te creëren, die een korte onbeschikbaarheid van de opslag kan overleven terwijl kritische berichten worden bewaard.
Tenslotte moet niet worden vergeten dat het belangrijk is om elke subsysteem goed te monitoren. Anders kun je gemakkelijk geconfronteerd worden met een situatie waarin fluentd zich in een staat bevindt CrashLoopBackOff en dat verstuurt niets, wat kan leiden tot het verlies van belangrijke informatie.
Conclusies
In dit artikel behandelen we geen SaaS-oplossingen zoals Datadog. Veel van de hier beschreven problemen zijn op een of andere manier al opgelost door commerciële bedrijven die gespecialiseerd zijn in logverzameling, maar niet iedereen kan om verschillende redenen SaaS gebruiken. (de belangrijkste redenen zijn kosten en naleving van de 152-FZ).
Gecentraliseerde logverzameling lijkt in eerste instantie een eenvoudige taak, maar is dat in werkelijkheid niet. Het is belangrijk om te onthouden dat:
- Het is alleen nodig om kritieke componenten gedetailleerd te loggen; voor andere systemen kan monitoring en foutverzameling worden ingesteld.
- Logs in productie moeten minimaal zijn om onnodige belasting te voorkomen.
- Logs moeten machineleesbaar, genormaliseerd zijn en een strikte indeling hebben.
- Echt kritieke logs moeten in een aparte stroom worden verzonden, die gescheiden is van de hoofdlogs.
- Het is verstandig om een log-accumulator te overwegen die kan helpen bij pieken in hoge belasting en die de belasting op de opslag gelijkmatiger maakt.
Deze eenvoudige regels, als ze overal worden toegepast, zouden de hierboven beschreven schema's mogelijk maken, zelfs als ze belangrijke componenten (de accumulator) missen. Als je je echter niet aan deze principes houdt, kan de taak gemakkelijk leiden tot nog een hoogbelaste (en tegelijkertijd weinig effectieve) component van het systeem.
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
