

Je hebt opnieuw de taak objectdetectie. Prioriteit is de snelheid van de werking met acceptabele nauwkeurigheid. Neem de YOLOv3-architectuur en train deze verder. De nauwkeurigheid (mAp75) is meer dan 0,95. Maar de snelheid van de uitvoering is nog steeds laag. Verdorie.
Vandaag zullen we kwantisatie vermijden. En onder de kat kijken we naar Model Pruning — het verwijderen van overbodige delen van het netwerk om de inferentie te versnellen zonder de nauwkeurigheid te verliezen. Eerst heel duidelijk — waar, hoeveel en hoe je kunt uitsnijden. We zullen bespreken hoe je dit met de hand kunt doen en waar je het kunt automatiseren. Aan het einde — een repository op keras.
Inleiding
Bij mijn vorige werk, bij het Permse Macroscop, heb ik een gewoonte ontwikkeld — altijd de uitvoeringstijd van algoritmen in de gaten te houden. En de netwerkuitvoering altijd te controleren via een adequaatheidsfilter. Meestal halen state-of-the-art modellen deze filter niet, wat me naar Pruning heeft geleid.
Pruning is een oud onderwerp, dat werd besproken in in 2017. Het belangrijkste idee is het verkleinen van de grootte van het getrainde netwerk zonder verlies van nauwkeurigheid door verschillende knopen te verwijderen. Het klinkt geweldig, maar ik hoor zelden over het gebruik ervan. Misschien zijn er niet genoeg implementaties, zijn er geen Nederlandstalige artikelen of denkt iedereen gewoon dat pruning een geheim is en zwijgt.
Maar laten we het analyseren
Een blik in de biologie
Ik hou ervan als in Deep Learning ideeën uit de biologie worden geïntegreerd. Ze kunnen worden vertrouwd (wist je dat ReLU erg lijkt op ?)
Het proces van Model Pruning is ook vergelijkbaar met biologie. De reactie van het netwerk kan hier worden vergeleken met de plasticiteit van de hersenen. Er zijn een paar interessante voorbeelden in het boek :
- De hersenen van een vrouw die vanaf geboorte maar de helft had, herschreven zichzelf om de functies van de ontbrekende helft uit te voeren.
- Een jongen schoot een deel van zijn hersenen weg dat verantwoordelijk was voor het gezichtsvermogen. In de loop van de tijd namen andere delen van de hersenen deze functies over. (herhalen we niet)
Zo kun je ook zwakke convoluties uit je model snijden. In het uiterste geval kunnen de resterende convoluties de uitgesneden delen vervangen.
Hou je van Transfer Learning of leer je vanaf nul?
Optie nummer één. Je gebruikt Transfer Learning met Yolov3, Retina, Mask-RCNN of U-Net. Maar vaak hoeven we geen 80 klassen objecten te herkennen, zoals in COCO. In mijn ervaring blijft het vaak beperkt tot 1-2 klassen. We zouden kunnen veronderstellen dat de architectuur voor 80 klassen hier overbodig is. Het ligt voor de hand om te denken dat we de architectuur moeten verkleinen. Bovendien willen we dit graag doen zonder dat de al bestaande voorgetrainde gewichten verloren gaan.
Optie nummer twee. Misschien heb je veel data en rekenkracht, of heb je gewoon een uiterst aangepaste architectuur nodig. Dat maakt niet uit. Maar je traint het netwerk vanaf nul. De normale volgorde is: we bekijken de datastructuur, kiezen een OVERBODIGE architectuur qua vermogen en duwen dropout om overfitting te voorkomen. Ik heb dropout van 0.6 gezien, Karl.
In beide gevallen kan het netwerk verkleind worden. We zijn gemotiveerd. Laten we nu eens kijken wat pruning inhoudt.
Algemene algoritme
We hebben besloten dat we convoluties kunnen verwijderen. Dit lijkt vrij eenvoudig:
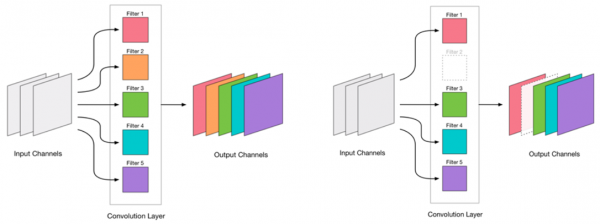
Het verwijderen van een willekeurige convolutie is stressvol voor het netwerk, wat meestal leidt tot een zekere toename van de fout. Enerzijds is deze fouttoename een indicator van hoe goed we de convoluties verwijderen (bijvoorbeeld een grote toename geeft aan dat we iets niet goed doen). Maar een kleine toename is vaak acceptabel en kan vaak worden gecorrigeerd met een lichte hertraining met een kleine LR. Laten we een stap toevoegen voor de hertraining:
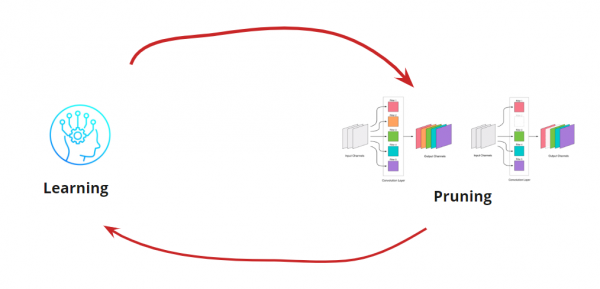
Nu moeten we begrijpen wanneer we onze cyclus van Learning<->Pruning willen stoppen. Hier kunnen exotische situaties zijn waarbij we het netwerk tot een bepaalde grootte en snelheid willen verkleinen (bijvoorbeeld voor mobiele apparaten). Echter, de meest voorkomende optie is om door te gaan met de cyclus totdat de fout boven de toegestane drempel komt. Laten we een voorwaarde toevoegen:
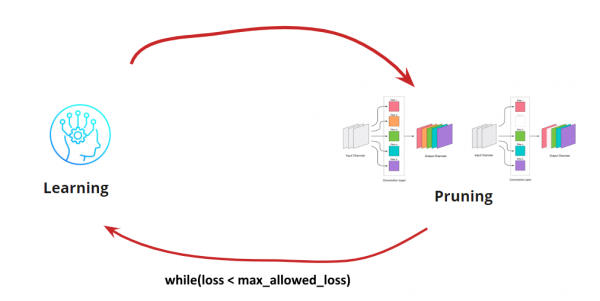
Dus, het algoritme wordt duidelijk. Het enige wat overblijft is te bespreken hoe we te verwijderen convoluties kunnen identificeren.
Zoeken naar te verwijderen convoluties
We moeten enkele convoluties verwijderen. Gewoon maar iets in de lucht schieten en alle convoluties verwijderen is een slecht idee, hoewel het wel zou werken. Maar omdat we een hoofd hebben, kunnen we nadenken en proberen 'zwakke' convoluties te identificeren voor verwijdering. Er zijn verschillende opties:
- . Het idee is dat convoluties met lage gewichten een geringe bijdrage leveren aan de uiteindelijke beslissing.
- De laagste L1-metriek met inachtneming van het gemiddelde en de standaardafwijking. We voegen een inschatting van de verdelingskarakteristiek toe.
- . Een nauwkeurigere bepaling van onbeduidende convoluties, maar zeer tijd- en resource-intensief.
- Andere
Elk van de opties heeft recht op bestaan en zijn eigen implementatiekenmerken. We zullen de optie met de laagste L1-maat bekijken
Handmatig proces voor YOLOv3
In de oorspronkelijke architectuur zijn er residuele blokken. Maar hoe geweldig ze ook zijn voor diepe netwerken, ze zullen ons iets in de weg staan. Het probleem is dat we convoluties met verschillende indexen in deze lagen niet kunnen verwijderen:
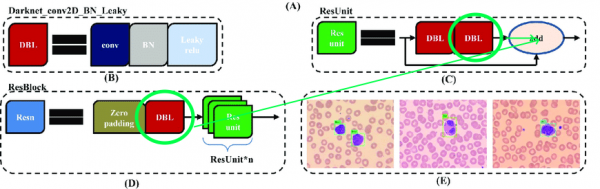
Daarom zullen we de lagen identificeren waarvan we de convoluties vrij kunnen verwijderen:

Laten we nu een werkcyclus opzetten:
- Activaties exporteren
- Bepalen hoeveel te snijden
- Snijden
- Train 10 epochs met LR=1e-4
- Testen
Het is nuttig om convoluties te exporteren om te beoordelen welk deel we bij een bepaalde stap kunnen verwijderen. Voorbeelden van export:
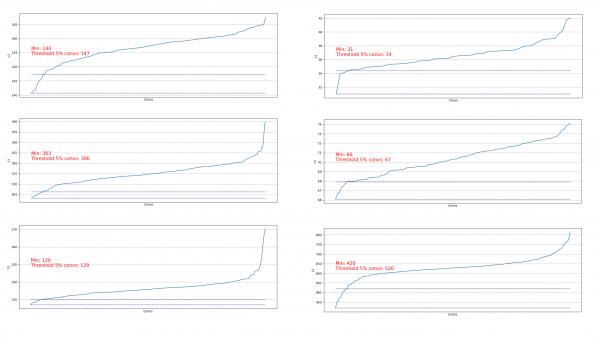
We zien dat bijna overal 5% van de convoluties een zeer lage L1-norm heeft en we ze kunnen verwijderen. Bij elke stap werd deze export herhaald en werd beoordeeld uit welke lagen en hoeveel er kan worden gesneden.
Het hele proces viel binnen 4 stappen (hier en overal zijn de getallen voor RTX 2060 Super):
| Stap | mAp75 | Aantal parameters, mln | Netwerk grootte, mb | Van het oorspronkelijke, % | Tijd per run, ms | Sneedvoorwaarde |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% van allemaal |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% van allemaal |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% voor lagen met 400+ convoluties |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% voor lagen met 100+ convoluties |
Bij stap 2 kwam er een positief effect bij — de batch-grootte 4 paste in het geheugen, wat het proces van fine-tuning aanzienlijk versneld heeft.
Bij stap 4 werd het proces gestopt, omdat zelfs langdurige fine-tuning de mAp75 niet naar de oude waarden kon brengen.
Uiteindelijk is het gelukt om de inferentie te versnellen met 15%, de grootte te verminderen met 35% en geen nauwkeurigheid te verliezen.
Automatisering voor eenvoudigere architecturen
Voor eenvoudigere netwerkarchitecturen (zonder voorwaardelijke add, concatenate en residuele blokken) kan men zich gerust richten op de verwerking van alle convolutielaag en het proces van het snijden van convoluties automatiseren.
Deze optie heb ik geïmplementeerd .
Het is heel eenvoudig: u heeft alleen een verliesfunctie, optimizer en batch-generatoren nodig:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Indien nodig kunnen de configuratieparameters worden gewijzigd:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # het aantal epochs voor training tussen de prune-stappen
    "stop_loss": 0.1, # verlies voor het stoppen van het proces
    "pruning_percent_step": 0.05, # deel van convs om te verwijderen bij elke prune-stap
    "pruning_standart_deviation_part": 0.2 # verschuiving voor het beperken van de prune-deel
}
Er is ook een beperking geïmplementeerd op basis van de standaardafwijking. Het doel is om het verwijderde deel te beperken, met uitzondering van convoluties met al "voldoende" L1-metingen:
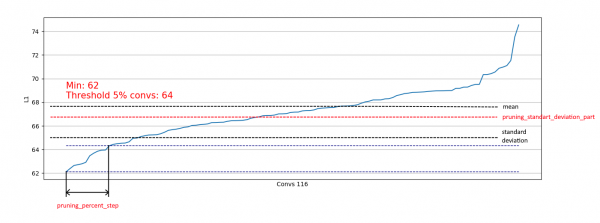
Hierdoor kunnen we alleen zwakke convoluties uit verdelingen zoals de rechter verwijderen en niet beïnvloeden hoe we verwijderen uit verdelingen zoals de linker:
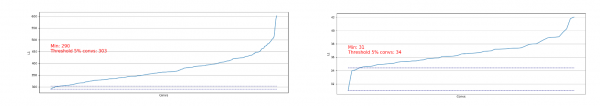
Bij benadering van een normale verdeling kan de coefficient pruning_standart_deviation_part worden gekozen uit:
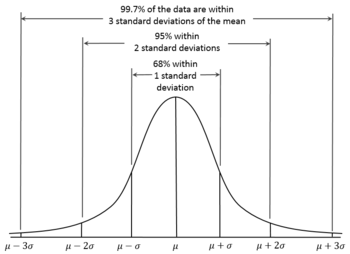
Ik raad een marge van 2 sigma aan. Of je kunt deze eigenschap negeren, waarbij je de waarde < 1.0 laat.
Het resultaat is een grafiek van de netwerkgrootte, verlies en verwerkingstijd van het netwerk over de hele test, genormaliseerd naar 1.0. Bijvoorbeeld, hier is de netwerkgrootte bijna met de helft verminderd zonder kwaliteitsverlies (een kleine convolutienetwerk met 100k gewichten):
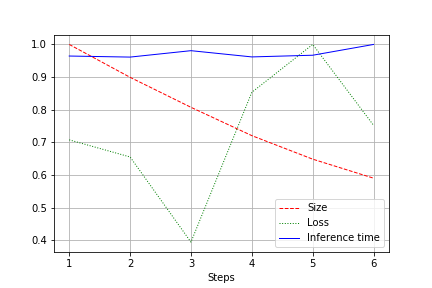
De verwerkingssnelheid is onderhevig aan normale fluktuaties en is praktisch niet veranderd. Hier is een verklaring voor:
- Het aantal convoluties verandert van een handige (32, 64, 128) naar minder handige voor grafische kaarten - 27, 51, enzovoorts. Ik kan hierin fout zijn, maar het is waarschijnlijk dat dit invloed heeft.
- De architectuur is niet breed, maar sequentieel. Door de breedte te verkleinen, veranderen we de diepte niet. Hierdoor verminderen we de belasting, maar veranderen we de snelheid niet.
Daarom blijkt de verbetering in een vermindering van de CUDA-belasting van 20-30% tijdens de verwerking, maar niet in een vermindering van de verwerkingstijd.
Conclusies
Laten we reflecteren. We hebben 2 varianten van pruning bekeken - voor YOLOv3 (waarbij handmatige aanpassingen nodig zijn) en voor netwerken met eenvoudigere architecturen. Het is duidelijk dat in beide gevallen de grootte van het netwerk kan worden verminderd en de snelheid kan worden verhoogd zonder nauwkeurigheid te verliezen. Resultaten:
- Vermindering van de grootte
- Versnelling van de verwerking
- Vermindering van de CUDA-belasting
- Als gevolg hiervan, ecologische duurzaamheid (we optimaliseren de toekomstige benutting van rekenmiddelen. Eén persoon is blij over dit resultaat, )
Aanvulling
- Na de pruning-stap kun je ook kwantisatie toepassen (bijvoorbeeld met TensorRT)
- TensorFlow biedt mogelijkheden voor . Werkt.
- Ik wil me verder ontwikkelen en ben blij met hulp.
Bron: habr.com
