

Het is bekend dat de competentie van een CTO pas echt wordt getest tijdens de tweede keer dat hij deze rol vervult. Want het is iets heel anders om enkele jaren in een bedrijf te werken, samen met het bedrijf te evolueren en, binnen dezelfde culturele context, geleidelijk meer verantwoordelijkheden te krijgen. En het is iets anders om meteen in de functie van technisch directeur te komen in een bedrijf met een bagage aan legacy en een hoop problemen, die zorgvuldig onder het tapijt zijn veegd.
In dit opzicht is de ervaring van Leon Fier, die hij deelde op , niet per se uniek, maar door de jarenlange ervaring en het aantal verschillende rollen die hij in 20 jaar heeft vervuld, is het zeer nuttig. Hieronder volgt een chronologie van gebeurtenissen over 90 dagen en veel anekdotes waar je om kunt lachen, vooral als ze iemand anders overkomen, maar waar je niet zo blij mee bent als je ze zelf ervaart.
Leon vertelt zeer kleurrijk in het Russisch, dus als je 35-40 minuten hebt, raad ik je aan om de video te bekijken. De tekstversie staat hieronder voor als je tijd wilt besparen.
De eerste versie van het rapport was een goed gestructureerde beschrijving van het werken met mensen en processen, met nuttige aanbevelingen. Maar het gaf niet alle verrassingen weer die onderweg opkwamen. Daarom heb ik het formaat veranderd en de problemen uiteengezet die in het nieuwe bedrijf voor mij opdoken, als een duivel uit een doosje, samen met de methoden om deze chronologisch op te lossen.
Een maand voor
Zoals veel goede verhalen begon dit met alcohol. We zaten met kennissen in een bar, en zoals gebruikelijk onder IT'ers, klaagde iedereen over zijn problemen. Een van hen was net van baan veranderd en vertelde over zijn problemen met technologie, mensen en teams. Hoe langer ik luisterde, hoe meer ik besefte dat hij mij gewoon moest inhuren, want dit zijn precies de problemen die ik de afgelopen 15 jaar heb opgelost. Dat heb ik hem ook gezegd, en de volgende dag ontmoetten we elkaar al in een werkomgeving. Het bedrijf heette Teaching Strategies.
Teaching Strategies is de marktleider in programma's voor vroege kinderopleiding — van geboorte tot drie jaar. De traditionele 'papieren' versie van het bedrijf bestaat al 40 jaar, en de digitale SaaS-versie van het platform bestaat 10 jaar. Onlangs is het proces van aanpassing van digitale technologie aan de bedrijfsstandaarden begonnen. De 'nieuwe' versie werd in 2017 gelanceerd en was bijna als de oude, alleen werkte het slechter.
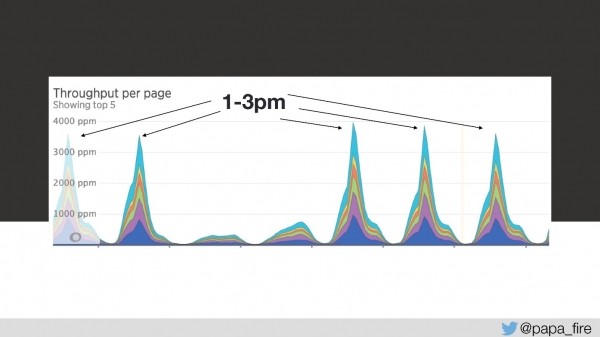
Het interessante is dat het verkeer van dit bedrijf zeer voorspelbaar is - van dag tot dag, van jaar tot jaar kan men heel precies voorspellen hoeveel mensen er komen en wanneer. Bijvoorbeeld, tussen 13:00 en 15:00 uur gaan alle kinderen in de kinderopvang slapen, terwijl de leraren beginnen met het invoeren van informatie. En dat gebeurt elke dag, behalve in het weekend, omdat er in het weekend bijna niemand werkt.
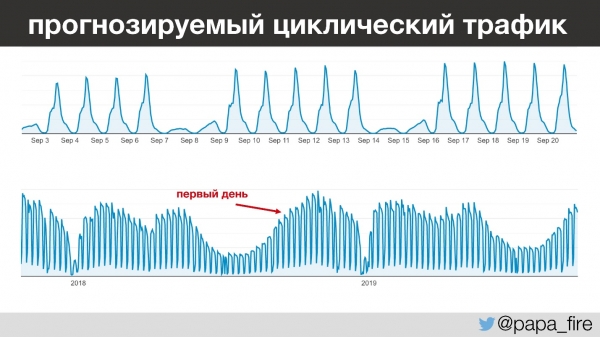
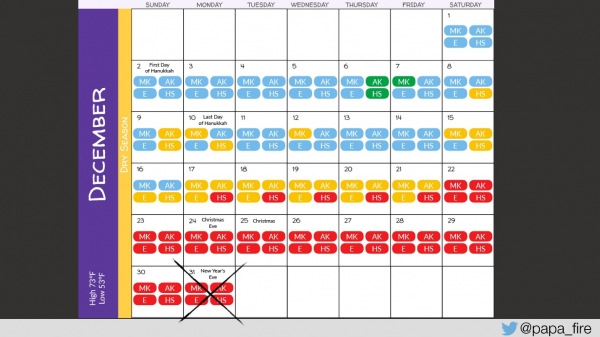
Om een beetje vooruit te lopen, merkte ik op dat ik mijn werk begon in de periode van het grootste jaarlijkse verkeer, wat om verschillende redenen interessant was.
Het platform, dat schijnbaar slechts 2 jaar oud was, had een unieke stack: ColdFusion & SQL Server 2008. ColdFusion, als je het niet weet, en waarschijnlijk weet je het niet, is een soort enterprise PHP dat halverwege de jaren '90 is uitgebracht, en sindsdien heb ik er niet veel meer over gehoord. Daarnaast waren er ook: Ruby, MySQL, PostgreSQL, Java, Go, Python. Maar het belangrijkste monolithische systeem draaide op ColdFusion en SQL Server.
Problemen
Hoe meer ik sprak met de medewerkers van het bedrijf over hun werk en de problemen die ze tegenkwamen, des te meer ik me realiseerde dat de problemen niet alleen technisch van aard waren. Goed, de technologie is oud - en we hebben met ergere gewerkt, maar er waren problemen met het team en met de processen, en het bedrijf begon dat te begrijpen.
Traditioneel zaten de techneuten in een hoekje en deden ze hun eigen werk. Maar steeds meer business begon via de digitale versie te verlopen. Daarom zijn er in het afgelopen jaar, voordat ik begon, nieuwe functies geïntroduceerd: een raad van bestuur, CTO, CPO en QA-directeur. Dat wil zeggen, het bedrijf begon te investeren in de technologische sector.
De sporen van zwaar erfgoed waren niet alleen in de systemen. In het bedrijf waren er legacy-processen, legacy-mensen, legacy-cultuur. Dit moest allemaal veranderen. Ik dacht dat het zeker niet saai zou worden, en besloot om het te proberen.
Twee dagen voor
Twee dagen voor de start van mijn nieuwe werk ging ik naar kantoor, vulde de laatste papieren in, leerde het team kennen en ontdekte dat het team op dat moment worstelde met een probleem. Het probleem was dat de gemiddelde laadtijd van pagina's was gestegen tot 4 seconden, dus dat was twee keer zo lang.
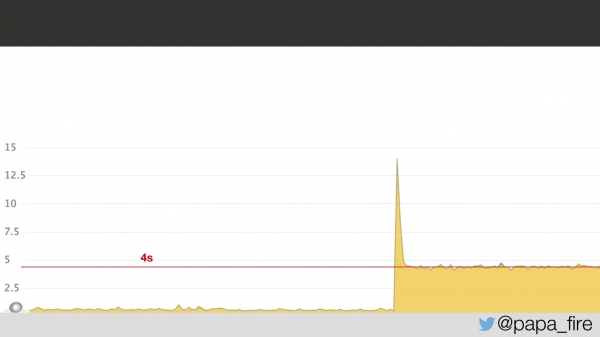
Aan de grafiek te zien is er duidelijk iets gebeurd, maar onduidelijk wat. Het bleek dat het probleem de netwerklatentie in het datacenter was: 5 ms latentie in het datacenter transformeerde naar 2 seconden voor de gebruikers. Waarom dat zo was, wist ik niet, maar in ieder geval werd duidelijk dat het probleem in het datacenter lag.
Dag één
Twee dagen waren voorbij en op mijn eerste werkdag ontdekte ik dat het probleem nog steeds bestond.
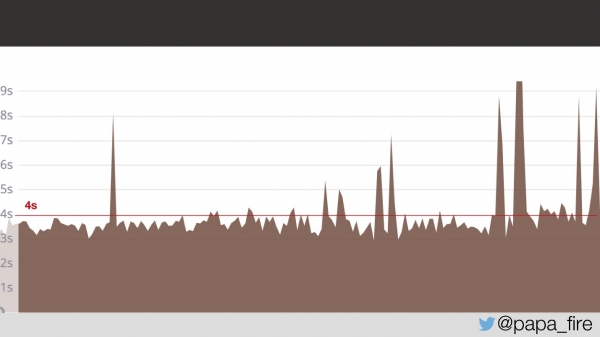
Twee dagen lang laadde de pagina bij gebruikers gemiddeld in 4 seconden. Ik vroeg of ze hadden gevonden wat het probleem was.
— Ja, we hebben een ticket geopend.
— En?
— Nou, ze hebben nog niet op ons geantwoord.
Hier besefte ik dat alles wat mij hiervoor was verteld slechts de kleine punt van de ijsberg was die ik moest aanpakken.
Er is een goede citaat die heel goed bij deze situatie past:
«Soms, om technologie te veranderen, moet je de organisatie veranderen.»
Maar omdat ik begon te werken in de drukste periode van het jaar, moest ik naar beide oplossingen kijken: zowel de snelle als de lange termijn, en beginnen met wat nu kritiek was.
Derde dag
Dus, de laadtijd duurt 4 seconden, en van 13 tot 15 zijn er de grootste pieken.
Op de derde dag zag de laadsnelheid in dit tijdsinterval eruit als:
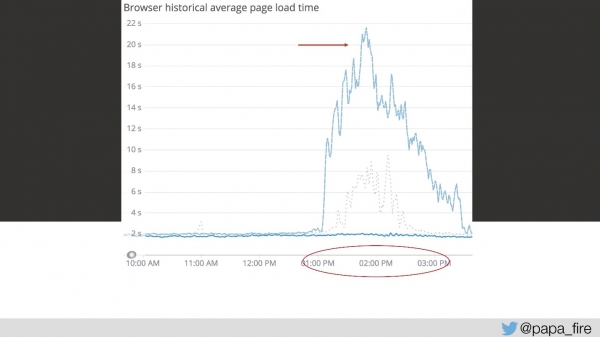
Van mijn kant werkte er helemaal niets. Voor iedereen andere werkte het iets langzamer dan normaal. Maar dat kan niet zomaar zo zijn — dit is een ernstig probleem.
Ik probeerde het team te overtuigen, maar men antwoordde dat er gewoon meer servers nodig waren. Dat is natuurlijk een oplossing voor het probleem, maar niet altijd de enige en meest effectieve. Ik vroeg waarom er niet genoeg servers waren, wat het verkeersvolume was. Ik extrapoleerde de gegevens en ontdekte dat we ongeveer 150 verzoeken per seconde hadden, wat binnen redelijke grenzen valt.
Maar men moet niet vergeten dat je, voordat je het juiste antwoord krijgt, de juiste vraag moet stellen. Mijn volgende vraag was: hoeveel frontend-servers hebben we? Het antwoord verraste me een beetje — we hadden 17 frontend-servers!
— Mag ik vragen, 150 gedeeld door 17, is dat ongeveer 8? Wil je zeggen dat elke server 8 verzoeken per seconde verwerkt, en als er morgen 160 verzoeken per seconde zijn, we dan nog 2 servers nodig hebben?
Natuurlijk hadden we geen extra servers nodig. De oplossing lag in de code zelf, en die was voor de hand liggend:
var currentClass = classes.getCurrentClass();
return currentClass;
Er was een functie getCurrentClass(), omdat alles op de site werkt in de context van de klasse — dat klopt. En voor deze functie waren er op elke pagina 200+ verzoeken.
Dus de oplossing was heel eenvoudig, het was niet nodig om iets opnieuw te schrijven: vraag gewoon niet dezelfde informatie opnieuw op.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Ik was erg blij omdat ik dacht dat ik op de derde dag het belangrijkste probleem had gevonden. Wat was ik naïef, het was slechts een van de vele problemen.
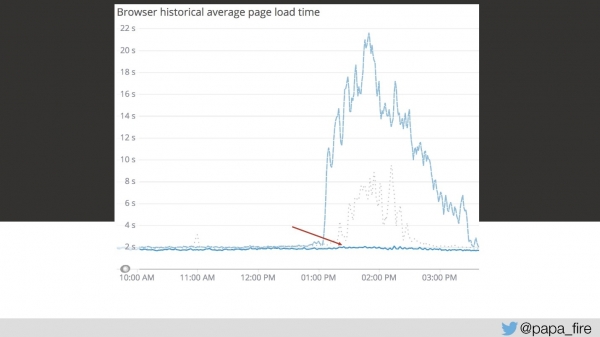
Maar de oplossing van dit eerste probleem heeft de tijdlijn veel lager gezet.
Ondertussen waren we bezig met andere optimalisaties. Er was veel dat gerepareerd kon worden. Op dezelfde derde dag ontdekte ik dat er toch een cache in het systeem was (in het begin dacht ik dat alle aanvragen onmiddellijk uit de database kwamen). Wanneer ik aan cache denk, stel ik me standaard Redis of Memcached voor. Maar dat dacht alleen ik, want voor caching gebruikte dat systeem MongoDB en SQL Server — dezelfde waaruit net gegevens waren gelezen.
Dag tien
In de eerste week hield ik me bezig met problemen die direct opgelost moesten worden. Iets in de tweede week kwam ik voor het eerst naar de stand-up om met het team te praten, te zien wat er gaande was en hoe het hele proces verliep.
Wederom bleek er iets interessants. Het team bestond uit: 18 ontwikkelaars; 8 testers; 3 managers; 2 architecten. En iedereen nam deel aan de gezamenlijke rituelen, dat wil zeggen meer dan 30 mensen kwamen elke ochtend naar de stand-up en vertelden wat ze deden. Het is duidelijk dat de vergadering niet 5 en niet 15 minuten duurde. Niemand luisterde naar elkaar omdat iedereen aan verschillende systemen werkte. In die vorm was 2-3 tickets per uur in de grooming-sessie al een goed resultaat.
Het eerste dat we deden, was het team opsplitsen in verschillende productlijnen. Voor verschillende secties en systemen hebben we aparte teams gevormd, bestaande uit ontwikkelaars, testers, productmanagers en businessanalisten.
Uiteindelijk kregen we:
- Vermindering van stand-ups en vergaderingen.
- Diepgaande productkennis.
- Gevoel van eigenaarschap. Toen mensen eerder constant van systemen verwisselden, wisten ze dat iemand anders waarschijnlijk met hun bugs moest werken, maar niet zijzelf.
- Samenwerking tussen groepen. Het hoeft geen betoog dat QA en programmeurs hiervoor niet veel met elkaar communiceerden, product deed zijn eigen ding, enzovoort. Nu hebben ze een gezamenlijk verantwoordelijkheidsgevoel.
We mainly focused on efficiency, performance, and quality — these are the issues we aimed to address through team transformation.
Day eleven
During the restructuring of the team, I discovered how to calculate StoryPoints. 1 SP equaled one day, and each ticket contained SP for both development and QA, so at least 2 SP.
How did I discover this?
We found a bug: in one of the reports, where the start and end dates for the requested report are entered, the last day is not accounted for. This means that somewhere in the query there was not <=, but just <. I was told that this is three Story Points, that is 3 dagen.
After that we:
- Reviewed the Story Points assessment system. Now resolving minor bugs that can quickly pass through the system reaches the user faster.
- Started to combine related tickets for development and testing. Previously, each ticket, each bug was a closed ecosystem, unlinked to anything else. Changing three buttons on one page could have been three different tickets with three different QA processes instead of one automated test on the page.
- Began working with developers on the approach to estimating effort. Three days to change one button — that's not funny.
Day twenty
Somewhere around the middle of the first month, the situation stabilized slightly, I figured out what was mainly happening, and I began to look to the future and think about long-term solutions.
Langetermijndoelen:
- Managed platform. Hundreds of requests on each page — that's not serious.
- Predictable trends. There were periodic traffic spikes that at first glance did not correlate with other metrics — we needed to understand why this happens and learn to predict it.
- Platform expansion. The business is constantly growing, more users are coming in, and traffic is increasing.
In the past, it was often said: "Let's rewrite everything in [language/framework], everything will work better!"
In most cases, this doesn’t work, and it’s good if the rewritten version even works. Therefore, we needed to create a roadmap — a concrete strategy illustrating step-by-step how business goals will be achieved (what we will do and why), which:
- reflects the mission and goals of the project;
- prioritizes key objectives;
- bevat een schema voor hun prestaties.
Tot nu toe had niemand met het team gesproken over het doel van de aangebrachte wijzigingen. Daarvoor zijn de juiste succesindicatoren nodig. Voor het eerst in de geschiedenis van het bedrijf hebben we KPI's voor het technische team opgesteld, waarbij deze indicatoren zijn gekoppeld aan de organisatie.
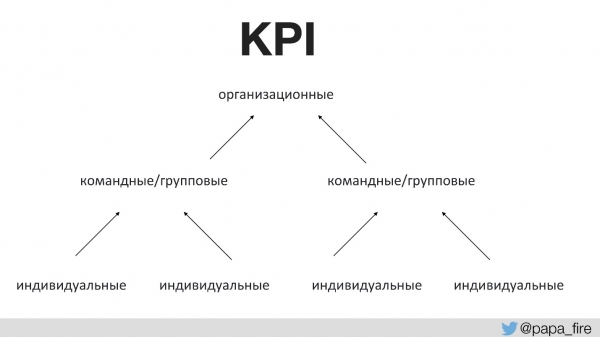
Dat wil zeggen, de organisatorische KPI's worden ondersteund door de teams, en de team KPI's worden vervolgens ondersteund door individuele medewerkers. Anders, als de technologische KPI's niet overeenkomen met de organisatorische, dan trekt iedereen het deken naar zich toe.
Bijvoorbeeld, een van de organisatorische KPI's is het vergroten van het marktaandeel door middel van nieuwe producten.
Hoe kunnen we het doel ondersteunen om meer nieuwe producten te hebben?
- Ten eerste willen we meer tijd besteden aan de ontwikkeling van nieuwe producten in plaats van het oplossen van defecten. Dit is een logische oplossing die eenvoudig te meten is.
- Ten tweede willen we de groei van het aantal transacties ondersteunen, omdat hoe groter het marktaandeel, des te meer gebruikers en dus meer verkeer.
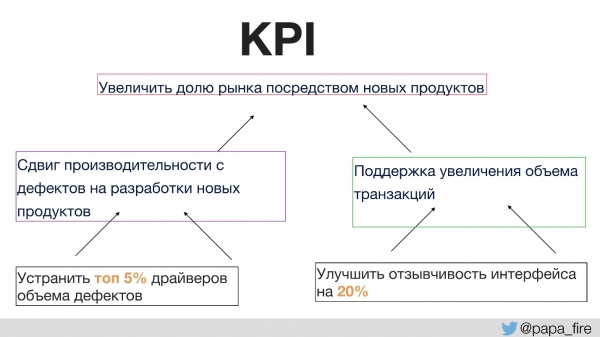
Dan zullen de individuele KPI's, die binnen de groep kunnen worden uitgevoerd bijvoorbeeld, komen uit de plek waar de meeste defecten vandaan komen. Als we ons op deze sectie concentreren, kunnen we ervoor zorgen dat er veel minder defecten zijn, en dan groeit de tijd voor de ontwikkeling van nieuwe producten weer, evenals de ondersteuning van de organisatorische KPI's.
Zo moet elke beslissing, inclusief het herschrijven van code, specifieke doelen ondersteunen die het bedrijf ons heeft gesteld (groei van de organisatie, nieuwe functies, aanwerving van personeel).
Tijdens dit proces kwam er een interessant punt naar voren, dat niet alleen voor de techneuten, maar voor het hele bedrijf nieuws was: alle tickets moeten gericht zijn op ten minste één KPI. Dat wil zeggen, als een productmanager zegt dat hij een nieuwe functie wil ontwikkelen, moet de eerste vraag zijn: "Welke KPI ondersteunt deze functie?" Als er geen is, dan sorry — het lijkt erop dat het een overbodige functie is.
Dag dertig
Aan het eind van de maand ontdekte ik nog een nuance, namelijk dat niemand van mijn Ops-team ooit de contracten heeft gezien die we met klanten afsluiten. Je zou je kunnen afvragen, waarom moeten ze die zien.
- Ten eerste omdat in de contracten SLA's zijn vastgelegd.
- Ten tweede, SLA's zijn allemaal verschillend. Elke klant kwam met zijn eigen eisen, en de verkoopafdeling ondertekende zonder verder te kijken.
Een interessant detail is dat in het contract met een van de grootste klanten staat dat alle softwareversies die het platform ondersteunt, n-1 moeten zijn; dat wil zeggen, niet de nieuwste versie, maar de op een na nieuwste.
Het is duidelijk hoe ver we verwijderd waren van n-1, aangezien het platform op ColdFusion draaide en SQL Server uit 2008, dat in juli helemaal niet meer werd ondersteund.
Dag vijfenveertig
Rond het midden van de tweede maand had ik genoeg tijd om te gaan zitten en het te doen valuestreammapping volledig voor het hele proces. Dit zijn de noodzakelijke stappen die moeten worden ondernomen, van het creëren van het product tot de levering aan de consument, en deze moeten zo gedetailleerd mogelijk worden beschreven.
Je splitst het proces in kleine stukjes en kijkt wat te veel tijd kost, wat geoptimaliseerd of verbeterd kan worden, enzovoort. Bijvoorbeeld, hoe lang het duurt om een verzoek van het product te verwerken, via grooming, wanneer het terechtkomt in een ticket dat een ontwikkelaar kan oppakken, QA, enzovoort. Zo kijk je heel gedetailleerd naar elke afzonderlijke stap en bedenk je wat kan worden geoptimaliseerd.
Toen ik dit deed, vielen me twee dingen op:
- een hoog percentage van teruggestuurde tickets uit QA naar ontwikkelaars;
- pull request review nam te veel tijd in beslag.
Het probleem was dat dit uitspraken waren als: het lijkt erop dat het veel tijd kost, maar we weten niet precies hoeveel.
"Je kunt niets verbeteren wat je niet kunt meten."
Hoe argumeteren we hoe ernstig het probleem is? Worden er dagen of uren verspild?
Om dit te meten, hebben we een paar stappen aan het Jira-proces toegevoegd: "klaar voor ontwikkeling" en "klaar voor QA" om te meten hoe lang elk ticket wacht en hoe vaak het terugkeert naar een bepaalde stap.
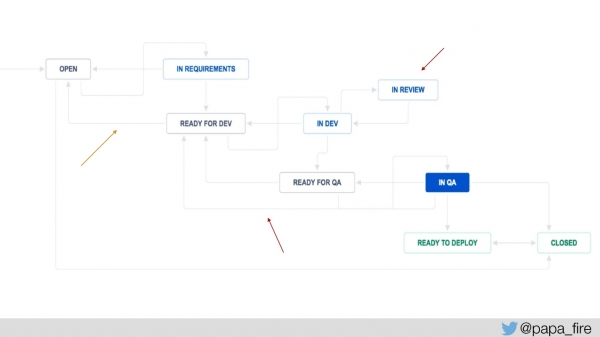
We hebben ook "in review" toegevoegd, zodat we weten hoe lang tickets gemiddeld in review staan, en van daaruit verder kunnen werken. We hadden systeemmetrics, nu hebben we nieuwe metrics toegevoegd en zijn we gaan meten:
- Efficiëntie van het proces: productiviteit en gepland/geleden.
- Kwaliteit van het proces: aantal defecten, defecten vanuit QA.
Dit helpt echt om te begrijpen wat goed gaat en wat niet.
Dag vijftig
Dit is allemaal goed en interessant, maar tegen het einde van de tweede maand gebeurde iets dat in principe voorspelbaar was, hoewel ik deze omvang niet had verwacht. Mensen begonnen te vertrekken omdat de top veranderde. Nieuwe mensen kwamen in het management, die alles begonnen te veranderen en de oudgedienden vertrokken. Gewoonlijk kent iedereen elkaar in een bedrijf dat al enkele jaren bestaat.
Dit was te verwachten, maar de schaal van de ontslagen was onverwacht. Bijvoorbeeld, in één week dienden twee teamleiders tegelijkertijd hun ontslag in. Daarom moest ik me niet alleen richten op andere problemen, maar me concentreren op het opbouwen van een team. Dit is een langdurig en moeilijk oplosbaar probleem, maar het moest worden aangepakt omdat ik de mensen die er nog waren (of de meesten van hen) wilde behouden. We moesten op een of andere manier reageren op het vertrek van mensen om de moraal in het team te ondersteunen.
In theorie is dit goed: er komt een nieuwe persoon die een carte blanche heeft, die de vaardigheden van het team kan beoordelen en medewerkers kan vervangen. In werkelijkheid is het echter niet zo eenvoudig om nieuwe mensen aan te nemen om zeer veel redenen. Er is altijd behoefte aan balans.
- Oud en nieuw. We moeten oude mensen behouden die kunnen veranderen en de missie kunnen ondersteunen. Maar tegelijkertijd moeten we nieuwe bloed toevoeren, daarover later meer.
- Ervaring. Ik heb veel gesproken met goede junioren die gepassioneerd waren en bij ons wilden werken. Maar ik kon hen niet aannemen omdat er niet genoeg senioren waren om de junioren te ondersteunen en als mentoren te fungeren. We moesten eerst de top aanvullen en pas daarna de jongeren.
- De zweep en de wortel.
Ik heb geen goed antwoord op de vraag welke balans juist is, hoe deze te behouden, hoeveel mensen er moeten blijven en hoe hard je druk moet uitoefenen. Dit is puur een individueel proces.
Dag eenenvijftig
Ik begon naar het team te kijken om te begrijpen wie ik had, en herinnerde me opnieuw:
“De meeste problemen zijn mensenproblemen.”
Ik ontdekte dat er in het team, zowel bij de ontwikkelaars als bij ops, drie grote problemen waren:
- Tevredenheid met de huidige situatie.
- Afwezigheid van verantwoordelijkheid — omdat niemand ooit de resultaten van de uitvoerders koppelde aan de impact op het bedrijf.
- Angst voor verandering.
Veranderingen brengen altijd ongemak met zich mee, en hoe jonger de mensen zijn, des te minder houden ze van veranderingen, omdat ze niet begrijpen waarom en niet weten hoe. Het meest voorkomende antwoord dat ik heb gehoord is: “Dat hebben we nooit gedaan.” Dit leidde soms tot absurditeit — de kleinste veranderingen gingen nooit zonder dat iemand zich verontwaardigd uitliet. En het maakte niet uit hoe de veranderingen hun werk aangingen, mensen zeiden: “Nee, waarom? Dit gaat niet werken.”
Maar je kunt niet beter worden zonder iets te veranderen.
Ik had een absoluut absurde conversatie met een medewerker, ik vertelde hem mijn ideeën over optimalisatie, waarop hij zei:
— Oh, heb je niet gezien wat we vorig jaar hadden!
— En wat dan?
— Het is nu veel beter dan het was.
— Dus kan het niet nog beter?
— Waarom zou dat nodig zijn?
Goede vraag — waarom? Alsof, als het nu beter is dan het was, alles voldoende goed is. Dit leidt tot een gebrek aan verantwoordelijkheid, wat op zich volkomen normaal is. Zoals ik al zei, was het technische team een beetje aan de zijlijn. Binnen het bedrijf dacht men dat ze er moesten zijn, maar niemand stelde ooit normen vast.. In de klantenservice hebben ze nooit SLA's gezien, dus voor het team was het behoorlijk "acceptabel" (dit heeft me het meest verbaasd):
- 12 seconden laadtijd;
- 5-10 minuten downtime bij elke release;
- het oplossen van kritieke bug's duurt dagen en weken;
- niet beschikbaar 24/7 / on-call.
Niemand heeft ooit geprobeerd te vragen waarom we dit niet beter konden doen, en niemand begreep ooit dat het niet zo hoorde te zijn.
Als bonus was er nog een ander probleem: een gebrek aan ervaring.De senioren vertrokken en het overgebleven jonge team groeide op in het oude regime en werd daar door vergiftigd.
Bovendien waren mensen bang om fouten te maken of onbekwaam over te komen. Dit uitte zich in het feit dat ze, ten eerste, onder geen enkele omstandigheid om hulp vroegen.Hoe vaak we ook als groep en individueel spraken, ik zei: "Stel een vraag als je niet weet hoe je iets moet doen." Ik heb veel vertrouwen in mijzelf en weet dat ik elk probleem kan oplossen, maar dat kost tijd. Dus als ik iemand kan vragen die het in 10 minuten kan oplossen, zal ik dat doen. Hoe minder ervaring je hebt, des te meer je bang bent om te vragen, omdat je denkt dat ze je onbekwaam zullen vinden.
Deze angst om vragen te stellen komt op interessante manieren naar voren. Bijvoorbeeld, je vraagt: 'Hoe gaat het met deze taak?' — 'Er blijft nog een paar uur over, ik ben bijna klaar.' De volgende dag vraag je weer en krijg je te horen dat alles goed is, maar er is een klein probleempje opgekomen dat zeker aan het einde van de dag opgelost zal zijn. Weer een dag later, en totdat je iemand echt onder druk zet en dwingt om met iemand te praten, gaat het zo door. Iemand wil de taak zelf oplossen en denkt dat als hij het zelf niet oplost, dat een grote mislukking zal zijn.
Precies daarom ontwikkelaars overschatten de inschattingen. Dat was een behoorlijke grap toen we een bepaalde taak bespraken; ik kreeg zo'n cijfer te horen dat ik erg verrast was. Waarop mij werd gezegd dat ontwikkelaars in de schattingen ook de tijd opnemen die de ticket nodig heeft om uit QA terug te komen, omdat daar fouten zullen worden gevonden, en de tijd die nodig is voor PR, en de tijd die mensen, die het moeten bekijken, bezig zullen zijn — dus alles wat maar mogelijk is.
Ten tweede, mensen die bang zijn om onkenbaar over te komen, analyseren te veel. Wanneer je zegt wat er precies moet gebeuren, begint het: 'Nee, wat als we hier even over nadenken?' In dat opzicht is ons bedrijf niet uniek; dit is een standaardprobleem onder jongeren.
Als reactie heb ik de volgende praktijken geïntroduceerd:
- De 30-minutenregel. Als je binnen een half uur het probleem niet kunt oplossen, vraag dan iemand om hulp. Dit werkt met wisselend succes, omdat mensen zich toch niet aanmelden, maar tenminste is het proces begonnen.
- Alles behalve de kern uitsluiten, bij het inschatten van de benodigde tijd voor een taak, dat wil zeggen alleen de tijd tellen die het schrijven van de code kost.
- Voortdurend leren voor degenen die te veel analyseren. Het is gewoon een constante interactie met mensen.
De zestigste dag
Terwijl ik hiermee bezig was, was het tijd om het budget onder de loep te nemen. Natuurlijk vond ik veel interessants over waar we het geld aan uitgaven. Bijvoorbeeld, we hadden een hele rack in een apart datacenter, waar één FTP-server stond die door één klant werd gebruikt. Het bleek dat '… we verhuisden, en hij is daar gewoon achtergebleven; we hebben hem niet vervangen'. Dat was 2 jaar geleden.
Een bijzondere interesse ging uit naar de rekening voor clouddiensten. Ik ben ervan overtuigd dat de belangrijkste oorzaak van de hoge rekening voor cloudservices de ontwikkelaars zijn, die voor het eerst in hun leven onbeperkte toegang tot servers hebben. Ze hoeven niet meer te vragen: 'Geef me alsjeblieft een testserver', ze kunnen het zelf nemen. Daarnaast willen ontwikkelaars altijd een zo’n cool systeem bouwen dat Facebook en Netflix jaloers worden.
Maar ontwikkelaars hebben geen ervaring met het aanschaffen van servers en het inschatten van de benodigde servergrootte, omdat ze dat eerder niet nodig hadden. En meestal begrijpen ze het verschil tussen schaalbaarheid en prestaties niet helemaal.
Resultaten van de inventarisatie:
- Vertrokken uit één datacenter.
- Hebben contracten met 3 logservices beëindigd. Want we hadden er 5 — elke ontwikkelaar die met iets begon te experimenteren, nam een nieuwe.
- 7 AWS-systemen uitgeschakeld. Nogmaals, niemand stopte de overleden projecten; ze bleven allemaal draaien.
- De softwarekosten met 6 keer verminderd.
Dag vijfenzestig
De tijd verstreek en na tweeënhalve maand moest ik de raad van bestuur ontmoeten. Onze raad van bestuur is niet beter of slechter dan andere, hij wil net als alle raden van bestuur alles weten. Mensen investeren geld en willen begrijpen in hoeverre wat we doen in lijn ligt met de gestelde KPI's.
De raad van bestuur ontvangt elke maand veel informatie: het aantal gebruikers, hun groei, welke diensten ze gebruiken en hoe, de prestaties en productiviteit, en tenslotte de gemiddelde laadtijd van pagina's.
Het probleem is alleen dat ik geloof dat gemiddelde waarden puur kwaad zijn. Maar het is heel moeilijk om dit aan de raad van bestuur uit te leggen. Ze zijn gewend om met geaggregeerde cijfers te werken, en niet bijvoorbeeld met de spreiding van laadtijden in seconden.
Hierdoor ontstonden interessante momenten. Bijvoorbeeld, ik zei dat we het verkeer moeten verdelen tussen afzonderlijke webservers, afhankelijk van het type inhoud.
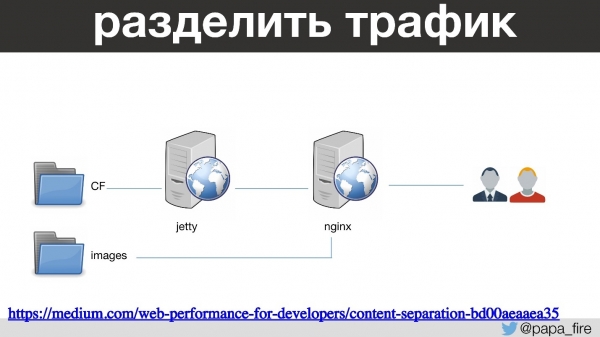
Dat wil zeggen, ColdFusion gaat via Jetty en nginx om pagina's te laden. En afbeeldingen, JS en CSS gaan via een aparte nginx met hun eigen configuraties. Dit is vrij standaardpraktijk waar ik een paar jaar geleden nog over sprak. Als resultaat worden afbeeldingen veel sneller geladen, en ... de gemiddelde laadtijd is met 200 ms toegenomen.
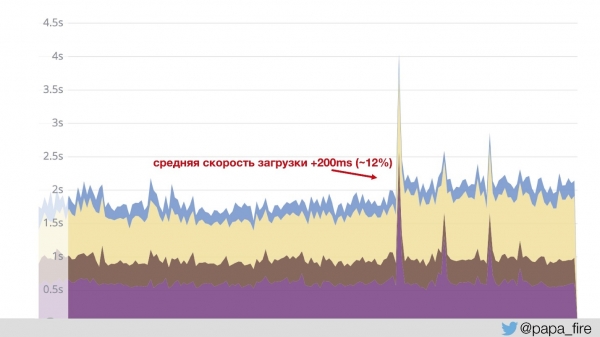
Dit gebeurde omdat de grafiek is gebaseerd op data die van Jetty komen. Met andere woorden, snel aanbod wordt niet meegenomen — het gemiddelde is gestegen. We begrepen dit, we lachten ervan, maar hoe leg je de raad van bestuur uit waarom we iets deden en het 12% slechter werd?
Vijfenachtigste dag
Aan het einde van de derde maand besefte ik dat ik op één ding helemaal niet had gerekend — de tijd. Voor alles waar ik over heb gesproken, is tijd nodig.
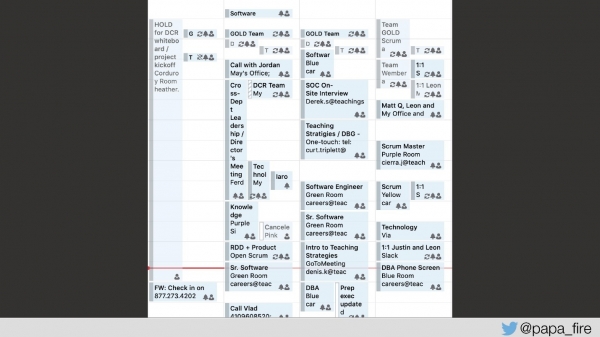
Dit is mijn echte kalender voor de week — gewoon een werkweek, niet al te druk. Er is niet genoeg tijd voor alles. Daarom moeten we opnieuw mensen aannemen die helpen met de problemen.
Conclusie
Dit is beslist nog niet alles. In dit verhaal ben ik zelfs nog niet aangekomen bij hoe we met het product werkten en probeerden in dezelfde geest af te stemmen, of hoe we de technische ondersteuning integreerden, of hoe we andere technische problemen oplosten. Bijvoorbeeld, ik ontdekte per toeval dat we niet gebruikmaken van de grootste tabellen in de database. SEQUENCEWe hebben een zelfgeschreven functie nextID, en deze wordt niet in een transactie gebruikt.
Er waren nog een miljoen van dit soort dingen waar je lang over kunt praten. Maar het belangrijkste, dat nog moet worden genoemd, is de cultuur.
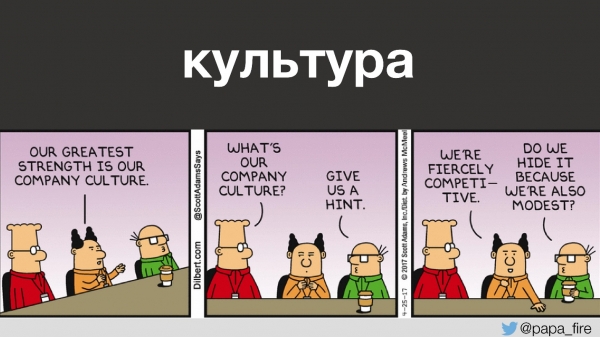
Het is precies de cultuur, of het gebrek daaraan, die tot alle andere problemen leidt. We proberen een cultuur op te bouwen waarin mensen:
- geen angst hebben voor falen;
- leren van fouten;
- samenwerken met andere teams;
- inisiatief tonen;
- verantwoordelijkheid nemen;
- de uitkomst als doel verwelkomen;
- succes vieren.
Met dit alles zal de rest volgen.
Leon Fyer , en op .
Wat betreft legacy zijn er twee strategieën: alles vermijden om ermee te werken, of dapper de bijbehorende moeilijkheden overwinnen. Wij kiezen voor de tweede weg, door processen en benaderingen te veranderen. Doe met ons mee in , en en laten we samen een DevOps-cultuur implementeren.
Bron: habr.com
