

Het artikel bestaat uit twee delen:
- Een korte beschrijving van enkele architecturen van netwerken voor objectdetectie op afbeeldingen en afbeeldingssegmentatie met de meest begrijpelijke bronnen voor mij. Ik heb geprobeerd video's en uitleg in het Russisch te kiezen.
- Het tweede deel bestaat uit de poging om de ontwikkeling richting van neural netwerken architecturen en de technologieën die daarop gebaseerd zijn te begrijpen.
Figuur 1 – Het is niet gemakkelijk om de architecturen van neurale netwerken te begrijpen.
Het begon allemaal toen ik twee demonstratie-applicaties maakte voor classificatie en objectdetectie op een Android-telefoon:
- , waarbij gegevens op de server worden verwerkt en naar de telefoon worden verzonden. Beeldclassificatie (image classification) van drie soorten beren: bruine, zwarte en pluche.
- , waarbij gegevens op de telefoon zelf worden verwerkt. Objectdetectie (object detection) van drie soorten: hazelnoten, vijgen en dadels.
Er is een verschil tussen de taken van afbeeldingsclassificatie, objectdetectie op een afbeelding en . Daarom was er behoefte om te begrijpen welke architecturen van neurale netwerken objecten op afbeeldingen detecteren en welke kunnen segmenteren. Ik vond de volgende voorbeelden van architecturen met de meest begrijpelijke bronnen voor mij:
- Een reeks architecturen gebaseerd op R-CNN (Rregio's met Cconvolutionele Nneurale Nnetwerken kenmerken): R-CNN, Fast R-CNN, , . Voor objectdetectie op een afbeelding wordt gebruikgemaakt van een Region Proposal Network (RPN) om begrensde regio's (bounding boxes) te identificeren. In eerste instantie werd een langzamere methode genaamd Selective Search gebruikt in plaats van RPN. Vervolgens worden de geïdentificeerde begrensde regio's aan een gewone neurale netwerken gegeven voor classificatie. In de R-CNN-architectuur zijn er expliciete 'for'-lussen om door de begrensde regio's te itereren, met maximaal 2000 doorlopen door het interne AlexNet-netwerk. Door de expliciete 'for'-lussen vertraagt de snelheid van beeldverwerking. Het aantal expliciete lussen en doorlopen door het interne neurale netwerk neemt af met elke nieuwe versie van de architectuur, en er worden tientallen andere wijzigingen aangebracht om de snelheid te verhogen en om de taak van objectdetectie te vervangen door segmentatie van objecten in Mask R-CNN.
- (Yalleen O. Look Once) – het eerste neurale netwerk dat objecten in realtime op mobiele apparaten herkende. Een kenmerk is het onderscheid tussen objecten met één enkele doorgang (slechts één keer kijken is voldoende). Dit betekent dat de architectuur van YOLO geen duidelijke 'for' lussen bevat, waardoor het netwerk snel werkt. Een analogie: bij NumPy zijn er ook geen duidelijke 'for' lussen bij matrixoperaties, die in NumPy op lagere architectuurniveaus worden geïmplementeerd via de programmeertaal C. YOLO gebruikt een grid van vooraf gedefinieerde vensters. Om te voorkomen dat hetzelfde object meerdere keren wordt gedefinieerd, wordt een overlappingscoëfficiënt (IoU) gebruikt, Intersection over Union). Deze architectuur werkt in een breed scala en heeft een hoge : het model kan worden getraind op foto's, maar werkt goed op getekende afbeeldingen.
- (Single Shot MultiBox Detector) – maakt gebruik van de meest succesvolle 'hacks' van de YOLO-architectuur (bijvoorbeeld non-maximum suppression) en voegt nieuwe toe, zodat het neuraal netwerk sneller en nauwkeuriger werkt. Een kenmerk is het onderscheid tussen objecten met één enkele doorgang met behulp van een gedefinieerd grid van vensters (default box) op een piramide van beelden. De beeldpiramide is gecodeerd in convolutionele tensors tijdens sequentiële convolutie- en poolingoperaties (bij de max-pooling operatie neemt de ruimtelijke dimensie af). Op deze manier kunnen zowel grote als kleine objecten in één doorgang van het netwerk worden gedefinieerd.
- MobileSSD (MobielNetV2 + SSD) – een combinatie van twee architectures van neurale netwerken. Het eerste netwerk werkt snel en verhoogt de nauwkeurigheid van de herkenning. MobileNetV2 wordt gebruikt in plaats van VGG-16, dat oorspronkelijk werd gebruikt in . Het tweede netwerk SSD bepaalt de locatie van objecten op de afbeelding.
- – een zeer klein maar nauwkeurig neuraal netwerk. Op zichzelf kan het de taak van objectdetectie niet oplossen. Het kan echter worden gebruikt bij de combinatie van verschillende architecturen. En gebruikt worden in mobiele apparaten. Een kenmerk is dat de gegevens eerst worden gecomprimeerd tot vier 1×1 convolutionele filters en daarna worden uitgebreid tot vier 1×1 en vier 3×3 convolutionele filters. Eén dergelijke iteratie van compressie-uitbreiding van gegevens wordt een 'Fire Module' genoemd.
- (Semantic Image Segmentation with Deep Convolutional Nets) – objectsegmentatie op een afbeelding. Een kenmerk van de architectuur is de 'dilated convolution' die de ruimtelijke resolutie behoudt. Vervolgens komt de fase van nabewerking van de resultaten met behulp van een grafische kansmodel (conditional random field), wat kleine ruis in de segmentatie verwijdert en de kwaliteit van het gesegmenteerde beeld verbetert. Achter de indrukwekkende naam 'grafische kansmodel' schuilt een gewone Gauss-filter die is geapproximiseerd over vijf punten.
- Probeerde te begrijpen hoe het werkt (Single-Shot Refinement Neural Network for Object Detection), maar begreep er weinig van.
- Kijk ook naar hoe de 'attention'-technologie werkt: , , . Een kenmerk van de 'attention'-architectuur is de automatische identificatie van gebieden van verhoogde aandacht op de afbeelding (RoI, Regions of Interest) met behulp van een neuraal netwerk genaamd Attention Unit. De gebieden van verhoogde aandacht lijken op begrensde regio's (bounding boxes), maar zijn niet gefixeerd op de afbeelding en kunnen vage randen hebben. Vervolgens worden kenmerken (features) uit de gebieden van verhoogde aandacht geëxtraheerd en 'gegeven' aan recurrente neurale netwerken met architecturen . Recurrente neurale netwerken kunnen de relaties tussen kenmerken in een reeks analyseren. Aanvankelijk werden recurrente neurale netwerken gebruikt voor het vertalen van tekst naar andere talen, en nu ook voor het vertalen en .
Naarmate ik deze architecturen bestudeerde begreep ik dat ik niets begreep. En het ligt niet aan het feit dat mijn neuraal netwerk problemen heeft met het aandachtmechanisme. Het creëren van al deze architecturen lijkt op een enorme hackathon, waar auteurs strijden in hacks. Hack (hack) is een snelle oplossing voor een moeilijke programmeertaak. Dat wil zeggen, er is geen zichtbare en begrijpelijke logische connectie tussen al deze architecturen. Alles wat hen verbindt, is een verzameling van de beste hacks die ze van elkaar lenen, plus een gemeenschappelijke (backpropagation). Geen ! Het is niet duidelijk wat er moet veranderen en hoe de bestaande prestaties geoptimaliseerd moeten worden.
Als gevolg van het ontbreken van logische samenhang tussen de hacks, zijn ze extreem moeilijk te onthouden en praktisch toe te passen. Dit resulteert in gefragmenteerde kennis. In het beste geval worden een paar interessante en onverwachte punten onthouden, maar het grootste deel van wat is begrepen en niet begrepen, verdwijnt al na enkele dagen uit het geheugen. Het zou al goed zijn als er na een week ten minste de naam van de architectuur kan worden herinnerd. En er zijn uren en zelfs dagen werk in het lezen van artikelen en het bekijken van overzichtsvideo's gestoken!
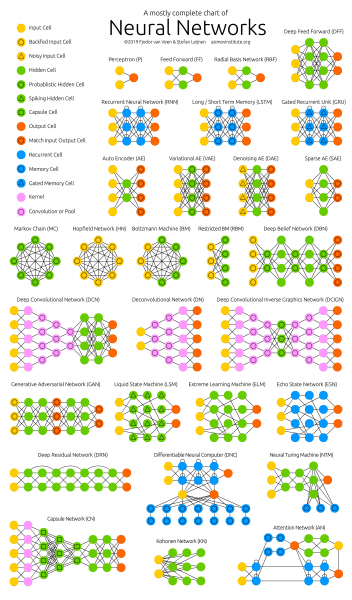
Figuur 2 –
De meeste auteurs van wetenschappelijke artikelen doen naar mijn persoonlijke mening hun uiterste best om deze gefragmenteerde kennis voor de lezer onbegrijpelijk te maken. Maar de participiale constructies in tien regellange zinnen met formules die 'van de muur zijn gehaald' – dat is een onderwerp voor een apart artikel (probleem ).
Om deze reden is het nodig geworden om informatie over neurale netwerken te systematiseren en zo de kwaliteit van begrip en onthouden te verhogen. Daarom werd de hoofdtitel voor de analyse van specifieke technologieën en architecturen van kunstmatige neurale netwerken de volgende taak: erachter komen waar dit alles naartoe gaat, en niet de werking van een specifiek neuraal netwerk apart.
Waar dit alles naartoe gaat. Belangrijkste resultaten:
- Het aantal startups op het gebied van machine learning is de afgelopen twee jaar . Een mogelijke oorzaak: 'neurale netwerken zijn niet langer iets nieuws'.
- Iedereen kan een werkend neuraal netwerk creëren voor het oplossen van een eenvoudige taak. Hiervoor kan men een kant-en-klaar model uit de 'modelentuin' (model zoo) nemen en de laatste laag van het neuraal netwerk trainen met) op kant-en-klare gegevens van of uit in de gratis .
- Grote producenten van neurale netwerken zijn begonnen met het creëren van ‘modelentuinen’ (model zoo). Hiermee kunnen snel commerciële applicaties worden gemaakt: voor TensorFlow, voor PyTorch, voor Caffe2, voor Chainer en .
- Neurale netwerken die werken in echte tijd (real-time) op mobiele apparaten. Van 10 tot 50 frames per seconde.
- Toepassing van neurale netwerken in telefoons (TF Lite), in browsers (TF.js) en in (IoT, IInternet of Tof dingen). Vooral in telefoons die al neurale netwerken op hardware-niveau ondersteunen (neuroversnellers).
- Elke device, kledingstukken en mogelijk zelfs voedsel zullen hebben IP-v6 adres en met elkaar communiceren" - .
- De groei van publicaties over machine learning is begonnen (verdubbeling elke twee jaar) sinds 2015. Duidelijk zijn er neurale netwerken nodig voor artikelanalyses.
- Veranderende technologieën die populair aan het worden zijn:
- PyTorch – de populariteit groeit snel en lijkt TensorFlow te overtreffen.
- Automatische hyperparameterafstemming AutoML – de populariteit groeit gestaag.
- Geleidelijke afname van precisie en een toename van rekenkracht: , algoritmes , onnauwkeurige (benaderde) berekeningen, kwantisatie (wanneer de gewichten van het neurale netwerk naar gehele getallen worden veranderd en gekwantiseerd), neuroversnellers.
- Vertaling en .
- Creëren , nu al in realtime.
- Het belangrijkste in DL is veel data, maar het verzamelen en annoteren ervan is moeilijk. Daarom ontwikkelt zich automatisering van annotatie () voor neurale netwerken met behulp van neurale netwerken.
- Met neurale netwerken is Computer Science plotseling een experimentele wetenschap geworden en is er een .
- IT-geld en de populariteit van neurale netwerken ontstonden gelijktijdig, toen berekeningen een marktwaarde gekregen hebben. De economie verandert van goud-valuta naar goud-valuta-berekening.. Zie mijn artikel over en de redenen voor het ontstaan van IT-geld.
Langzaam komt er een nieuwe (Machine Learning & Deep Learning), die is gebaseerd op de presentatie van een programma als een verzameling getrainde neurale netwerken.
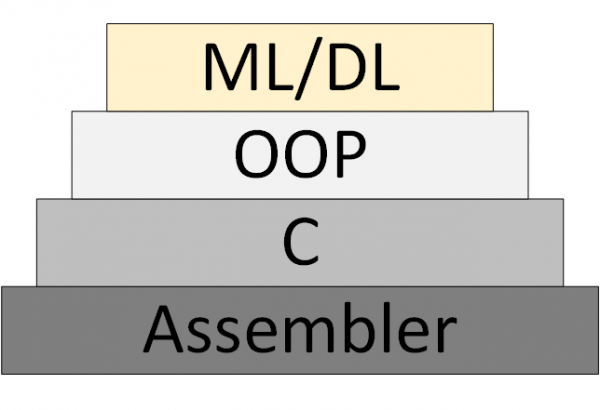
Figuur 3 – ML/DL als nieuwe programmatiestijl
Echter, er is nooit echt een "theorie van neurale netwerken", binnen welk kader je systematisch kunt denken en werken. Wat nu als "theorie" wordt genoemd, zijn eigenlijk experimentele, heuristische algoritmes.
Links naar mijn en andere bronnen:
- Nieuwsbrief over Data Science. Voornamelijk over beeldverwerking. Wie deze wil ontvangen, kan een e-mail sturen (foobar167<dognose>gmail<dot>com). Links naar artikelen en video’s worden verstuurd naarmate het materiaal zich ophoopt.
- Algemene , die ik heb gevolgd en die ik nog wil volgen.
- , waarmee je zou moeten beginnen met het bestuderen van neurale netwerken. Plus een brochure .
- , waar iedereen iets interessants voor zichzelf kan vinden.
- Ze zijn uiterst nuttig gebleken videokanalen die wetenschappelijke artikelen analyseren over Data Science. Zoek ze, abonneer je erop en deel de links met je collega's en mij ook. Voorbeelden:
- ook met stapsgewijze instructies en open sourcecode.
Bedankt voor uw aandacht!
Bron: habr.com
