

In dit artikel deel ik mijn overpeinzingen over de geschiedenis en de toekomst van het internet, gecentraliseerde en gedecentraliseerde netwerken en als resultaat — de mogelijke architectuur van het gedecentraliseerde netwerk van de volgende generatie.
Er is iets mis met het internet
Voor het eerst maakte ik kennis met het internet in 2000. Natuurlijk is dat niet het begin — het netwerk bestond al voor die tijd, maar die periode kan worden gezien als de eerste bloei van het internet. Het wereldwijde web is een geniaal uitvinding van Tim Berners-Lee, web1.0 in zijn klassieke, canonieke vorm. Een overvloed aan websites en pagina's die via hyperlinks met elkaar zijn verbonden. Op het eerste gezicht — een eenvoudige architectuur, zoals alles geniale: gedecentraliseerd en vrij. Ik wil — ik reis over de websites van andere mensen door op de hyperlinks te klikken; ik wil — ik maak mijn eigen website waarop ik dat publiceer wat mij interesseert — bijvoorbeeld mijn artikelen, foto's, programma's, hyperlinks naar interessante websites voor mij. En anderen plaatsen links naar mij.
Schijnbaar — een idyllisch beeld? Maar je weet al hoe dit is afgelopen.
Er zijn te veel pagina's geworden en informatie zoeken is een tamelijk complexe zaak geworden. De door auteurs geschreven hyperlinks konden deze enorme hoeveelheid informatie simpelweg niet structureren. Eerst verschenen er handmatig gevulde catalogi, en daarna gigantische zoekmachines die gebruik gingen maken van ingenieuze heuristische rankingalgoritmes. Websites werden gemaakt en vervolgens weer verlaten, informatie werd gedupliceerd en vervormd. Het internet werd snel gecommercialiseerd en ging steeds verder weg van het ideale academische netwerk. De opmaaktaal veranderde snel in een opmaaksysteem. Advertenties verschenen, vervelende hinderlijke banners en technieken voor het manipuleren en misleiden van zoekmachines — SEO. Het netwerk raakte snel vervuild met informatieafval. Hyperlinks stopten met een instrument voor logische verbinding te zijn en werden een instrument voor promotie. Websites sloten zich op, werden zelfvoorzienend, veranderden van open 'pagina's' in hermetische 'applicaties', en werden slechts middelen om inkomsten te genereren.
Al op dat moment had ik het idee dat "er iets niet klopte". Een heleboel verschillende websites, van primitieve persoonlijke pagina's met schokkende ontwerpen tot "megaportalen", vol met flonkerende banners. Zelfs als de websites over hetzelfde onderwerp gingen, waren ze totaal niet met elkaar verbonden, met elk een eigen ontwerp, eigen structuur, irritante banners, slecht werkende zoekfuncties, problemen met downloaden (ja, ik wilde informatie offline hebben). Zelfs toen begon het internet op een soort televisie te lijken, waar nuttige inhoud werd overschaduwd door allerlei franje.
Decentralisatie is een nachtmerrie geworden.
Wat wil ik eigenlijk?
Paradoxaal genoeg had ik, zonder kennis van web 2.0 of p2p, als gebruiker helemaal geen behoefte aan decentralisatie! Als ik terugdenk aan mijn onbedorven gedachten uit die tijd, realiseer ik me dat ik eigenlijk nodig had... één enkele database! Een database waarvan een zoekopdracht alle resultaten zou teruggeven, in plaats van de resultaten die het beste bij het rangschikkingsalgoritme passen. Een database waarin al deze resultaten uniform gepresenteerd en gestileerd waren in mijn eigen, uniforme opmaak, in plaats van de schreeuwerige zelfgemaakte ontwerpen van talrijke Vasja Poepkin. Een database die ik offline kon opslaan zonder bang te zijn dat de website morgen zou verdwijnen en alle informatie voor altijd verloren zou zijn. Een database waar ik mijn eigen informatie in kon invoeren, zoals opmerkingen en tags. Een database waarin ik kon zoeken, sorteren en filteren met mijn persoonlijke algoritmes.
Web 2.0 en sociale netwerken
Ondertussen kwam het concept Web 2.0 in beeld. Samengevat in 2005 door Tim O'Reilly als "een methode om systemen te ontwerpen die, door rekening te houden met netwerkinteracties, beter worden naarmate meer mensen ze gebruiken" — bedoeld om gebruikers actief te betrekken bij het collectief creëren en bewerken van inhoud op het internet. Zonder te overdrijven, zijn sociale netwerken de hoogtepunt en triomf van dit concept geworden. Gigantische platforms die miljarden gebruikers samenbrengen en honderden petabytes aan gegevens opslaan.
Wat hebben we dan gekregen in sociale netwerken?
- uniformiteit van de interface; het blijkt dat gebruikers niet al die mogelijkheden voor het creëren van diverse en schreeuwende ontwerpen nodig hebben; alle pagina's van alle gebruikers hebben hetzelfde ontwerp en dat bevalt iedereen en is zelfs handig; alleen de inhoud verschilt.
- uniformiteit van de functionaliteit; al die diversiteit aan scripts bleek ook niet nodig. 'Feed', vrienden, albums... na verloop van tijd hebben de functionaliteiten van sociale netwerken zich min of meer gestabiliseerd en zullen waarschijnlijk niet veranderen: immers, functionaliteit wordt bepaald door de soorten activiteiten van mensen, en mensen veranderen praktisch niet.
- één database; werken met zo'n database bleek veel handiger dan met een aantal verspreide websites; zoeken is veel eenvoudiger geworden. In plaats van voortdurend diverse zwak verbonden pagina's te scannen, alles te cachen en te rangschikken volgens complexe heuristische algoritmen — een relatief eenvoudige uniform verzoek aan één database met een bekende structuur.
- feedbackinterface — likes en shares; in het reguliere web kon Google bijvoorbeeld geen feedback van gebruikers krijgen na het klikken op een link in de zoekresultaten. In sociale netwerken blijkt deze verbinding eenvoudig en natuurlijk te zijn.
Wat hebben we verloren? We hebben decentralisatie verloren, en dus — vrijheid. Het wordt beschouwd dat onze gegevens nu niet meer van ons zijn. Vroeger konden we onze persoonlijke pagina's zelfs op onze eigen computer plaatsen, maar nu geven we al onze gegevens aan internetgiganten.
Bovendien zijn, met de ontwikkeling van het internet, regeringen en bedrijven geïnteresseerd geraakt, wat heeft geleid tot problemen met politieke censuur en copyrightbeperkingen. Onze pagina's op sociale netwerken kunnen worden verbannen en verwijderd als de inhoud niet voldoet aan bepaalde regels van het sociale netwerk; voor een ondoordachte post kan men administratief en zelfs strafrechtelijk worden vervolgd.
En nu vragen we ons opnieuw af: moeten we de decentralisatie niet terugbrengen? Maar dan in een andere vorm, zonder de tekortkomingen van de eerste poging?
Peer-to-peer netwerken
De eerste p2p-netwerken kwamen veel vroeger op dan web 2.0 en ontwikkelden zich parallel aan de ontwikkeling van het web. De traditionele toepassing van p2p is bestandenuitwisseling; de eerste netwerken werden ontwikkeld voor het delen van muziek. De eerste netwerken (zoals Napster) waren in feite gecentraliseerd, en daarom werden ze al snel door rechtenhouders gesloten. Volgers kozen voor decentralisatie. In 2000 verschenen de protocollen ED2K (de eerste client eDokney) en Gnutella, in 2001 - het FastTrack-protocol (client KaZaA). Geleidelijk nam de mate van decentralisatie toe en werden de technologieën verfijnd. In plaats van systemen met een 'wachtrij voor uploads' kwamen torrents, en de conceptie van gedistribueerde hash-tabellen DHT verscheen. Naarmate de druk van overheden toenam, werd de anonimiteit van deelnemers steeds belangrijker. Sinds 2000 wordt er gewerkt aan het Freenet-netwerk, sinds 2003 - I2P, en in 2006 werd het RetroShare-project gestart. We kunnen tal van p2p-netwerken noemen, zowel bestaande als inmiddels verdwenen - en ook die nu actief zijn: WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler en vele anderen. Ze zijn talrijk. Ze zijn verschillend. Ze zijn heel verschillend - zowel qua doel als qua structuur... Misschien zijn niet al deze namen bekend bij jullie. En dit is lang niet alles.
Echter, p2p-netwerken hebben een heleboel nadelen. Naast de technische tekortkomingen die eigen zijn aan elke specifieke implementatie van een protocol en client, kunnen we bijvoorbeeld een vrij algemeen nadeel noemen - de moeilijkheid van het zoeken (dat wil zeggen, alles waar Web 1.0 mee te maken had, maar dan in een nog complexere variant). Hier is er geen Google met zijn alomtegenwoordige en onmiddellijke zoekfunctie. En als je voor bestandenruil-netwerken nog kunt zoeken op bestandsnaam of meta-informatie, is het vinden van iets, laten we zeggen, in overlay-netwerken zoals onion of i2p, heel lastig, als het al mogelijk is.
Over het geheel genomen, als we een analogie trekken met het klassieke internet, dan zijn de meeste gedecentraliseerde netwerken ergens vast komen te zitten op het niveau van FTP. Stel je een internet voor waarin er niets is behalve FTP: geen moderne websites, geen web 2.0, geen YouTube... Zo ongeveer in deze staat bevinden gedecentraliseerde netwerken zich. En ondanks afzonderlijke pogingen om iets te veranderen, zijn er tot nu toe weinig veranderingen.
Inhoud
Laten we nog eens kijken naar een ander belangrijk onderdeel van deze puzzel: content. Content is het grootste probleem van elke online bron, vooral van gedecentraliseerde. Waar kunnen we het vandaan halen? Natuurlijk, je kunt vertrouwen op een groep enthousiastelingen (zoals het geval is met de bestaande p2p-netwerken), maar dan zal de ontwikkeling van het netwerk vrij traag gaan en zal er weinig content zijn.
Werken met het reguliere internet is het zoeken naar en bestuderen van content. Soms is het ook het opslaan (als de content interessant en nuttig is, dan bewaren veel mensen, vooral degenen die het internet zijn binnengestapt tijdens de dial-up-periode — waaronder ikzelf — dat verstandig offline, zodat het niet verloren gaat; want het internet is een onvoorspelbare zaak, vandaag is er een site, morgen is die er niet meer, vandaag is er een video op YouTube — morgen is die verwijderd, enzovoorts.
En voor torrents (die we eerder meer beschouwen als een aflevermiddel dan als een p2p-netwerk) wordt opslaan zelfs verondersteld. En dit is trouwens een van de problemen van torrents: een bestand dat eenmaal is gedownload, is moeilijk te verplaatsen naar een plek waar het handiger is om het te gebruiken (over het algemeen moet je de distributie handmatig regenereren) en je kunt het helemaal niet hernoemen (je kunt een hardlink maken, maar daar weet bijna niemand van).
Kortom, velen bewaren op de een of andere manier content. Wat is de verdere bestemming ervan? Gewoonlijk belanden opgeslagen bestanden ergens op de schijf, in een map zoals Downloads, tussen een wirwar van andere bestanden. Dit is slecht — en vooral slecht voor de gebruiker zelf. Als het internet zoekmachines heeft, heeft de lokale computer van de gebruiker niets dergelijks. Het is goed als de gebruiker zorgvuldig is en gewend is om gedownloade bestanden te sorteren. Maar niet iedereen is zo…
Tegenwoordig zijn er eigenlijk ook veel mensen die niets opslaan en volledig op online vertrouwen. Maar in p2p-netwerken wordt verondersteld dat content lokaal op het apparaat van de gebruiker wordt opgeslagen en aan andere deelnemers wordt gedeeld. Is het mogelijk om een dergelijke oplossing te vinden die beide categorieën gebruikers in een gedecentraliseerd netwerk betrekt, zonder hun gewoonten te veranderen, en bovendien hun leven vergemakkelijkt?
Het idee is vrij eenvoudig: wat als we een middel zouden maken voor gebruiksvriendelijk en transparant opslaan van content van het gewone internet, met slimme opslag — met semantische meta-informatie, en niet in een grote hoop, maar in een bepaalde structuur met de mogelijkheid van verdere structurering, en tegelijkertijd opgeslagen content delen in een decentraal netwerk?
Laten we beginnen met opslaan
We zullen de utilitaire toepassingen van het internet voor het bekijken van weersvoorspellingen of vluchttijden niet beschouwen. We zijn meer geïnteresseerd in zelfvoorzienende en min of meer onveranderlijke objecten — artikelen (van tweets/posts op sociale media tot grotere artikelen, zoals hier op Habr), boeken, afbeeldingen, programma's, audio en video's. Waar komt de informatie voornamelijk vandaan? Gewoonlijk is dat
- sociale netwerken (verschillende nieuwsberichten, kleine notities — "tweets", afbeeldingen, audio en video)
- artikken op thematische websites (zoals Habr); er zijn niet veel goede bronnen, meestal zijn deze bronnen ook opgebouwd volgens het principe van sociale netwerken
- nieuwswebsites
Over het algemeen zijn er standaardfuncties zoals: "vind leuk", "herpubliceer", "deel op sociale media", enzovoort.
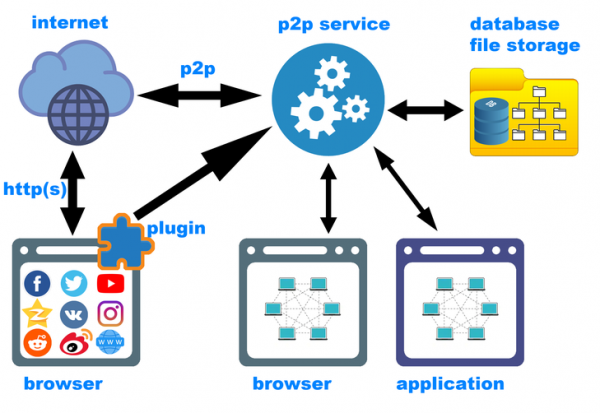
Stel je een browserplugin, voor die speciaal alles opslaat waaraan we een like hebben gegeven, dat we hebben herpubliceerd, of dat we in "favorieten" hebben opgeslagen (of een speciale knop van de plugin hebben ingedrukt, geplaatst in het menu van de browser — voor het geval de website geen functie voor het geven van likes/herpubliceren/toevoegen aan bladwijzers heeft). Het belangrijkste idee is dat je simpelweg een like geeft — zoals je dat een miljoen keer eerder hebt gedaan, en het systeem slaat het artikel, de afbeelding of video op in een speciale offline opslag en dat artikel of die afbeelding wordt toegankelijk — zowel voor offline weergave via de interface van de gedecentraliseerde client, als in het gedecentraliseerde netwerk zelf! Ik vind het heel handig. Geen onnodige handelingen, en we lossen meteen meerdere problemen op:
- het opslaan van waardevolle content die verloren kan gaan of verwijderd kan worden
- snelle invulling van het gedecentraliseerde netwerk
- aggregatie van content uit verschillende bronnen (je kunt geregistreerd zijn op tientallen internetbronnen en al je likes/herpublicaties zullen samenkomen in een enkele lokale database)
- structurering van interessante content volgens jouw regels
Het is duidelijk dat de browserplugin moet worden afgestemd op de structuur van elke website (dit is heel goed mogelijk – er zijn al plugins die content van YouTube, Twitter, VK, enz. opslaan). Het aantal websites waarvoor het zinvol is om persoonlijke plugins te maken is niet zo groot. Meestal gaat het om enkele populaire sociale netwerken (waarvan er niet meer dan een dozijn zijn) en een aantal hoogwaardige thematische sites zoals Habr (daarvan zijn er ook niet veel). Met de open source code en specificatie zou het ontwikkelen van een nieuwe plugin op basis van een sjabloon niet veel tijd moeten kosten. Voor andere websites kan een universele opslaan-knop worden gebruikt die de hele pagina in mhtml opslaat – mogelijk na eerst de pagina van advertenties te hebben ontdaan.
Nu over structurering
Met ‘slim’ opslaan bedoel ik minimaal het opslaan met meta-informatie: de bron van de content (URL), een set eerder gegeven likes, tags, opmerkingen, hun identificatoren, enz. Bij gewoon opslaan gaat deze informatie namelijk verloren… Onder bron kan niet alleen de directe URL worden begrepen, maar ook de semantische component: bijvoorbeeld de groep in het sociale netwerk of de gebruiker die de repost heeft gemaakt. De plugin kan slim genoeg zijn om deze informatie te gebruiken voor automatische structurering en tagging. Daarnaast moet de gebruiker altijd extra meta-informatie aan de opgeslagen content kunnen toevoegen; hiervoor moeten zo gebruiksvriendelijk mogelijke interface-middelen worden voorzien (ik heb genoeg ideeën hierover).
Zo wordt de vraag naar structurering en organisatie van lokale bestanden van de gebruiker beantwoord. Dit is al een bruikbare functie die zelfs zonder p2p kan worden benut. Gewoon een offline database die weet wat, waar en in welke context we hebben opgeslagen en die kleine onderzoeken mogelijk maakt. Bijvoorbeeld, het vinden van externe sociale netwerkgebruikers die de meeste likes hebben gegeven op dezelfde berichten als jij. Stelt veel sociale netwerken dit openlijk beschikbaar?
Hier moet al worden vermeld dat één browserplug-in natuurlijk niet genoeg is. Het tweede belangrijkste onderdeel van het systeem is de dienst van het gedecentraliseerde netwerk, dat op de achtergrond werkt en zowel het p2p-netwerk bedient (verzoeken uit het netwerk en verzoeken van de client) als het opslaan van nieuwe content via de plug-in. De dienst zal in samenwerking met de plug-in de content op de juiste plaats plaatsen, hashes berekenen (en mogelijk bepalen dat dergelijke content al eerder is opgeslagen), en de benodigde metadata in de lokale database toevoegen.
Interessant genoeg zou het systeem in deze vorm al nuttig zijn, zonder enige p2p. Veel mensen gebruiken webclippers die interessante content uit het web, bijvoorbeeld naar Evernote, toevoegen. De voorgestelde architectuur is een uitgebreide versie van zo'n clipper.
En ten slotte, p2p-uitwisseling
Het leukste is dat informatie en metadata (zowel gevangen uit het web als onze eigen) kunnen worden uitgewisseld. Het concept van een sociale netwerk past perfect in de p2p-architectuur. Je zou kunnen zeggen dat sociale netwerken en p2p als voor elkaar gemaakt zijn. Elk gedecentraliseerd netwerk zou idealiter als sociaal moeten worden opgebouwd, alleen dan zal het effectief werken. "Vrienden", "Groepen" — dat zijn dezelfde peers waarbij duurzame verbindingen moeten zijn, en die komen voort uit een natuurlijke bron: gemeenschappelijke interesses van gebruikers.
De principes van het opslaan en delen van content in een gedecentraliseerd netwerk zijn volledig identiek aan de principes van het opslaan (vangen) van content uit het gewone internet. Als je iets uit het netwerk gebruikt (en dat betekent dat je het hebt opgeslagen), kan iedereen jouw middelen (hardeschijf en bandbreedte) gebruiken die nodig zijn voor het verkrijgen van deze specifieke content.
Likes zijn het eenvoudigste hulpmiddel voor het opslaan en delen. Als ik een like geef — het maakt niet uit of het in het externe internet of binnen het gedecentraliseerde netwerk is — dan betekent dat dat ik de content leuk vind, en aangezien dat zo is, ben ik bereid om het lokaal te houden en het aan andere deelnemers van het gedecentraliseerde netwerk te delen.
- De content zal niet 'verdwijnen'; ik heb het nu lokaal opgeslagen, ik kan er later weer naar terugkomen, wanneer ik maar wil, zonder me zorgen te maken dat iemand het verwijdert of blokkeert.
- Ik kan het categoriseren, taggen, van commentaar voorzien, associëren met andere inhoud, kortom er iets zinnigs mee doen - laten we het 'vorming van metadata' noemen.
- Ik kan deze metadata delen met andere netwerkleden.
- Ik kan mijn metadata synchroniseren met de metadata van andere leden.
Waarschijnlijk lijkt het logisch om geen dislike-knoppen te hebben: als ik geen content leuk vind, is het logisch dat ik geen ruimte op mijn schijf wil verspillen om die content op te slaan en mijn internetverbinding hiervoor wil gebruiken. Daarom passen dislike-knoppen erg slecht in een gedecentraliseerd systeem (hoewel het soms toch nuttig kan zijn. ).
Soms is het nodig om ook wat 'je niet leuk vindt' op te slaan. Er is zo'n woord als 'moet' :)
«Bladwijzers(of 'Favorieten') — ik uit geen mening over de inhoud, maar sla het op in mijn lokale bladwijzerdatabase. Het woord 'favorieten' past niet helemaal bij de betekenis (daar zijn likes en hun verdere categorisatie voor), maar 'bladwijzers' past heel goed. Inhoud in 'bladwijzers' wordt ook gedeeld - als je het 'nodig hebt' (d.w.z. als je het op de een of andere manier 'gebruikt'), dan is het logisch dat het ook 'nodig' kan zijn voor iemand anders. Waarom niet jouw bronnen hiervoor gebruiken?
De functie 'vrienden' is vrij duidelijk. Dit zijn groepen, mensen met vergelijkbare interesses, en dus degenen die waarschijnlijk interessante inhoud zullen hebben. In een gedecentraliseerd netwerk betekent dit vooral het volgen van de nieuwsoverzichten van vrienden en toegang tot hun mappen (albums) met door hen opgeslagen inhoud.
Evenzo de functie 'groepen' — een soort collectieve nieuwsfeeds, of fora, of iets dergelijks, waarop je ook kunt abonneren — en dus alle materialen van de groep ontvangen en delen. Misschien moeten 'groepen', net als grote fora, hiërarchisch zijn — dit zou helpen om de inhoud van groepen beter te structureren en de informatiestroom te beperken, zodat je niets ontvangt of deelt wat je niet echt interessant vindt.
Alles andere
Het is belangrijk op te merken dat een gedecentraliseerde architectuur altijd complexer is dan een gecentraliseerde. In gecentraliseerde bronnen is er een strikte dictatuur van de servercode. In gedecentraliseerde systemen is het noodzakelijk om overeenstemming te bereiken tussen een groot aantal gelijke deelnemers. Uiteraard kan dit niet zonder cryptografie, blockchains en andere innovaties die voornamelijk zijn ontwikkeld voor cryptocurrency.
Ik veronderstel dat er mogelijk enige cryptografische wederzijdse vertrouwensbeoordelingen nodig zijn die door de netwerkdeelnemers voor elkaar worden opgesteld. De architectuur moet effectief het hoofd bieden aan botnets die, bestaand in een bepaalde cloud, bijvoorbeeld hun eigen beoordelingen kunnen manipuleren. Ik hoop dat corporaties en botnetfarms, ondanks hun technologische superioriteit, de controle over zo'n gedecentraliseerd netwerk niet kunnen overnemen; dat de belangrijkste middelen de levende mensen zijn, in staat om content te creëren en te structureren die interessant en nuttig is voor andere levende mensen.
Ook hoop ik dat zo'n netwerk de beschaving vooruit helpt. Ik heb hierover een heleboel ideeën, die echter niet binnen het kader van dit artikel passen. Ik wil alleen zeggen dat bepaalde soorten wetenschappelijke, technische, medische enzovoort content voorrang moeten krijgen boven entertainment, en dat dit inderdaad enige moderatie zal vereisen. Moderatie in zich zelf in een gedecentraliseerd netwerk is geen triviale taak, maar het is oplosbaar (alhoewel het woord 'moderatie' totaal ongepast is en de essentie van het proces — zowel extern als intern — niet weergeeft... en ik heb zelfs niet bedacht hoe ik dit proces zou kunnen noemen).
Het is waarschijnlijk overbodig om te wijzen op de noodzaak om anonimiteit te waarborgen — zowel met ingebouwde middelen (zoals in i2p of Retroshare) als door al het verkeer via TOR te laten lopen. VPN.
En tot slot de softwarearchitectuur (schematisch weergegeven op de afbeelding bij het artikel). Zoals al eerder werd gezegd, is de eerste component van het systeem een browserplugin die content met metadata vastlegt. De tweede belangrijke component is een p2p-service die op de achtergrond werkt (‘backend’). Het functioneren van het netwerk mag duidelijk niet afhankelijk zijn van het feit of de browser is opgestart. De derde component is de clientsoftware — frontend. Dit kan een lokale webservice zijn (in dit geval kan de gebruiker met het gedecentraliseerde netwerk werken zonder zijn favoriete browser te verlaten), of een afzonderlijke GUI-applicatie voor een specifiek besturingssysteem (Windows, Linux, MacOS, Android, iOS, enz.). Ik hou van het idee van het gelijktijdig bestaan van alle frontend-varianten. Dit dwingt ook tot een striktere architectuur van de backend.
Er zijn nog veel meer aspecten die niet in dit artikel zijn opgenomen. Verbinding maken met bestaande bestandsopslag (dat wil zeggen, wanneer je al een paar terabytes hebt gedownload, en je de cliënt laat scannen, de hashes laten verkrijgen, deze vergelijken met wat er al in het netwerk is en aan de distributie deelnemen, en ondertussen informatie over je eigen bestanden uit het netwerk ophalen — normale namen, beschrijvingen, beoordelingen, recensies, enz.), koppeling van externe bronnen van metadata (zoals Libgen-databases), optioneel gebruik van schijfruimte voor de opslag van andere versleutelde content (zoals in Freenet), architectuur van integratie met bestaande gedecentraliseerde netwerken (hier is het echt een duistere woud), het idee van media-hashing (het gebruik van speciale perceptuele hashes voor media-inhoud — afbeeldingen, audio en video, wat het mogelijk maakt om media-bestanden die dezelfde betekenis hebben, maar verschillen in grootte, resolutie, enz. te vergelijken) en nog veel meer.
Korte samenvatting van het artikel
1. In gedecentraliseerde netwerken is er geen Google met zijn zoek- en rankingfunctionaliteiten — maar er zijn wel gemeenschappen van echte mensen. Een sociaal netwerk met zijn feedbackmechanismen (likes, reposts...) en sociale grafieken (vrienden, gemeenschappen...) is het ideale model voor het toepassingsniveau van een gedecentraliseerd netwerk.
2. Het belangrijkste idee dat ik met dit artikel breng, is het automatisch opslaan van interessante inhoud van het reguliere internet bij het geven van een like of een repost; dit kan nuttig zijn, ook zonder p2p, gewoon om een persoonlijk archief van interessante informatie bij te houden.
3. Deze inhoud kan ook automatisch een gedecentraliseerd netwerk vullen.
4. Het principe van het automatisch opslaan van interessante inhoud werkt ook bij likes/reposts binnen het meest gedecentraliseerde netwerk.
Bron: habr.com
