

— dit is een kolomgeoriënteerd databasemanagementsysteem voor online verwerking van analytische queries (OLAP) met open source, ontwikkeld door Yandex. Het wordt gebruikt door Yandex, CloudFlare, VK.com, Badoo en andere diensten wereldwijd voor het opslaan van werkelijk enorme hoeveelheden data (het invoeren van duizenden rijen per seconde of petabytes aan data die op schijf zijn opgeslagen).
In een typische, 'rij-georiënteerde' DBMS, zoals MySQL, Postgres, MS SQL Server, worden gegevens in de volgende volgorde opgeslagen:
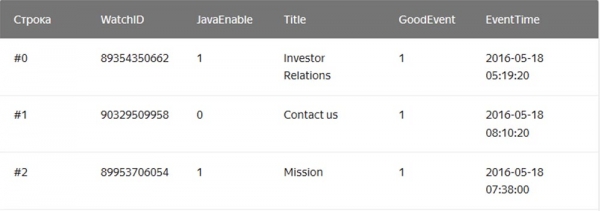
Bij dit systeem worden waarden die bij één rij horen fysiek naast elkaar opgeslagen. In kolomgeoriënteerde DBMS worden waarden uit verschillende kolommen afzonderlijk opgeslagen, terwijl de gegevens van één kolom samen worden bewaard:
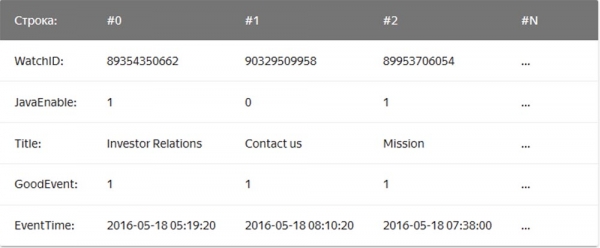
Voorbeelden van kolomgeoriënteerde DBMS zijn Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Bedrijf – mailforwarder begon in 2018 Clickhouse te gebruiken voor rapportage en was zeer onder de indruk van zijn eenvoud, schaalbaarheid, SQL-ondersteuning en snelheid. De snelheid van dit DBMS leek wel magie.
Eenvoud
Clickhouse kan op Ubuntu worden geïnstalleerd met slechts één enkele opdracht. Als je SQL kent, kun je meteen beginnen met Clickhouse voor jouw behoeften. Dit betekent echter niet dat je 'show create table' in MySQL kunt uitvoeren en de SQL zomaar naar Clickhouse kunt kopiëren.
Ten opzichte van MySQL zijn er belangrijke verschillen in datatypes in de schema-definities van deze DBMS, dus voor een comfortabele werking heb je enige tijd nodig om de schema-definities aan te passen en de tabelengines te leren.
Clickhouse werkt uitstekend zonder enige extra software, maar als je replicatie wilt gebruiken, moet je ZooKeeper installeren. Prestatie-analyse van queries toont uitstekende resultaten aan — systeemtabel bevatten alle informatie en alle gegevens kunnen worden verkregen via traditionele en saaie SQL.
Prestaties
- vergelijkingen van Clickhouse met Vertica en MySQL op een serverconfiguratie: twee sockets Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 op 8 6TB SATA HDD's, ext4.
- vergelijkingen van Clickhouse met de cloud data warehouse Amazon RedShift.
- Uittreksels uit de blog :
De ClickHouse-database heeft een zeer eenvoudig ontwerp: alle knooppunten in de cluster hebben dezelfde functionaliteit en gebruiken alleen ZooKeeper voor coördinatie. We hebben een kleine cluster van enkele knooppunten opgebouwd en tests uitgevoerd, waarbij we ontdekten dat het systeem een behoorlijk indrukwekkende prestatie levert, wat overeenkomt met de geclaimde voordelen in de benchmarks voor analytische databases. We besloten om dieper in te gaan op het concept dat ten grondslag ligt aan ClickHouse. Het eerste obstakel voor ons onderzoek was het gebrek aan tools en de kleine gemeenschap rondom ClickHouse, dus verdiepten we ons in het ontwerp van deze database om te begrijpen hoe het werkt.
ClickHouse ondersteunt het rechtstreeks ontvangen van gegevens van Kafka niet, omdat het slechts een database is. Daarom hebben we een eigen adapterservice geschreven in Go. Deze leest gecodeerde berichten van Cap’n Proto uit Kafka, zet deze om in TSV en voegt ze in batches via de HTTP-interface in ClickHouse in. Later herschreven we deze service om de Go-bibliotheek samen met de eigen interface van ClickHouse te gebruiken voor betere prestaties. Bij het evalueren van de prestaties van het ontvangen van batches ontdekten we iets belangrijks: de prestaties van ClickHouse zijn sterk afhankelijk van de batchgrootte, oftewel het aantal gelijktijdig ingevoegde rijen. Om te begrijpen waarom dit gebeurt, hebben we onderzocht hoe ClickHouse gegevens opslaat.
De belangrijkste engine, beter gezegd, de motorfamilie voor tabellen die door ClickHouse wordt gebruikt voor het opslaan van gegevens, is MergeTree. Deze engine is conceptueel vergelijkbaar met het LSM-algoritme dat wordt toegepast in Google BigTable of Apache Cassandra, maar vermijdt de opbouw van een tussentijdse geheugen-tabel en schrijft gegevens direct op schijf. Dit geeft het een uitstekende schrijfcapaciteit, aangezien elke ingevoegde batch alleen wordt gesorteerd op de 'primaire sleutel' (primary key), gecomprimeerd en op schijf geschreven om een segment te vormen.
Het ontbreken van een geheugen tabel of enig concept van 'versheid' van gegevens betekent ook dat ze alleen kunnen worden toegevoegd; het wijzigen of verwijderen wordt door het systeem niet ondersteund. Tot nu toe is de enige manier om gegevens te verwijderen deze per kalendermaand te verwijderen, aangezien segmenten nooit de maandgrens overschrijden. Het ClickHouse-team werkt actief aan het maken van deze functie configureerbaar. Aan de andere kant maakt dit het opnemen en samenvoegen van segmenten probleemloos, waardoor de doorvoersnelheid lineair schaalt met het aantal gelijktijdige invoeracties totdat I/O of kernen verzadigd zijn.
Echter, deze omstandigheid betekent ook dat het systeem niet geschikt is voor kleine pakketten, waardoor Kafka-diensten en invoermachines voor buffering worden gebruikt. Verder blijft ClickHouse op de achtergrond constant segmenten samenvoegen, zodat veel kleine gegevensstukken worden samengevoegd en meerdere keren worden geschreven, en zo de schrijfintensiteit opbouwen. Tegelijkertijd zal een te groot aantal niet-verbonden stukken agressieve throttling van invoeren veroorzaken totdat de samenvoeging doorgaat. We hebben ontdekt dat de beste compromis tussen het accepteren van gegevens in realtime en de prestaties van de acceptatie binnen een beperkte hoeveelheid invoeren per seconde ligt.
De sleutel tot de leesprestaties van tabellen is indexering en de locatie van gegevens op de schijf. Ongeacht hoe snel de verwerking is, wanneer de engine terabytes aan gegevens vanaf de schijf moet scannen en alleen een deel daarvan gebruikt, kost dat tijd. ClickHouse is een kolom-georiënteerde opslag, dus elk segment bevat een bestand voor elke kolom met gesorteerde waarden voor elke rij. Hierdoor kunnen hele kolommen die in de query ontbreken eerst worden overgeslagen, en vervolgens kunnen verschillende cellen parallel worden verwerkt met gevectoriseerde uitvoering. Om een volledige scanning te voorkomen, heeft elk segment een klein indexbestand.
Aangezien alle kolommen zijn gesorteerd op de 'primaire sleutel', bevat het indexbestand alleen de labels (gevangen rijen) van elke N-de rij, zodat ze zelfs voor zeer grote tabellen in het geheugen kunnen worden opgeslagen. Bijvoorbeeld, het is mogelijk om standaardinstellingen in te stellen om 'iedere 8192-de rij te markeren', waardoor 'schaarse' indexering van een tabel met 1 triljoen rijen, die gemakkelijk in het geheugen past, slechts 122.070 tekens zou kosten.
Ontwikkeling van het systeem
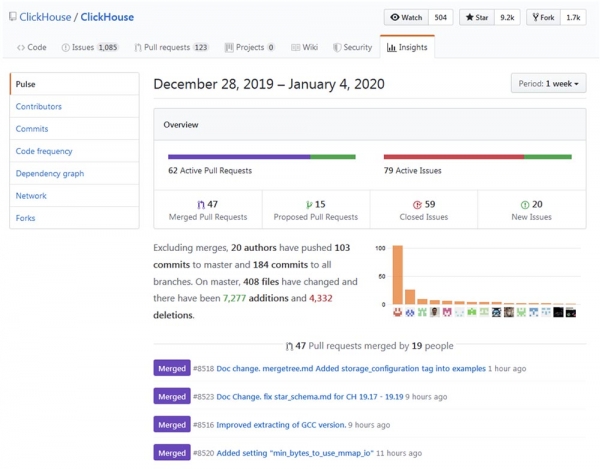
De ontwikkeling en verbetering van Clickhouse is te volgen op en je kunt zien dat het proces van 'groei' op indrukwekkende snelheid plaatsvindt.
Populariteit
Het lijkt erop dat de populariteit van Clickhouse exponentieel toeneemt, vooral in de Russischtalige gemeenschap. De conferentie High load 2018 (Moskou, 8-9 november 2018) toonde aan dat grote spelers zoals vk.com en Badoo Clickhouse gebruiken om gegevens (bijvoorbeeld logs) van tienduizenden servers gelijktijdig in te voegen. In een video van 40 minuten . Binnenkort zullen we de transcriptie op Habr publiceren voor gemakkelijke werking met het materiaal.
Toepassingsgebieden
Nadat ik een tijd heb besteed aan onderzoek, denk ik dat er gebieden zijn waar ClickHouse nuttig kan zijn of andere, meer traditionele en populaire oplossingen zoals MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot en Druid volledig kan vervangen. Hieronder worden de details van het gebruik van ClickHouse voor modernisering of volledige vervanging van de bovengenoemde databases uiteengezet.
Uitbreiding van de mogelijkheden van MySQL en PostgreSQL
Onlangs hebben we MySQL gedeeltelijk vervangen door ClickHouse voor het platform voor nieuwsbrieven. Het probleem was dat MySQL, door een ondoordachte ontwerp, elke verzonden e-mail en elke link in die e-mail registreerde met een base64-hash, wat resulteerde in een enorme MySQL-tabel (email_stats). Na het verzenden van slechts 10 miljoen e-mails naar de abonnees, nam deze tabel 150 GB aan schijfruimte in, en MySQL begon te 'vertragen' bij eenvoudige verzoeken. Om het schijfruimteprobleem op te lossen, hebben we met succes de InnoDB-tabelcompressie gebruikt, waardoor deze vier keer kleiner werd. Echter, het heeft nog steeds geen zin om meer dan 20-30 miljoen e-mails in MySQL op te slaan alleen om de geschiedenis te lezen, aangezien elk eenvoudig verzoek, dat om welke reden dan ook een volledige scan moet uitvoeren, leidt tot swap en hoge I/O-belasting, waarvoor we regelmatig Zabbix-waarschuwingen ontvingen.
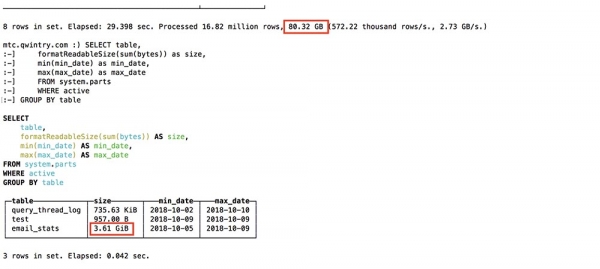
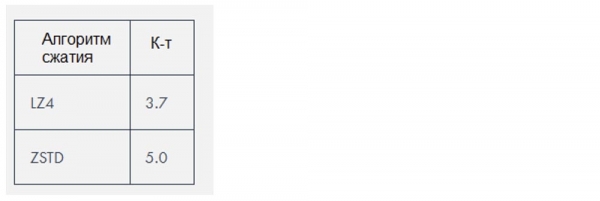
Clickhouse maakt gebruik van twee compressie-algoritmen die de datagrootte met ongeveer , maar in dit specifieke geval waren de gegevens bijzonder 'samendrukbaar'.
Vervangen van ELK
Op basis van onze eigen ervaring vereist de ELK-stack (ElasticSearch, Logstash en Kibana, in dit geval ElasticSearch) veel meer middelen om te draaien dan nodig is voor het opslaan van logboeken. ElasticSearch is een uitstekende engine als je goede full-text zoekfunctionaliteit in logs nodig hebt (en ik denk niet dat je dat echt nodig hebt), maar ik vraag me af waarom het de facto de standaard engine voor logboekregistratie is geworden. De ontvangstprestaties in combinatie met Logstash veroorzaakten problemen, zelfs bij relatief kleine belasting, en vereisten steeds meer RAM en schijfruimte. Als database is Clickhouse beter dan ElasticSearch om de volgende redenen:
- Ondersteuning van SQL-dialect;
- Betere compressiegraad van opgeslagen gegevens;
- Ondersteuning voor reguliere expressies Regex in plaats van full-text zoekopdrachten;
- Verbeterde query-planning en hogere algehele prestaties.
Momenteel is het grootste probleem bij het vergelijken van ClickHouse met ELK het gebrek aan oplossingen voor het verzenden van logs, evenals het gebrek aan documentatie en tutorials over dit onderwerp. In dit opzicht kan elke gebruiker ELK configureren met behulp van de Digital Ocean-gids, wat van groot belang is voor een snelle implementatie van dergelijke technologieën. Hier is er een database-engine, maar er is nog geen Filebeat voor ClickHouse. Ja, dat is er wel aanwezig. en systeem voor logbestanden , er bestaat een tool voor het invoeren van logbestandsgegevens in ClickHouse, maar dit kost meer tijd. Desondanks blijft ClickHouse de voorkeur genieten vanwege zijn eenvoud, waardoor zelfs beginners het binnen 10 minuten eenvoudig kunnen installeren en gebruiksklaar zijn.
Gezien mijn voorkeur voor minimalistische oplossingen, heb ik geprobeerd FluentBit te gebruiken, een hulpmiddel voor het verzenden van logs met een zeer klein geheugenverbruik, samen met ClickHouse, terwijl ik probeerde Kafka te vermijden. Echter, er moeten kleine incompatibiliteiten worden opgelost, zoals , voordat dit zonder een proxylaag kan worden gedaan die de gegevens van FluentBit naar ClickHouse converteert.
Als alternatief voor Kibana kan ClickHouse als backend worden gebruikt . Voor zover ik begrijp, kunnen er prestatieproblemen optreden bij het weergeven van een enorm aantal gegevenspunten, vooral met oudere versies van Grafana. Bij Qwintry hebben we dit nog niet geprobeerd, maar klachten hierover verschijnen af en toe op het ClickHouse-ondersteuningskanaal in Telegram.
Vervanging van Google Big Query en Amazon RedShift (oplossing voor grote bedrijven)
De ideale manier om BigQuery te gebruiken, is door 1 TB aan JSON-gegevens te uploaden en analytische queries uit te voeren. Big Query is een geweldig product, waarvan de schaalbaarheid moeilijk te overschatten is. Het is veel complexere software dan ClickHouse, die op een interne cluster draait, maar vanuit het klantperspectief heeft het veel gemeen met ClickHouse. BigQuery kan snel 'duur worden' zodra je gaat betalen voor elke SELECT, dus het is een echte SaaS-oplossing met al zijn voor- en nadelen.
ClickHouse is de beste keuze als je veel computationeel dure queries uitvoert. Hoe meer SELECT-queries je elke dag uitvoert, hoe zinvoller het is om Big Query te vervangen door ClickHouse, omdat deze vervangingen je duizenden dollars kunnen besparen als het gaat om veel terabytes aan verwerkte gegevens. Dit geldt niet voor opgeslagen gegevens, waarvan de verwerking in Big Query redelijk goedkoop is.
In een artikel van medeoprichter Alexander Zaytsev van Altinity worden de voordelen van een dergelijke migratie van databasesystemen besproken.
Vervanging van TimescaleDB
TimescaleDB is an extension of PostgreSQL that optimizes the handling of time-series data in a regular database, ).
Although ClickHouse is not a serious competitor in the time-series niche, its columnar structure and vectorized query execution make it significantly faster than TimescaleDB for most analytical query processing. Moreover, ClickHouse's performance for bulk data ingestion is approximately three times higher, and it consumes 20 times less disk space, which is crucial for processing large volumes of historical data..
In contrast to ClickHouse, the only way to save some disk space in TimescaleDB is by using ZFS or similar file systems.
Upcoming updates to ClickHouse will likely introduce delta compression, making it even more suitable for handling and storing time-series data. TimescaleDB might be a better choice than 'bare' ClickHouse in the following cases:
- small installations with very low amounts of RAM (<3 GB);
- a large number of small INSERTs that you do not want to buffer into large chunks;
- better consistency, uniformity, and ACID requirements;
- PostGIS support;
- integration with existing PostgreSQL tables, as TimescaleDB is essentially PostgreSQL.
Competition with Hadoop and MapReduce
Hadoop and other MapReduce products can perform many complex computations, but they generally operate with significant latencies. ClickHouse addresses this issue by processing terabytes of data and providing results nearly instantaneously. Thus, ClickHouse is much more efficient for conducting rapid, interactive analytical research, which should interest data processing professionals.
Competition with Pinot and Druid
The closest competitors to ClickHouse are the columnar linearly scalable open-source products Pinot and Druid. An excellent comparison of these systems was published in the article from February 1, 2018.
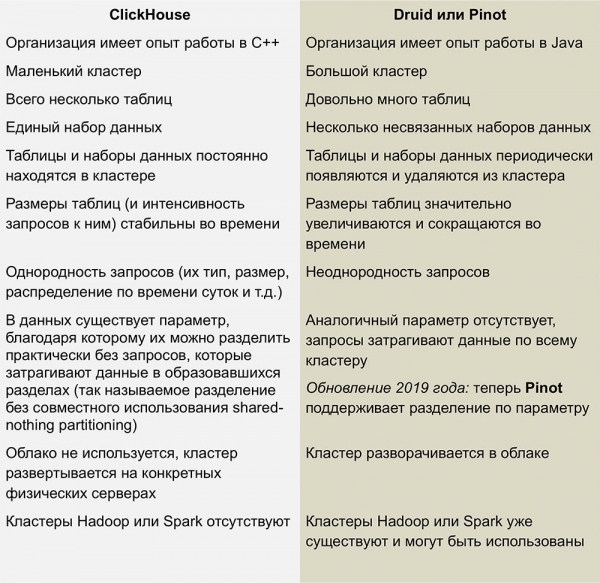
This article requires updating – it mentions that ClickHouse does not support UPDATE and DELETE operations, which is not entirely accurate regarding the latest versions.
Wij hebben niet genoeg ervaring met deze databases, maar de complexiteit van de infrastructuur die nodig is om Druid en Pinot te draaien vindt ik echt niet prettig - het is een heleboel 'bewegende onderdelen', omringd door Java van alle kanten.
Druid en Pinot zijn incubatorprojecten van Apache, waarvan de ontwikkeling uitgebreid wordt belicht door Apache op de pagina's van hun GitHub-projecten. Pinot verscheen in de incubator in oktober 2018, terwijl Druid acht maanden eerder - in februari - werd geboren.
Het gebrek aan informatie over hoe AFS werkt, roept bij mij enkele, en mogelijk domme, vragen op. Ik vraag me af of de auteurs van Pinot opgemerkt hebben dat de Apache Foundation meer geneigd is om Druid te steunen, en of een dergelijke houding ten opzichte van de concurrent misschien jaloezie heeft veroorzaakt? Zal de ontwikkeling van Druid vertragen en die van Pinot versnellen, als de sponsors die de eerste steunen plotseling geïnteresseerd raken in de tweede?
Nadelen van ClickHouse
Onvolwassenheid: het is duidelijk dat dit nog steeds een spannende technologie is, maar in elk geval is er niets dergelijks te zien in andere kolomgeoriënteerde databases.
Kleine inserts presteren slecht bij hoge snelheid: inserts moeten worden verdeeld in grote brokken, omdat de prestaties van kleine inserts evenredig afnemen met het aantal kolommen in elke rij. Zo worden de gegevens in ClickHouse op schijf opgeslagen - elke kolom vertegenwoordigt 1 of meer bestanden, dus voor het invoegen van 1 rij met 100 kolommen, moeten er ten minste 100 bestanden worden geopend en geschreven. Daarom is er een tussenpersoon nodig voor het bufferen van inserts (tenzij de client zelf het bufferen verzorgt) - meestal is dat Kafka of een of ander queue management systeem. Je kunt ook de Buffer table engine gebruiken om later grote fragmenten gegevens naar MergeTree-tabellen te kopiëren.
De joins van tabellen zijn beperkt door het RAM van de server, maar in ieder geval zijn ze daar! Bijvoorbeeld, Druid en Pinot hebben helemaal geen dergelijke joins, omdat ze moeilijk te implementeren zijn in gedistribueerde systemen die geen grote hoeveelheden gegevens tussen nodes kunnen verplaatsen.
Conclusies
In de komende jaren zijn we van plan om ClickHouse breed te gebruiken bij Qwintry, omdat deze databasebeheersysteem een uitstekende balans biedt tussen prestatie, lage overhead, schaalbaarheid en eenvoud. Ik ben er bijna zeker van dat het snel zal verspreiden zodra de ClickHouse-gemeenschap meer manieren bedenkt om het te gebruiken bij kleine en middelgrote installaties.
Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
