

De feestdagen zijn voorbij en we zijn terug met onze tweede post in de serie over Istio Service Mesh.
Het onderwerp van vandaag is Circuit Breaker, wat in het Nederlands ‘automatische onderbreker’ betekent, in de volksmond ook wel ‘beveiligingsautomaat’. Alleen in Istio schakelt deze onderbreker geen kortsluiting of overbelaste schakelingen uit, maar defecte containers.
Hoe dit idealiter zou moeten werken
Wanneer microservices worden beheerd door Kubernetes, bijvoorbeeld binnen het OpenShift-platform, schalen ze automatisch op en neer afhankelijk van de belasting. Aangezien microservices in pods draaien, kunnen er op één eindpunt meerdere exemplaren van een containerized microservice zijn, en Kubernetes zal de aanvragen routeren en lasten balanceren tussen hen. En – idealiter – zou dit alles perfect moeten functioneren.
We herinneren ons dat microservices klein en efemeer zijn. Deze efemere aard, die hier betekent dat ze gemakkelijk ontstaan en verdwijnen, wordt vaak onderschat. De geboorte en dood van elk exemplaar van een microservice in een pod zijn heel normale gebeurtenissen. OpenShift en Kubernetes gaan hier goed mee om, en alles werkt fantastisch – maar weer, dat is in theorie.
Hoe het echt werkt
Stel je nu voor dat een specifiek exemplaar van een microservice, dat wil zeggen een container, defect is geraakt: het reageert ofwel niet (fout 503), ofwel – wat erger is – reageert het, maar te traag. Met andere woorden, het werkt moeizaam of reageert niet op aanvragen, maar wordt niet automatisch uit de pool verwijderd. Wat moet je in dit geval doen? De poging herhalen? Het uit het routeringsschema verwijderen? En wat betekent ‘te traag’ – hoeveel is dat in cijfers, en wie bepaalt die? Misschien gewoon een pauze geven en later opnieuw proberen? En zo ja, hoe veel later?
Wat is Pool Ejection in Istio
En hier komt Istio te hulp met zijn Circuit Breaker-automatische systemen, die defecte containers tijdelijk uit de pool van routerings- en belastingseffectieve bronnen verwijderen door de Pool Ejection-procedure uit te voeren.
Met behulp van een outlier detection-strategie detecteert Istio afwijkende pods die uit de lijn vallen, en verwijdert ze voor een bepaalde tijd uit de bronpool, die het ‘slaapvenster’ (sleep window) wordt genoemd.
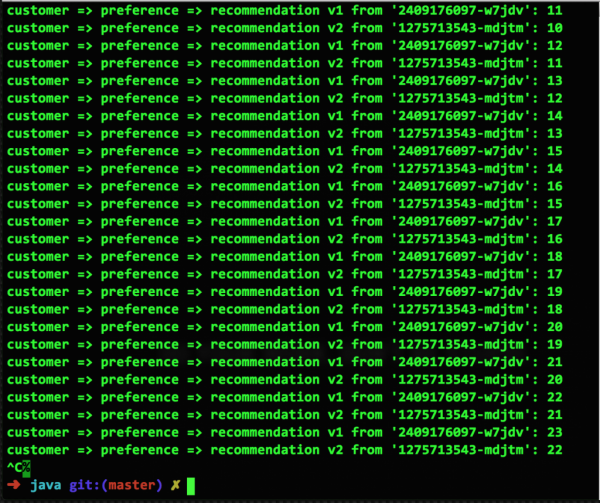
Om te laten zien hoe dit werkt in Kubernetes op het OpenShift-platform, beginnen we met een screenshot van normaal werkende microservices uit het voorbeeld in de repository . Hier hebben we twee pods, v1 en v2, elk met één draaiende container. Wanneer er geen Istio-routeringsregels worden gebruikt, past Kubernetes standaard een gelijkmatig gebalanceerde cyclische routering toe:
Voorbereiden op de storing
Voordat we Pool Ejection uitvoeren, moeten we een Istio-routeringsregel creëren. Stel dat we verzoeken 50/50 willen verdelen tussen de pods. Daarnaast zullen we het aantal containers van v2 verhogen van één naar twee, zo:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Nu stellen we de routeringsregel in zodat het verkeer 50/50 tussen de pods wordt verdeeld.
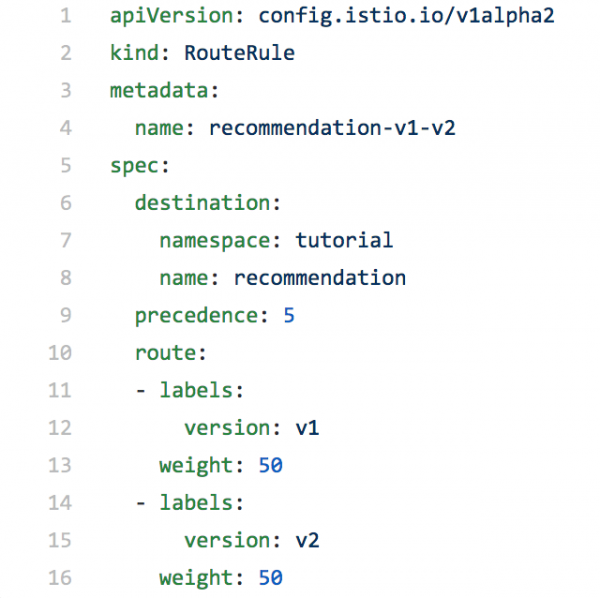
En zo ziet het resultaat van deze regel eruit:
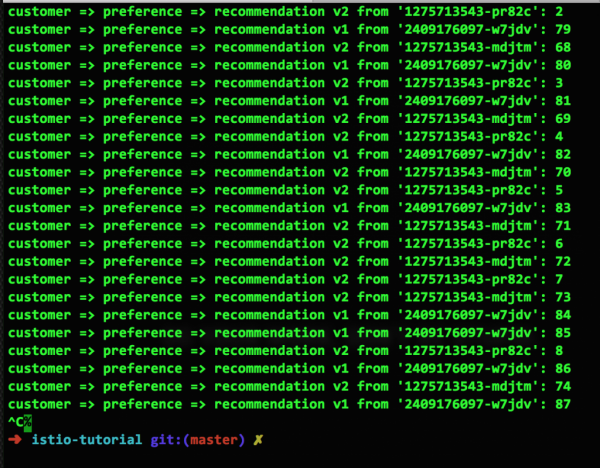
Men kan aanmerken dat op deze screenshot niet 50/50, maar 14:9 is, maar na verloop van tijd zal de situatie verbeteren.
Een storing creëren
Laten we nu een van de twee containers van v2 uit schakelen, zodat we één werkende container v1, één werkende container v2 en één defecte container v2 hebben:
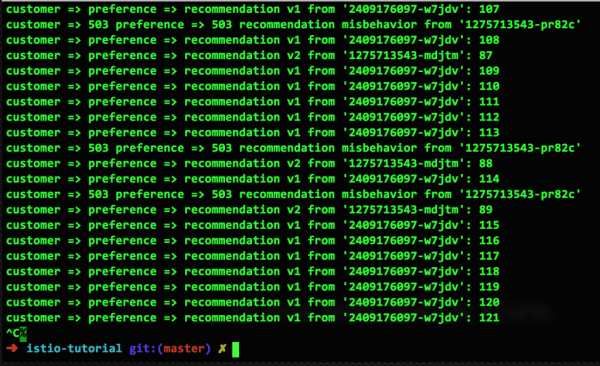
De storing herstellen
Dus, we hebben een defecte container, en het is tijd voor Pool Ejection. Met een zeer eenvoudige configuratie zullen we deze defecte container 15 seconden uitsluiten van alle routeringsschema's in de verwachting dat deze vanzelf weer in een goede staat terugkeert (of opnieuw opstart of zijn prestaties herstelt). Zo ziet deze configuratie eruit en de resultaten ervan:
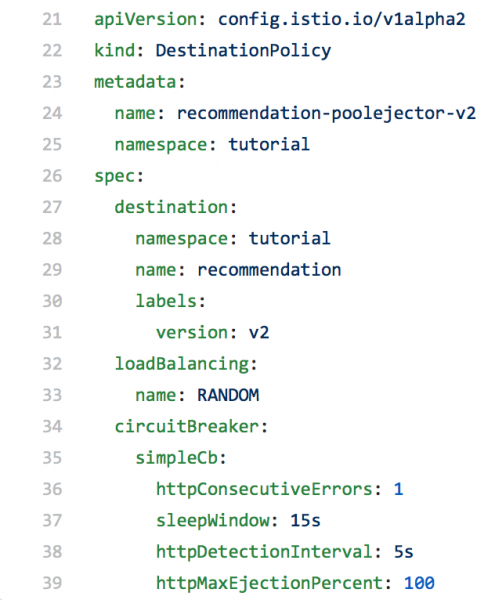
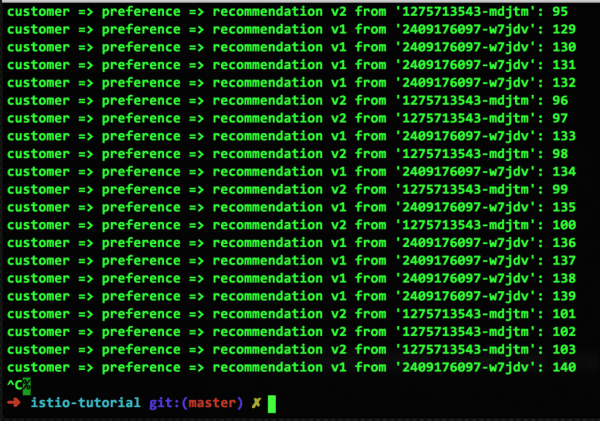
Zoals te zien is, wordt de defecte container v2 niet meer gebruikt voor het routeren van verzoeken, omdat hij uit de pool is gehaald. Maar na 15 seconden zal hij automatisch terugkeren naar de pool. Eigenlijk hebben we zojuist laten zien hoe Pool Ejection werkt.
We beginnen met het bouwen van de architectuur
Pool Ejection in combinatie met de monitoringmogelijkheden van Istio stelt ons in staat om een kader te creëren voor het automatisch vervangen van defecte containers, om stilstand en storingen te verminderen of zelfs volledig te elimineren.
NASA heeft één luidsprekende leus – Failure Is Not an Option, waarvan wordt gezegd dat deze afkomstig is van de vluchtleider . In het Nederlands zou je dit kunnen vertalen als "Mislukken is geen optie", en de betekenis hier is dat alles kan werken als je maar voldoende wil hebt. Echter, in het echte leven gebeuren storingen niet zomaar, ze zijn onvermijdelijk, overal en altijd. Hoe gaan we om met deze storingen in het geval van microservices? Naar onze mening is het beter om niet op wilskracht te vertrouwen, maar op de mogelijkheden van containers. , , en .
Istio, zoals we hierboven al hebben aangegeven, implementeert een goed bewezen concept uit de fysieke wereld: automatische zekeringen. Net zoals een elektrische zekering een probleemgedeelte van de circuit uitschakelt, verbreekt de software Circuit Breaker in Istio de link tussen de stroom van verzoeken en de probleemcontainer wanneer er iets mis is met de eindbestemming, bijvoorbeeld wanneer de server is gecrasht of traag is geworden.
Bovendien zijn er in het tweede geval nog meer problemen, omdat de vertragingen van één container niet alleen een cascade van vertragingen veroorzaken in de bijbehorende services en daardoor de algehele systeemprestaties verlagen, maar ook leiden tot herhaaldelijke verzoeken aan de al trage service, wat de situatie alleen maar verergert.
Circuit Breaker in theorie
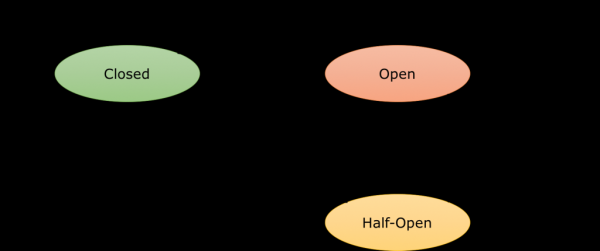
Circuit Breaker is een proxy die de stroom van verzoeken naar een eindbestemming controleert. Wanneer deze bestemming niet meer werkt of - afhankelijk van de ingestelde configuraties - begint te vertragen, verbreekt de proxy de verbinding met de container. Daarna wordt het verkeer omgeleid naar andere containers, gewoonweg voor belastingverdeling. De verbinding blijft open (open) gedurende een vooraf ingestelde slaapperiode, laten we zeggen twee minuten, en wordt daarna als half-open (half-open) beschouwd. Een poging om het volgende verzoek te verzenden, bepaalt de verdere status van de verbinding. Als alles in orde is met de service, wordt de verbinding hersteld en weer gesloten (closed). Als er echter nog steeds iets mis is met de service, wordt de verbinding opnieuw verbroken en wordt de slaapperiode opnieuw geactiveerd. Zo ziet een vereenvoudigd diagram van de statusovergangen van de Circuit Breaker eruit:
Het is belangrijk op te merken dat dit allemaal plaatsvindt op wat we noemen het niveau van de systeemarchitectuur. Daarom moet je op een gegeven moment je applicaties leren werken met Circuit Breaker, bijvoorbeeld door een standaardwaarde terug te geven of, indien mogelijk, het bestaan van de service te negeren. Hiervoor gebruiken we het bulkhead-patroon, maar dit valt buiten de reikwijdte van dit artikel.
Circuit Breaker in de praktijk
Als voorbeeld zullen we twee versies van onze aanbevelingsmicroservice op OpenShift draaien. Versie 1 zal normaal functioneren, terwijl we in v2 een vertraging toevoegen om serververtraging te simuleren. Voor het bekijken van de resultaten gebruiken we een tool. :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
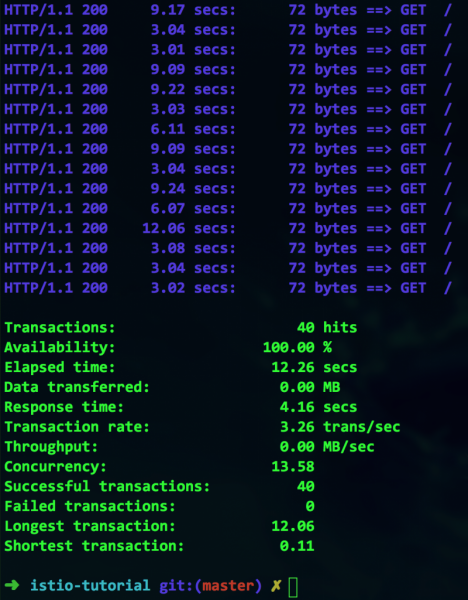
Alles lijkt te werken, maar tegen welke prijs? Op het eerste gezicht hebben we 100% beschikbaarheid, maar let goed op – de maximale duur van de transactie bedraagt maar liefst 12 seconden. Dit is duidelijk een knelpunt dat we moeten verhelpen.
Om dit te doen, sluiten we met behulp van Istio de aanvragen naar trage containers uit. Zo ziet de bijbehorende configuratie eruit met Circuit Breaker:
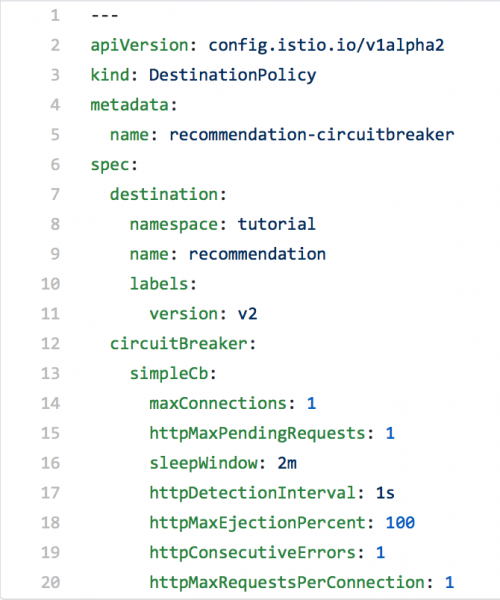
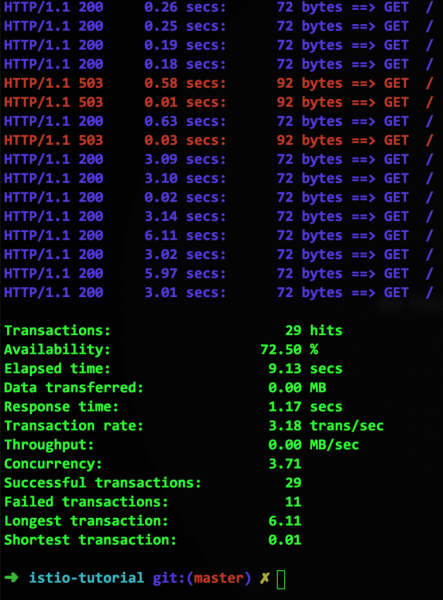
De laatste regel met de parameter httpMaxRequestsPerConnection geeft aan dat de verbinding moet worden verbroken bij de poging om een tweede verbinding te maken naast de al bestaande. Aangezien onze container een traag service simuleert, zullen dergelijke situaties zich periodiek voordoen, en dan zal Istio een 503-fout teruggeven, terwijl Siege het volgende toont:
Oké, we hebben Circuit Breaker, wat nu?
Dus we hebben automatische uitschakeling geïmplementeerd, zonder de broncode van de services zelf aan te raken. Door gebruik te maken van Circuit Breaker en de hierboven beschreven procedure voor Pool Ejection, kunnen we de trage containers uit de pool van resources verwijderen totdat ze weer normaal functioneren, en hun status op vooraf bepaalde tijdstippen controleren – in ons voorbeeld is dit om de twee minuten (parameter sleepWindow).
Let op dat het vermogen van de applicatie om te reageren op een 503-fout nog steeds op het niveau van de broncode is ingesteld. Er zijn verschillende strategieën voor het omgaan met Circuit Breaker, afhankelijk van de situatie.
In de volgende post: zullen we het hebben over tracing en monitoring, die al zijn ingebouwd of gemakkelijk aan Istio kunnen worden toegevoegd, evenals hoe je opzettelijk fouten in het systeem kunt introduceren.
Bron: habr.com
