

Volgens , data engineer is momenteel een van de snelst groeiende beroepen. Data engineers spelen een cruciale rol binnen organisaties – ze creëren en onderhouden de pipelines en databases die worden gebruikt voor het verwerken, transformeren en opslaan van gegevens. Welke vaardigheden zijn voor deze functie het belangrijkst? Verschilt de lijst van wat nodig is van data scientists? Dit alles komt aan bod in mijn artikel.
Ik heb vacatures voor de functie van data engineer geanalyseerd zoals ze er in januari 2020 uitzagen, om te begrijpen welke technologische vaardigheden het meest in trek zijn. Daarna heb ik de resultaten vergeleken met de statistieken voor vacatures van data scientists – hierbij kwamen enkele interessante verschillen aan het licht.
Laten we zonder verdere introducties meteen naar de top tien technologieën gaan die het vaakst in vacatures worden genoemd:
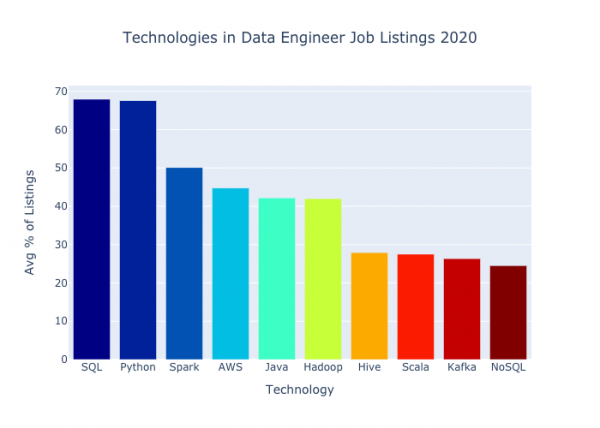
Vermeldingen van technologieën in vacatures voor de functie van data engineer in 2020
Laten we dit uitzoeken.
Verantwoordelijkheden van een data engineer
Tegenwoordig is het werk dat data engineers verrichten van groot belang voor organisaties – deze mensen zijn verantwoordelijk voor het opslaan van informatie en het omzetten ervan in een formaat waar andere medewerkers mee kunnen werken. Data engineers bouwen pipelines om de gegevensstromen of batches uit verschillende bronnen te verzamelen. Vervolgens voeren de pipelines extractie-, transformatie- en laadprocessen uit (ook wel ETL-processen genoemd), zodat de gegevens beter bruikbaar zijn voor verdere verwerking. Daarna worden de gegevens overgedragen aan analisten en data scientists voor diepere analyses. Ten slotte eindigen de gegevens in dashboards, rapporten en modellen voor machine learning.
Ik zocht naar informatie die kon helpen bij het bepalen welke technologieën momenteel het meest gewild zijn in het werk van een data engineer.
Methoden
Ik heb informatie verzameld van drie vacaturesites – , en en onderzocht welke zoekwoorden worden gebruikt in combinatie met 'data engineer' in vacatures gericht op bewoners van de Verenigde Staten. Voor deze taak heb ik twee Python-bibliotheken gebruikt – en Ik heb zowel de zoekwoorden die in de eerdere lijst voor de analyse van vacatures voor data scientists waren opgenomen, als de woorden die ik handmatig heb geselecteerd door vacatures voor data engineers te lezen, meegenomen. LinkedIn is niet als bron opgenomen, omdat ik daar ben verbannen na mijn vorige poging om gegevens te verzamelen.
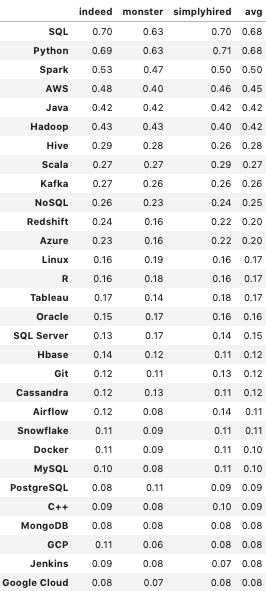
Voor elk zoekwoord heb ik het percentage vermeldingen berekend van het totale aantal teksten op elke site afzonderlijk, en vervolgens de gemiddelde waarde over de drie bronnen berekend.
Resultaten
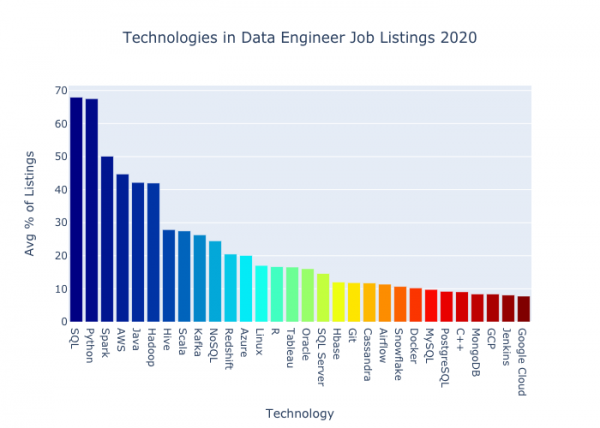
Hieronder staan dertig technische termen uit het veld van data engineering met de hoogste scores op alle drie de vacaturewebsites.
Hier zijn dezelfde cijfers, maar gepresenteerd in tabelvorm:
Laten we stap voor stap doorgaan.
Overzicht van de resultaten
Zowel SQL als Python komen voor in meer dan twee derde van de bekeken vacatures. Deze twee technologieën zijn dan ook het belangrijkst om als eerste te leren. – een zeer populaire programmeertaal die wordt gebruikt voor dataverwerking, het maken van websites en het schrijven van scripts. staat voor Structured Query Language; het is een standaard die wordt gerealiseerd door een groep talen en wordt gebruikt voor het ophalen van gegevens uit relationele databases. Het bestaat al geruime tijd en heeft zich bewezen door zijn hoge stabiliteit.
Spark wordt in ongeveer de helft van de vacatures genoemd. – een 'gecombineerde analytische engine voor big data processing met ingebouwde modules voor streaming, SQL, machine learning en grafenverwerking'. Het is bijzonder populair bij degenen die met grote databases werken.
AWS komt in ongeveer 45% van de vacatureteksten voor. Dit is een cloud computing-platform van Amazon; het heeft het grootste marktaandeel onder alle cloudplatforms.
Daarna volgen Java en Hadoop – iets meer dan 40% per stuk. – een wijdverspreide, bewezen taal die in de tiende plaats behaalde onder de talen die ontwikkelaars angst aanjagen. Daarentegen was Python de tweede meest geliefde taal. Java wordt gedomineerd door Oracle, en alles wat je erover moet weten, is te begrijpen uit deze screenshot van de officiële pagina van januari 2020.
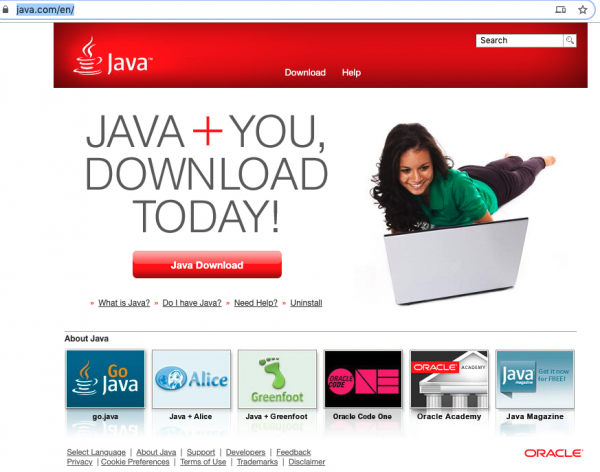
Alsof ik in een tijdmachine heb gereden
maakt gebruik van het softwaremodel MapReduce met serverclusters voor big data. Deze model wordt steeds vaker verlaten.
Daarna zien we Hive, Scala, Kafka en NoSQL – elk van deze technologieën komt in een kwart van de gepresenteerde vacatures voor. Apache Hive is een databasestoftware die "het lezen, schrijven en beheersen van grote datasets in gedistribueerde opslag vergemakkelijkt met behulp van SQL". is een programmeertaal die actief wordt gebruikt bij het werken met big data. In het bijzonder is Spark gemaakt in Scala. In de eerder genoemde ranking van populaire programmeertalen staat Scala op de elfde plaats. is een gedistribueerd platform voor het verwerken van streamingberichten. Het is zeer populair als middel voor datastreaming.
stellen zichzelf tegenover SQL. Ze verschillen doordat ze niet relationeel, niet gestructureerd zijn en over horizontale schaalbaarheid beschikken. NoSQL heeft enige populariteit veroverd, maar de koortsachtige fascinatie voor deze benadering, die zelfs leidde tot profetieën dat het SQL zou vervangen als dominante opslagparadigma, lijkt inmiddels voorbij.
Vergelijking met de termen in data scientist vacatures
Hier zijn dertig technologiegerelateerde termen die het meest voorkwamen bij werkgevers in de data science sector. Deze lijst heb ik op dezelfde manier verkregen als eerder beschreven voor data engineering.
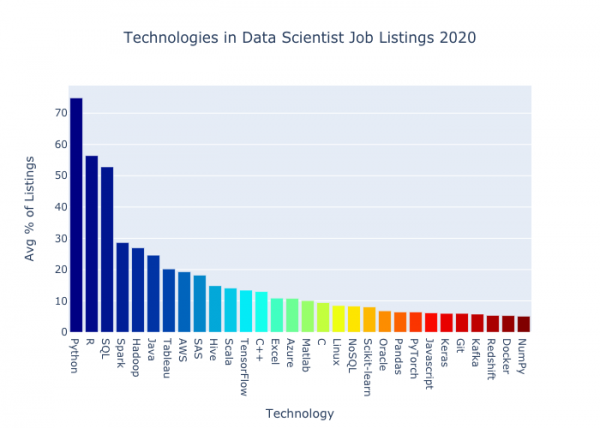
Vermeldingen van technologieën in vacatures voor de positie van data scientist in 2020
Als we kijken naar het totaal aantal, zijn er vergeleken met de eerder bekeken set, 28% meer vacatures (12.013 tegenover 9.396). Laten we kijken naar welke technologieën minder vaak voorkomen in vacatures voor data scientists dan voor data engineers.
Populairder in data engineering
In de onderstaande grafiek zijn de sleutelwoorden weergegeven met een gemiddelde afwijking in waarden van meer dan 10% of minder dan -10%.
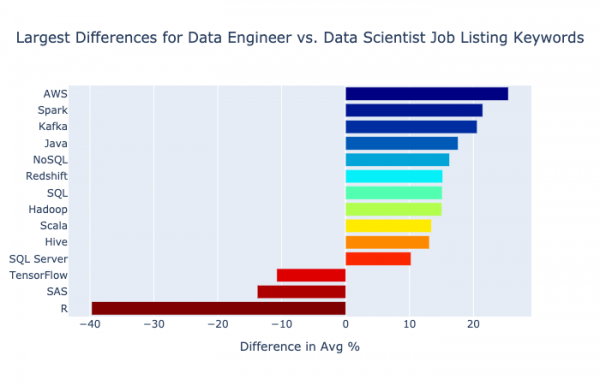
De grootste verschillen in frequentie van sleutelwoorden tussen data engineer en data scientist
De meest significante stijging wordt waargenomen bij AWS: in data engineering verschijnt het 25% vaker dan in data science (ongeveer 45% en 20% van het totale aantal vacatures respectievelijk). Het verschil is duidelijk!
Hier zijn dezelfde gegevens in een iets andere presentatie - in de grafiek staan de resultaten voor hetzelfde sleutelwoord in vacatures voor data engineer en data scientist naast elkaar.
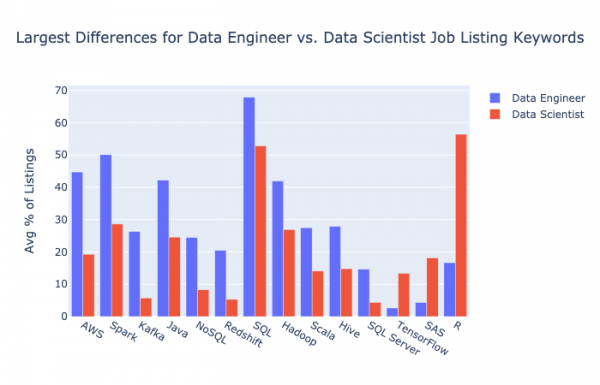
De grootste verschillen in frequentie van sleutelwoorden tussen data engineer en data scientist
De volgende grootste sprong merkte ik bij Spark – data engineers moeten vaak met grote gegevens werken. is ook met 20% gestegen, wat bijna vier keer zoveel is in vergelijking met de resultaten van data scientist vacatures. Gegevensoverdracht is een van de belangrijkste verantwoordelijkheden van een data engineer. Ten slotte bleek het aantal vermeldingen 15% hoger te zijn in het data engineering domein voor Java, NoSQL, Redshift, SQL en Hadoop.
Minder populaire technologieën in data engineering
Laten we nu eens kijken naar welke technologieën minder populair zijn in vacatures voor data engineers.
De meest scherpe daling in vergelijking met het data science domein vond plaats bij : daar kwam het ongeveer in 56% van de vacatures voor, hier – slechts in 17%. Indrukwekkend. R is een programmeertaal die populair is bij wetenschappers en statitici, en staat op de achtste plaats in de ranking van angstaanjagende talen.
komt ook aanzienlijk minder voor in vacatures voor data engineer – het verschil bedraagt 14%. SAS is een gepatenteerde taal die is ontworpen voor statistiek en gegevensanalyse. Interessant om op te merken: volgens de resultaten , heeft het de laatste tijd sterk aan terrein verloren – sterker dan enige andere technologie.
Gewild in zowel data engineering als data science
Het is belangrijk op te merken dat acht van de tien top posities in beide datasets overeenkomen. SQL, Python, Spark, AWS, Java, Hadoop, Hive en Scala maken deel uit van de top tien voor zowel de data engineering als de data science sector. In de onderstaande grafiek kunt u de vijftien populairste technologieën bij werkgevers van data engineers zien, met bovendien hun score in vacatures voor data scientists.
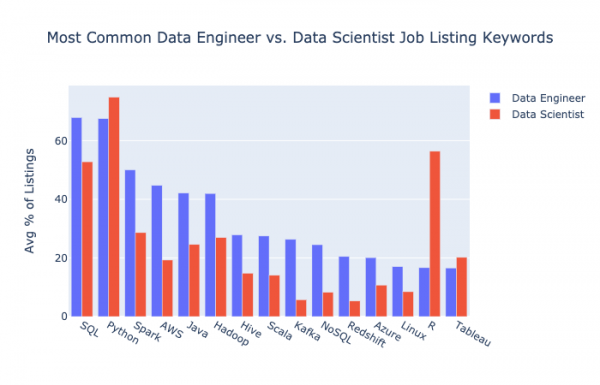
Aanbevelingen
Als je je wilt bezighouden met data engineering, raad ik je aan de volgende technologieën te beheersen – ik geef ze in volgorde van geschatte prioriteit.
Leer SQL. Ik wijs je in het bijzonder naar PostgreSQL omdat het open source is, grote populariteit heeft binnen de gemeenschap en zich in een groeifase bevindt. Hoe je de taal kunt gebruiken, staat in het boek My Memorable SQL – de pilotversie is beschikbaar .
Beheers Python, al is het niet op het meest hardcore niveau. Het boek My Memorable Python is precies gericht op beginners. Het is te koop op , elektronische versie of harde kopie, aan jou de keus, of je kunt het downloaden in pdf of epub formaat .
Zodra je met Python bekend bent, ga je verder met pandas – de Python-bibliotheek die wordt gebruikt voor het opschonen en verwerken van gegevens. Als je van plan bent om te werken bij een bedrijf waar kennis van Python vereist is (en dat is de meerderheid), kun je er zeker van zijn dat kennis van pandas als standaard wordt aangenomen. Ik ben momenteel bezig met een inleidende handleiding voor het werken met pandas – je kunt , zodat je het moment van uitgave niet mist.
Beheers AWS. Als je een data engineer wilt worden, kun je niet zonder een cloudplatform, en AWS is de populairste daarvan. De cursussen van , hebben me geholpen toen ik , en ik denk dat ze ook goede materialen voor AWS hebben.
Als je deze lijst allemaal hebt afgehandeld en als data engineer verder wilt groeien in de ogen van werkgevers, stel ik voor om Apache Spark toe te voegen voor het werken met grote gegevens. Hoewel mijn onderzoek naar vacatures voor data science een daling in interesse liet zien, komt het bij data engineers toch bijna in elke tweede vacature voorbij.
Tot slot
Ik hoop dat dit overzicht van de meest gevraagde technologieën voor data engineers nuttig voor je is geweest. Als je benieuwd bent naar de situatie met vacatures voor analisten, lees dan . Veel succes met engineering!
Bron: habr.com
