

Hallo allemaal! Ik ben een backend-ontwikkelaar en schrijf microservices in Java + Spring. Ik werk in een van de ontwikkelingsteams van interne producten bij Tinkoff.
In ons team rijst vaak de vraag naar het optimaliseren van databasequery's. We willen altijd dat het nog iets sneller gaat, maar soms kunnen we niet alleen rekenen op zorgvuldig opgebouwde indexen — we moeten naar alternatieve oplossingen zoeken. Tijdens een van dergelijke zoektocht op het internet naar redelijke optimalisaties voor het werken met databases, vond ik , auteur van het boek SQL Performance Explained. Dit is zo'n zeldzaam soort blog waar je alle artikelen achtereenvolgens kunt lezen.
Ik wil een kort artikel van Markus voor jullie vertalen. Het kan in zekere zin een manifest genoemd worden dat de aandacht vestigt op een oud, maar nog steeds actueel probleem met de prestaties van de offset-operatie volgens de SQL-standaard.
Op sommige plaatsen zal ik de auteur aanvullen met uitleg en opmerkingen. Al deze plaatsen zal ik aanduiden met "bijv." voor meer duidelijkheid.
Korte inleiding
Ik denk dat velen weten hoe problematisch en traag werken met paginawijze selects via offset kan zijn. Maar wisten jullie dat je het vrij eenvoudig kunt vervangen door een efficiëntere constructie?
Dus, het sleutelwoord offset geeft de database aan om de eerste n records in de query over te slaan. Echter, de database moet nog steeds deze eerste n records van de schijf lezen, in de opgegeven volgorde (bijv.: toepassen van sortering als het is opgegeven), en pas daarna kan het beginnen met het retourneren van records vanaf n+1 en verder. Het meest interessante is dat het probleem niet ligt in de specifieke implementatie in de databases, maar in de oorspronkelijke definitie volgens de standaard:
…de rijen worden eerst gesorteerd volgens de <order by-clausule> en daarna beperkt door het aantal rijen dat gespecificeerd is in de <result offset-clausule> vanaf het begin te laten vallen…
-SQL:2016, Deel 2, 4.15.3 Afgeleide tabellen (bijv.: momenteel de meest gebruikte standaard)
Het sleutelpunt hier is dat offset een enkele parameter accepteert — het aantal records dat moet worden overgeslagen, en dat is alles. Volgens deze definitie kan de database alleen maar alle records ophalen en vervolgens de ongewenste laten vallen. Het is duidelijk dat zo'n definitie van offset onnodig werk met zich meebrengt. En het maakt zelfs niet uit of het SQL of NoSQL is.
Nog wat pijn
De offsetproblemen eindigen hier niet, en dat is waarom. Als er tussen het lezen van twee pagina's gegevens van de schijf een andere operatie een nieuwe record invoegt, wat zal er dan gebeuren?
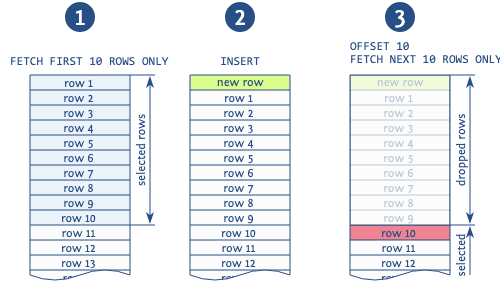
Wanneer offset wordt gebruikt om records van eerdere pagina's over te slaan, is het in de situatie waarin een nieuwe record tussen de leesoperaties van verschillende pagina's is toegevoegd, zeer waarschijnlijk dat u duplicaten krijgt (opmerking: dit is mogelijk wanneer we pagina voor pagina lezen met een 'order by'-constructie, dan kan een nieuwe record letterlijk in het midden van onze resultaten komen).
De afbeelding illustreert zo'n situatie. De database leest de eerste 10 records, waarna een nieuwe record wordt ingevoerd, die alle gelezen records met 1 verschuift. Vervolgens haalt de database de nieuwe pagina op met de volgende 10 records en begint niet bij de 11e, zoals zou moeten, maar bij de 10e, waardoor deze record wordt gedupliceerd. Er zijn ook andere anomalieën verbonden aan het gebruik van deze expressie, maar dit is de meest voorkomende.
Zoals we al hebben vastgesteld, zijn dit geen problemen van specifieke databases of hun implementaties. Het probleem ligt bij de paginatiebepaling volgens de SQL-norm. We vertellen de database welke pagina we nodig hebben of hoeveel records we moeten overslaan. De database is simpelweg niet in staat om zo'n verzoek te optimaliseren, omdat er te weinig informatie is.
Het is ook belangrijk op te merken dat dit probleem niet specifiek is voor één sleutelwoord, maar eerder een semantisch probleem van de query is. Er zijn nog enkele identieke syntaxes die ook problematisch zijn:
- Het sleutelwoord offset, zoals eerder aangegeven.
- De constructie van de twee sleutelwoorden limit [offset] (hoewel limit op zichzelf niet zo slecht is).
- Filtering op ondergrenzen, gebaseerd op rijnummering (bijvoorbeeld row_number(), rownum, enzovoort).
Al deze expressies geven simpelweg aan hoeveel rijen moeten worden overgeslagen, zonder aanvullende informatie of context.
Verderop in dit artikel wordt het sleutelwoord offset gebruikt als een verzamelterm voor al deze varianten.
Leven zonder OFFSET
Laten we ons nu voorstellen hoe onze wereld zou zijn zonder al deze problemen. Blijkt dat leven zonder offset helemaal niet zo moeilijk is: met een select kunt u alleen die rijen kiezen die we nog niet hebben gezien (opmerking: dat zijn degene die er niet waren op de vorige pagina) door een voorwaarde in de where-clausule.
In dit geval baseren we ons op het feit dat selects worden uitgevoerd op een geordende verzameling (de goede oude order by). Aangezien we een geordende verzameling hebben, kunnen we een vrij simpele filter gebruiken om alleen die gegevens op te halen die zich achter de laatste opname van de vorige pagina bevinden:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Dat is het hele principe van deze aanpak. Natuurlijk wordt het interessanter bij sorteren op meerdere kolommen, maar het idee blijft hetzelfde. Het is belangrijk op te merken dat deze constructie toepasbaar is in veel -oplossingen.
Deze aanpak wordt de seek method of keyset pagination genoemd. Het lost het probleem op van zwevende resultaten (bv. de situatie met opnamen tussen het lezen van pagina's, zoals eerder beschreven) en, zoals we allemaal graag zien, werkt het sneller en stabieler dan de klassieke offset. De stabiliteit komt voort uit het feit dat de verwerkingstijd van de aanvraag niet evenredig toeneemt met het nummer van de gevraagde tabel (bijv. als je meer wilt weten over de werking van verschillende benaderingen van pagination, kun je . Daar vind je ook vergelijkende benchmarks van verschillende methoden).
Een van de dia's , dat key pagination natuurlijk niet almachtig is — het heeft zijn beperkingen. De meest significante is dat het geen willekeurige pagina's kan lezen (bv. niet-sequentieel). Echter, in het tijdperk van oneindig scrollen (bv. aan de voorkant) is dit niet echt een probleem. Het aangeven van het paginanummer voor een klik is in ieder geval een slechte oplossing bij het ontwerpen van UI (bv. de mening van de auteur van het artikel).
En wat met de tools?
Key pagination is vaak niet geschikt vanwege het gebrek aan instrumentele ondersteuning voor deze methode. De meeste ontwikkelingsinstrumenten, inclusief verschillende frameworks, bieden geen keuze over welke methode voor pagination wordt uitgevoerd.
De situatie wordt verergerd door het feit dat de beschreven methode doorlopende ondersteuning vereist in de gebruikte technologieën — van de database tot de uitvoering van AJAX-verzoeken in de browser bij oneindig scrollen. In plaats van alleen het paginanummer aan te geven, moet je nu een set sleutels voor alle pagina's tegelijk opgeven.
Het aantal frameworks dat paginering op basis van sleutel ondersteunt, groeit echter geleidelijk. Dit is wat er op dit moment beschikbaar is:
- voor Java;
- voor Ruby;
- en voor Django;
- voor Python;
- — criteria API voor JPA-implementaties;
- voor Perl;
- , мапер для Node.js .
(Opmerking: sommige links zijn verwijderd omdat bepaalde bibliotheken ten tijde van de vertaling sinds 2017-2018 niet zijn bijgewerkt. Als je geïnteresseerd bent, kun je de originele bron bekijken.)
Hierbij heb ik jouw hulp nodig. Als je een framework ontwikkelt of ondersteunt dat op een of andere manier paginering gebruikt, dan vraag ik je, verzoek ik je, smeek ik je om native ondersteuning voor paginering op basis van sleutel te maken. Als je vragen hebt of hulp nodig hebt, wil ik je graag helpen (, , ) (opmerking: uit mijn ervaringen met Markus kan ik zeggen dat hij echt enthousiast is over het verspreiden van dit onderwerp).
Als je gebruik maakt van kant-en-klare oplossingen die volgens jou ondersteuning voor paginering op basis van sleutel verdienen, creëer dan een verzoek of bied zelfs een kant-en-klaar oplossing aan, indien mogelijk. Je kunt ook deze artikel in de link opnemen.
Conclusie
De reden waarom een zo eenvoudige en nuttige benadering als paginering op basis van sleutel zo weinig verbreid is, ligt niet in het feit dat het technisch ingewikkeld is of grote inspanningen vereist. De belangrijkste reden is dat velen gewend zijn aan offset — deze benadering is voorgeschreven door de standaard zelf.
Als gevolg hiervan denkt maar weinig mensen na over het veranderen van de benadering van paginering en daardoor ontwikkelt de instrumentele ondersteuning vanuit frameworks en bibliotheken zich traag. Dus als je het idee en het doel van offsetvrije paginering aanspreekt, help dan om het te verspreiden!
Bron:
Auteur: Markus Winand
Bron: habr.com
