

Dit artikel is een vertaling van mijn artikel op Medium — , dat behoorlijk populair bleek te zijn, waarschijnlijk vanwege de eenvoud. Daarom besloot ik het in het Nederlands te schrijven en iets toe te voegen, zodat een leek, die geen datadeskundige is, begrijpt wat een datawarehouse (DW) is, wat een data lake (Data Lake) is, en hoe ze samenleven.
Waarom ik over data lake wilde schrijven? Ik werk al meer dan 10 jaar met data en analytics, en tegenwoordig werk ik zeker met big data bij Amazon Alexa AI in Cambridge, dat zich in Boston bevindt, hoewel ik zelf in Victoria op Vancouver Island woon en vaak in Boston, Seattle en Vancouver ben, en soms zelfs in Moskou spreek op conferenties. Ook schrijf ik af en toe, maar voornamelijk in het Engels, en heb al , daarnaast heb ik de behoefte om trends in analytics vanuit Noord-Amerika te delen, en soms schrijf ik in .
Ik heb altijd gewerkt met datawarehouses, en sinds 2015 ben ik intensief met Amazon Web Services bezig, en ben ik überhaupt overgestapt op cloud analytics (AWS, Azure, GCP). Ik heb de evolutie van analyticsoplossingen sinds 2007 gevolgd en heb zelfs gewerkt bij de datawarehouse vendor Teradata en het geïmplementeerd in Sberbank, toen ontstond Big Data met Hadoop. Iedereen begon te zeggen dat het tijdperk van datawarehouses voorbij was en dat alles nu op Hadoop werkt, en toen begon men ook te spreken over Data Lake, met de opmerking dat het datawarehouse echt voorbij was. Maar gelukkig (of voor sommigen helaas, zoals zij die veel geld verdienden met het instellen van Hadoop) is het datawarehouse er nog steeds.
In dit artikel zullen we bekijken wat een data lake is. Het artikel is gericht op mensen met weinig of geen ervaring met datawarehouses.
Op de afbeelding is het meer van Bled, dat is een van mijn favoriete meren, hoewel ik er maar één keer ben geweest, maar ik zal het mijn hele leven onthouden. Maar we zullen het hebben over een ander type meer — data lake. Misschien hebben velen van jullie deze term al eens gehoord, maar een aanvullende definitie kan nooit kwaad.
Allereerst zijn dit de meest populaire definities van Data Lake:
«een bestandsopslag voor alle soorten ruwe data, die toegankelijk zijn voor analyse door iedereen in de organisatie» — Martin Fowler.
“Als je denkt dat een datawarehouse een fles water is — gezuiverd, verpakt en klaar voor eenvoudig gebruik, dan is een datameer een enorme tank met water in zijn natuurlijke staat. Gebruikers kunnen zelf water putten, duiken en verkennen.” — James Dickson.
Nu weten we zeker dat een datameer gaat over analytics, het stelt ons in staat om grote hoeveelheden data in hun oorspronkelijke vorm op te slaan en we hebben de benodigde en handige toegang tot de gegevens.
Ik hou er vaak van om dingen te vereenvoudigen. Als ik een ingewikkelde term eenvoudig kan uitleggen, betekent dat dat ik heb begrepen hoe het werkt en waarvoor het nodig is. Zo aan het rommelen met mijn iPhone in de fotogalerij, realiseerde ik me dat dit eigenlijk een datameer is; ik heb zelfs een slide gemaakt voor conferenties:
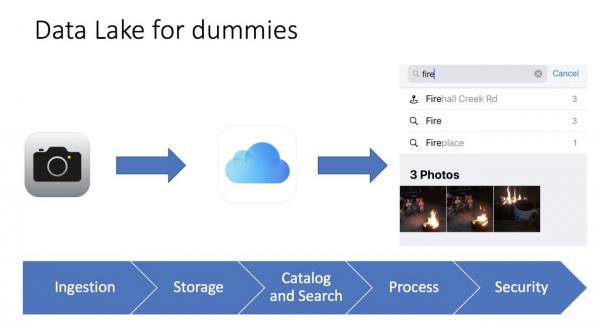
Het is heel eenvoudig. We maken een foto met de telefoon, de foto wordt opgeslagen op de telefoon en kan ook in iCloud worden opgeslagen (een cloud-bestandopslag). Bovendien verzamelt de telefoon metadata van de foto: wat erop staat, geotag, tijd. Het resultaat is dat we via de gebruiksvriendelijke interface van de iPhone onze foto kunnen vinden, en we zelfs statistieken zien; bijvoorbeeld, als ik zoek naar foto's met het woord vuur (fire), vind ik 3 foto's van een kampvuur. Voor mij is het echt een Business Intelligence-tool die heel snel en efficiënt werkt.
En natuurlijk mogen we de veiligheid (authenticatie en autorisatie) niet vergeten, anders kunnen onze data gemakkelijk openbaar worden. Er zijn veel nieuwsberichten over grote bedrijven en startups waarvan de gegevens door nalatigheid van ontwikkelaars en het niet volgen van eenvoudige regels openbaar zijn geworden.
Zelfs zo'n eenvoudige afbeelding helpt ons te begrijpen wat een datameer is, de verschillen met een traditioneel datawarehouse en de belangrijkste elementen daarvan:
- Gegevens laden (Ingestion) — de sleutelcomponent van een datameer. Gegevens kunnen op twee manieren in de datastorage komen — batch (laden met intervallen) en streaming (data stream).
- Bestandopslag (Storage) — de belangrijkste component van het Datameer. We hebben een opslag nodig die gemakkelijk schaalbaar, extreem betrouwbaar en kosteneffectief is. Bijvoorbeeld, in AWS is dit S3.
- Catalogus en Zoeken (Catalog and Search) — om te voorkomen dat we in een Data Moeras terechtkomen (wat betekent dat we alle gegevens in één hoop gooien en het daarna onmogelijk is om ermee te werken), is het noodzakelijk om een laag van metadata te creëren voor gegevensclassificatie, zodat gebruikers gemakkelijk de gegevens kunnen vinden die ze nodig hebben voor analyse. Daarnaast kunnen aanvullende zoekoplossingen zoals ElasticSearch worden gebruikt. Zoekfunctionaliteit helpt gebruikers bij het vinden van de benodigde gegevens via een gebruiksvriendelijke interface.
- Verwerking (Process) — deze stap is verantwoordelijk voor de verwerking en transformatie van gegevens. We kunnen gegevens transformeren, structuren aanpassen, opschonen en nog veel meer.
- Beveiliging (Security) — het is belangrijk om tijd te besteden aan het ontwerp van de beveiliging van de oplossing. Bijvoorbeeld, data-encryptie tijdens opslag, verwerking en overdracht. Het is cruciaal om methoden voor authenticatie en autorisatie te gebruiken. Tot slot is een audittool nodig.
Vanuit praktisch oogpunt kunnen we een datameer karakteriseren aan de hand van drie attributen:
- Verzamel en sla alles op wat je wilt — een datameer bevat alle gegevens, zowel onbewerkte ruwe gegevens voor elke periode als verwerkte/schone gegevens.
- Diepe analyse — een datameer stelt gebruikers in staat om gegevens te onderzoeken en te analyseren.
- Flexibele toegang — een datameer biedt flexibele toegang tot verschillende gegevens en verschillende scenario's.
Nu kunnen we het verschil bespreken tussen een datawarehouse en een datameer. Gewoonlijk vragen mensen:
- Wat met het datawarehouse?
- Vervangen we het datawarehouse door een datameer of breiden we het uit?
- Is het mogelijk om zonder datameer te functioneren?
Kortom, er is geen duidelijk antwoord. Het hangt allemaal af van de specifieke situatie, de vaardigheden binnen het team en het budget. Een voorbeeld is de migratie van een datawarehouse naar Oracle in AWS en het creëren van een datameer door het dochterbedrijf van Amazon — Woot — .
Aan de andere kant beweert de leverancier Snowflake dat je niet meer over een datameer hoeft na te denken, omdat hun dataplatform (voor 2020 was dit een datawarehouse) je in staat stelt om zowel een datameer als een datawarehouse te combineren. Ik heb niet veel gewerkt met Snowflake, en het is echt een uniek product dat dat kan. Wat de prijs betreft, dat is een ander verhaal.
Samenvattend is mijn persoonlijke mening dat we nog steeds een datawarehouse nodig hebben als primaire gegevensbron voor onze rapportage, en alles wat niet past, slaan we op in een datameer. De rol van analytics is om het bedrijfsleven gemakkelijke toegang te bieden voor besluitvorming. Hoe je het ook wendt of keert, maar zakelijke gebruikers werken efficiënter met een datawarehouse dan met een datameer. Bijvoorbeeld bij Amazon — er is Redshift (analytisch datawarehouse) en er zijn Redshift Spectrum/Athena (SQL-interface voor het datameer in S3 op basis van Hive/Presto). Hetzelfde geldt voor andere moderne analytische datawarehouses.
Laten we een typische architectuur van een datawarehouse bekijken:
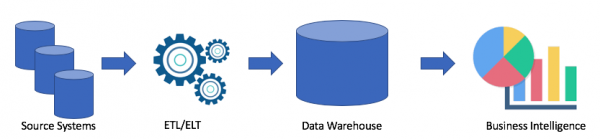
Dit is een klassieke oplossing. We hebben bronnenystemen, met behulp van ETL/ELT kopiëren we gegevens naar het analytische datawarehouse en verbinden we het met een Business Intelligence-oplossing (mijn favoriet is Tableau, en de jouwe?).
Zo'n oplossing heeft de volgende nadelen:
- ETL/ELT-operaties vereisen tijd en middelen.
- Over het algemeen zijn de kosten voor gegevensopslag in een analytisch datawarehouse niet goedkoop (bijvoorbeeld Redshift, BigQuery, Teradata), omdat we een heel cluster moeten kopen.
- Zakelijke gebruikers hebben toegang tot opgeschoonde en vaak geaggregeerde gegevens en hebben geen mogelijkheid om ruwe gegevens te verkrijgen.
Natuurlijk hangt alles af van jouw specifieke casus. Als je geen problemen hebt met je datawarehouse, heb je absoluut geen datameer nodig. Maar wanneer er problemen zijn met gebrek aan ruimte, vermogen of waar de prijs een cruciale rol speelt, dan kan het datameer een optie zijn. Daarom is het datameer erg populair. Hier is een voorbeeld van de architectuur van een datameer:
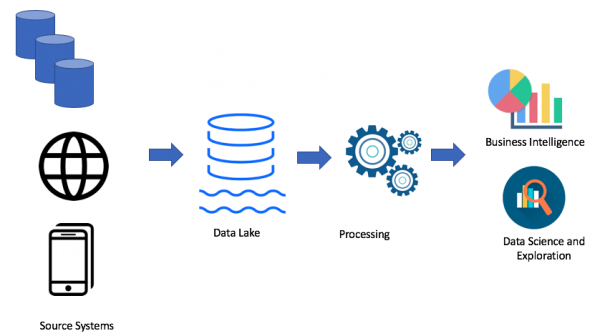
Door de aanpak van een datameer te gebruiken, laden we ruwe gegevens in ons datameer (batch of streaming), vervolgens verwerken we de gegevens indien nodig. Een datameer stelt zakelijke gebruikers in staat om hun eigen gegevens-transformaties (ETL/ELT) te maken of gegevens te analyseren in Business Intelligence-oplossingen (als de juiste driver aanwezig is).
Het doel van elke analytische oplossing is om te dienen voor zakelijke gebruikers. Daarom moeten we altijd vanuit de eisen van het bedrijf werken. (Bij Amazon is dit een van de principes — working backwards).
Door zowel met een datawarehouse als met een datameer te werken, kunnen we beide oplossingen vergelijken:
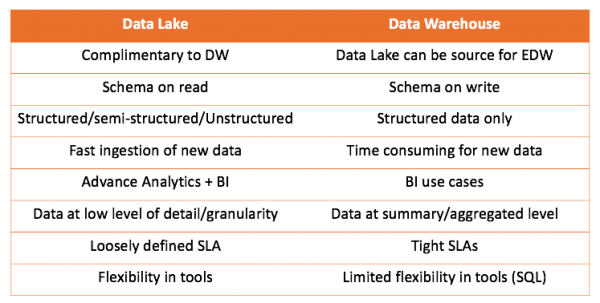
De belangrijkste conclusie is dat een datastorage niet concurreert met een datameer, maar meer aanvult. Het is aan jou om te beslissen wat geschikt is voor jouw situatie. Het is altijd interessant om het zelf te proberen en de juiste conclusies te trekken.
Ik wil ook een van de case studies bespreken waarin ik de datameer-aanpak ben gaan gebruiken. Het is vrij eenvoudig; ik probeerde een ELT-tool te gebruiken (we hadden Matillion ETL) en Amazon Redshift. Mijn oplossing werkte, maar voldeed niet aan de vereisten.
Ik moest weblogs nemen, deze transformeren en aggregeren om gegevens te leveren voor twee casussen:
- Het marketingteam wilde de activiteit van bots voor SEO analyseren.
- IT wilde de metrics van de websites bekijken.
Zeer eenvoudige, heel simpele logs. Hier is een voorbeeld:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Eén bestand woog 1-4 megabyte.
Maar er was één probleem. We hadden 7 domeinen over de hele wereld, en op één dag werden er 7000 bestanden aangemaakt. Dat is niet erg veel, in totaal 50 gigabyte. Maar de grootte van onze Redshift-cluster was ook klein (4 nodes). Het traditioneel uploaden van één bestand duurde ongeveer een minuut. Dus het probleem kon niet rechtstreeks worden aangepakt. En dit was het geval waarin ik besloot de datameer-aanpak te gebruiken. De oplossing zag er ongeveer als volgt uit:
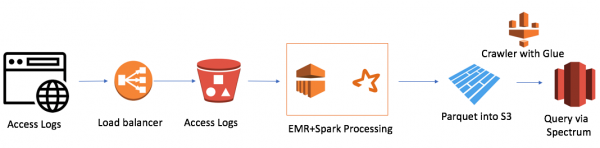
Het is vrij eenvoudig (ik wil opmerken dat het voordeel van werken in de cloud de eenvoud is). Ik gebruikte:
- AWS Elastic Map Reduce (Hadoop) als rekenkracht.
- AWS S3 als bestandsopslagsysteem met gegevensversleuteling en toegangsbeperkingen.
- Spark als InMemory-rekenkracht en PySpark voor logica en gegevenstransformatie.
- Parquet als resultaat van het werk van Spark.
- AWS Glue Crawler als metadata-verzamelaar voor nieuwe gegevens en partitites.
- Redshift Spectrum als SQL-interface voor het datameer voor bestaande Redshift-gebruikers.
De kleinste EMR+Spark-cluster verwerkte de hele batch van bestanden in 30 minuten. Er zijn ook andere cases voor AWS, vooral veel gerelateerd aan Alexa, waar veel gegevens zijn.
Onlangs ontdekte ik een van de nadelen van een data lake - de GDPR. Het probleem is dat wanneer een klant vraagt om gegevens te verwijderen en de gegevens zich in een van de bestanden bevinden, we de Data Manipulation Language en de DELETE-operatie niet kunnen gebruiken zoals in een database.
Ik hoop dat het artikel het verschil tussen een data warehouse en een data lake verduidelijkt. Als het interessant was, kan ik meer van mijn artikelen of artikelen van professionals die ik lees vertalen. Ook kan ik praten over de oplossingen waarmee ik werk en hun architectuur.
Bron: habr.com
